LangChain 学习笔记(二):大模型交互
- 2026-11-04 16:07:20
前言
一、原生调用:先看看"原始"长什么样
1. 原生 OpenAI SDK 调用 DeepSeek
from openai import OpenAI # uv add openaiimport osfrom dotenv import load_dotenv # python-dotenv 包# 加载项目中的.env 文件的配置load_dotenv()client = OpenAI(base_url=os.getenv("DEEPSEEK_BASIC_URL"), api_key=os.getenv("DEEPSEEK_API_KEY"))response = client.chat.completions.create(model="deepseek-flash",messages=[{"role": "system", "content": "你是一个广东人"},{"role": "user", "content": "你好"},],stream=False,reasoning_effort="high",extra_body={"thinking": {"type": "enabled"}}, )print(response)
2. 原生 SDK 的痛点
OpenAI 用 client.chat.completions.create() Anthropic 用 client.messages.create() 取内容的方式也各不相同:OpenAI 用 .choices[0].message.content,Anthropic 用 .content[0].text
二、LangChain 登场:统一接口的威力
用 LangChain 调用 openAi
import osfrom dotenv import load_dotenvfrom langchain_openai import ChatOpenAIload_dotenv()# 实例化大模型llm = ChatOpenAI(openai_api_key=os.getenv(”OPENAI_API_KEY”),openai_api_base=os.getenv(”OPENAI_API_BASE”), model_name=”glm-5”)# 调用模型的invoke 得到模型的响应res = llm.invoke(”你好,我想了解下你这个模型的情况”)# 输出print(res)
用 LangChain 调用 deepseek
import osfrom dotenv import load_dotenvfrom langchain_deepseek import ChatDeepSeekload_dotenv()# 实例化大模型llm = ChatDeepSeek(openai_api_key=os.getenv(”DEEPSEEK_API_KEY”),openai_api_base=os.getenv(”DEEPSEEK_BASIC_URL”), model_name=”deepseek-flash”)# 调用模型的invoke 得到模型的响应res = llm.invoke(”你好,我想了解下你这个模型的情况”)# 输出print(res)
返回的对象为
AIMessage, 如果只是想获得回答的内容,可以调用content属性
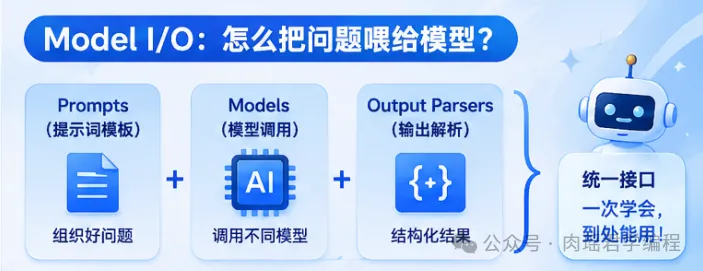
Model I/O 回答的是一个最基本的问题:"怎么把问题喂给模型,并拿到有用的结果?"
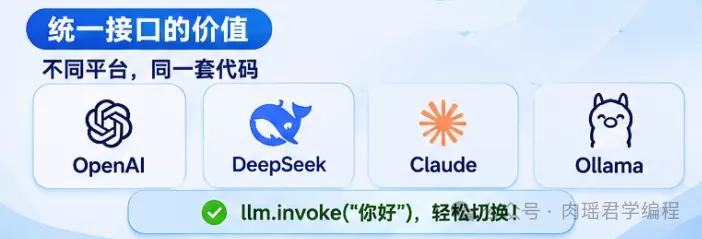
统一接口的价值,不管你用的是 OpenAI、DeepSeek、Claude 还是本地的 Ollama,LangChain 都提供了完全一致的调用方式:
# 不同平台,同一套代码llm = ChatOpenAI(model="gpt-4o-mini") # OpenAIllm = ChatOpenAI(model="deepseek-chat", ...) # DeepSeekllm = ChatAnthropic(model="claude-sonnet-4-20250514") # Anthropicllm = ChatOllama(model="qwen2.5:7b") # 本地模型# 调用方式完全一致response = llm.invoke("你好") # 同步调用response = await llm.ainvoke("你好") # 异步调用for chunk in llm.stream("你好"): # 流式输出print(chunk.content, end="")responses = llm.batch(["问题1", "问题2"]) # 批量调用
这就是 Model I/O 中 Models 层的核心价值:一次学会,到处能用。
三、基础使用:ChatOpenAI 实战
from langchain_openai import ChatOpenAIfrom dotenv import load_dotenvload_dotenv()# 最简写法:环境变量里已配好 OPENAI_API_KEY 和 OPENAI_BASE_URLllm = ChatOpenAI(model_name="gpt-4o-mini")response = llm.invoke("你好,介绍一下LangChain")# response 是一个 AIMessage 对象,不是普通字符串print(type(response)) # <class 'langchain_core.messages.ai.AIMessage'>print(response.content) # 模型返回的文本内容print(response.response_metadata) # 模型名称、token消耗等元信息
llm = ChatOpenAI(model_name="gpt-4o-mini", # 模型名称(必填)temperature=0.7, # 随机性,0=确定性,1=有创意(默认因模型而异)max_tokens=1000, # 最大输出长度timeout=60, # 超时时间(秒)max_retries=2, # 失败重试次数)
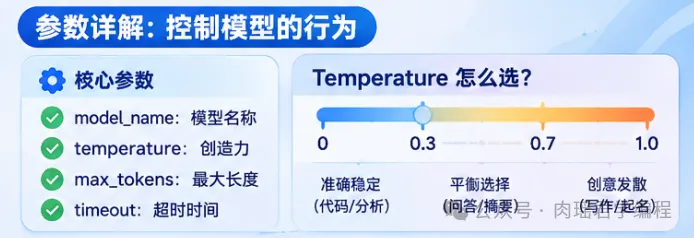
1. temperature 到底怎么选?
from langchain_openai import ChatOpenAIquestion = "给我的咖啡店起个名字"# temperature=0 —— 确定性输出,每次结果几乎一样llm_precise = ChatOpenAI(model_name="gpt-4o-mini", temperature=0)print(llm_precise.invoke(question).content)# → "醇香时光咖啡馆"(每次运行结果固定)# temperature=1 —— 有创意,每次结果不同llm_creative = ChatOpenAI(model_name="gpt-4o-mini", temperature=1)print(llm_creative.invoke(question).content)# → "晨雾与豆语"(下次运行可能是另一个名字)
选择建议:
2. Token 是什么?
所以,同样一句话,人眼看起来长度差不多,token 数却可能差很多。
四、进阶技巧:动态切换模型
1. 用 init_chat_model 统一初始化
# uv add langchain-openai# uv add langchain-anthropic# uv add google-genaifrom langchain.chat_models import init_chat_modelfrom dotenv import load_dotenvimport osload_dotenv()# 一个函数搞定所有提供商,通过 model_provider 参数区分llm_openai = init_chat_model("gpt-5.4-nano-2026-03-17", model_provider="openai", api_key=os.getenv("OPENAI_API_KEY"),base_url=os.getenv("OPENAI_BASE_URL"))llm_claude = init_chat_model("claude-opus-4-7", model_provider="anthropic", api_key=os.getenv("ANTHROPIC_API_KEY"),base_url=os.getenv("ANTHROPIC_BASE_URL"))llm_gemini = init_chat_model("gemini-3.1-flash-lite-preview", model_provider="google_genai",api_key=os.getenv("GEMINI_API_KEY"), base_url=os.getenv("GEMINI_BASE_URL"))# 调用方式完全一致for name, llm in [("OpenAI", llm_openai), ("Claude", llm_claude), ("Gemini", llm_gemini)]:response = llm.invoke("用一句话介绍你自己")print(f"{name}: {response.content}")
什么时候用哪个?
ChatOpenAIChatAnthropic 等具体类 | ||
init_chat_model | ||
init_chat_model | ChatOpenAI |
2. 运行时动态切换模型
from langchain.chat_models import init_chat_modelconfigurable_model = init_chat_model(temperature=0)# 使用GPT-4result1 = configurable_model.invoke("你好",config={"configurable": {"model": "gpt-4o-mini"}})# 使用Clauderesult2 = configurable_model.invoke("你好",config={"configurable": {"model": "claude-sonnet-4-6"}})
五、模型调用方式详解
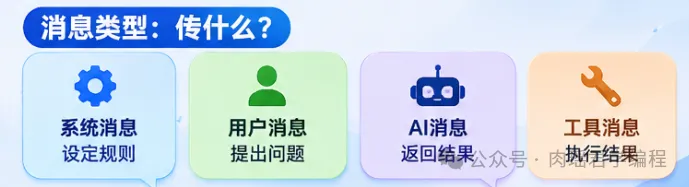
1. 消息类型:传什么
SystemMessage | |||
HumanMessage | |||
AIMessage | |||
ToolMessage |
记忆口诀:系统定规则,用户提问题,AI给回复,工具报结果。
from dotenv import load_dotenvfrom langchain_deepseek import ChatDeepSeekfrom langchain_core.messages import (HumanMessage,SystemMessage,AIMessage)load_dotenv()llm = ChatDeepSeek(model_name="deepseek-flash")# 构建对话conversation = [SystemMessage(content="你是一个有帮助的AI助手"), HumanMessage(content="你好,我叫小阁老"),AIMessage(content="你好,小阁老,有什么需要帮助吗?"),HumanMessage(content="我叫什么名字")]print(llm.invoke(conversation)
为什么需要区分消息类型?
系统消息:设定AI的"人设"和行为规则 用户消息:真正的问题或指令 AI消息:保留历史上下文,让AI"记得"之前说过什么 工具消息:当AI调用外部工具时,工具返回的结果
2. 传入方式:怎么传
llm.invoke("你好") | ||
llm.invoke([SystemMessage(...), HumanMessage(...)]) | ||
llm.invoke([("system", "..."), ("user", "...")]) |
一句话记忆:
能用字符串就用字符串(最简单) 需要对话/角色时用消息列表(最常见) 动态构建时用元组/字典(最灵活)
方式一:直接传入字符串(最简单)
from langchain_openai import ChatOpenAIllm = ChatOpenAI(model="gpt-4o-mini")response = llm.invoke("你好,介绍一下LangChain")print(response.content)
适用场景:
单轮问答,不需要上下文 不需要设定 AI 的角色或行为规则 快速测试或调试
优势:代码最简洁,一行搞定
局限:无法保留对话历史,无法设定系统提示词
方式二:传入消息列表(最常用)
from langchain_core.messages import HumanMessage, SystemMessage, AIMessagellm = ChatOpenAI(model="gpt-4o-mini")response = llm.invoke([SystemMessage(content="你是一个专业的Python编程助手"),HumanMessage(content="什么是装饰器?")])print(response.content)
适用场景:
需要设定 AI 角色(比如"你是一个翻译助手") 需要保留对话历史 需要区分系统指令/用户输入/AI回复
实战示例:多轮对话
from langchain_core.messages import HumanMessage, AIMessage# 对话历史conversation = [HumanMessage(content="什么是LangChain?"),AIMessage(content="LangChain是一个用于开发大模型应用的框架。"),HumanMessage(content="它有哪些核心组件?") # 这依赖于上一轮的上下文]response = llm.invoke(conversation)print(response.content)
方式三:使用元组或字典(最灵活)
# 元组方式:(角色, 内容)tuple_messages = [("system", "你是一个专业的Python编程助手"),("user", "什么是装饰器?")]# 字典方式:{"role": 角色, "content": 内容}dict_messages = [{"role": "system", "content": "你是一个专业的Python编程助手"},{"role": "user", "content": "什么是装饰器?"}]print(llm.invoke(tuple_messages))print(llm.invoke(dict_messages))
适用场景:
从 API 返回的 JSON 数据直接转成消息列表 从配置文件或数据库读取对话模板 动态构建消息列表
3. 调用方式:怎么调
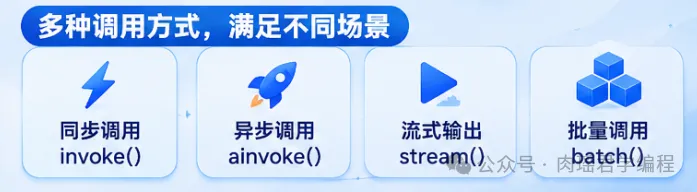
同步调用 - invoke()(最常用)
response = llm.invoke("什么是LangChain?")print(response.content)
异步调用 - ainvoke()(高并发)
同步(invoke):排队买奶茶━━━━━━━━━━━━━━━━━━━━━━━━━━━━━你 → 点单 → 等10分钟 → 拿到 → 再点下一杯 → 等10分钟 → 拿到5杯奶茶总耗时:50分钟(串行等待)异步(ainvoke):扫码下单━━━━━━━━━━━━━━━━━━━━━━━━━━━━━你 → 5杯同时下单 → 哪杯好了取哪杯5杯奶茶总耗时:≈10分钟(并行等待)
为什么模型调用特别适合异步?因为 llm.invoke() 的耗时几乎全花在"等网络响应"上,CPU 其实是闲着的。异步让你在等第1个响应的同时,把第2、3、4、5个请求也发出去,所有等待时间重叠,总耗时 ≈ 单次最慢的那个请求。
基础用法
import asynciofrom langchain_openai import ChatOpenAIllm = ChatOpenAI(model="gpt-4o-mini")async def call_llm_async():response = await llm.ainvoke("什么是LangChain?")print(response.content)asyncio.run(call_llm_async())
invoke() vs ainvoke() 性能对比
import timeimport asynciofrom langchain_openai import ChatOpenAIllm = ChatOpenAI(model="gpt-4o-mini")# 准备 5 个测试问题prompts = ["用一句话介绍一下北京","用一句话介绍一下上海","用一句话介绍一下广州","用一句话介绍一下深圳","用一句话介绍一下杭州"]# ========== 测试一:同步 invoke(串行) ==========def test_sync_invoke():print("=== 同步 invoke ===")start_time = time.time()for i, prompt in enumerate(prompts):print(f" [同步] 正在发送第 {i + 1} 个请求...")llm.invoke(prompt) # 死等,拿到结果才进入下一次循环print(f"总耗时: {time.time() - start_time:.2f} 秒\n")# ========== 测试二:异步 ainvoke(并行) ==========async def test_async_ainvoke():print("=== 异步 ainvoke ===")start_time = time.time()# 关键:用 asyncio.gather 同时派发所有请求print(" [异步] 瞬间派发 5 个请求...")tasks = [llm.ainvoke(prompt) for prompt in prompts]results = await asyncio.gather(*tasks)for r in results:print(f" 回答: {r.content[:20]}...")print(f"总耗时: {time.time() - start_time:.2f} 秒\n")# ========== 运行对比 ==========async def main():test_sync_invoke() # 先跑同步await test_async_ainvoke() # 再跑异步asyncio.run(main())
ainvoke() 解决的是 → "等待时不阻塞"(让出 CPU,别的任务有机会插进来)gather() 解决的是 → "同时派发多个任务"(把多个协程塞进事件循环并行跑)
invoke()= 你站在柜台前死等,奶茶没做好之前你哪儿也去不了,后面的人也点不了单 ainvoke()= 你扫码下单后去旁边坐着,不占柜台了,后面的人可以继续点单 asyncio.gather()= 同时帮5个人下单,让奶茶店并行制作
所以:如果只有你一个人买奶茶,ainvoke()(坐着等)和 invoke()(站着等)时间一样长——因为没有"后面的人"需要你让位。ainvoke()的价值在于"让出控制权",而gather()的价值在于"利用让出的控制权塞入更多任务"。两者缺一不可。
# ❌ 错误理解:用了 ainvoke 就会快
# 实际效果:还是串行,因为每次 await 都在等当前这个完成
async def wrong_way():r1 = await llm.ainvoke("问题1") # 等第1个完成(2秒)r2 = await llm.ainvoke("问题2") # 再等第2个完成(2秒)r3 = await llm.ainvoke("问题3") # 再等第3个完成(2秒)# 总耗时:~6秒(串行)# ✅ 正确写法:ainvoke 负责"能让出",gather 负责"同时跑"async def right_way():tasks = [llm.ainvoke("问题1"), # 创建协程,但不等待llm.ainvoke("问题2"), # 创建协程,但不等待llm.ainvoke("问题3"), # 创建协程,但不等待]r1, r2, r3 = await asyncio.gather(*tasks) # 三个请求同时发出,同时等待# 总耗时:~2秒(并行)
invoke() | ||
await ainvoke() | ||
asyncio.gather(*tasks) |
*tasks是 Python 的解包语法:gather(*[a, b, c])等价于gather(a, b, c)。
适用场景:
需要同时处理多个请求(批量调用、并行对比) Web 服务、API 接口(FastAPI 等异步框架) 对响应时间有要求的应用
流式调用 - stream()(打字机效果)
llm = ChatDeepSeek(model_name="deepseek-flash")print("AI 回答")full_message = Nonefor chunk in llm.stream("写一首关于家乡的诗"):full_message = chunk if full_message is None else full_message + chunkprint(chunk.content, end="", flush=True)# 完整消息print(f"\n\n完整消息:\n{full_message.content}")
flush=True的作用是强制将内存缓冲区中的内容立刻推送到屏幕上显示,而不是等攒够了一定数量或者遇到换行符才显示
流式事件监听(高级用法):
async def stream_events():async for event in llm.astream_events("你好"):if event["event"] == "on_chat_model_start":print(f"输入: {event['data']['input']}")elif event["event"] == "on_chat_model_stream":print(f"Token: {event['data']['chunk'].content}", end="",flush=True)elif event["event"] == "on_chat_model_end":print(f"\n完成!")asyncio.run(stream_events())
批次调用 - batch()(并行处理)
def batch_example():questions = ["什么是Python?","什么是JavaScript?","什么是Go语言?"]responses = llm.batch(questions)for q,r in zip(questions, responses):print(f"Q: {q}")print(f"A: {r.content}\n")batch_example()
批量异步调用:
async def async_batch_example():questions = ["什么是Python?","什么是JavaScript?","什么是Go语言?"]responses = await llm.abatch(questions)for q,r in zip(questions, responses):print(f"Q: {q}")print(f"A: {r.content}\n")asyncio.run(async_batch_example())
六、调用配置与高级特性
运行时配置
llm = ChatDeepSeek(model_name="deepseek-flash")response = llm.invoke("讲一个笑话",config={"tags": ["humor", "demo"], # 标签"metadata": {"user_id": "123"}, # 元数据})print(response) # 响应中并无config 的内容
. 这些config数据到底去哪了?
这些数据被 LangChain 的回调系统(Callback System)拦截并收集起来了。它们主要用于以下两个场景:
场景 A:云端监控与可视化(LangSmith)通过在环境变量中配置了 LangSmith(LangChain 官方的监控平台)
场景 B:本地回调拦截,通过**回调处理器(Callback Handler)**来拦截它们
from langchain_core.callbacks import BaseCallbackHandler# 1. 自定义一个回调处理器,拦截并打印运行信息class MyDebugCallback(BaseCallbackHandler):def on_chat_model_start(self, serialized, prompts, **kwargs):print("\n" + "=" * 40)print(" [拦截到 LLM 启动请求]")print(f" Tags: {kwargs.get('tags')}")print(f" Metadata: {kwargs.get('metadata')}")print("=" * 40 + "\n")llm = ChatDeepSeek(model_name="deepseek-flash")# 2. 在调用时,将你的回调处理器传进去response = llm.invoke("讲一个笑话",config={"tags": ["humor", "demo"], # 标签"metadata": {"user_id": "123"}, # 元数据"callbacks": [MyDebugCallback()] # 关键:挂载你的回调})print("最终返回的 response 依然只有大模型的内容:")print(response.content)
七、调用本地模型:Ollama
Ollama 介绍
Ollama 安装
curl -fsSL https://ollama.com/install.sh | sh模型下载和运行
# 下载并运行模型(首次使用会自动下载)ollama run qwen3.5:4b# 列出已下载的模型ollama list# 查看模型信息ollama show qwen3.5:4b
使用 LangChain 调用 Ollama
# uv add langchain-ollamafrom langchain_ollama import ChatOllama# 基本用法ollama_llm = ChatOllama(model="qwen3:8b", base_url="http://localhost:11434")response = ollama_llm.invoke("你好,介绍一下你自己")print(response.content)

