Stata学习笔记(二十三)-对数模型的系数应该怎么解释
- 2026-11-04 16:06:57
今天我们来聊一聊对数模型的系数应该怎么解释这个问题。
具体而言,对于对数模型,例如,lnprice 对 lnweight 回归,系数是 0.1910322。可不可以直接解释成"重量每增加 1%,价格上升 0.19%"?而对于置信区间 [-0.3513521, 0.7334166] ,能不能直接乘 100?
这几个问题之前并没有仔细思考过,这次想认真算一遍。利用 Stata 官方自带的数据auto,该数据包含了1978 年美国 74 款轿车的价格、油耗、重量等 12 个变量,我们来探讨一下这个问题。
当然,关于对数模型系数的解释,Wooldridge (2016) 的书中第六章做出了具体的阐述,有兴趣的小伙伴可以自行翻看。
Wooldridge, J. M. (2016). Introductory Econometrics: A Modern Approach (6th ed.). Boston, MA: Cengage Learning.
数据
auto 是 Stata 随附的官方示例数据,可以使用 webuse 调出来:
// Initializeclear allset more offset seed 20250725
cd "E:/Work" // CHANGE PATH TO LOCAL DIRECTORY WHERE ...global figures "./output/figures"
webuse auto, cleardescribe
Contains data from https://www.stata-press.com/data/r16/auto.dtaobs: 74 1978 Automobile Datavars: 12 13 Apr 2018 17:45(_dta has notes)------------------------------------------------------------------------------storage display valuevariable name type format label variable label------------------------------------------------------------------------------make str18 %-18s Make and Modelprice int %8.0gc Pricempg int %8.0g Mileage (mpg)rep78 int %8.0g Repair Record 1978headroom float %6.1f Headroom (in.)trunk int %8.0g Trunk space (cu. ft.)weight int %8.0gc Weight (lbs.)length int %8.0g Length (in.)turn int %8.0g Turn Circle (ft.)displacement int %8.0g Displacement (cu. in.)gear_ratio float %6.2f Gear Ratioforeign byte %8.0g origin Car type------------------------------------------------------------------------------Sorted by: foreign
共有74 个观测,没有缺失值。 再来看看对价格的具体描述性统计: 均值 6165.257 ,比中位数 5006.5 高出 23%,偏度 1.653434。这说明价格这个变量不适合直接放进线性方程。
summarize price, detailPrice-------------------------------------------------------------Percentiles Smallest1% 3291 32915% 3748 329910% 3895 3667 Obs 7425% 4195 3748 Sum of Wgt. 74--------------------------------------------------50% 5006.5 Mean 6165.257Largest Std. Dev. 2949.49675% 6342 1346690% 11385 13594 Variance 869952695% 13466 14500 Skewness 1.65343499% 15906 15906 Kurtosis 4.819188
在取了对数后,偏度降到 1.063312,峰度从 4.819188 降到 3.161721。
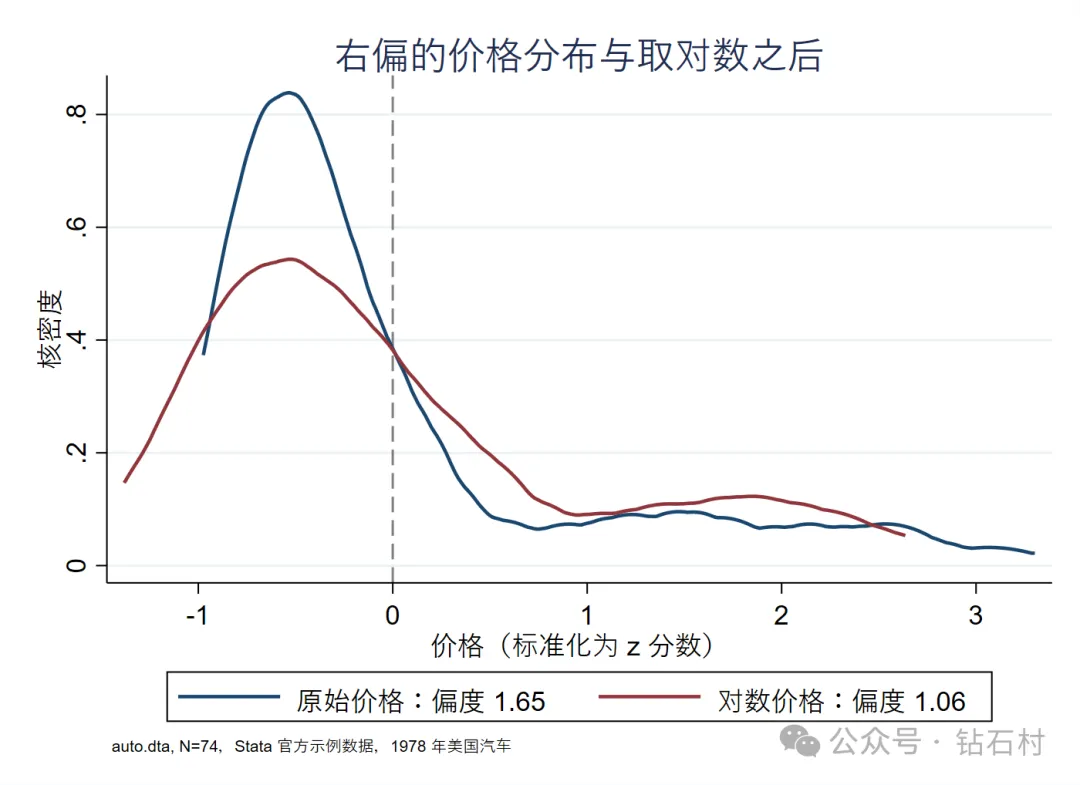 价格分布与取对数之后
该图的代码如下:
egen double zprice = std(price)egen double zlprice = std(lprice)twoway (kdensity zprice, lcolor(navy) fcolor(navy*0.15) lwidth(medthick)) ///(kdensity zlprice, lcolor(maroon) fcolor(maroon*0.15) lwidth(medthick)), ///xline(0, lpattern(dash) lcolor(gs8)) ///legend(order(1 "原始价格:偏度 1.65" 2 "对数价格:偏度 1.06") rows(1) size(medsmall)) ///ytitle("核密度") xtitle("价格(标准化为 z 分数)") ///title("右偏的价格分布与取对数之后") ///note("auto.dta, N=74,Stata 官方示例数据,1978 年美国汽车", size(vsmall)) ///graphregion(color(white)) plotregion(color(white))graph save "fig23dist.gph", replacegraph export "fig23dist.png", width(1400) replace
回归
先看未对数处理的回归:
regress price mpg weightSource | SS df MS Number of obs = 74-------------+---------------------------------- F(2, 71) = 14.74Model | 186321280 2 93160639.9 Prob > F = 0.0000Residual | 448744116 71 6320339.67 R-squared = 0.2934-------------+---------------------------------- Adj R-squared = 0.2735Total | 635065396 73 8699525.97 Root MSE = 2514------------------------------------------------------------------------------price | Coef. Std. Err. t P>|t| [95% Conf. Interval]-------------+----------------------------------------------------------------mpg | -49.51222 86.15604 -0.57 0.567 -221.3025 122.278weight | 1.746559 .6413538 2.72 0.008 .467736 3.025382_cons | 1946.069 3597.05 0.54 0.590 -5226.245 9118.382------------------------------------------------------------------------------
weight 的系数 1.746559,可以解释为"重量每增加 1 磅,价格平均高 1.75 美元"。再换成对数形式:
gen double lprice = ln(price)gen double lmpg = ln(mpg)gen double lweight = ln(weight)regress lprice lmpg lweight
Source | SS df MS Number of obs = 74-------------+---------------------------------- F(2, 71) = 15.64Model | 3.43231712 2 1.71615856 Prob > F = 0.0000Residual | 7.79121716 71 .109735453 R-squared = 0.3058-------------+---------------------------------- Adj R-squared = 0.2863Total | 11.2235343 73 .153747045 Root MSE = .33126------------------------------------------------------------------------------lprice | Coef. Std. Err. t P>|t| [95% Conf. Interval]-------------+----------------------------------------------------------------lmpg | -.6616413 .2784715 -2.38 0.020 -1.216898 -.1063848lweight | .1910322 .2720159 0.70 0.485 -.3513521 .7334166_cons | 9.117591 2.91713 3.13 0.003 3.300999 14.93418------------------------------------------------------------------------------
weight 从 t = 2.72(p = 0.008,显著)变成了 t = 0.70(p = 0.485,不显著),系数小了 9 倍。油耗则从 -49.51(不显著)变成 -0.6616413(p = 0.020,显著)。
对数系数的解释
系数 0.1910322 有两种解释。第一种是系数乘 100:"重量每增加 1%,价格平均上升 19.1%。"这是最常见的解释。第二种是先取指数再减 1,即:
nlcom expb: exp(_b[lweight])expb: exp(_b[lweight])------------------------------------------------------------------------------lprice | Coef. Std. Err. z P>|z| [95% Conf. Interval]-------------+----------------------------------------------------------------expb | 1.210498 .3292748 3.68 0.000 .5651316 1.855865------------------------------------------------------------------------------
exp(0.1910322) = 1.210498,也就是"重量增加 1%,价格平均上升 21.05%"。两种解释之间差了将近 2 个百分点,还算可以接受的范围。
不过对 lmpg 这个系数,情况就不一样了。用只回归mpg的设定更容易看出来:
preservequietly regress price mpgscalar b_lv = _b[mpg]scalar se_lv = _se[mpg]restorepreservequietly regress lprice lmpgscalar b_ld = _b[lmpg]scalar se_ld = _se[lmpg]restoredi "水平值 mpg: b=" b_lv " se=" se_lvdi "对数值 mpg: b=" b_ld " se=" se_lddi "朴素 100*b = " 100*b_lddi "精确 exp(b)-1 = " 100*(exp(b_ld)-1)
水平值 mpg: b=-238.89435 se=53.076687对数值 mpg: b=-.82684696 se=.1484986朴素 100*b = -82.684696精确 exp(b)-1 = -56.257366
可以看出,这里的差异很明显:朴素算法显示油耗每增加 1%,价格下降 82.68%;精确算法显示 56.26%。差了 26 个百分点。此时,"近似"已经不能简单地当成精确的百分比来解释了。
那这个系数应该怎么理解?需要做减法:
di "精确 exp(b)-1 = " 100*(exp(b_ld)-1)-56.26% 是"油耗翻一倍"的精确效果。如果只想看倍数,可以:
di "exp(b_ld*ln2) = " exp(b_ld*ln(2))di "乘2的百分比变化 = " 100*(exp(b_ld*ln(2))-1)
exp(-0.8268 × ln2) = 0.5638,即油耗翻一倍,价格大约变成原来的 56.4%——降幅 43.6%。所以 lnprice 对 lnmpg 的双对数模型里,lmpg 的系数不能直接当成百分比,它只是"弹性"这个说法的一个线性近似载体。
nlcom 的 p 值不能拿来用
上面使用 nlcom 时有个容易忽略的问题:z = 3.68,P > |z| = 0.000,看起来"显著"。但原回归里 lweight 的 p 值是 0.485,不显著。同一件事情,出现两个相矛盾的结果。
原因是 nlcom 检验的原假设是 exp(β) = 0。这个原假设本身是不合理的:指数函数的值取不到 0,所以 z 统计量在估计 β 接近 0 的时候反而会变大。换个变量就可以看出来:
nlcom expc: exp(_b[_cons])expc: exp(_b[_cons])------------------------------------------------------------------------------lprice | Coef. Std. Err. z P>|z| [95% Conf. Interval]-------------+----------------------------------------------------------------expc | 9114.222 26587.37 0.34 0.732 -42996.07 61224.51------------------------------------------------------------------------------
同一个模型,expc 的 P 值是 0.732。两个数都是指数,差别只在 β 的绝对值:0.1910322 时 z 高到 3.68,9.117591 时 z 只有 0.34。β 一旦远离 0,指数的 z 就掉下来。nlcom的 z 值和 p 值在 exp 变换下没有实际意义,不能直接写进论文。
置信区间不能直接乘 100
这是比系数点估计更容易出错的地方。原回归给的是 β 在对数尺度上的区间 [-0.3513521, 0.7334166],转换成百分比区间有两种做法:
scalar bw = _b[lweight]scalar sw = _se[lweight]scalar tc = invttail(e(df_r), 0.025)di "naive pct CI = " 100*(bw-tc*sw) " ~ " 100*(bw+tc*sw)di "correct pct CI = " 100*(exp(bw-tc*sw)-1) " ~ " 100*(exp(bw+tc*sw)-1)di "point exp pct = " 100*(exp(bw)-1) " vs 100*b = " 100*bw
naive pct CI = -35.135208 ~ 73.341657correct pct CI = -29.626406 ~ 108.21824point exp pct = 21.049848 vs 100*b = 19.103224
朴素算法:[-35.14%, 73.34%]。正确算法:[-29.63%, 108.22%]。
上界从 73% 变成了 108%。两个区间都正确包含 0 对应的"无变化",但区间宽度差了整整 35 个百分点。这个差异全部来自指数函数的凸性,即它把右端往上推得比左端往下推得多。所以"系数区间直接乘 100"这个做法会给出对称的百分比范围,而真实的不对称性是存在的,只是被人为抹掉了。
所以得出的结论是:报告对数模型的系数时,直接报告 β 和 β 的置信区间,在正文里明确写出"该系数为弹性"或者"近似半弹性",不要直接在表格里放百分比。
如果确实需要百分比的区间,nlcom 也是可以给出的:
nlcom expb: exp(_b[lweight])输出的 [0.5651316, 1.855865] 减去 1 就是 [-43.49%, 85.59%]。注意这个数和上面手工算的 [-29.63%, 108.22%] 又不一样——nlcom 用的是局部线性近似(delta 方法),手工算的是先取区间端点再指数变换,是全局精确变换。
什么时候 bootstrap 比 delta 方法可靠
delta 方法是局部近似,β 大、标准误大的时候近似质量会下降。bootstrap 命令可以直接对 exp(β) 抽样,不需要手推公式:
bootstrap expbw = exp(_b[lweight]), reps(2000) seed(20250725): regress lprice lmpg lweightLinear regression Number of obs = 74Replications = 2,000command: regress lprice lmpg lweightexpbw: exp(_b[lweight])------------------------------------------------------------------------------| Observed Bootstrap Normal-based| Coef. Std. Err. z P>|z| [95% Conf. Interval]-------------+----------------------------------------------------------------expbw | 1.210498 .4320056 2.80 0.005 .3637831 2.057214------------------------------------------------------------------------------
bootstrap 的标准误 0.4320056,nlcom 给的是 0.3292748,bootstrap 的结果多了整整 31%。原因是 exp(β) 的抽样分布明显右偏,delta 方法只用梯度的一阶信息,把它当成对称的正态分布处理;而 bootstrap 把偏度整个算进去了。
这里想多说一句:74 个观测做 2000 次重抽样,rep 缺失的比例不低,抽样分布的偏度估计本身就不稳。所以这个0 .4320056 也不该当成"真值",它只是提醒我们 delta 方法给的 0.3292748 大概率偏窄。
顺便,对 β 本身做 bootstrap 对照一下:
bootstrap braw = _b[lweight], reps(2000) seed(20250725): regress lprice lmpg lweight| Observed Bootstrap Normal-based| Coef. Std. Err. z P>|z| [95% Conf. Interval]-------------+----------------------------------------------------------------braw | .1910322 .3527325 0.54 0.588 -.5003108 .8823753------------------------------------------------------------------------------
β 自己的标准误:解析值 0.2720159,bootstrap 值 0.3527325,也大了 30%。这个差异不应该出现——OLS 的标准误有精确公式,bootstrap 只是换个算法重估同一个量。差距这么大,一个可能的解释是这个样本太小、reps 有限导致的模拟误差。
margins 的作用
margins 在对数模型里算的就是 β 本身:
margins, dydx(lweight) atmeansConditional marginal effects Number of obs = 74Model VCE : OLSExpression : Linear prediction, predict()dy/dx w.r.t. : lweightat : lmpg = 3.024536 (mean)lweight = 7.978751 (mean)------------------------------------------------------------------------------| Delta-method| dy/dx Std. Err. t P>|t| [95% Conf. Interval]-------------+----------------------------------------------------------------lweight | .1910322 .2720159 0.70 0.485 -.3513521 .7334166------------------------------------------------------------------------------
结果和回归表里的 lweight 那一行一模一样。对数模型对 ln(weight) 而言本身就是线性的,∂ln(price)/∂ln(weight) 就是 β。margins 的真正用处在交互项和虚拟变量上,这里就不过多展开了。
Stata 中有几个现成的命令可以处理对数系数的解释。其中最推荐的是 nlcom 的 nlcom expb: exp(_b[x])。它能一步给出 exp(β) 的点估计、delta 方法标准误和置信区间;但也存在 z 值和 p 值不可信的问题,只能取其中的估计值和区间。其他比较不错的还有 margins 的 margins, dydx(x) atmeans,以及需要非标准误时用 bootstrap 的 reps() 选项直接对 exp(β) 抽样。
如何报告
首先,需要说清楚函数形式。"被解释变量与解释变量均取自然对数",或者"被解释变量取对数、解释变量保留原值"
表格里直接展示 β 和标准误,不放百分比:
regress lprice lmpg lweight------------------------------------------------------------------------------lprice | Coef. Std. Err. t P>|t| [95% Conf. Interval]-------------+----------------------------------------------------------------lmpg | -.6616413 .2784715 -2.38 0.020 -1.216898 -.1063848lweight | .1910322 .2720159 0.70 0.485 -.3513521 .7334166_cons | 9.117591 2.91713 3.13 0.003 3.300999 14.93418------------------------------------------------------------------------------
正文里解释经济含义,并且明确标注"近似"两个字。比如lweight 的系数为 0.191(标准误 0.272),近似含义为重量每增加 1%,价格平均上升 19.1%。一定要写"近似",因为这不是精确的弹性。
当系数较大的时候改用精确变换,并作出说明。lmpg 的系数 -0.6616 就属于这种情况,可以解释为"油耗增加到原来的两倍,价格平均下降到原来的 63.2%"(exp(-0.6616 × ln2) = 0.632)。
至于"什么时候该取对数",一个判断标准是看变量之间的关系,而不是看单个变量的分布。价格、收入、GDP 这类金额变量取对数通常有道理;年份、学历、在职年限这类变量保留原值更自然。Rönkkö(2022) 他们那篇文章把这个观点讲得很清楚:他们系统梳理了六本管理学顶刊的 107 篇文章,发现相当一部分研究的函数形式选择依据是"让变量分布看起来正态"这类理由,而不是理论上的函数形式。
参考文献:
Wooldridge, J. M. (2016). Introductory Econometrics: A Modern Approach (6th ed.). Boston, MA: Cengage Learning.
Rönkkö, M., Aalto, E., Tenhunen, H., & Aguirre-Urreta, M. I. (2022). Eight Simple Guidelines for Improved Understanding of Transformations and Nonlinear Effects. Organizational Research Methods, 25(1): 48-87.

