从权重到世界 01|用 Excel 教会一个神经元做与运算
- 2026-11-07 13:20:29
用 Excel 教会一个神经元做“与运算”:从零看懂神经网络如何学习
不写 Python,不调用机器学习框架。只用四条真值表和一张 Excel,能不能让一个初始参数全为零的神经元,自己学会最简单的逻辑运算?
第一次接触神经网络时,我们常常会被一个问题吸引:模型究竟是怎样从“不会”变成“会”的?
输入数据、计算误差、调整权重……这些术语看似熟悉,可如果只看现成的代码,很难直观地看到参数在每一步究竟发生了什么变化。
于是,我做了一个尽可能简单的实验:用 Excel 训练一个只有 2 个输入、1 个输出、3 个可调参数的神经元,让它学会 AND(与运算)。训练数据只有 4 条,全部计算过程都可以在表格中逐行检查。
实验采用经典感知机的误分类更新规则,初始参数均为 0,学习率为 0.1,激活函数使用 Excel 的 GESTEP。下面就从第一条数据开始。
01|只给神经元四道题
AND(与运算)的规则很简单:两个输入同时为 1,输出才是 1;其余情况均输出 0。
这张真值表就是我们的全部训练集。
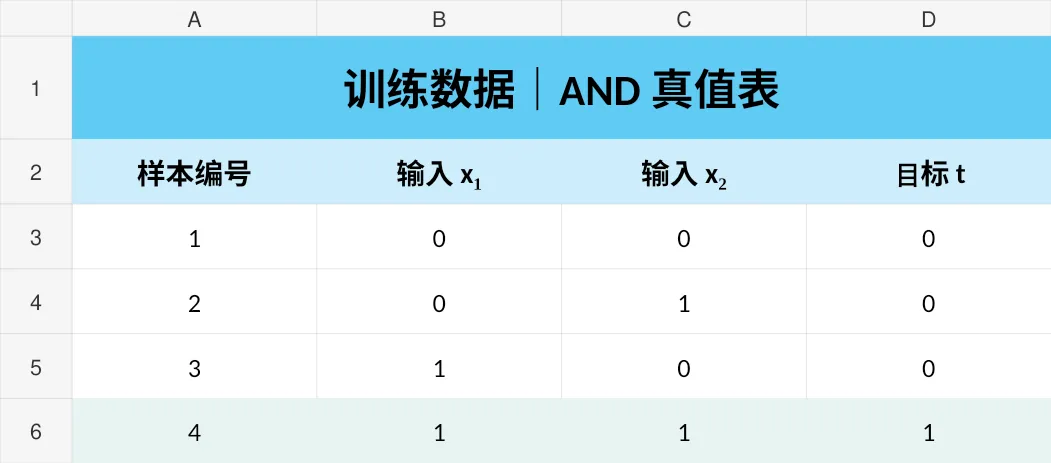
图 1|在「训练集」工作表中录入四条 AND 样本。
我们不会直接给神经元写下“与运算”的判断逻辑,而是让它依次处理这四条数据:预测正确就保持参数不变,预测错误就按规则修正参数。
这里要明确实验的边界:四条数据已经涵盖二进制 AND 的所有可能输入。 所以,最终达到 100% 准确率,意味着神经元完整实现了这张真值表,并不意味着它获得了处理任意复杂任务的能力。
02|一个神经元,到底在算什么?
可以先把神经元理解为一个“加权求和,再判断是否过线”的装置。
输入 x₁ ── ×w₁ ──┐ ├─ 求和 ─ 减去阈值 θ ─ 阶跃函数 ─ 输出 y输入 x₂ ── ×w₂ ──┘第一步,计算净输入:
其中,、 是两个输入各自的权重, 是阈值。它们就是需要通过训练调整的三个参数。
第二步,把净输入交给阶跃激活函数:
也就是说,净输入大于或等于零就输出 1,否则输出 0。
先记住一个重要约定:本文采用 。 这与 Excel 函数 GESTEP(数值) 的默认判定一致。有的教材使用 ,两种定义都可以讨论,但训练和验证必须采用同一套规则。恰好落在决策边界上的样本,会因此得到不同的输出。
如果你接触过神经网络中的偏置(bias),它与本文阈值的关系是:
本实验把三个参数全部初始化为零:
不妨先想一想:此时无论输入什么, 都是零。由于我们约定 ,神经元会把四道题全部回答为 1。
它只答对了 ,另外三题全错。接下来,训练的任务就是寻找一组参数,让四个样本都能被正确分类。
03|答错以后,参数怎样调整?
先定义预测误差:
因为目标输出 与预测输出 都只能取 0 或 1,所以误差只有三种可能:
比如,某个本应输出 1 的样本被判成了 0,我们就需要让它的净输入 往正方向移动;反过来,如果把 0 错判为 1,就让 往负方向移动。
如何把这个想法写成统一的更新规则?引入学习率 ,表示每次修正的步长。对于当前神经元,经典感知机可以使用:
为什么权重的更新量还要乘以输入 ?
以 为例。如果当前 ,那么 无论怎样改变,都不会影响这条样本的净输入。因此,这次修正不必调整 。相较之下,阈值 会影响所有输入组合的净输入。
这是不是梯度下降?
这是一个非常容易混淆的地方。
阶跃函数在 时导数为 0,在 时不可导。因此,不能直接对这个阶跃函数使用常规链式法则,通过输出误差进行普通梯度下降。
我们这里采用的是感知机的误分类更新规则:利用“分类对还是错”以及输入的取值,确定参数该往哪个方向移动。它不需要计算阶跃函数的导数。
现代多层神经网络通常使用 Sigmoid、ReLU 等可微或几乎处处可微的激活函数,再结合损失函数和反向传播进行训练。这是后续学习的内容;眼下先弄清感知机怎样更新参数,就已经迈出了关键一步。
04|动手搭建:让 Excel 完成一次训练
教学工作簿分为四个工作表:
训练集:保存四条真值表。 参数:设置学习率和初始权重、阈值。 训练明细:逐样本记录预测、误差和参数更新。 轮次汇总:检查每轮训练结果与收敛情况。
下面按照实际工作簿的单元格位置操作。
第一步:设置训练参数
在「参数」工作表中填写:
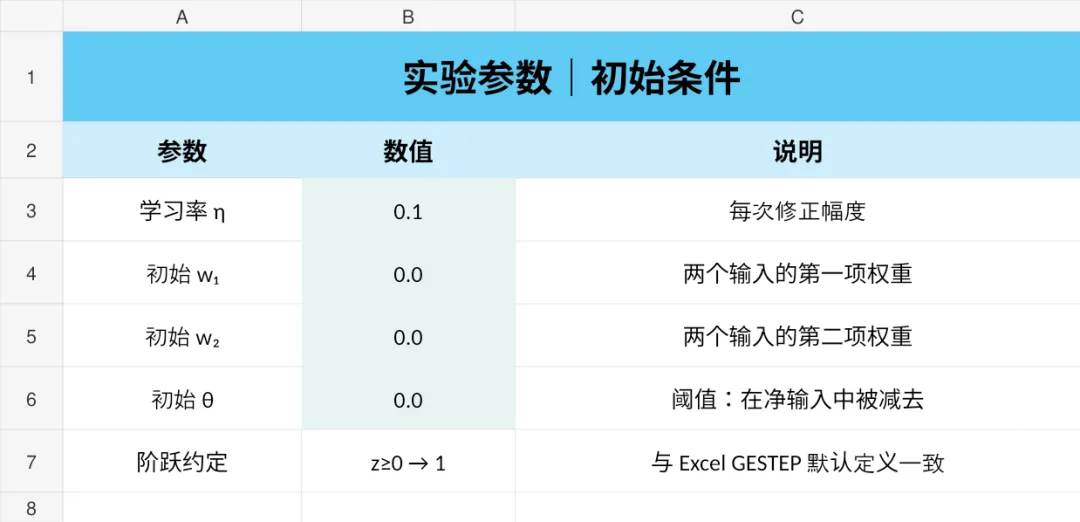
图 2|三个初始参数和一个学习率,决定了这次训练的起点。
在训练过程中,学习率保持 0.1,权重和阈值则随着每次误分类而变化。
第二步:建立「训练明细」
为了追踪每一次变化,我们让一行代表处理一条样本,并在同一行记录更新前的计算结果和更新后的参数。
在这份模板中,第 3 行放初始参数,第 4 行才开始处理第一条样本。
首先,把 M3、N3、O3 分别设置为:
=参数!B4=参数!B5=参数!B6然后让第一条样本的 C4:E4 分别引用「训练集」中的输入和目标:
=训练集!B3=训练集!C3=训练集!D3后面三条样本依次引用「训练集」第 4~6 行。每轮都保持相同的样本顺序:
第三步:填写前向计算公式
在 F4 计算净输入:
=ROUND(C4*M3+D4*N3-O3,10)注意这里用的是上一行的参数,也就是本次样本处理之前的参数。
在 G4 根据阶跃函数得到预测值:
=IF(F4>=0,1,0)也可以直接写成:
=GESTEP(F4)这里使用 ROUND(...,10) 是为了减轻十进制小数在计算机浮点运算中产生的微小偏差,避免本应为零的结果被判成一个极小的正数或负数。在当前这个简单的教学实验中,保留十位小数足够;它是一项数值处理约定,而不是感知机算法本身的必要步骤。
第四步:计算误差和更新量
在 H4 计算误差:
=E4-G4在 L4 引用学习率。这里使用绝对引用,向下填充时仍指向同一个参数单元格:
=参数!$B$3接着依次在 I4、J4、K4 输入三个参数增量公式:
=L4*H4*C4=L4*H4*D4=-L4*H4这样,Excel 就能根据预测误差自动确定:该改哪些参数,以及每个参数要改多少。
第五步:得到更新后的参数
在 M4、N4、O4 输入:
=ROUND(M3+I4,10)=ROUND(N3+J4,10)=ROUND(O3+K4,10)至此,一行表格便完成了一个完整的学习步骤:
读入样本 → 计算净输入 → 预测 → 计算误差 → 更新权重与阈值。
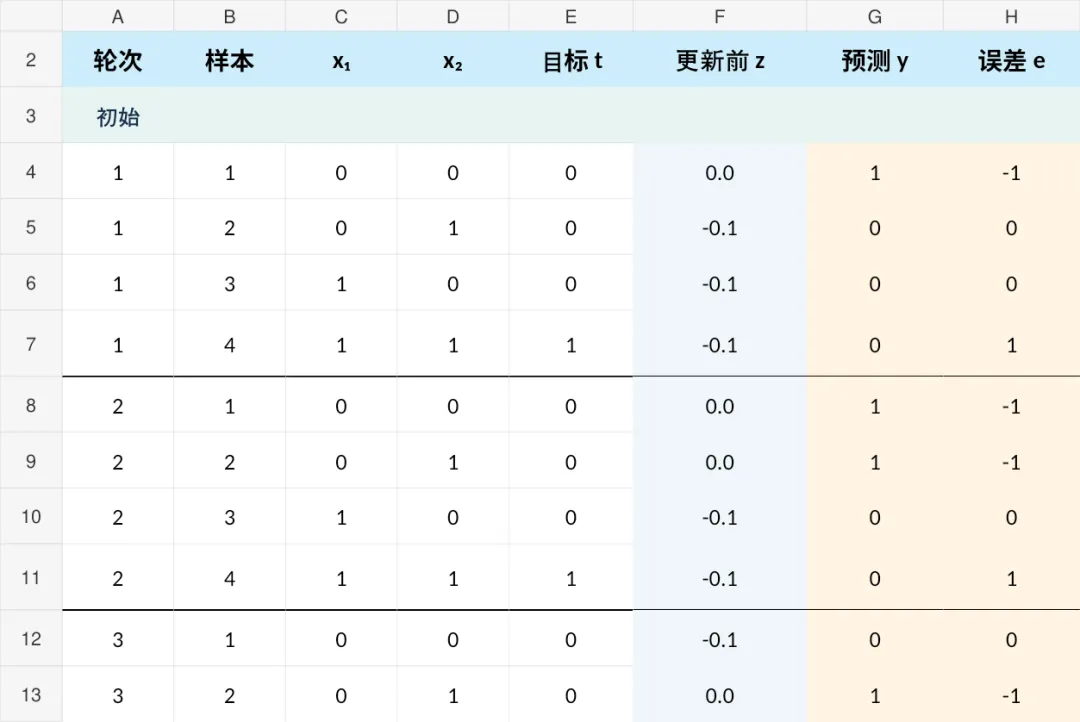
图 3|左半表:观察神经元拿到当前样本后,如何得到预测结果和误差。
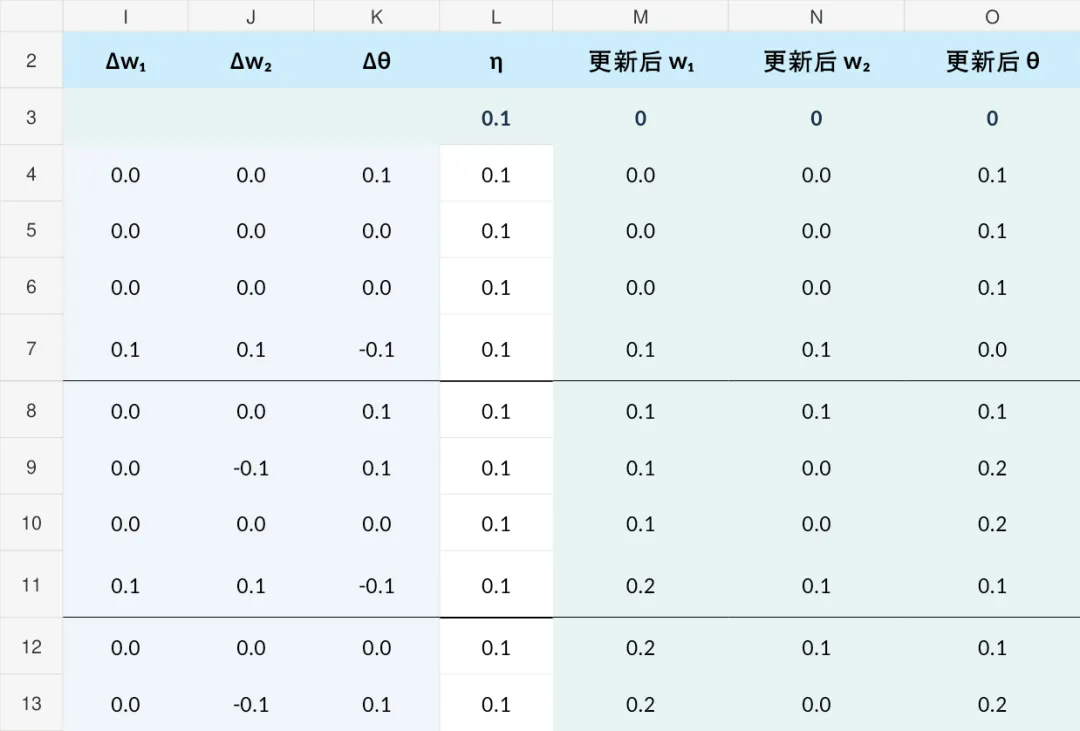
图 4|右半表:每次预测后,三个参数如何变化。
第六步:复制公式,形成多轮训练
每轮包含四条样本。第 1 轮使用第 4~7 行,第 2 轮使用第 8~11 行,以此类推。
在 A4 输入轮次公式:
=INT((ROW()-4)/4)+1在 B4 输入样本编号公式:
=MOD(ROW()-4,4)+1向下填充到第 27 行,就得到 6 轮 × 4 条样本 = 24 次样本访问。
样本数据的引用也按四行一组循环:第 4~7 行引用训练集,第 8~11 行引用上一轮的 C4:E7,后续依次重复。配套模板已经设置好这部分引用。
最后,将 F4:O4 的计算公式向下填充至第 27 行。由于每行都引用上一行更新后的参数,下一条样本总是接着上一条样本的结果继续训练。
这种处理方式称为逐样本在线更新(online update)。它不同于先计算完全部样本、再统一更新一次参数的批量更新。
05|亲自算两步,看见神经元第一次“学习”
表格搭好了,但最好先不用 Excel,亲手算两步。算过以后,公式才不只是一串字符。
第一次更新:让 不再被错判
第一条样本是:
初始参数全为 0,故:
预测错了,误差为:
学习率为 ,三个参数的变化量分别是:
因此更新后:
这一步最有意思的地方是:两个权重都没有变化,只有阈值增大了。 因为输入本身全为零,改变权重并不能修正这条样本;提高阈值,才能让它的净输入变成负数。
第四条样本:让 输出 1
第一轮的第二、第三条样本,此时均能正确分类,参数不会变化。
所以处理第四条样本 时,参数仍然是:
计算得到:
可是目标输出是 ,于是:
这一次需要提高净输入:
第一轮结束后的参数是:
你或许已经发现:一次更新能纠正当前样本,却不保证其他样本也因此变得更准确。
感知机的训练不是直接求出唯一正确答案,而是在不同样本的约束之间反复调整,直到找到一组能让所有样本都分类正确的参数。
06|训练了六轮,什么时候才算“学会”?
把全部四个样本按顺序处理一遍,称为一个训练轮次(Epoch)。
按照前面的设置,训练过程如下:
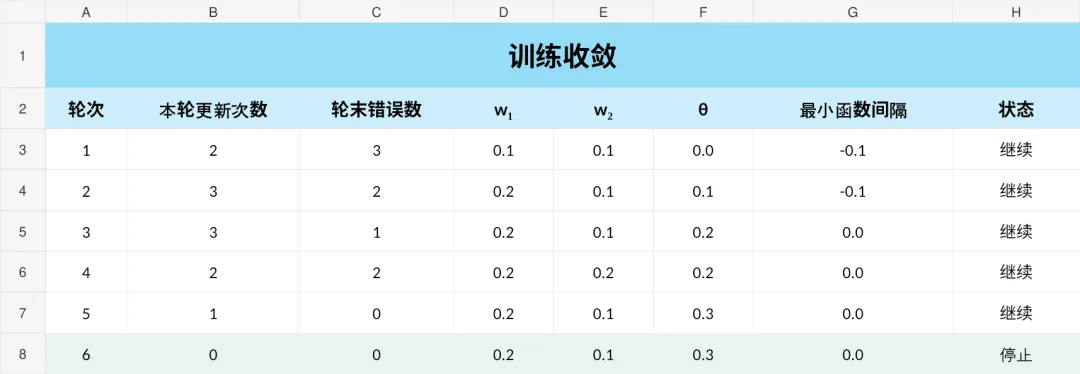
图 5|第 5 轮末已经全部分类正确;第 6 轮没有再更新参数,训练正式停止。
这里有两个容易混为一谈的指标:
本轮更新次数,统计的是遍历四条样本时发生了多少次误分类,因此进行了多少次参数更新。
轮末错误数,则是在这一轮全部更新结束后,固定最终得到的那组参数,重新预测四个样本,统计仍有多少条分错。
两者不一定相等,因为前面某次更新可能改变后面样本的判断,也可能使之前正确的样本暂时变错。
看第 3、4 轮就很明显:轮末错误数先从 1 增加到了 2。这说明,感知机每轮的分类错误数不一定单调下降,不能以“本轮比上轮更差”来判断训练失败。
如何确定停止条件?
本实验采用一条简单而可靠的规则:
完整遍历四条训练样本,如果一整轮都没有发生参数更新,就停止训练。
因此,第 5 轮末虽然已经达到 100% 准确率,但仍然用第 6 轮确认一次:四条样本全部预测正确,参数一次也没有更新。
总共经历了 6 轮、24 次样本访问、11 次参数更新。
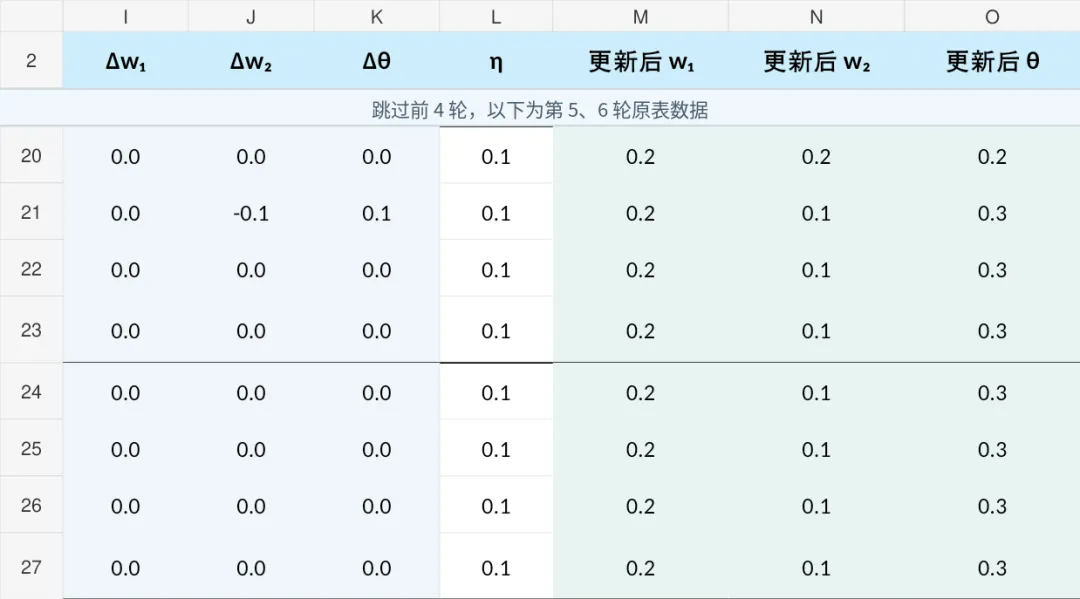
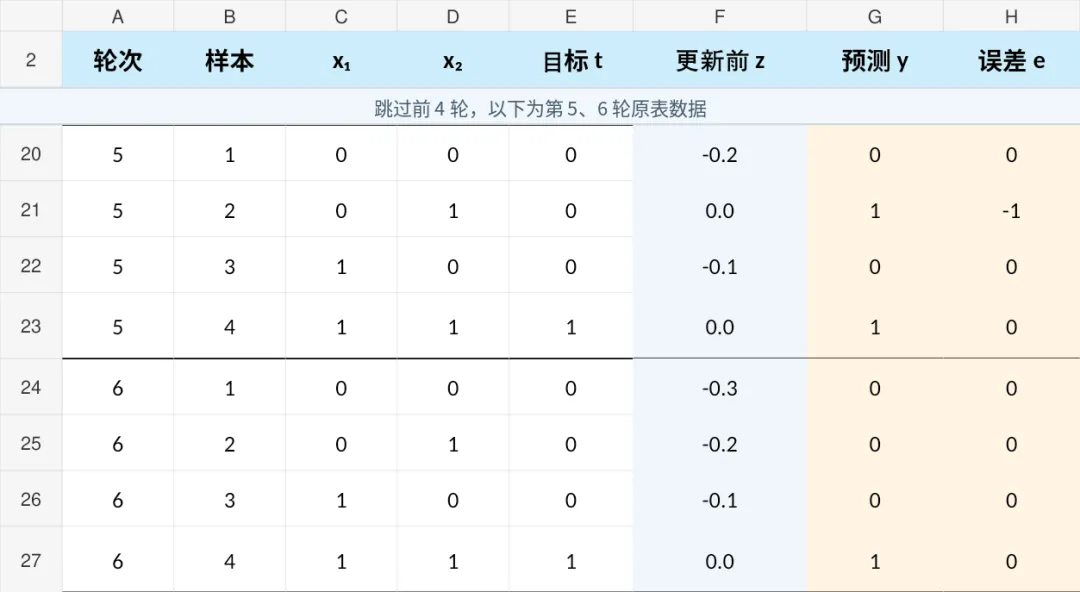
图 6—7|最后两轮的预测与参数记录。为了适合手机阅读,将同一工作表的表头及第 5、6 轮数据组合展示,并标明省略的中间行。
在 Excel 中自动统计
例如,「轮次汇总」中可以用第 1 轮误差区域统计更新次数:
=COUNTIF(训练明细!H4:H7,"<>0")第二轮改为 H8:H11,之后每轮向下移动四行。
如果汇总表 B3 存放该轮更新次数,那么在相应的停止状态单元格中可以使用:
=IF(B3=0,"停止","继续")这里要特别区分:统计更新次数可直接查看误差列;统计轮末错误数,则必须用该轮结束时的同一组参数,重新计算四条样本的预测结果。
最终参数与验证
训练结束后,得到:
也就是说,神经元学会了下面这条判定规则:
代入全部真值表:
四道题,全部答对。
需要说明的是:这组权重和阈值不是唯一解。只要满足 AND 的分类约束,就可能存在其他同样正确的参数组合。
07|准确率 100%,就说明训练结果足够好吗?
如果只要求实现这张真值表,答案是肯定的;但如果还关心对参数扰动的稳定性,事情就没有这么简单。
再看最终模型:
当输入 时:
这个正类样本恰好落在决策边界上。按照本文约定的 ,它仍然被正确分类;可是,如果阈值从 稍微增加到 :
预测结果就会变成 0。
所以,分类正确不等于分类边界足够稳健。 这也引出了机器学习中的另一个重要概念:分类间隔(margin)。
在本文 的约定下,要让 AND 四条样本都分类正确,参数需要满足:
这一约束也意味着有效的两个权重必须为正。
如果固定训练得到的权重 、,那么阈值可以选择在 内。比如手动把 改为 ,四条样本的净输入依次为:
不仅全部分类正确,而且每条样本都位于决策边界的正确一侧,并留有一定余量。
但要注意: 只是我们训练后手动举出的另一组有效参数,并不是原本的感知机算法自动找到的最优解。
如果希望训练过程主动追求更大的分类间隔,还需要进一步研究带间隔感知机、支持向量机(SVM)等方法。
08|从一个感知机,走向真正的神经网络
回头看,我们训练的只是最基础的单个感知机。但它已经包含了许多神经网络的基本元素:输入、权重、阈值或偏置、激活函数、误差反馈,以及通过训练调整参数的过程。
当然,今天的多层神经网络远比它复杂。大量隐藏神经元通过非线性变换构造新的特征表示,训练过程通常依赖损失函数、反向传播和梯度优化。
单个感知机还有一个明确的能力边界:它只能构造线性决策边界。
AND 运算的四个点可以被一条直线分开,因此一个感知机就足够了。XOR(异或)运算的正负样本却交错分布,无法被单条直线分开。想要解决它,就需要合适的非线性特征映射,例如由隐藏层提供的非线性变换。
由此再看这次 Excel 实验,它的意义不在于模型有多复杂,而在于我们终于能亲眼观察:
所谓“学习”,并不是神经元突然理解了与运算,而是训练算法根据样本反馈,持续修改参数,直到找到一条满足分类要求的决策边界。
留给读者的三个小实验
如果你也搭好了这张 Excel 表,可以在原有公式不变的前提下,尝试改变三个条件:
改变学习率:把 改成 ,观察参数的数值尺度与更新次数有何变化。 改变样本顺序:让 先进入训练,观察收敛轨迹是否相同。 改变训练目标:把 AND 改成 XOR,看看单个感知机为什么难以让全部样本同时分类正确。
你会发现,真正有价值的不只是最终准确率,而是参数如何变化、为何能够收敛,以及何时无法收敛。
一张电子表格,未必能替代机器学习框架;但作为理解神经网络工作原理的第一块实验台,它已经足够清晰。

