深入理解agent学习笔记(十二)——记忆的可执行状态与治理
- 2026-11-05 10:14:00
点击下方卡片,关注“人工智能陈小白”
视觉/大模型/图像重磅干货,第一时间送达!
1. 两个尺度:个人记忆与共享知识
记忆进阶:可执行状态与治理
1. 从文本记忆到可执行状态
Simple Notes、Enhanced Notes、JSON Cards 本质上都是文本:擅长召回单条事实,却要把聚合、冲突检测与约束执行交给 LLM「心算」。
User as Code 换了一种思路:把用户状态改成带类型的可执行对象,把规则写成普通函数,让「表示」和「推理」使用同一种可验证介质。它借鉴「预写日志 + 检查点」:会话结束后先把事实追加到只增日志,再定期从完整日志重建带类型的状态。既保留原始证据,也得到可查询、可执行的派生状态。
state = {"passport": PassportInfo(number="AB1234567",country="US",expiry_date=date(2025, 2, 18),),"trips": [Trip(destination="Tokyo", departure_date=date(2025, 1, 15),is_international=True),...],}
带类型的状态把原本需要 LLM「读一遍再心算」的操作交给确定性函数:
# 聚合统计count(trip for trip in state.tripsif trip.is_international andyear(trip.departure_date) == 2025)# => 2# 冲突发现:当前用药与过敏史交叉比对def check_drug_allergy(profile):for medication in profile.current_medications:for allergy in profile.allergies:if medication.drug_class == allergy.drug_class:emit_conflict(medication, allergy)# 约束执行:状态更新后自动检查护照有效期def check():for trip in state.trips:if trip.is_international:days = date_difference(state.passport.expiry_date, trip.departure_date)if days < 180:alert("passport expires too soon", trip, days)
这种表示的优势是可测试、可复现:聚合结果、冲突判断、约束检查都是代码,不依赖模型这次是否「算对」。代价是需要设计类型与规则,且不适合高度自由的自然语言知识。
2. 认知科学给的另一维视角
认知科学把记忆分为工作记忆与长期记忆。工作记忆对应 Agent 的上下文窗口——当前任务的临时信息空间(轨迹是其中最重要的内容,也可能包含从长期记忆激活的信息)。长期记忆又分三类:
- 情景记忆
:具体事件与经历。「上周三和同事在意大利餐厅吃饭」;Agent 对应「用户订了下周五去东京的 ANA 航班」——记录了事件的时间、对象与细节。 - 语义记忆
:从事件中抽象出的一般知识。「意大利首都是罗马」;Agent 对应「用户是素食者」「偏好靠窗座位」——不是某次对话记录,而是多次交互提炼出的稳定特征。 - 程序记忆
:行为模式与流程。骑自行车的能力;Agent 对应「先搜直飞 → 确认座位 → 用常旅客号 → 订餐」这类反复出现的流程。
三套分类体系(存在哪里、怎么存、存什么)是正交的,可以自由组合。选择格式取决于工程需求(简单性与表达力),选择类型取决于业务场景(记事实、事件还是流程)。
3. 两种记忆框架的设计取舍
3.1 Mem0:冲突处理从写入移到检索
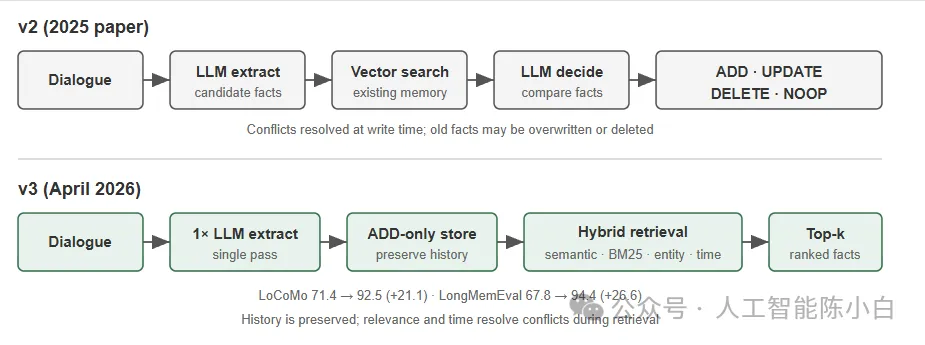
图 1:Mem0 记忆管理架构
Mem0 的演进很能说明系统设计取舍:
- 2025 年论文与 v2:写入时消歧。
对话结束后,LLM 抽取候选事实;系统用向量检索找到相近的已有记忆,再由 LLM 在 ADD、UPDATE、DELETE、NOOP 中做决定。用户先说「我住在北京」,后说「我搬到了上海」,系统会把前一条 UPDATE 成「住在上海」,在写入时消除冲突。优势是记忆库始终简洁一致;风险是一次错误的更新或删除会不可逆地丢历史,而且每条候选事实都要经历检索与第二次 LLM 判断。 - 2026 年 v3:只追加 + 混合检索。
一次 LLM 调用抽取事实,并且只做 ADD;「住在北京」与稍后的「搬到上海」作为带时间信息的两条事实并存。查询时融合语义相似度、BM25 关键词与实体匹配,再结合时间排序。这样避免错误 UPDATE/DELETE 丢历史,减少 LLM 调用,还能用多种信号找出当前事实。Mem0 报告 LoCoMo 从 71.4 提升到 92.5,LongMemEval 从 67.8 提升到 94.4。
这个反转的启示是:冲突不一定要在写入时解决。保留带时间的事实、在检索时判断「哪一条是当前有效」,往往比不可逆地覆盖更稳。代价是查询侧要处理更多候选与时间信息。
3.2 Memobase:聚焦用户画像
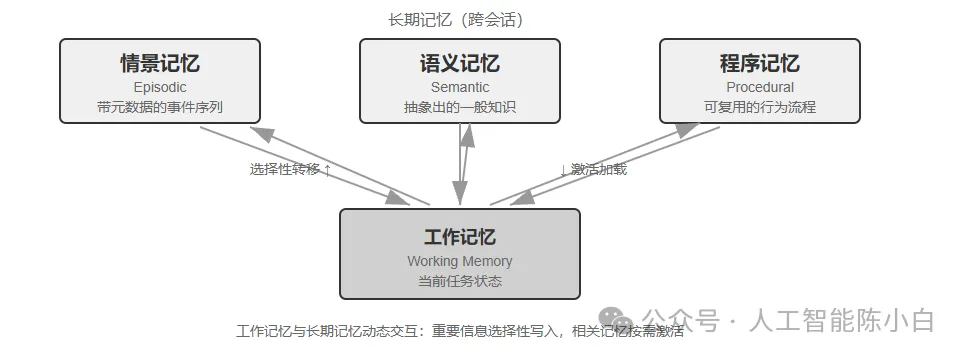
图 2:多类型记忆协同的参考架构
Memobase 不与 Mem0 拼通用流水线,而是聚焦「用户画像」这一具体形态:
- 用户画像(Profile)
:一组可由开发者配置的槽位,按主题—子主题两级组织(如 basic_info→ 姓名、interest→ 兴趣、work→ 职位),存放从对话中提取的稳定属性; - 事件记忆(Event Memory)
:按时间线记录用户经历的事件,回答「我们上次讨论预算是什么时候」这类与时间有关的问题。
工程上采用缓冲批处理:对话先在缓冲区累积,达到规模或时限后统一触发一次记忆提取,摊薄 LLM 调用成本;查询侧只读已整理好的画像与事件,保证低延迟。
两个框架只覆盖了记忆设计空间的一部分:Mem0 的事实条目接近语义记忆,Memobase 的画像近似语义记忆、事件记忆近似情景记忆。把视野放宽,可以设想多类型记忆协同的参考架构:
- 情景 / 语义 / 程序记忆
:沿用认知科学三类定义;其中情景记忆的重点是多维元数据检索——存时间戳、情感标记、任务标识,可按时间、主题组合查询; - 工作记忆
:管理当前任务状态,与长期记忆动态交互——重要信息选择性转移到长期记忆,相关长期记忆被激活加载到工作记忆。
要区分工作记忆与「轨迹」:两者都为当前决策提供即时上下文,但轨迹是不可变的完整事件序列,工作记忆是经过筛选与激活的动态子集。实际框架往往只实现一两种类型,按业务取舍比追求「大而全」更现实。
4. 记忆压缩与整理
交互持续进行,记忆系统面临存储与检索效率的双重挑战。简单累积会导致记忆爆炸,不仅占空间,还降低检索准确性。
可以分三层压缩:
- 重要性评分筛选
:综合访问频率(常被检索的重要)、时间衰减(越久远越易遗忘)、情感强度(强烈情感更易保留)、信息独特性(重复信息降权)。低于阈值的记忆标记为可压缩或可删除。例如一条被访问 5 次、创建 3 天、带强情感标记、无重复的记录得分较高;一条仅访问 1 次、创建 90 天、无情感、与 3 条记忆高度重复的记录则可能低于阈值。 - 聚类
:相似记忆分组,每组生成代表性摘要(多次天气对话压缩为「用户经常询问天气,特别关心降雨」),原始细节归档到二级存储。 - 抽象与泛化
:从具体情景记忆提取一般规律,转化为语义或程序记忆。例如从多次购物对话学到「偏好性价比高的产品,重视用户评价」。
5. 隐私:日志脱敏
用户记忆的核心挑战是:既能利用信息提供个性化服务,又不让敏感数据暴露在 LLM 上下文与系统日志里。
一个可行方案是本地模型脱敏:用本地部署的小模型(如 Qwen3 0.6B,可跑在 CPU 或消费级设备)做 PII 检测。选择本地而非云端 API 的原因很明确——日志本身可能含敏感信息,发送到云端脱敏就违背了初衷。
系统要能识别三类信息:
- 结构化
:身份证号、银行卡号; - 半结构化
:地址; - 自然语言表达的敏感内容
:如「我的密码是 abc123」。
识别结果通过 JSON Schema 结构化输出,包含类型、位置与置信度。相比传统正则,基于 LLM 的脱敏召回率可达 95% 以上,同时显著降低假阳性。超高吞吐场景可以用混合策略:正则快速过滤明显模式,LLM 深度分析剩余文本。
6. 补记
可执行记忆与文本记忆不是替代关系,而是分工:需要确定性聚合、冲突检测、约束执行的少量关键状态,适合可执行表示;大量、模糊、需要语义检索的经历,适合文本 + 检索。
记忆治理最难的不是存储,而是「谁有权改、改错了怎么回滚」。把记忆库当代码库管理——变更走 diff、审核、版本与回滚——比让模型直接覆盖更可靠。这与后面知识库更新的思路一致。
欢迎同学添加小助手,获取代码或加入人工智能圈交流群