用 Trae 做代码安全审计:6 步流程,模板全给
- 2026-10-31 23:56:32
上个月帮朋友看一个 Java 项目。
扫描器出了一份报告,两百多条告警。他盯着那份 Excel 看了两天,最后真正要改的只有 11 条。
剩下的一百多条里,一半是框架已经处理过的,一半是扫到了测试代码。
这不是扫描器的问题。规则匹配本来就不知道“这个参数其实在上一层被转成 int 了”。它只能告诉你:这里看起来像。
我后来用 Trae 把这个流程重做了一遍。同样的仓库,从两天压到半天,200 多条压到 17 条,每条都带调用链和复现。
但我得先说清楚一件事:
Trae 不是扫描器。把它当扫描器用,你会得到一份更会说谎的报告。
这篇讲的是怎么用它——从划边界到出报告,六步走完。所有模板你都能直接抄。
一、先说清楚它会在哪儿翻车
我见过太多人是这么用的:把仓库拖进 Trae,输入一句“帮我找一下代码里的安全漏洞”,然后等它吐一份报告。
前三次都会让你觉得值。第四次开始你会发现问题:
它说得越笃定,你越不敢信。
这不是错觉。把大模型当独立扫描器用,有四种坏法,而且都被写进论文了。
第一种,报出根本不存在的东西。它能给你写一段看起来很专业的攻击路径,但那个函数在你项目里压根没有。有一份对 Linux 内核的抽样,400 条 AI 判定里 246 条被确认真实有效,剩下的多是误报——原因包括跨过程推理不足,比如看不清调用方是不是已经做了清理。
第二种,跨文件就跟不上。真漏洞常常要顺着 Controller 追到 Service,再追到拼 SQL 的那一行。超过六层调用、跨文件的链路,它要么看不到,要么自己接错线——而它不会告诉你哪一段是猜的。
第三种,它只看得到你给的那一角。企业项目几十万行。就算上下文开到百万 token,真正相关的那张调用图也塞不进去。你没给它的部分,它会当成不存在。
第四种,同一份代码跑两次,结论不一样。有研究把同一份 70 个 commit 的代码喂给 4 个模型、各跑 5 轮、温度设成 0,结论每轮都不同。而审计要的是一份能被复核的记录,不是一次随机抽样。
再看一组数:单纯让 GPT-4 扫智能合约,召回能到 88%,但准确率只有 22.6%。翻译一下——它标出来的四个问题里,三个是假的。
另有一份 2026 年的统计更扎心:开发者拒收了 56.3% 的 AI 代码审查意见,拒收原因里排第一的就是误报。
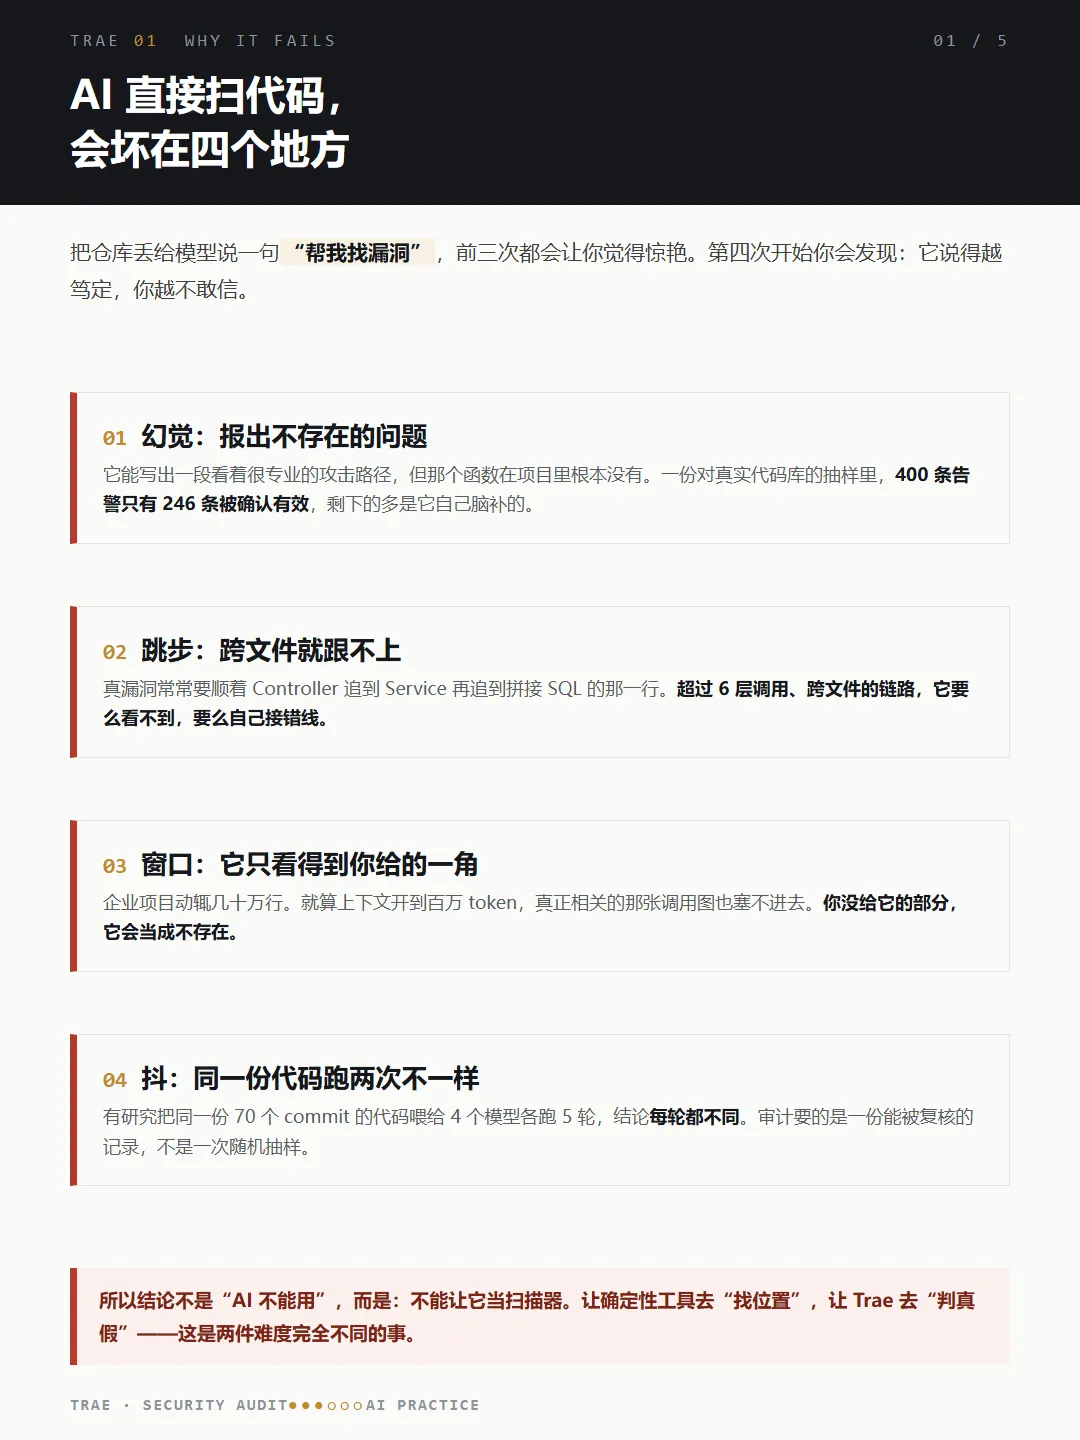
所以问题从来不是“AI 能不能看懂代码”。它能。问题是“发现”和“判断”是两件难度完全不同的事,而大家习惯让它一次做完。
二、把“扫”和“判”彻底拆开
这是我在这套方法里最想让你记住的一张图。搞混了它,后面所有配置都是白费。
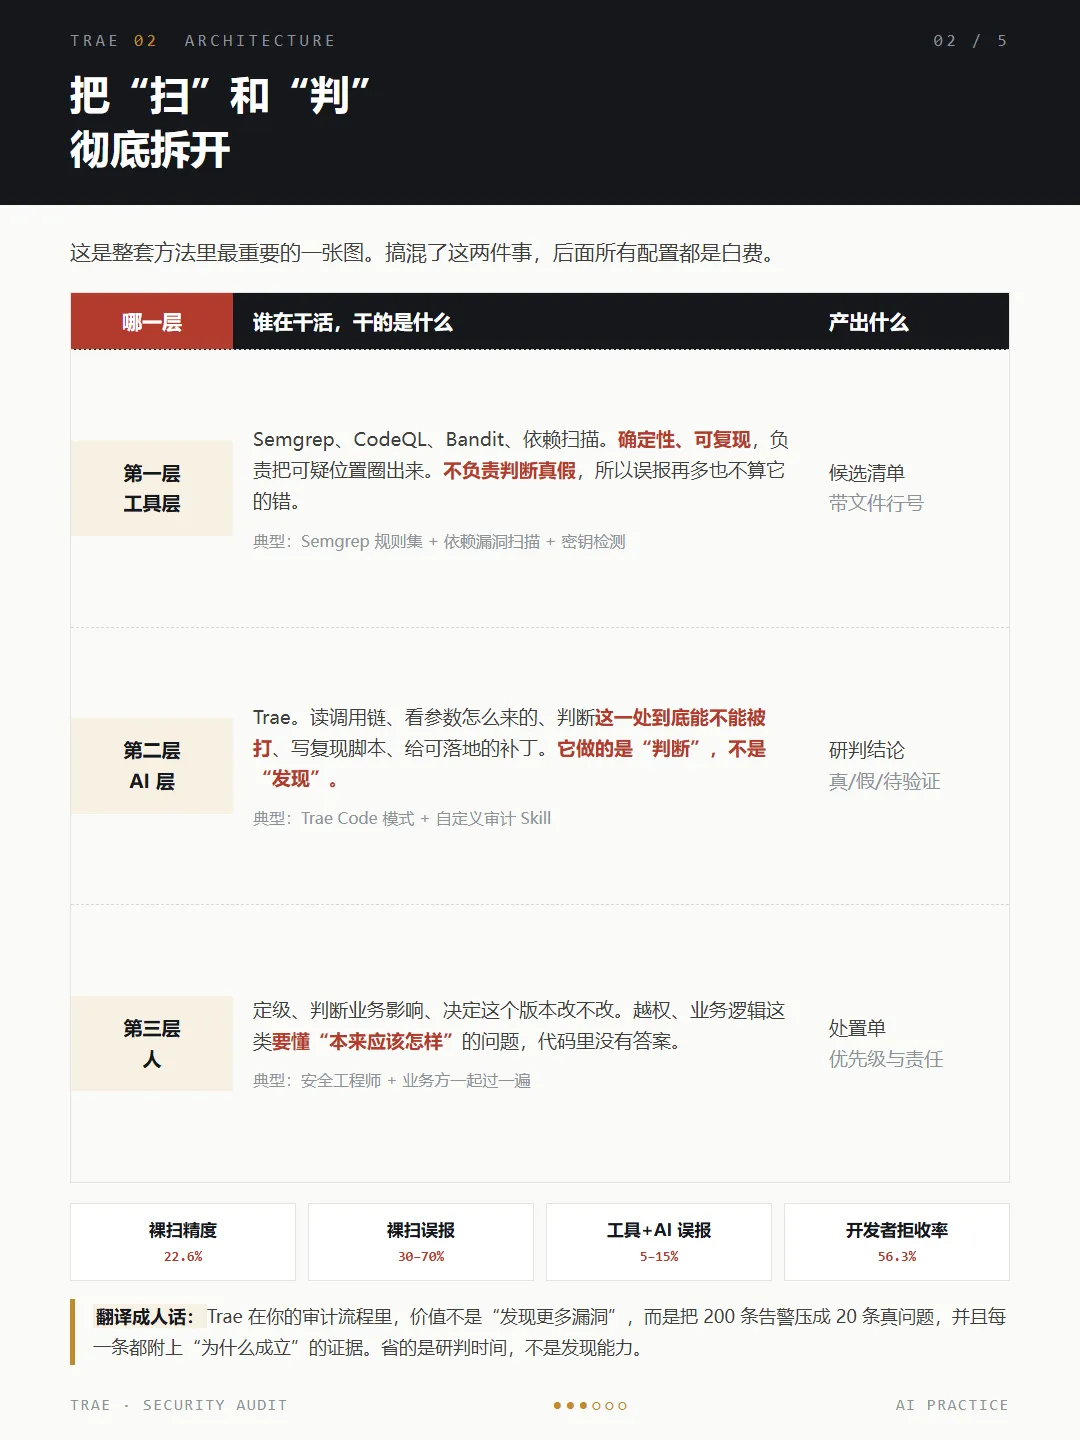
第一层是工具层。Semgrep、CodeQL、Bandit、依赖漏洞扫描,这些确定性工具负责把可疑位置圈出来。它们可复现、不抖动、不会编,但也笨——不懂上下文,所以误报多。
记住:工具层的 KPI 不是准确率,是覆盖率。你宁可它多报,也别漏。
第二层才是 Trae。它的活不是“再找一遍”,是判断“这一处到底成不成立”:这个参数从哪来?中间有没有被处理?能不能从外部真的打到?
这是个窄得多的问题,也是它真正擅长的问题。
第三层是人。定级、判断业务影响、决定这个版本改不改。越权、业务逻辑这类问题,代码里根本没有答案——它不知道“这个订单本来应该只属于当前用户”。
这三层拆开之后,效果是能被量化的。
IRIS 那项研究(ICLR 2025)在 CWE-Bench-Java 的 120 个真实漏洞上做了对比:CodeQL 单独跑出 27 个,接上 GPT-4 做研判之后到 55 个。工具负责找位置,模型负责判真假,两边都不越界。
另一个方向的数据更有意思:QASecClaw 拿 OWASP Benchmark 的 2740 个用例测试,在 Semgrep 输出上叠一层大模型过滤,消掉了 88.6% 的误报,只损失 3.1% 的真问题,F1 从 78.39% 提到 90.93%。
这就是 Trae 在你审计流程里的真实定位:它不负责发现更多漏洞,它负责把 200 条告警压成 20 条真问题,并且每条都告诉你为什么成立。省的是研判时间,不是发现能力。想清楚这一点,后面每一步都顺了。
三、六步走完一次完整审计
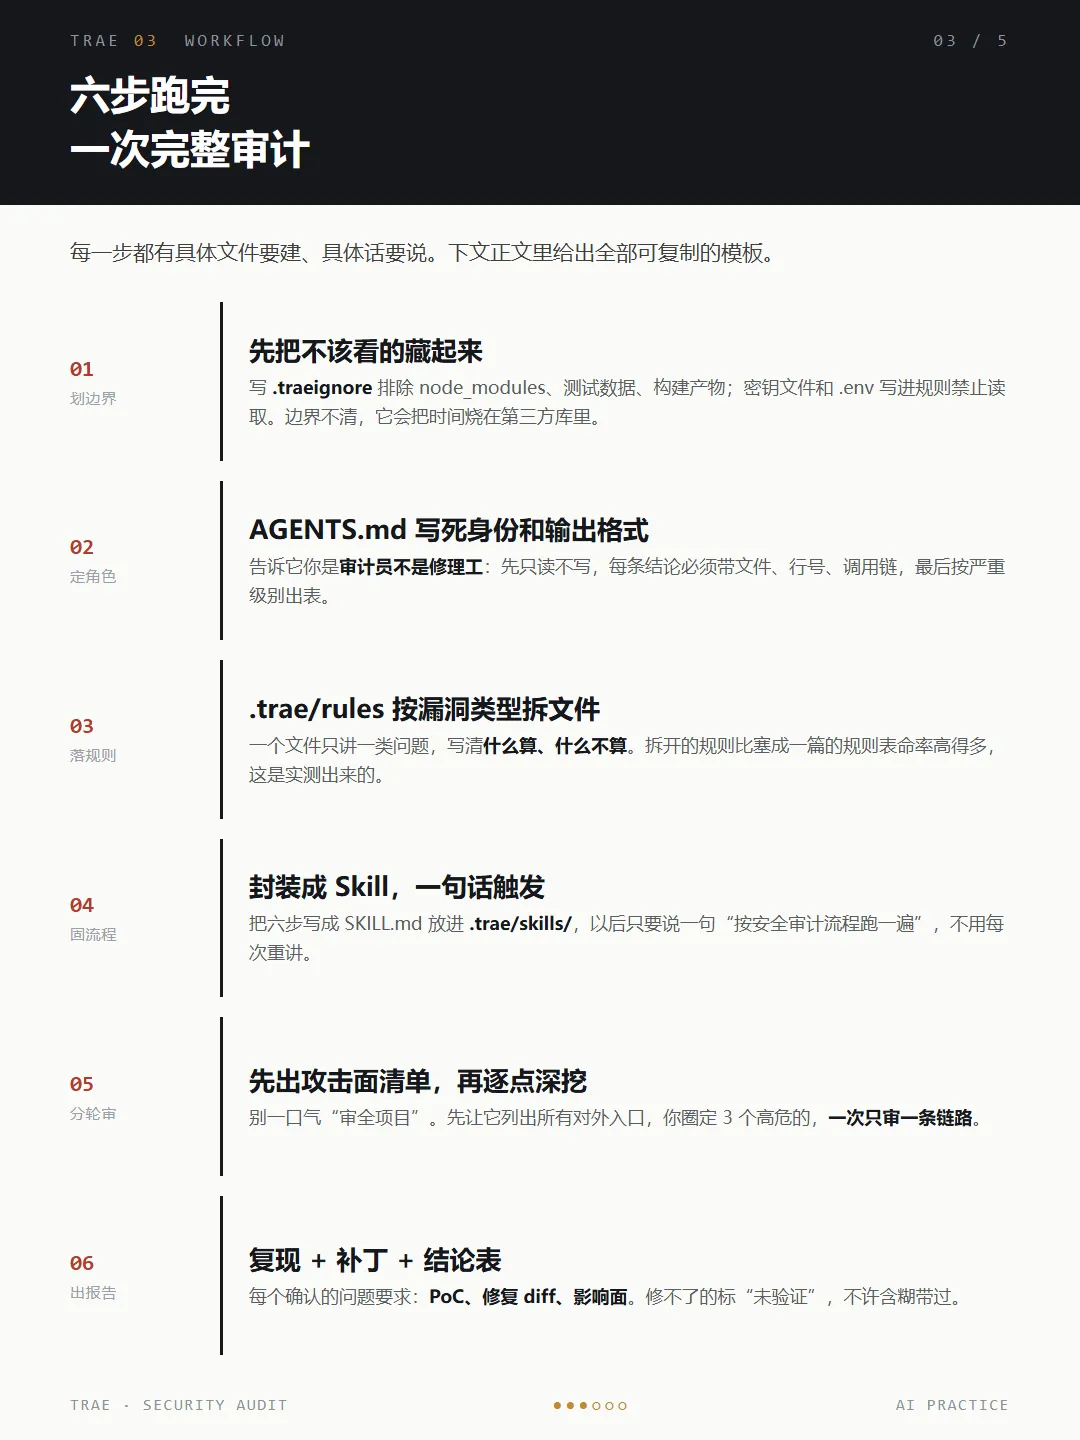
下面每一步都给出具体文件、具体内容。你照着建就行。
先分个类:第 1 到 4 步是一次性配置,做完就一直有效;第 5、6 步是每次审计重复执行的。正式开审之前,先把 Semgrep 跑一遍,把结果贴进对话——这就是第二节说的工具层打底。没这一步,Trae 就是在裸扫。
第 1 步:先划边界,别让它看无关代码
这一步最少人做,但效果最明显。项目根目录建一个 .traeignore:
项目根目录 / .traeignore
node_modules/vendor/dist/build/target/*.min.js**/test/****/fixtures/****/mock/****/__snapshots__/**
第三方库、构建产物、测试数据、mock,全部排除。这些东西进上下文只有一个结果:把真正该看的代码挤掉。
同时把密钥相关的东西钉死。在规则文件里写明:
不许读取 .env、*.pem、*.key、credentials.*、config/secrets.*。它要是为了“理解配置”去读了这些,你的密钥就进了对话记录。
另外看一下 Trae 的命令执行设置(Settings → Conversation Flow → Auto-run)。做审计时不要开 Auto Run,那个模式所有命令直接执行、不经过沙箱。
审计阶段你只需要它读代码,把权限收到 Manual run 或默认的 Sandbox with allowlist 就够了。沙箱能力以 macOS 和远程 Linux 环境为主,Windows 上建议直接用手动确认模式,逐条看命令再放行。
第 2 步:AGENTS.md,把角色和输出格式写死
项目根目录建 AGENTS.md。这一个文件决定了它后面所有回答的形状。(如果你的版本里没有识别这个文件,就把同样内容放进 .trae/rules/ 目录,作用一样。)
项目根目录 / AGENTS.md
# 安全审计工作区规则## 你的角色你是代码安全审计员,不是修理工。本轮任务只读:不修改、不新建、不删除任何业务文件。唯一例外:可以在 audit/ 目录下写报告和 PoC。## 输出硬性要求1. 每条结论必须给出:文件路径 + 行号 + 从入口到 sink 的完整调用链2. 调用链里出现的每个函数,必须能在仓库里搜到。搜不到就别写。3. 给不出调用链的,归入“推测”,不算结论。4. 严重级别只用三档:确认必改 / 需人工确认 / 已排除5. 不要给“整体安全评分”,那个数字没有参照系。## 判定口径- 只有能从外部输入到达的才算漏洞,内部工具函数不算- 框架已默认防护的(ORM 参数化、模板自动转义)先排除再谈- 拿不准的写“待验证”,不要往高处靠## 交互方式- 一次只审一条链路,审完等我确认再继续- 发现跨模块问题时,先画调用图,不要直接下结论
第 1、2 条是关键。它把“给结论”变成了“给证据”,而幻觉最容易死在“把每个函数名都指出来”这个要求上——编出来的函数一搜就没有。
第 5 条也别省。AI 特别爱在报告末尾来一句“综合评分 7/10”,这种数字除了让领导以为有量化,没有任何用处。
第 3 步:rules 按漏洞类型拆文件
在 .trae/rules/ 下建规则文件。重点不是写得多,是一个文件只讲一类问题。塞成一篇大杂烩的规则表,命中率会掉一大截。
.trae/rules/sql-injection.md
---description: SQL 注入审查规则,涉及数据库访问时生效globs: ["**/*.java", "**/*.py", "**/*.go", "**/*.xml"]---# SQL 注入## 什么算- 用户可控字符串进入 SQL 拼接(+ / String.format / f-string / %)- MyBatis 用 ${} 接收外部参数(#{} 是预编译,安全)- ORDER BY / 表名 / 列名用了外部参数:无法参数化,必须白名单## 什么不算- 参数化查询、预编译占位符- 值来自常量或配置,且不经过任何外部输入- ORM 链式查询且没有原生 SQL 片段## 判定要做的三件事1. 找到参数来源:request / header / cookie / 上游服务2. 沿调用链确认中间没被强制类型转换(如转 int)3. 看影响面:只是越权读,还是能堆叠执行## 输出要求注入点行号、参数来源链路、可复现请求、修复后代码
什么算和什么不算这两段是这套规则里最值钱的部分。只写“检查 SQL 注入”,它会把你项目里所有拼接字符串都标一遍;写清“参数化查询不算”,它才知道该放过什么。
再给一个越权的,这类规则最能体现差别:
.trae/rules/broken-access-control.md
---description: 越权与权限校验审查,涉及接口鉴权时生效globs: ["**/controller/**", "**/api/**", "**/handler/**"]---# 越权(水平 / 垂直)## 判定前提本项目的权限模型:- 登录态由 JWT 承载,userId 从 token 解析- 资源归属关系:order.user_id / file.owner_id / doc.tenant_id- 管理员角色:role = admin,单独走 @AdminOnly 注解## 什么算- 接口用路径或请求体里的 id 直接查资源,没有校验归属- 校验用的是请求里传来的 userId,而不是 token 里的- 写操作只校验了登录态,没校验角色## 什么不算- 已通过网关或拦截器统一鉴权,且拦截器覆盖了该路径- 资源本身是公共的(字典、公告)## 输出要求接口路径、缺失的校验点、构造越权的请求示例、需要补的校验代码
看到了吗——判定前提这一段是在把你的业务知识喂给它。它不知道“order 属于 user”,你得告诉它。
这也是为什么越权问题 AI 最容易漏:不是它不会看代码,是它不知道你的业务里什么叫“不该看到的”。
第 4 步:封装成 Skill,一句话触发
规则写好了,每次还得重新讲一遍流程,很烦。把流程本身写成一个 Skill,放在 .trae/skills/security-audit/SKILL.md:
.trae/skills/security-audit/SKILL.md
---name: security-auditdescription: 对指定模块做代码安全审计。当用户要求安全审计、 漏洞排查、审一下这个接口时使用。---# 安全审计## 流程1. 确认范围:只审用户点名的模块,不要自行扩大2. 画攻击面:列出该模块所有外部入口(HTTP/消息/定时/上传)3. 排优先级:按能否触达数据、是否需要登录排序,从最高危起4. 逐条深挖:一次只审一条链路,不要并行审多条5. 出结论:写入 audit/report.md,按三档分类## 禁止- 不要顺手改业务代码- 不要在缺少调用链的情况下下结论- 不要用“可能存在”这类模糊表述,要么给证据,要么标待验证## 报告模板见 audit/report-template.md
第 4 条“一次只审一条链路”是硬约束,别删。一口气审全项目,它必然开始糊——上下文一长,规则遵守率断崖式下跌。宁可分十轮。
第 5 步:分轮深挖,先出清单再审单点
到这一步才开始真正干活。顺序很重要:先让它列出所有入口,你圈定目标,再逐条深挖。
第一轮,只要一张表:
提示词 1 / 出攻击面
读 src/main/java/com/xxx/controller 下所有类,只做一件事:列出所有对外 HTTP 入口,按这个格式给我表格:路径 | 方法 | 是否需登录 | 入参里有没有直接落到数据库/文件/命令的不要分析漏洞,不要给建议,只要这张表。
拿到表之后,你自己圈三条最该看的——通常是文件下载、导出、带 id 查询这类。然后一条一轮:
提示词 2 / 单链路深挖
只看 /api/order/export 这一条链路。从 Controller 开始,把每一层调用的类名、方法名、文件行号列出来,一直追到真正执行 SQL 或写文件的那一行。列完之后回答三个问题:1. 哪些参数是用户可控的?2. 这些参数有没有在任何一层被过滤或转义?3. 如果我要构造恶意请求,最可能从哪个参数进去?先只回答这三问,不要给修复建议。
注意最后那句“先不要给修复建议”。不加这句,它会一边分析一边给方案,分析到一半就开始跑偏——因为它已经把“我要修什么”当前提了。
先定罪,再量刑。这两件事必须分开问。
这一轮的后半段:自证、复现、补丁
这是判断真假最有效的一招。它刚说完“这里有注入”,你立刻让它反过来论证:
提示词 3 / 自我反驳
你刚才判定这是 SQL 注入。现在反过来论证:如果这段代码其实是安全的,理由会是什么?把你能想到的辩护理由全部列出来,逐条判断成立不成立。如果最后发现它确实安全,直接说“我判错了”。
实测下来,这一句话能干掉相当一部分误报。原因很简单:正向提问时它会顺着你的暗示走,反向提问时它才真的去读代码。
然后要复现。跑得起来才算真:
提示词 4 / 最小复现
写一个能验证这个漏洞的最小复现:- 一个 curl 命令或 Python 脚本- 说明需要什么前置条件(登录态、特定数据)- 预期返回什么才算复现成功如果这个环境跑不起来,明确写“未验证”,不要假装能跑。
最后才要补丁:
提示词 5 / 修复方案
给出修复方案,要求:1. 最小改动,不要顺手重构2. 给出 diff 格式的前后对比3. 说明这个改动会不会影响现有功能4. 如果有多种修法,列出来并说明你推荐哪个、为什么
第 1 条也很关键。不写“最小改动”,它经常会顺手帮你把整个类重构了——然后你的 PR 变成八百行 diff,review 的人直接崩溃。
第 6 步:出一份能交差的报告
在 audit/report-template.md 里定好格式,让它照着填:
audit/report-template.md
# 审计报告:<模块名>范围 / 时间 / 使用的工具与版本## 一、确认必改### 1. <问题标题>- 位置:OrderController.java:88 → OrderService.java:142- 参数来源:GET /api/order/export?sort= 未校验拼入 ORDER BY- 影响:可读取任意表数据- 复现:curl ...(已实测 / 未验证)- 修复:改为白名单校验,diff 见附录## 二、需人工确认(判定依据 + 卡在哪儿,需要谁来看)## 三、已排除| 告警 | 排除理由 |## 四、本次未覆盖- 定时任务链路(无外部输入,本次未审)- 文件上传模块(另排期)
第四段本次未覆盖别省。这是区分“专业报告”和“AI 生成报告”最明显的一处——负责任的人会写清楚自己没看什么。
四、三个高频场景,问法差在哪
同样是问问题,问法不同,结论质量差一个量级。
场景一:SQL 注入
错误问法:“这段代码有 SQL 注入吗?”——它会顺着你的暗示说“有”,因为你已经告诉它答案了。
正确问法:“这个 sort 参数从哪来?中间有没有在哪一层被转成 int 或者做过白名单校验?把每一层都列出来。”
前者是让它表态,后者是让它查证。差别就这么大。
场景二:越权
这是 AI 最容易漏的一类,不是能力问题,是信息问题。它不知道你的资源归属关系。
做法:把数据模型和权限模型先贴给它——哪张表有 user_id、哪个中间件做统一鉴权、管理员怎么标识。然后再问:
“这个接口用路径里的 orderId 查订单。按我给你的归属关系,它有没有可能查到别人的订单?给出你能构造的请求。”
不给模型,它只能看到“查了个订单”。给了模型,它才能看到“查了个订单但没校验归属”。
场景三:硬编码密钥
这类它很擅长,正则一扫就有。但会漏“看起来不像密钥的密钥”:内网数据库地址、测试环境的固定账号、短得不像 token 的 JWT secret、写在注释里的旧密码。
补一句就够:“除了常见的 AK/SK 格式,再找找这几类:内网地址、固定账号密码、注释里的历史凭证、长度小于 32 位的 secret 变量。”
五、它会骗你,这四步能挡住
前面几节讲的是怎么让 AI 更能干活,这一节讲怎么让你别被它带沟里。
审计报告里最贵的不是漏报,是一条被 AI 说得斩钉截铁、结果根本不存在的“高危”。漏报你还有机会在别处发现,误报会直接烧掉团队对你的信任。
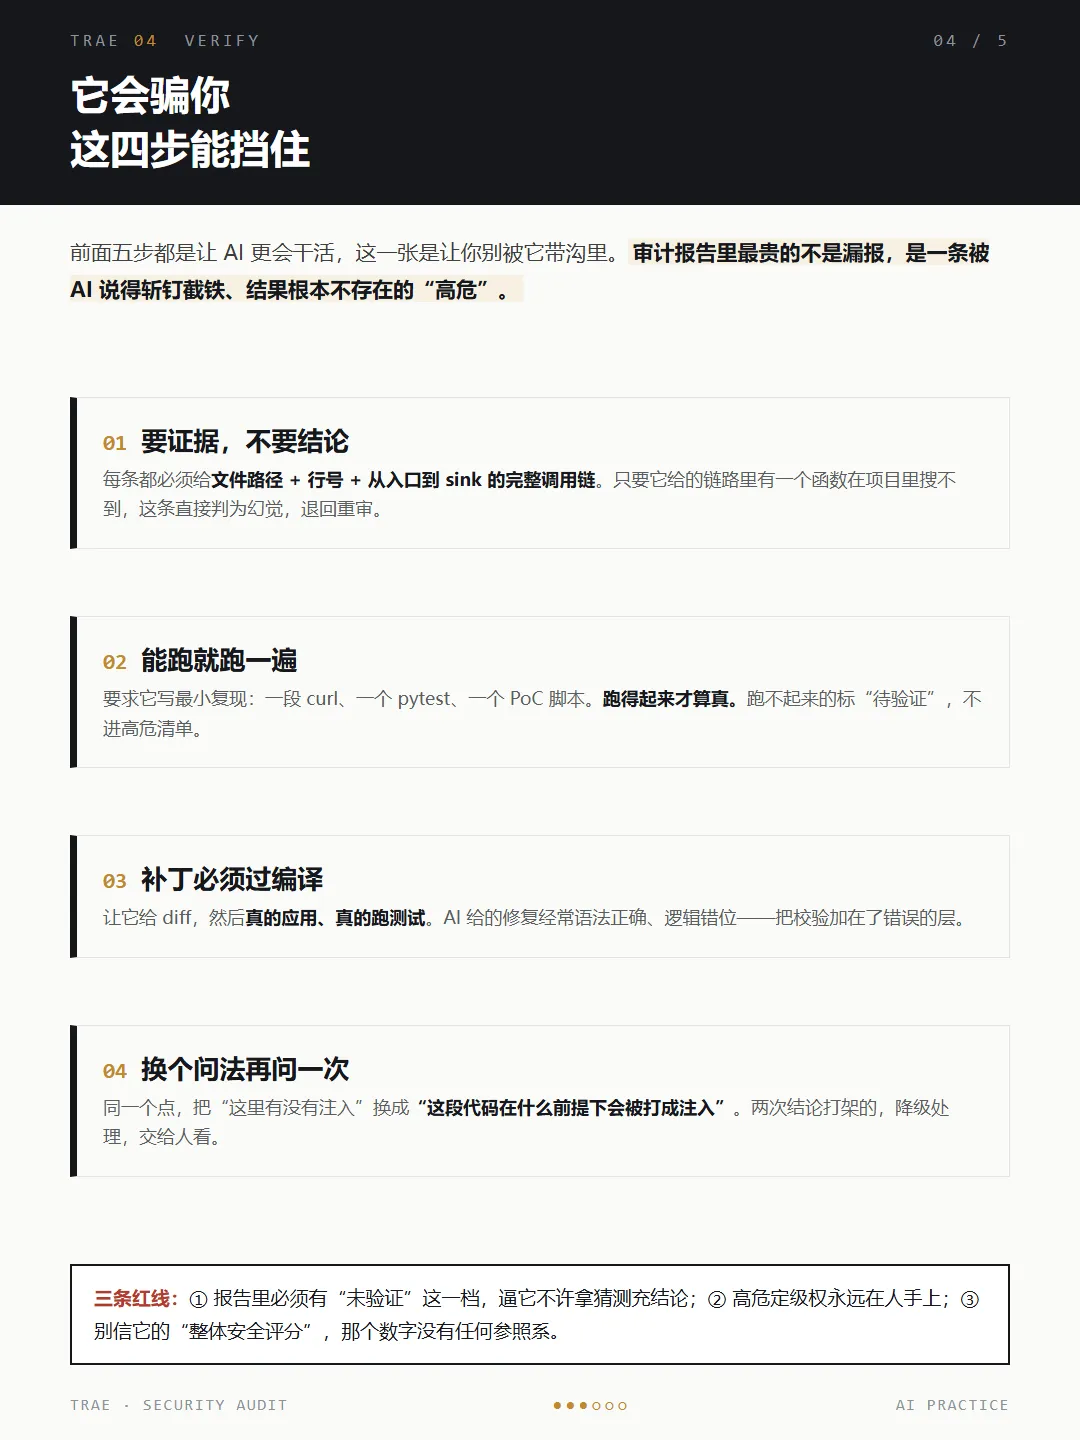
要证据,不要结论。每条必须给文件、行号、完整调用链。链路里任何一个函数在仓库里搜不到,这条直接判为幻觉,退回重审。
能跑就跑一遍。要求它写最小复现。跑得起来才算真,跑不起来就标“待验证”,不进高危清单。
补丁必须过编译。让它给 diff,然后真的应用、真的跑测试。AI 的修复经常语法正确、逻辑错位——最常见的是把校验加在了错误的层,看起来修好了,实际绕过路径还在。
换个问法再问一次。同一个点,把“这里有没有注入”换成“这段代码在什么前提下会被打成注入”。两次结论打架的,降级处理,交给人看。
还有一条原则:报告里必须有“未验证”这一档。它的作用是逼 AI 不许拿猜测充结论。没有这一档,所有不确定的东西都会被它塞进“高危”里,因为那看起来更像干活。
六、跑顺了之后,接进日常
单次审计跑通,下一步是把它塞进流程。有几个现成的口子:
PR 阶段。Trae 内置了 TRAE-security-review 技能,专门审代码差异和合并请求,输出结构化的安全问题清单。在 GitHub 集成里开 “Auto-review Pull Requests”,每次提 PR 自动跑一轮。
工具 + AI 串联。在 CI 里先跑 Semgrep,把结果 JSON 喂给 Trae 做研判,只把“确认必改”的写回 PR 评论。这一步是把前面那套三层架构固化下来。
别让 AI 直接卡 CI。这条是踩过坑的经验。把 AI 的判定做成硬门禁,误报会把整个团队堵死,两周之内所有人都会开始绕过它。让它先当评论员,等准确率稳定了再谈门禁。
还有一个反直觉的用法:用 AI 审 AI 写的代码。现在很多代码本身就是模型生成的,这类代码有个特点——模式规整、注释漂亮、边界处理想当然。人看容易看麻,AI 反而容易发现“这里假设了输入一定非空”这类问题。
七、一屏速查
开会前扫一眼,或者直接截图存手机。
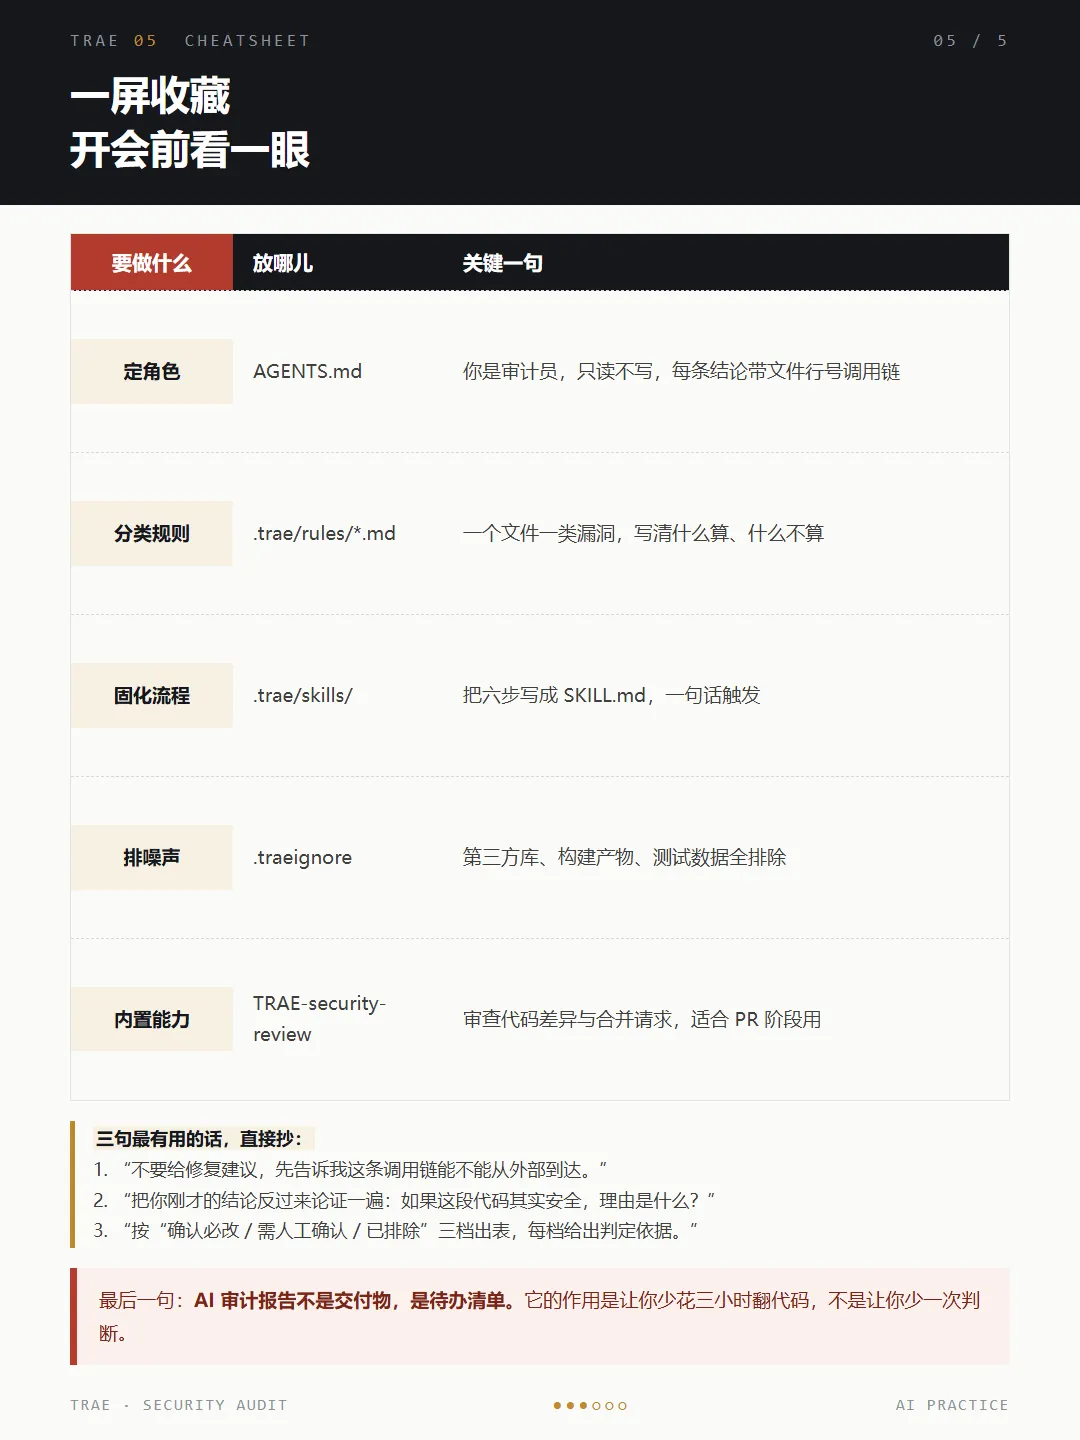
目录结构就这么五项:
项目根目录结构
AGENTS.md 审计员角色 + 输出格式.traeignore 排除无关代码.trae/rules/*.md 按漏洞类型拆的规则.trae/skills/ security-audit 流程封装audit/ 报告输出目录(唯一允许写的地方)
最后
有句话我想放在最后。
审计这件事的本质,一直没变过:你得证明一段代码在什么条件下会坏,而不是证明它“看起来没问题”。
AI 改变的是翻代码的时间。以前你要一行一行读,现在你可以把“读”这一步交出去,只留下“判断”。
但判断力不会跟着一起交出去。
所以我从不建议把 AI 的审计报告直接当交付物。它就是一份待办清单——它帮你把要查的地方标出来,剩下每一格的勾,还是你自己打。
省下来的那两天,应该花在那些 AI 判断不了的地方。

