LLM学习笔记-49- Attention系列-MHA/MQA/GQA
- 2026-11-06 01:58:10
第一条路线叫 Softmax Attention,也就是标准的自注意力机制及其各种改良版本。
这条路线的基本思路是:既然每个词的记忆是分开存的,那就想办法让每份记忆占用的空间更小,或者让同一份记忆被更多人共用,从而省掉存储和搬运的开销。
这篇笔记先介绍 “ Memory-Representation Efficiency(记忆表示效率)” 这部分,这部分又分为3类:
• Sharing across Heads(跨头共享) • Compression along Channels(沿通道压缩) • Sharing across Layers(跨层共享)
本篇笔记介绍最容易理解的第一个分类: Sharing across Heads(跨头共享)。顾名思义,跨头共享允许多个 query 头复用 KV 状态以减小KV的存储,它要回答的问题是:同一 token 是否需要为每个 query 头独立存储 key 和 value?
我们先从标准的注意力MHA入手,再看其变体MQA 和 GQA
1. MHA (Multi-Head Attention)
标准注意力,也就是综述文中提到的Softmax 注意力,它属于"显式记忆"(explicit-memory):一个 query 在一组可枚举的记忆单元中将自己与每个单元比较,对得到的分数做归一化,再聚合对应的 value。
• 设 query 位置为 、注意力头为 ,令 、、 为对层输入做线性投影得到的 query、key、value 向量。如下面公式所示:其中 是 query 可访问的记忆位置集合。
对应综述文中给出的5个角度来看标准注意力:
• 记忆表示(Memory Representation):是逐 token 的 key–value 对; • 记忆更新(Memory Update):在每个解码步追加一对新的 KV; • 访问(Access):因果掩码下,全部历史 token 可见。 • 读出(Readout):是式(1)中,softmax(QKᵀ) 加权 V,逐头进行。 • 整合(Integration):将各头输出拼接并施加输出投影
设: 为头数, 为头维度
投影过程(每个头一套独立参数):
直接套用式 (1): 每个头拿自己的 与历史上本头专属的 打分,对本头专属的 加权求和。
整合:
说明: 记忆表示是" 组互不相关的 (K, V)",KV Cache 每词存 个数。 完全独立意味着每个头可以从同一 里抽取完全不同的特征写入记忆,表达力最强,但缓存也最贵。
一句话:MHA是每头独立生成 K/V,逐词逐头缓存
2. MQA (Multi-Query Attention)
所有 query 头保留各自的 query 投影,但从同一个共享 key 头和同一个共享 value 头读取。即 ,KV不再有头维度,只有Q还是保持头维度:
投影过程:
与式 (1)差异 ——注意 K、V 不再有头下标 :
整合: 与 MHA 相同,。
说明: 公式的关键变化是 、——记忆单元不再属于任何头。于是 个头读同一份记忆,读出结果的全部差异只能来自查询侧 的不同(同一份 V 被 组不同的权重重新加权)。缓存降到每词 ,是 MHA 的 。
一句话:K/V 退化为全局唯一一份
3. GQA(Grouped-Query Attention, GQA)
GQA 把 query 头分组,组内共享一个 KV 头。改变分组数即可在 MHA 与 MQA 之间构造一个连续谱,让模型设计者在头级表示能力与缓存/带宽效率之间权衡。
从公式变化看:
投影过程: 把 个查询头划分为 组(),定义头到组的映射
式 (1) 变化为——K/V 的下标换成组号 :
整合: 同 MHA,。
说明: 只需一个映射函数 就统一了整个家族: 时 ,退化为 MHA; 时 ,退化为 MQA。同组内所有头读写同一份 KV,组间互不干扰。缓存为每词 , 是质量与效率之间的连续旋钮。
一句话:引入分组映射 ,K/V 按组共享
论文中的图很形象的说明这点:
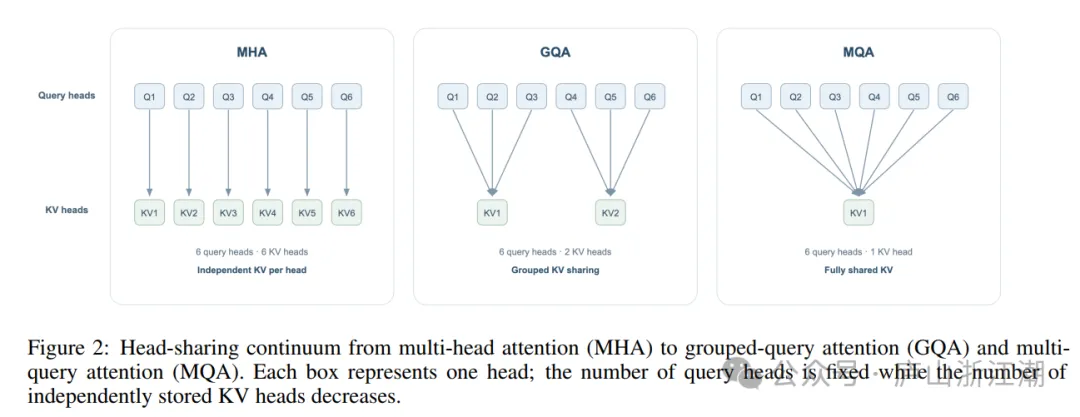
下图给出完整的Attetion的5个角度的三者对比框图:

