DeepInfer 学习笔记01:基本的 Inference 过程
- 2026-11-07 17:27:06
我一直是一个软件工程师,并不熟悉模型 Training 和 Inference 的东西。但在现在这个时间,我觉得还是很有必要,哪怕很粗浅地学习一下。我的一位朋友曾经跟我说他在本地部署了一些小的模型,他认为这是当前这个时代最重要的技术,不能只满足于会用,无论如何要理解这是怎么个事。以此自勉,并找机会学习。
正好不久之前,DeepSeek 开源了他们的 Inference 架构到 GitHub 上,于是立即 clone 到了本地,并开始在业余时间(与我的 Agent 一起)学习这个架构,试图努力抓住这个时代的一点尾巴。
我希望使用 8 到 10 篇笔记来记录我的学习心得,让我自己更了解大模型到底是怎么工作的,对我们用好大模型,又有哪些启发。
Inference 和 Training
这次 DeepSeek 发布的是他们的 Inference 框架,Training 框架不在其中。
Training 是指,将大量的学习语料变成一个模型; Inference 指的是在已经有一个模型的前提下,怎样将输入(也就是常说的 Prompt 或者提示词)转成输出的 token。
可以粗略地把 Training 理解为培养一个学生,把 Inference 理解成让这个学生开始答题。前者会改变模型本身,后者使用已经训练好的模型。这两步都很重要。光有一个强大的模型,没有好的 Inference 框架,就没办法很好地服务用户。我们在网页里跟 AI 聊天,或者使用各种 Agent 完成特定的工作,接触的都是后者。
DeepInfer 学习计划
在初步分析了 DeepSeek 开源出来的东西之后,我初步框定了下面这些话题:
基本 Inference 过程【这篇笔记就会 cover】:一次 Prompt 怎样变成 token,又怎样一步步变成回答。 一些基本概念 Prefill、Decode、KV Cache:模型读输入和写输出时,分别在做些什么。 调度和多卡协同:很多请求同时到来时,先算谁、怎么算,以及一张卡忙不过来时怎么办。 输出的约束:例如怎样让模型按照 JSON 等指定格式输出,尽量少给上层应用添麻烦。
未来,随着进一步的学习,计划也会动态调整。我的目标很朴素:理解一下这个时代也许最前沿的技术,然后看看能怎样提升我自己的工作方式。
基本的 Inference 过程:为什么 AI 的回答总是一个字一个字蹦出来
讲完了前面的废话,让我们来看一下,用户输入的一段提示词,到底是怎么变成 AI 的回答的。大家可能都有感觉,问了 AI 一个问题之后,它的回答都是一个字一个字往外蹦的,为什么这样呢?
我先把整个过程画出来。这里先不讲那些实现细节,只看一个问题变成一段回答,中间发生了什么。
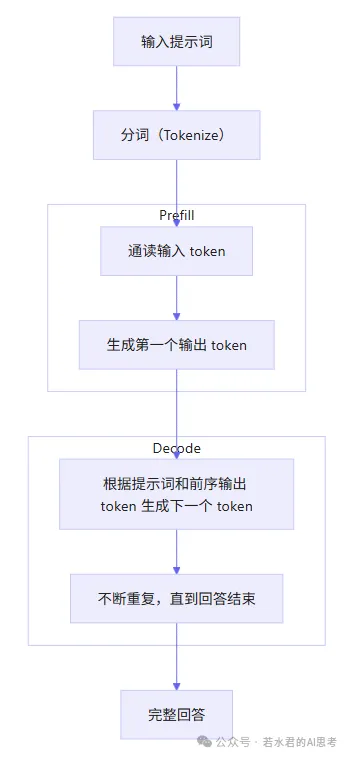
这就解释了两个问题。
第一,为什么输出都是一个一个往外蹦。Prefill 阶段,输入提示词已经全部准备好了,模型可以通读这些 token。到了 Decode 阶段,下一个 token 要根据提示词和前面已经生成的 token 来算。前一个没出来,后一个就没法开始,所以只能一个接着一个生成,显示在屏幕上就像一个字一个字往外蹦。
第二,为什么账单上输出的价格更贵,而且往往有长度限额。输入可以放在一起处理,输出却要重复很多轮生成。回答越长,模型需要工作的轮数越多,占用机器的时间也越长,费用自然更高。再加上模型一次能容纳的输入和输出总量有限,所以平台通常会限制最大输出长度。
在上图中,我也标出了 Prefill 和 Decode 的部分,下一篇,我们将重点拆解这一块。

