端到端自动驾驶学习笔记(三):SparseDrive
- 2026-11-13 06:05:35
最近在系统学习自动驾驶端到端的技术路线,这些是之前的论文笔记:
今天来学习SparseDrive。这是端到端的经典论文,作者来自地平线和清华。
【2024】SparseDrive:End-to-End Autonomous Driving via Sparse Scene Representation
论文核心内容
SparseDrive 不再构建 BEV 特征,直接用动态智能体和静态地图元素构成稀疏场景表示来做端到端自动驾驶。同时将自车也初始化为实例,与周围智能体共同进行时序、智能体和地图交互,再并行生成多模态轨迹,最后通过碰撞感知重评分选出规划结果。
目录
1 研究背景
2 总体架构
3 核心方法
对称稀疏感知
自车实例初始化
并行运动规划器
分层规划选择
4 训练策略
5 总结与个人思考
01
PART
研究背景
RESEARCH BACKGROUND
传统自动驾驶系统通常由感知、预测和规划等模块串联组成,优点是结构清晰、便于调试,但模块之间存在信息损失和误差累积,各模块的优化目标也不一定与最终驾驶目标一致。
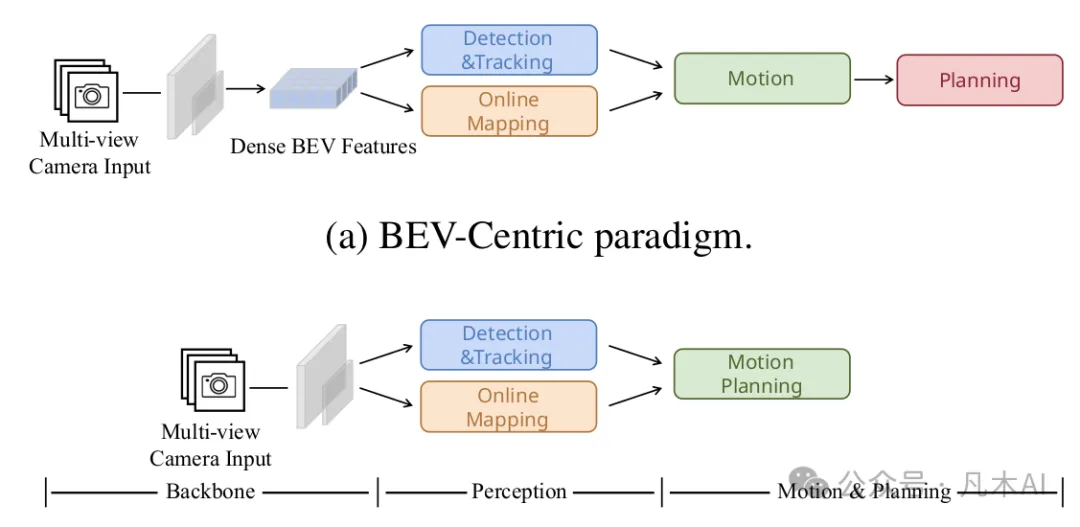
UniAD 等端到端方法将多个任务放入统一框架,可以面向最终规划目标优化,但作者认为仍存在两类问题:
稠密 BEV 特征计算开销较大。BEV 特征的计算和显存开销会受到感知范围、空间分辨率等因素影响,后续还需要在 BEV 上完成检测、建图、预测和占据估计等任务。
预测与规划的任务设计过于直接。现有方法通常先预测周围智能体,再根据预测结果规划自车,忽略了自车与周围智能体之间的双向交互;同时,确定性规划轨迹也难以表达未来驾驶行为的不确定性。
因此,SparseDrive 不仅试图去掉稠密 BEV,还试图重新组织预测与规划之间的关系。
02
PART
总体架构
OVERALL ARCHITECTURE
SparseDrive 主要包含:图像编码器、对称稀疏感知、并行运动规划器。
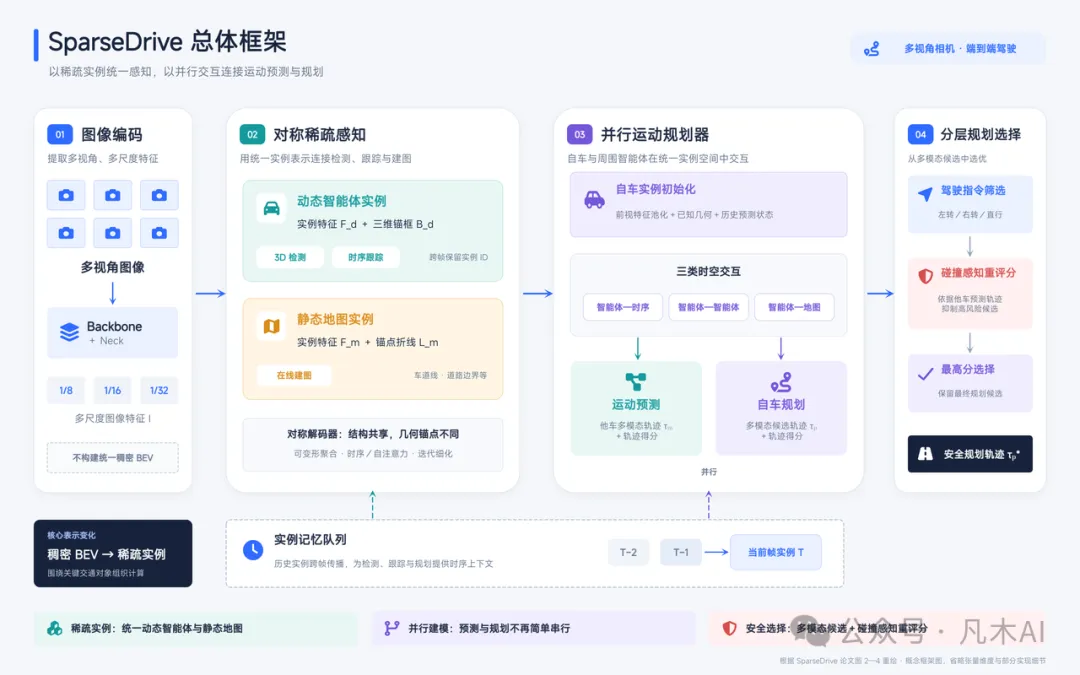
首先将多视角输入图像编码为 N 个视角、S 个尺度特征图 I。在对称稀疏感知模块中,特征图 I 被聚合为两组实例,分别表示周围智能体和地图元素,它们被输入并行运动规划器,与初始化后的自车实例进行交互。其中,稀疏场景由两类实例构成:
动态智能体
实例特征+三维 anchor。
静态地图元素
实例特征+锚点折线。
这种表示直接保留驾驶所需的关键对象,不再构建覆盖整个感知区域的统一稠密 BEV 特征。
运动规划器同时预测周围智能体和自车的多模态轨迹,并通过分层规划选择策略选择一条安全轨迹作为最终规划结果。
03
PART
核心方法
CORE METHOD
对称稀疏感知
SparseDrive 使用结构对称的检测分支和建图分支,统一检测、跟踪与在线建图。
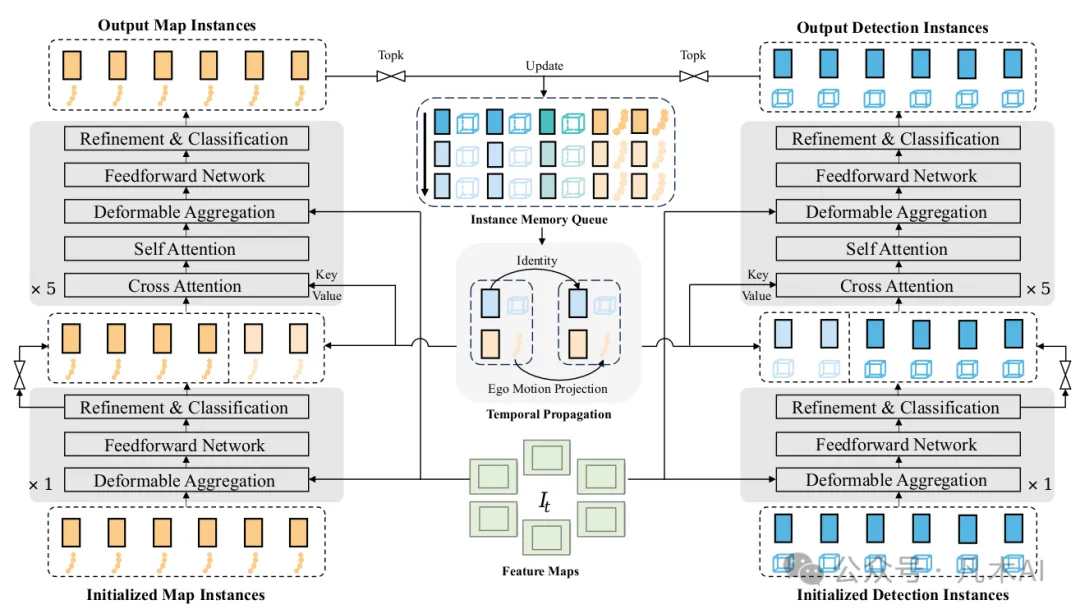
稀疏检测将每个智能体表示为一组实例特征 F_d(N_d × C) 和 anchor B_d(N_d × 11),其中 N_d 为 anchor 数量,C 为特征维数,11 为 anchor 维度,包含位置、尺寸、偏航角和速度等信息。解码器围绕 anchor 生成关键点,将其投影到多视角图像特征上采样,再逐步更新实例特征、分类结果和 anchor。
检测分支包含非时序解码器和时序解码器:
非时序解码器
从初始化实例开始完成当前帧感知。
时序解码器
融合历史实例,并利用时序交叉注意力和实例自注意力更新场景表示。
稀疏在线建图沿用检测分支的基本结构,只是将几何锚点从三维框换成地图折线,从而用统一方式处理车道线、道路边界等静态元素。
稀疏跟踪不额外设计复杂的数据关联网络,而是利用实例的跨帧传播维持身份一致性:当实例置信度超过阈值后分配 ID,并在后续时序传播中保留该 ID。因此,跟踪任务不需要单独的跟踪损失。
自车实例初始化
与周围智能体类似,自车由自车实例特征 F_e(1 × C) 和自车锚框 B_e(1 × 11) 表示。
以往方法往往将自车查询随机初始化,但 SparseDrive 认为,自车规划与周围智能体预测一样,也需要语义和几何信息。然而,周围智能体的实例特征聚合自图像特征图,这对自车并不可行,因为自车处于相机的盲区。因此,我们使用前视相机的最小特征图做 AveragePool 来初始化自车实例特征。
这样做有两个优点:
语义上下文
最小特征图已经编码了驾驶场景的语义上下文。
稠密特征补充
稠密特征图可作为稀疏场景表示的补充,以防存在一些无法在稀疏感知中检测到的黑名单障碍物。
对于自车 anchor,可以使用已知的位置、尺寸和偏航角初始化;对于每帧的速度初始化,使用上一帧预测的速度,避免直接输入当前真实速度造成自车状态泄漏。
并行运动规划器
为了实现所有道路智能体之间的高阶交互,SparseDrive 将自车实例与周围智能体实例进行拼接,得到拼接后的实例特征和 anchor:
F_a = Concat(F_d, F_e)
B_a = Concat(B_d, B_e)
由于自车实例在初始化时没有时序信息,而时序信息对规划十分重要,设计了大小为 (N_d+1)× H 的实例记忆队列用于时序建模,其中 H 是存储的帧数,通过三类注意力完成时空交互:
智能体—时序交叉注意力:每个实例聚合自身历史信息。
智能体—智能体自注意力:建模自车与周围智能体之间的高阶交互。
智能体—地图交叉注意力:引入道路结构和地图约束。
随后,网络同时为周围智能体和自车预测多模态轨迹T_m(N_d × K_m × T_m × 2) 和 T_p(N_c × K_p × T_p × 2),及其得分 s_m(N_d × K_m) 和 s_p(N_cmd × K_p)。
其中,K_m 和 K_p 分别是运动预测与规划的模态数量,T_m 和 T_p 分别是运动预测与规划的未来时间戳数量,N_cmd 是规划的驾驶指令数量。
使用三种驾驶指令:左转、右转和直行。对于规划,我们还根据自车实例特征额外预测当前自车状态。
这种设计与传统串行方法的本质区别是:规划不再只是运动预测的下游消费者,自车与他车的未来行为在同一个交互过程中联合建模。
分层规划选择
多模态规划会产生多条候选轨迹,SparseDrive 通过三个步骤选择最终结果:
根据左转、右转或直行等驾驶指令,保留对应候选轨迹。
利用周围智能体的预测轨迹评估碰撞风险,对于碰撞概率较高的轨迹降低其得分,将发生碰撞的轨迹得分设为 0。
选择得分最高的轨迹作为最终规划输出。
碰撞感知重评分不需要额外的轨迹优化器,结构较轻量。其实现中,与预测智能体轨迹发生碰撞的候选轨迹会直接被置为低分。
04
PART
训练策略
TRAINING STRATEGY
SparseDrive 采用两阶段训练:
第一阶段
从头训练对称稀疏感知模块,使模型先获得稳定的稀疏场景表示。
第二阶段
联合训练稀疏感知模块与并行运动规划模块,不冻结任何权重,实现端到端优化。
整体 Loss 包含检测、在线建图、运动预测、规划这 4 项任务的分类 Loss 和回归 Loss,此外还加入深度估计的辅助学习用于增强感知模块训练的稳定性。多模态运动预测与规划采用赢家通吃策略,即重点优化与真实轨迹最接近的模态,同时学习不同轨迹的置信度。对于规划,还有一项针对自车状态的额外回归 Loss。
论文在 nuScenes 验证集上进行实验,主要结果如下:
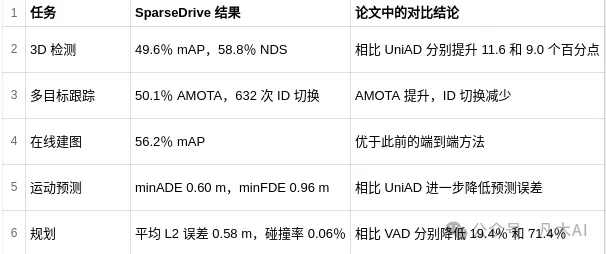
消融实验支持了以下结论:
将并行预测规划改为串行结构,会损害运动预测和碰撞率。
移除自车实例的语义与几何初始化,规划误差和碰撞率均会上升。
将多模态规划改为确定性规划,会产生更高的碰撞率。
移除实例级时序交互,规划 L2 误差明显恶化。
碰撞感知重评分能够在几乎不增加 L2 误差的情况下降低碰撞率。
增加规划模态数量能够持续改善性能,在六种模态附近趋于饱和。
效率方面,论文报告轻量模型 SparseDrive-S 相比 UniAD 实现 7.2 倍训练速度和 5.0 倍推理速度。不过,两者测速所用 GPU 并不完全一致,因此这些倍数更适合作为效率趋势参考,而不是严格的同平台对比。
///
LAST
总结与个人思考
SUMMARY · THOUGHTS
SparseDrive 的主要价值
稀疏表示组织完整任务链
证明端到端自动驾驶不一定需要统一稠密 BEV 中间表示,围绕关键交通实例也能组织完整任务链。
减少任务之间的人为割裂
检测和建图共享对称结构,预测和规划共享多模态轨迹建模方式。
并行交互触及核心问题
这种并行交互设计更直接地触及端到端驾驶的核心问题:自车决策与周围交通参与者并非单向依赖。
SparseDrive 的局限
稀疏表示可能遗漏未建模目标
对于异常障碍物感知漏检或无法被实例化,仅依靠智能体和地图实例可能不够。
碰撞评估依赖上游预测
如果他车轨迹预测不准,碰撞感知重评分也可能筛选出并不安全的轨迹。
联合训练仍然复杂
多任务之间可能存在梯度冲突,两阶段训练也说明稳定感知表示仍是端到端优化的前提。
SparseDrive 最值得借鉴的并不只是“用稀疏检测替代 BEV”,而是它展示了一种更统一的端到端设计思路:以实例为基本单位组织场景,以轨迹为基本单位统一预测与规划,再以安全评分连接模型输出和最终决策。
我是凡木,专注AI、世界模型、LLM、自动驾驶等技术方向,欢迎关注凡木AI公众号,一起交流学习。
欢迎点赞、推荐、转发三连,如果想第一时间收到推送,记得点击星标⭐,我们下篇见。

