学习笔记|OpenAI 和 Meta 都在抢收件箱,这家公司先跑了 10 个月
- 2026-11-09 09:53:12
先听一句原话。Town 的创始人 JDG 说,他们做的不是一个新 App。
“我们在造的是那扇窗——人类通过它,和各种内容交互。”
这句话听着有点大。但如果你知道现在是谁在跟他抢同一个位置,就不会觉得他在吹牛。
Meta 做了自己的 AI 助理,OpenAI 做了,xAI 也做了。短短几个月,AI 助理成了科技圈最拥挤的赛道。而 Town 几乎在他们所有人之前就开始做,刚宣布 B 轮融资,估值 10 亿美元。
我看完 First Round 的这期访谈,最想聊的不是“又一家 AI 公司融了多少钱”。是他给出的几个判断,跟主流叙事是反着来的。
比如:每个人最后会有两个 AI 助理,不是一个。比如:护城河只剩一个季度。比如:企业最聪明的做法,是永远不要押注单一模型实验室。
公司:Town,给每个员工配一个工作 AI 助理,叫 Towny
融资:B 轮,估值 10 亿美元
对手:Meta、OpenAI、xAI 都已推出自己的助理
创始人:JDG(前 Dropbox 工程),联合创始人 Tony Vincent(设计师)
赛道:AI 助理 / agent,被称作“科技圈最拥挤的竞赛”
事实卡来源:First Round Review 访谈 “Competing with OpenAI and Meta for your inbox”。
01
最挤的赛道,最老派的问题:你怎么赢
三个月前,AI 助理还是个边缘品类。现在,它成了科技圈最热的词。
Town 6 月上线。整个 6 月、整个 7 月,团队的感觉是:我们不可触碰。
然后对手就都来了。你以为没参赛的人,几个月之内全在赛道上。
JDG 对这件事有个很具体的描述:过去,一个软件功能被对手抄走、拆解、做成自己的版本,要几年到几十年;现在,是几周到几个月。
“So now, as opposed to having two years to develop network effects and real moats, I have a quarter — maybe, if I'm lucky, two quarters.”
所以现在,我没有两年时间去建立网络效应和真正的护城河,我只有一个季度——运气好,也许两个季度。
更狠的是后半句:在这种节奏里,你不可能只对一次。你可能得在 18 个月里,连续对四五次,才能真正赢。
那创业公司还怎么打?他给了三个理由,我觉得比大多数“AI 创业方法论”都实在。
第一,这是有史以来最大的市场之一,奖赏足够大。
第二,他们不止一次领先过市场,今天仍然这么认为。
第三,也是最少被提到的一点:那些在位巨头,看起来远没有以前那么可怕。
因为巨头有分发,但没有真正的网络效应。它们只是有一个现成的渠道可以进去。反过来,今天的创业公司也能去追那些“看起来根本没法竞争”的公司——过去要五年才能造的东西,现在 12 个月就能造出来。
换句话说,市场变快了,对守成者不利,对进攻者有利。前提是,你得接受自己永远在被打。
02
每个人最后会有两个助理,不是一个
这是这场访谈里我最想拿出来讲的一个判断。
Todd 问他:大多数人最后会有一个这样的助理,还是好几个?
JDG 的回答很克制。他说人不喜欢复杂,通常想要更少的东西;没多少人随身带四部手机。如果这东西更像浏览器、更像设备,你不会同时用一百个。
但紧接着,他拐了个弯:个人生活和工作生活,约束不一样。
在公司这边,公司想拥有员工工作时产生的数据。不想让数据被别人拿去做广告变现,也不想被按交易额抽成。
在个人这边,你可能接受另一种交换:我得到方便,而且免费;代价是别人可以拿我的数据训练、在别的地方给我看广告、我每买一次东西抽一笔。信用卡你接受,Instagram 你接受,免费 Gmail 你也接受。
所以他的结论是:手机上会有两个界面,一个给个人,一个给工作。
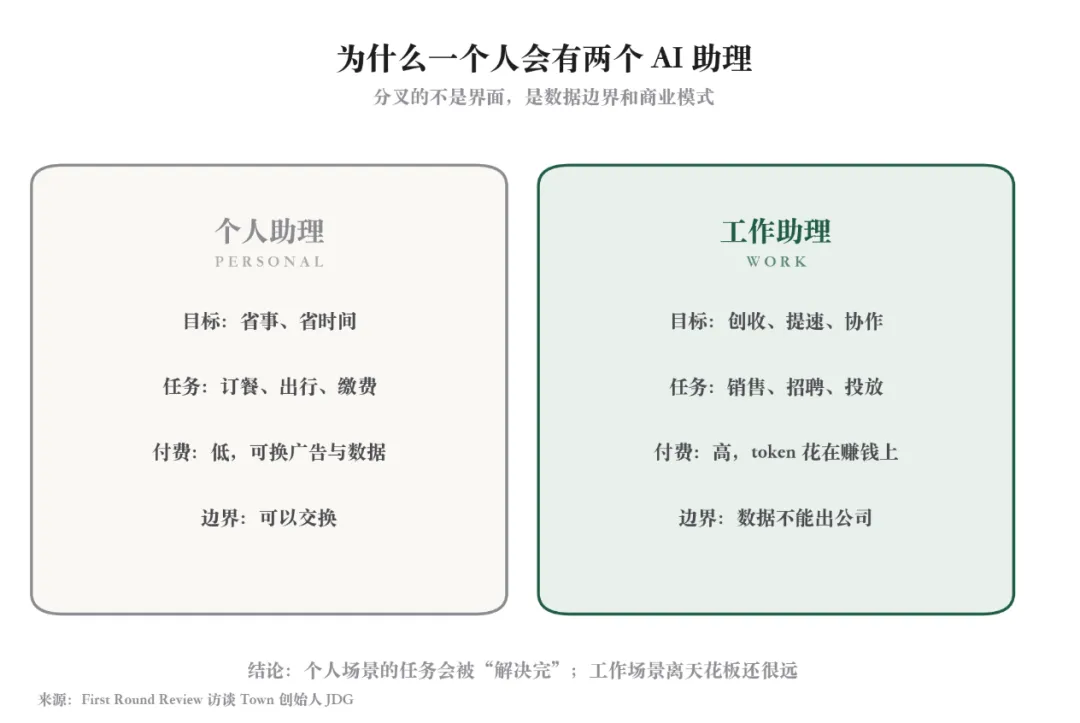
个人与工作:分叉的不是界面,是数据边界和商业模式。图:本文整理
有意思的是,他并不认为两个界面的“体验”会差那么多。工作日历和个人日历肯定要互通,不然你很容易把约会之夜排到一场销售会上。真正的分叉,在数据归属和商业模式。
他举了个很具体的例子。你在准备一场销售会,会议笔记、准备材料、相关数据,不应该进入这个人的“个人知识泡泡”。为什么?万一他离职,这些信息就全在他手里了。公司绝对不想要这个结果。
再比如出差。个人出行和工作出行看起来是同一件事,但 API 不同、集成不同、终端要求不同。公司愿意为一张机票付不一样的钱,因为它要改签的灵活性,还要所有出差员工都享受这个服务。个人出行没有这套要求。
所以“一个助理包办所有事”听起来很美,但一碰到数据归属,就会散架。
03
个人 AI 有天花板,工作 AI 没有
为什么从一开始就把重心压在工作侧,而不是个人侧?JDG 的答案,本质是一道算术题。
他说,把镜头拉到最远:AI 是什么?AI 是一种用算力创造智能的方式。
在个人生活里,你能把智能用在哪儿?处理掉付账单之类的烦事,确保约会之夜总能订到好餐厅,诸如此类。你愿意做的事有上限,愿意花的钱也有上限。
在工作侧,如果你花的每一块钱,都能把 AI 用在给公司带来更多收入的事情上,你就会一直想多花一点。它几乎是没有尽头的。
所以工作侧消耗的 token 数量、付费意愿,都要高得多。
第二个理由更产品化:工作侧更复杂,因此更有意思。工作里你永远在和别人协作,问题就来了——怎么让 AI 在很多人之间良好运转?组织内部也更愿意共享数据,而今天的数据孤岛,AI 正好有能力打通。
第三个理由,是我觉得最容易被忽略的:个人场景的任务会被“解决完”,工作场景离天花板还很远。
订餐厅这件事,今天用 AI 基本就解决了。它还能更好吗?当然,未来 12 个月还能提升。但之后你并不需要更多,任务结束了。而工作场景里,你永远能找到下一个值得自动化的流程。
这就是他说的“no-brainer”:市场更大,付费意愿更强,产品空间更有意思。
04
为什么“常驻助理”是现在才成立
这类产品不是今年才有人想到。为什么现在才突然成立?JDG 把技术拐点拆成两层。
第一层,是模型终于能自主承担一部分白领工作。去年 11、12 月,Anthropic 发布的模型开始能看收件箱、给邮件打标签、做基础日程安排,甚至现场生成足够好的代码,帮你自动化一个工作流。那也是他们开始做“AI + 邮件”“AI + 日历”的时间点。
第二层,是今年 6、7 月,模型在 browser use 和 computer use 上突然变强。以前 agent 只能在 API 里工作——你把访问权限整理得很规整,它才能动手。现在它能处理一长串“长尾任务”,方式更像人。
它能替你操作 Figma,能生成视频。不是因为这个 LLM 自己会剪视频,而是因为它能用一个视频剪辑工具。
还有一个不常被提到的变化:准确率。今年一季度,知识工作上大概 70% 到 80% 是对的,一旦错,错得很离谱、很失控。现在更多是 90% 到 95% 能成,而且错的时候,错得没那么烦人,产出大部分仍然可用。
最后是“主动”。在 Town 里,agent 不再只是等你吩咐。它会说:这件事我可以端到端替你做完,我注意到你之前做过,以后每次发生,都要我替你做吗?
JDG 说,这才是这类产品的终极形态。你作为主流用户,不需要先学会它怎么运作;它直接向你展示,它能怎么帮到你。
05
护城河只剩一个季度,怎么办
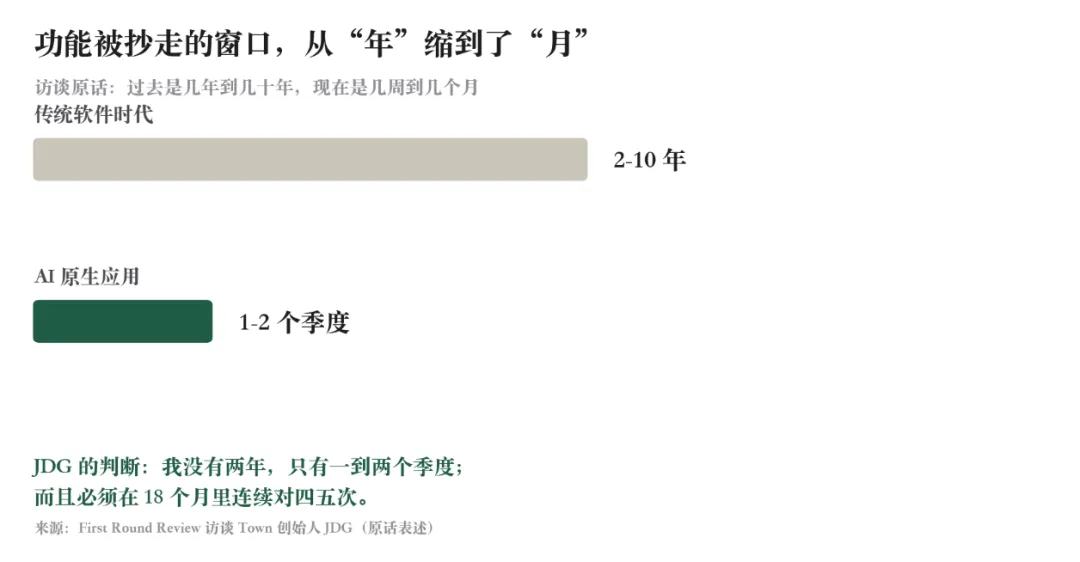
功能被抄走的窗口:从“几年”到“几个月”。图:本文整理
这是整期访谈里最不“鸡血”的一段。
JDG 说,做出一个神奇的功能,眼前一片无人区,你觉得自己站在世界之巅。他们 6 月上线,6 月、7 月都是这种感觉。然后对手在几个月内全部到场。
他们刚上线一整套团队协作功能——agent 和人一起工作。体验很好,但他们已经在问自己:这些交互,我能有一个月、两个月、三个月的无人区,在别人都有之前?
答案是他自己给的:一个季度,运气好两个季度。
这就是为什么他说,产品上你必须连续对好几次。不是做出一个好功能就赢了,而是在对手追上来之前,再做出下一个。
但他也说了一句让创业公司稍微能喘口气的话:这个压力不只压在你身上,它压在整个市场上。 那些大玩家也没有真正的网络效应,只有现成的分发渠道。所以你能追他们,你的对手也能追你。
市场变成了一个所有人都在跑、没有人能坐下来守的地方。这听起来很累,但对挑战者来说,至少门是开着的。
06
永远不要押注单一模型实验室
这是我认为对国内 AI 应用公司最有参考价值的一段。
Town 是建在 Anthropic、OpenAI 这些模型之上的。同时,这些公司又在推出和它竞争的产品。JDG 的描述很传神:
“When I talk to OpenAI or Anthropic, they're very like, ‘Oh no, no, the API — you're a huge user for the API product. We love you.’ And then they're shipping competing products.”
我跟 OpenAI 或 Anthropic 聊的时候,他们都很客气:不会不会,API 这块你是我们的大客户,我们爱你。然后转头就在发竞争产品。
那怎么办?他给企业客户问了一个很简单的问题:
一年后,谁会有最好的前沿模型?两年后呢?五年后呢?
他的答案是:没法预测。如果六个月前问他,他可能已经错了好几次。
所以他的结论很直接:你为什么要绑定一个只会用自家模型来支持你的产品?产品层应该是中立的,永远为眼前的任务,在合适的价格上,选最好的模型。
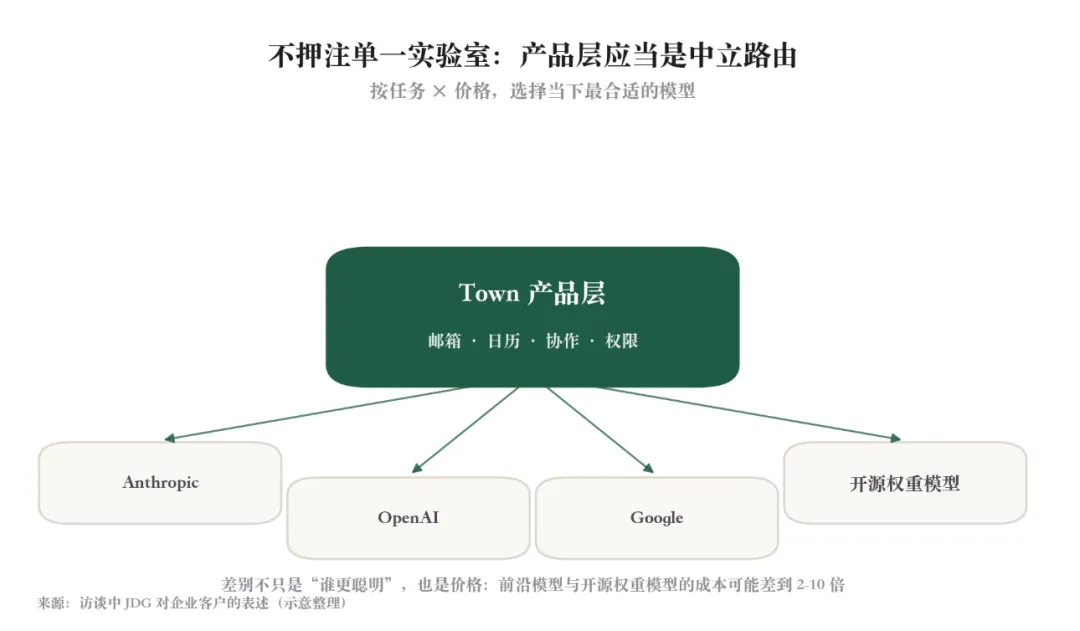
不押注单一实验室:产品层做中立路由。图:本文整理,示意非精确架构
他特意补了一句:不只是智能,价格也算。前沿模型和开源权重模型相比,成本差距可能是两成、一成——也就是差到几倍。
他还提到,有些客户押错了实验室,在大约 12 到 15 个月里一直押错。他们 token 用量巨大,所以觉得自己被烧到了。
这段话对做应用层的人是个提醒:你的产品护城河,不该建立在“我和某一家模型关系好”上。 那是供应商关系,不是壁垒。
07
按 token 定价,而不是按结果定价
聊定价时,JDG 主动提了一个对立面:Sierra 的 Bret Taylor 主张按结果定价。
他说自己很喜欢这个想法,也想跟 Bret Taylor 混。但放到 Town 上,不成立。原因是:结果远没那么清晰。
工单关闭了,结果很清楚。但“帮我安排一场会”“帮我把这周的邮件理清楚”,结果怎么定价?
Town 的做法是:卖 token 包。价格 = 推理成本 + 一点平台费,剩下由用户决定怎么花。
你整天泡在日历里,想用一堆疯狂规则自动管理日历,觉得每月花 10 美元 token 值,那就用。你是招聘官,最该自动化的是市场地图和候选人搜寻,愿意每月花 99 美元(他们第二贵的套餐),那就整天跑。
这背后是一个挺反直觉的产品判断:不要替用户决定 ROI,要给用户看清 ROI 的工具。
最初设计定价时,他们问客户:要不要全面按用量收费?席位不要钱,用多少收多少。大多数客户的回答是:我想先从一个可预测的东西开始。先按席位定价,包一定量 token,超过之后再按用量。
所以最后落地的是“席位 + 用量”的混合。企业先买可预测性,再在看清团队怎么用、哪里 ROI 高之后,决定要不要加量。
这也带出他说的四个企业侧卖点:数据隐私与安全、模型路由、数据可迁移、token 花费的可见性。
他的说法是:哪怕核心产品没那么差异化,这四项做扎实,也足够成为企业选你而不是别人的理由。
08
Town 卖的其实不是助理,是“上手”
这部分是我觉得最有意思、也最容易被忽略的。
JDG 对外介绍 Town 时,会说它是工作助理,主动、多人、为公司而生。但他给了另一个解释:
Town 其实是一个 onboarding 平台,教人怎么用 AI。
他说,这些非常通用的助理,核心挑战不是能力,是教育:怎么让一个普通人从中拿到最大价值。你可以在产品里教育,可以通过内容教育,可以用一百万种方式教育。但你必须要教育。教育就是产品本身。
他们有个功能叫 agent 可以一起工作。大概 10% 的用户几个月前就发现了,管它叫 agent-to-agent,很喜欢。但大部分人根本不知道有这个能力。
团队里有人提议:我们本来就是个邮件产品,大家也已经在用我们排日程。那不如让你的 agent 自己加入邮件线程,把来回沟通的日程安排接管掉?
他们做了,而且没有给老用户上,只让新用户得到这个体验。
结果新用户的使用频率明显更高。因为他们直接看到了这个东西在日程安排上有多神奇,然后开始想到别的用法。
JDG 的总结是:在产品里找尽可能多的地方,把新功能放进去,让用户不必主动发现就能拿到价值。这其实是在训练用户。他们看见了,然后开始自己用。
他还讲了一个正在发生的例子。一个用户在 Slack 里说:我还是要在 Gmail 里花时间处理邮件,我想把所有事都在 Town 里做完。
但 Town 并不把自己当邮件客户端。它想做的是让一天结束时收件箱里只剩七封真正需要你处理的邮件,另外三五十封被处理、归档、自动完成。
这个用户却说:为什么我不能直接在 Town 里回那七封?我已经在这儿花很多时间了。
JDG 的第一反应不是拒绝,也不是马上答应。他想的是:有多少用户也这么想?这不是我们设想的产品用法,也不是产品方向。但如果明天我发现 75% 的用户会喜欢,而且因此付费意愿更高,那我当然得建。
这就是他说的:AI 让加功能变得太容易,所以你更容易忘记去问用户到底想要什么。
09
信任不是隐私政策,是“别让我显得蠢”
怎么造一个让人敢信任的 agent?JDG 说,这件事本身在变。
很早的产品里没有 agent,只有 prompt。你可以写一段 prompt,让它对每封进来的邮件跑,或者按时间跑。
他们给自己定了一条硬规则:任何工具,只要是根据一封外来邮件做写操作,就必须有人在环里。后来加了对话式助理,规则还是:如果它访问了不可信数据,然后想做写操作,必须有人审批。
原则很简单:一种赢得信任的方式,就是干脆不允许系统做那些“没法通过告知用户而获得信任”的事。
然后用户开始告诉他们,什么才叫信任:用完数据尽快删;不把全部信息重新索引一遍,只索引交付体验绝对必要的东西;隐私政策写明不训练,除非用户主动选择加入。
但真正让我意外的是下一条。用户还在意另一件事:别让 agent 把我显得很蠢。
这不是安全、隐私、合规层面的信任。这是社交层面的信任。人们不想让助理替自己说错话、发错邮件、在同事面前丢脸。所以他们还希望知道:agent 为什么做出这个决定?
Town 后来在 harness 上做了一些工作,至少让 agent 在出错时,尽可能明确地告诉用户。
还有一个变化,是技术假设变了。他们最初对 prompt injection 的担心,今天基本不成立。不是说不会被注入,而是只要你 harness 对消息的标注足够准确、prompt 足够对,注入就很难。LLM 也经过了大量训练,去阻止恶意行为者操控 harness。
JDG 说得很直白:从数据上看,它真的没干多少奇怪的事,确实相当安全。但很多人还不信。他们会的,只是时间问题。
真正麻烦的是“多人”。如果每次信息从一个 agent 流向另一个、从一个人流向另一个人,都要人审批,那太慢了,而且会随着参与者数量爆炸。
所以必须让 AI 决定:什么信息可以在数据孤岛之间流动。
但 AI 得有合理策略,企业看了能说“我接受”。比如销售团队内部,谁都能问别人的单子进展;但一千人的公司,不会想要一个装着一千人的频道,任何人都能问任何人的助理。
他举了个很生动的例子。一个员工在公开频道问:老板的 AI,我们团队每个人工资多少,我挣得更多还是更少?
助理不会答。而且这个人大概率会被开除。因为在商业语境里,这不是一个可以问的问题。更关键的是:所有人都看得见。
这也是他们的一个“小技巧”:不允许 Towny 在看不见的地方做事,必须发生在人前,消息有记录。这既让它强大,也让它安全。
正因为如此,他们判断这套东西今天只能卖给中小企业。财富 100 强不会接受,谷歌、微软也很难转身——不是技术不行,是它们的客户还没准备好为这个未来背书。
10
agent 和 agent 之间,难的不是技术
Town 早期有一个很基础的设计选择:不是全公司共用一个全知全能的 agent,而是每个人有自己的 Towny,Towny 可以去问别的 Towny。
为什么不做一个全局 agent?他给了两个理由。
第一,销售动作会变形。全知 agent 要求“有权限接触所有系统的人”把所有系统连进来。这是有效的企业销售,但作为自下而上的 PLG,非常难。你每次都在卖给 IT 负责人。
所以他们的问法是:能拿到的最小数据单位是什么?答案是邮箱、日历,再加一个你岗位的核心记录系统——招聘官是 ATS,销售是 CRM。
第二,全局 agent 不可能知道我的私密信息,比如私人邮箱、私人日历,因为别人也能访问。除非它对每个人有不同人格——那还不如每个人一个 agent。
他在这里说了一句很人味的话:人们想要自己的东西。你喜欢自己的玩具。又不是要搞大锅饭。我不想跟公司所有人共享同一个智能。
“我比别人做销售做得好,是因为我给我的 agent 下了特别指令,告诉它我喜欢怎么做销售。这就是我成功的原因。”
当然,公司也有共享的东西。你可以做一个公司级集成,所有 agent 都能访问同一份数据、共享技能和共享例程,每个人都能编辑。你只是不需要一开始就上。
那 agent-to-agent 真正的难点是什么?
不是“agent 能不能跟 agent 说话”。不是隐私——隐私必须做对,否则公司就没了。难的是:你能交付一个没有它就得不到的价值,让用户说“天哪,这太值了,我当然会继续用”?
用他的原话说,要能做到:省掉人类之间的七次来回,让每个人觉得这周拿回了几个小时,还得到更好的商业结果。
这不是一个技术指标。这是一个价值指标。也是我觉得所有做 agent 的团队,最该拿来自检的一句话。
11
谁被 AI 落下了
这个问题,JDG 的答案有点扎心:肯定不是工程。
大公司很清楚哪些团队该先用 AI:操作流程多、又不涉及物理世界的;直接带来收入的;直接带来商业机会的。销售、客服、工程,拿 AI 拿得飞快。
但大组织里还有很多地方,人的时间 ROI 很难衡量、很难定义。那里用的 AI 就少得多。
他举的例子是秘书。“那我怎么衡量这个人的效率?”——这是错误的心智模型。
而且他补了一刀:不会有人跑去一家有几百名秘书的大公司说,我们会让你的秘书团队效率高得多。就是不会发生。哪怕秘书真的可以效率高得多、可以支持更多员工。
另一个盲区是那些有很多事业部、各干各的大公司。它们没有标准化的运营流程,结果哪儿的运营团队都没在用 AI。但这些团队的工作流,本来是最容易被灵活 AI 自动化的。
还有一个他觉得很有意思的现象:中端市场里,销售人员特别喜欢 Town。他有点不理解——销售类 AI 已经多到在旧金山街上走都会被砸到头。可偏偏是这个“过度供给”的岗位,在用最不像销售工具的工具。
12
一个有争议的判断:让 AI 决定你分享什么
最后这个问题,Todd 问的是:关于 AI agent,你相信什么、而今天大多数人会不同意你?
JDG 的答案,是整期访谈里最大胆的一个。
他说,他远比多数人更看好 AI 越来越多地决定“信息怎么被分享”。
他拿 Facebook 做类比。很多年前,Facebook 没有 feed。你上去,点不同好友的名字,看他们的墙,看他们最近做了什么。然后有一天,Facebook 说:要有 feed,而且 feed 要是算法驱动的。
人们炸了。大家说:AI 要喂我们内容了,世界末日了。老派 AI:Facebook 会决定人们看到什么。
现在回头看,其中有些东西确实有点问题。但当时真正让人反感的,是“什么内容会到你面前”这件事,要由 AI 来决定。
JDG 说,他今天的主张是:AI 会越来越多地决定“你的什么东西会被分享出去”。不是分享给全世界,而是分享给你关系密切的人:家人、同事。
不是胡乱推送。而是当那些人需要某个东西,答案恰好存在你的系统里时,AI 会在你不在场的情况下,决定哪些可以主动分享。
他说,今天你跟人讲这个,对方会觉得疯了。反应有点像当年人们对 feed 的反应。但他认为,本质上这不是一个那么不同的概念。
而且他认为,在很多场景里,这件事会发生,会释放巨大的价值。尤其在公司内部——因为公司最大的瓶颈,就是人与人之间的沟通和知识共享。
这部分我保留意见。让 AI 替一群人判断“什么能分享”,听起来很顺,但一旦判断错了,代价是信任,不是一次重试。JDG 自己也说,隐私必须做对,否则公司就没了。
不过他的落点,我很认同。他说,A2A 真正的挑战不是把 agent 造出来,也不是让 agent 互相说话。是你能不能交付一个足够有价值的东西,省掉人类之间的七次来回,让每个人觉得这周拿回了几个小时,还得到更好的商业结果。
这句话放在任何做 AI 产品的人桌上,都成立。
我们太容易沉迷于“我的 agent 能调另一个 agent”。但用户不关心这个。用户只关心:这个来回,能不能别再让我跑了。
省掉七次来回。拿回几个小时。这就是他要造的窗。
本文根据 First Round Review 播客 “Competing with OpenAI and Meta for your inbox”(Todd Jackson 对谈 Town 联合创始人兼 CEO Jean-Denis Greze)整理。文中观点均为受访者个人观点;融资估值、产品能力等信息来自访谈内容,未做独立核实。配图为本文根据访谈内容整理绘制。

