深入理解agent学习笔记(十三)——RAG基础
- 2026-11-06 04:36:44
点击下方卡片,关注“人工智能陈小白”
视觉/大模型/图像重磅干货,第一时间送达!
RAG 基础:知识获取管道
1. RAG 的最小闭环
共享知识库的核心技术是检索增强生成(Retrieval-Augmented Generation,RAG):把 LLM 的思考与生成能力,与外部知识库的广度、时效性结合。模型训练数据有截止日期,知识库可以随时更新。
典型 RAG 由两部分构成:检索器从知识库找出相关片段,生成器(通常是 LLM)拿到片段作为上下文生成答案。
以公司知识库为例:
query = "退款流程"results = retriever.search(query, top_k=2)# ["退款政策:订单签收后7天内可申请全额退款,需提供订单号...",# "退款操作步骤:1.进入'我的订单' 2.选择需退款的订单 3.点击'申请退款'..."]answer = llm.generate(system="你是客服助手。", context=results, question=query)# → "您可以在签收后7天内申请全额退款。操作步骤:..."
核心流程只有三步:检索相关片段 → 注入上下文 → LLM 基于上下文生成答案。
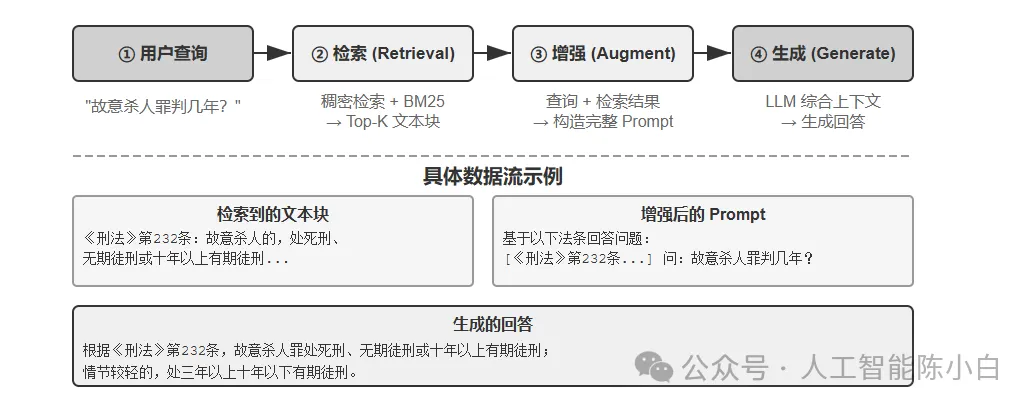
图 1:RAG 查询流程——检索、增强、生成
2. 文档分块
在检索之前,还有一步离线预处理:分块(Chunking),把长文档切成适合独立检索的片段。
为什么必须分块?
嵌入模型对输入长度有限制,而且一整篇文档压成一个向量时,多个主题混在一起,向量无法精确表达任何一个; 检索的目标是只把相关的那部分注入上下文。片段太大,会连带引入大量无关内容,浪费窗口、稀释注意力。
三类常见策略:
固定大小切分:按固定 token 数(如 512)切分,相邻块保留重叠(如 50–100 token),避免关键句恰好在边界被切断。实现简单、结果可预测,但无视文档结构——段落、代码、表格都可能被拦腰截断。
递归/结构感知切分:按自然边界(章节标题、段落、句子)递归切分——先按大边界切,仍超长再降级到更小边界。Markdown、HTML 等有显式结构的文档尤其适合。这是目前生产系统最常用的默认选择。
语义切分:计算相邻句子的嵌入相似度,在语义「断崖」处下刀,使每块内部主题尽量单一。质量更高,代价是需要额外嵌入计算。
块大小与重叠是一对权衡:
块太小,单块信息不完整,脱离上下文后语义模糊(「该公司收入增长了 3%」——哪家公司?哪个季度?); 块太大,一块混杂多个主题,嵌入被稀释,检索精度下降,命中后还带入更多无关内容。
常见起点是每块 256–1024 token、相邻块重叠 10%–20%,再根据检索质量实测调优。
无论哪种策略,分块都会切断片段与原始上下文的联系——「该公司」指代谁、这段话出自哪份报告,这些信息留在块外。这是分块的固有缺陷,后面用「上下文感知检索」修补。
3. 稠密嵌入:语义相似
计算机不能直接理解「苹果」和「橙子」,嵌入把词或句子转化成一串数字(向量),并让语义相近的内容向量也相近。这些向量所在的空间是一张高维地图,语义越接近,点越靠近。
经典例子:国王 - 男性 + 女性 ≈ 女王,说明向量运算可以捕捉语义关系。「稠密」是相对于稀疏嵌入而言:稠密向量每个维度都有数值,稀疏向量大部分维度为零。
衡量两个向量有多近,常用余弦相似度:计算夹角余弦,越接近 1 表示方向越一致、语义越相似。为什么用夹角而不是距离?因为我们关心方向(语义是否相近),而不是长度(文本长度或词频)。两篇内容相同但长度不同的文档,向量长度不同、方向一致,余弦相似度能正确判断语义相同。
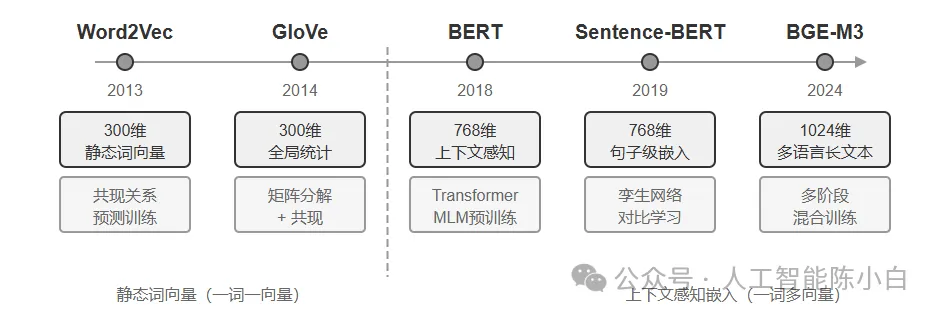
图 2:稠密嵌入技术演进
早期 Word2Vec 通过海量文本中词汇的共现关系,为每个词生成固定向量;它能捕捉语言规律,但无法处理一词多义——bank 在「河岸」与「投资银行」中向量相同。
现代嵌入模型(BERT、BGE-M3)在生成词的向量时会考虑整个句子甚至段落。自注意力让模型计算每个词时参考句中所有其他词,因此「苹果」在「苹果公司发布新产品」与「买了两斤苹果」中会得到不同向量,实现从「词汇级」到「语境级」的飞跃。BGE-M3 等模型还支持多语言与长文本;BERT 这类较早模型的输入上限只有 512 token,不适合长文本。
海量向量中快速找最近邻,需要 ANN(近似最近邻)索引。两类主流算法:
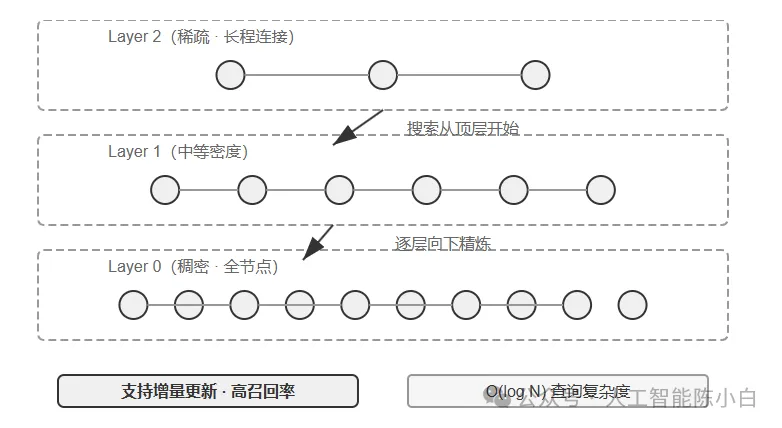
图 3:HNSW 索引结构
索引策略与嵌入模型同等重要,它直接决定性能、成本与可维护性。
4. 稀疏嵌入:精确匹配
与捕捉语义的稠密嵌入不同,稀疏嵌入根植于传统信息检索,核心是精确关键词匹配。它把文档表示为极高维向量,绝大多数维度为零,只有文档中出现的词对应的维度非零。理论基石是词袋模型(BoW):只关心哪些词出现、出现几次,忽略词序——「猫追狗」与「狗追猫」在词袋中完全相同。
TF-IDF 的直觉是:一个词在当前文档出现越多、在整个语料库越少见,对检索越重要。100 篇文章中 60 篇含「模型」、只有 3 篇含「蒸馏」,那么「蒸馏」更能区分哪些文章真正与「模型蒸馏」相关。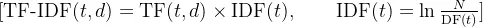
朴素实现有两个局限:词频随出现次数线性增长(出现 10 次得 5 次的两倍分),且没有校正文档长度(长文档仅因字数多就更容易得高分)。
BM25 对这两点做修正:保留 IDF 对稀有词加权,同时引入词频饱和与长度归一化:
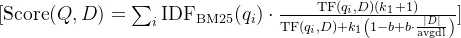
其中  控制词频饱和速度,使重复出现的边际贡献递减;(b) 控制长度归一化强度,使不同长度文档更公平比较。一个词出现 10 次通常不会比出现 5 次贡献整整两倍;相同词频在较长文档中权重更低。
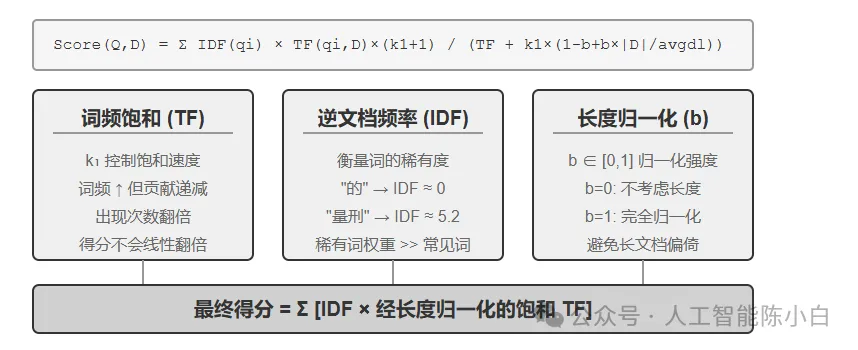
图 4:BM25 评分机制
稀疏检索的优点是精确:技术代码、人名、错误码等查询表现极佳;缺点是读不懂同义表达——搜「kitty」找不到只写了「cat」的文档。
5. 混合检索:两路互补
稠密懂语义但可能漏关键词(搜「HTTP-403」返回泛泛的「服务器错误」讨论),稀疏精确但读不懂同义词。混合检索的思路很简单:两路都跑,结果合并;难点在于如何把分布迥异的两组得分整合成有意义的排序。
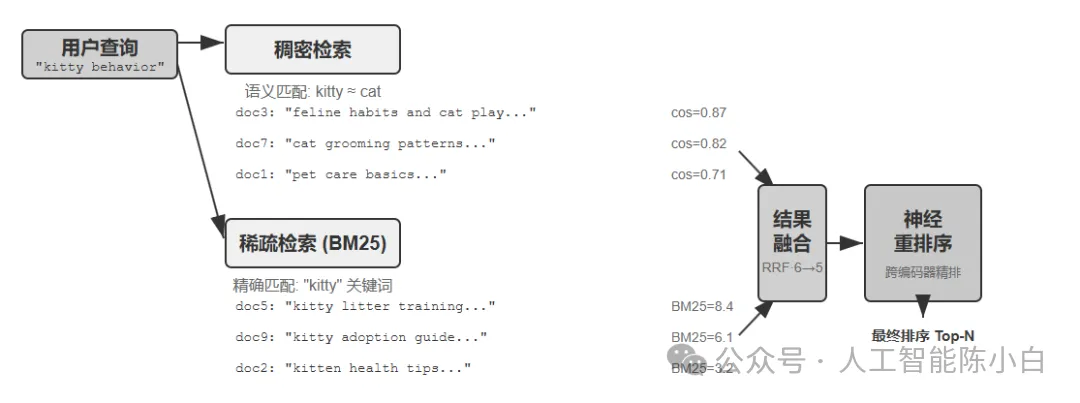
图 5:混合检索与重排序流水线
典型流水线分三阶段:
- 并行检索
:同时向稠密与稀疏引擎发查询,各自召回候选; - 结果融合
:把两路结果合成统一候选池。稠密余弦得分通常在 0–1,BM25 得分可能 0–几十,尺度与分布完全不同。常用倒数排名融合(RRF):完全抛开原始得分、只看排名,每个文档的综合得分是它在各路结果中排名的平滑倒数之和, score = Σ 1/(k + rank),k常取 60,用于压低前几名之间的差距。RRF 简单稳健,但只利用排名信息,丢失原始得分中的相关性信号。 - 神经重排序
:对融合候选池中排名靠前的 N 个(如前 50)逐一精排。它不是「补救 RRF 丢掉的得分」才存在——无论前一步怎么融合,重排序都值得加,因为它换用了更强的匹配范式。
双编码器与跨编码器的区别可以用招聘打比方:
- 双编码器
:查询与文档独立生成向量,靠向量运算比相似度,速度极快,适合从海量数据初筛; - 跨编码器
:把查询与候选文档拼接成一段文字送入模型,逐词比对、输出综合相关性得分,慢得多,但判断更准。重排序器通常采用这种架构。
融合负责产生统一候选池,重排序负责在候选池上精排,两者不是替代关系。
6. 检索质量怎么量
调优多阶段流水线需要客观指标,最核心的三个都在带标注答案的测试集上计算:
工业界还常说检索失败率:正确信息未出现在 top-20 结果中的查询比例。
严格说,上面定义的 recall@k 更接近命中率(hit rate / success@k):前 k 个结果里只要有一篇相关文档就算命中。学术上的 recall@k 指「相关文档被召回的比例」,一个查询有多篇相关文档时两者并不相等。跨来源比较时要留意口径。
7. 补记
RAG 的常见误区是把它当成「接一个向量库就完了」。实际上,分块决定检索的上限,嵌入决定语义覆盖,稀疏检索兜住精确匹配,重排序决定最终排序质量——任何一环短板都会让最终答案变差。
另一个经验是:先量检索,再调生成。如果正确文档根本没被召回,换更强的生成模型也无济于事;recall@k 与失败率应该作为 RAG 的第一组监控指标。
欢迎同学添加小助手,获取代码或加入人工智能圈交流群