LLM学习笔记-47-关于投机解码-DFlash & DSpark(之五)-硬件感知前缀调度
- 2026-11-05 11:39:35
本笔记继续介绍:Hardware-Aware Prefix Scheduler (硬件感知前缀调度)
• 利用置信度头预测出的存活概率 和当前的硬件负载曲线 SPS(B),动态计算出当前最优的验证长度 。
个人感觉理解这部分的关键,也是DSPARK明显区别于其他方法的核心是,它是从系统的角度做的优化,不仅仅考虑单用户,单请求,而是引入了多请求这个维度,站在最大化整个系统的动态吞吐的角度来确定验证的长度。(是不是很像通信系统里面的多用户调度?调度哪些用户使得系统吞吐量最大)。
我们定义:
• :活跃请求的数目; • :请求 的逐位置的置信度估计; • 为请求 被调度的验证长度;
几个关键量的定义:
• 前缀存活概率:(假设前面的都活下来,第 个也活下来的概率)。 • 总 batch 大小(以 token 计):。每个请求至少有 个 bonus token(目标模型本来就要生成的那个),再加上 个验证的草稿 token。(包含系统全部的请求) • 期望接受 token 数:。每个验证位置 的期望贡献就是它的存活概率 。(包含系统全部的请求) • 吞吐曲线:引擎在 batch size 下的 steps/sec。这是引擎初始化时离线 profile 一次得到的轻量 cost table。
调度器的核心思路是:通过动态选择验证长度 来最大化期望的系统级 token 吞吐量
详细解释一下这个吞吐量公式的物理含义:
• (Expected Accepted Tokens):单次前向传播(1 step)能产出多少有效 token。在推测解码中,目标模型跑一次,除了能生成它本来就要生成的 1 个基础 token 外,还能顺便验证草稿模型给的 个 token。由于这些草稿 token 有各自的存活概率 ,所以 是一个期望值()。单位:token / step。 • (Steps Per Second):系统每秒能跑多少次前向传播(step)。这就是你常说的推理速度。但这速度不是固定的,它受限于当前的 batch size 。当 很大时,GPU 算力被吃满,单次 step 的耗时就会变长,SPS 就会下降。单位:step / 秒。 • (System Token Throughput):系统级吞吐量,即整个系统每秒能吐出多少个 token。单位:(token/step) × (step/秒) = token / 秒。
**一句话总结: 就是在算,在当前负载下,系统每秒实际能产出多少真实可用的 token。
从公式可以看出:
• 增加验证长度(增大 )的收益: 会变大,因为多验证一个词就多一点期望收益。 • 增加验证长度(增大 )的代价:总 batch 里的 token 数 变大了,挤占了 GPU 资源,导致 下降。
调度器要做的,就是寻找那个让 和 乘起来最大的黄金分割点。
🔴采用贪心算法:
1) 先计算每个请求、每个前缀长度的“存活概率”;2) 按存活概率从高到低进行排序,并按照这个顺序,逐一选择对应请求的对应前缀长度进行贪心尝试;3) 每加入一个前缀单元,就用“预期接受量 × 硬件在对应 batch size 下的 step 速度”估计吞吐;4) 保留能提升吞吐的选择,一旦不能提升就停止。
一句话概括:
先计算每个请求各前缀长度的存活概率,再按概率从高到低贪心加入前缀,用“预期接受量 × 硬件 step 速度”评估吞吐,找到使有效吞吐最大的每个请求前缀长度。
🔴我们逐一具体拆解论文算法步骤,论文描述还是很清楚的:
论文描述如下:
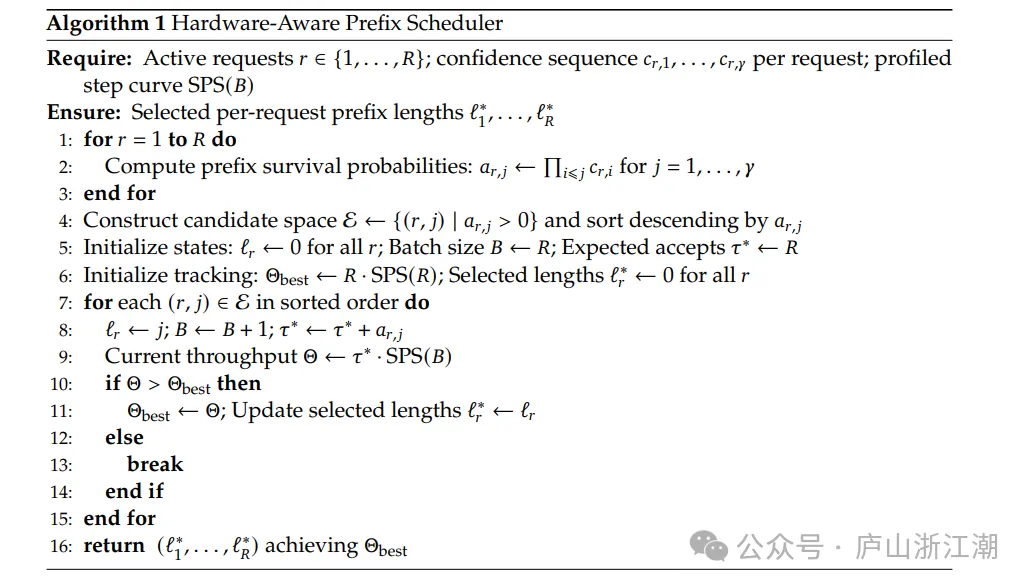
图中符号定义如下:
1) step 1 ~ 3: 首先 计算每个请求的每个前缀位置的存活概率:对应伪码:
• 对 到 执行循环; • 对每个请求 ,计算前缀存活概率:
2)step 4 :构造候选空间并按存活概率降序排序
候选空间为:
含义:
• 每个候选 表示“请求 的的前缀长度为 ”; • 只保留 的候选,排除存活概率为 、完全无收益的前缀; • 然后按 从大到小排序。
排序的目的:
• 优先尝试“最可能被接受”的前缀;满足贪心策略,先把收益概率最高的前缀加入调度; • 同一请求的不同长度 中,通常短前缀的 更大,满足,符合树的顺序特征。
3)step5 和 step 6 为初始化操作
• :初始时所有请求都不选择额外前缀; • :初始 batch size 为请求数 ,可以理解为每个请求先占一个基础调度单元; • :初始预期接受量为 ,可理解为每个请求至少有 1 个基础接受贡献。 • : 因为 初始为 ,$\tau^*R$, 所以得到这个吞吐量的初始值。 • :初始时所有请求都不加前缀。
4)step7~15 :贪心遍历和早停过程:
: (按存活概率从高到低遍历候选){把候选的 对应的请求 的 前缀长度 , 加入更新尝试;
更新对应变量:
• :把请求 的前缀长度设为 ; • :每加入一个候选前缀单元,batch size 增加 。 • :当前配置的预期接受量增加 。
计算当前吞吐估计:
•
如果吞吐变好,就接受并更新最优:如果不能变好,直接停止:if - : 更新最优吞吐 ; - : 更新该请求的最优前缀长度 else break; end}
最后 :返回达到最优吞吐 的每个请求前缀长度:
这里的排序很重要:是贪心搜索和早停的前提:
优先把“最可能存活、收益最高”的前缀节点加入调度;每加一个节点就增加一点 batch 负担,同时增加预期接受量;一旦硬件速度下降导致吞吐不再提升,就停止。

