LLM学习笔记-45-关于投机解码-DFlash & DSpark(之三)串行头
- 2026-11-04 12:39:17
本篇笔记正式进入DSpark部分:
1. 背景和简介
我们回归一下每生成 token 的平均延迟公式:
从上面的公式可以看出:提升加速比可以从3个角度进行:降低 (草稿更快)、提高 (草稿更好,平均接受长度更长,接受率更高),或降低有效的 (验证更聪明)。
• 传统的自回归草稿器(如EAGLE-3)取得高 ,但要付出 的代价,即草稿成本随 draft的token个数线性增长 • 并行草稿器(如DFlash) 把 压缩为单趟并行向前,却因每个位置被独立预测而牺牲了 。 • 同时固定长度验证会把 浪费在几乎注定被拒的低置信后缀 token 上。
DSpark 则从两个方面来对这些局限进行改进,从而提升加速比。
参考论文说明:
DSpark,一个把高吞吐并行生成与自适应、负载感知验证统一起来的投机解码框架。DSpark 的核心是通过两个互补机制来化解草稿生成与验证的权衡。
• 其一,DSpark 采用半自回归架构。它让计算上昂贵的草稿主干保持完全并行,仅追加一个轻量的串行输出头(serial output head)来注入局部转移信息(local transition information)。这一设计既保留了并行模型的草稿速度,又显著缓解了后缀衰减。 • 其二,DSpark 采用置信度调度验证。通过将一个估计前缀存活概率的confidence head与一个hardware-aware scheduler耦合起来,DSpark 为每个请求动态裁剪验证长度。该调度器仅把目标验证预算投向有最高期望回报的 token。
• 半自回归生成(论文中3.1 节)。 • 基于🔵DFlash并行主干处理草稿计算的大头,使 几乎与 无关。外加一个🔵轻量的顺序块(sequential block)在草稿 token 间注入依赖,以极小的额外延迟提升 。 降低 (草稿更快)和 提高 • 置信度调度验证(论文中3.2 节)。 • 引入一个🔵置信度头(confidence head)估计逐位置的接受概率,一个🔵硬件感知调度器(hardware-aware scheduler)利用这些估计来剪除低置信后缀 token,削减不必要的验证计算。 降低 (草稿更快)和 提高
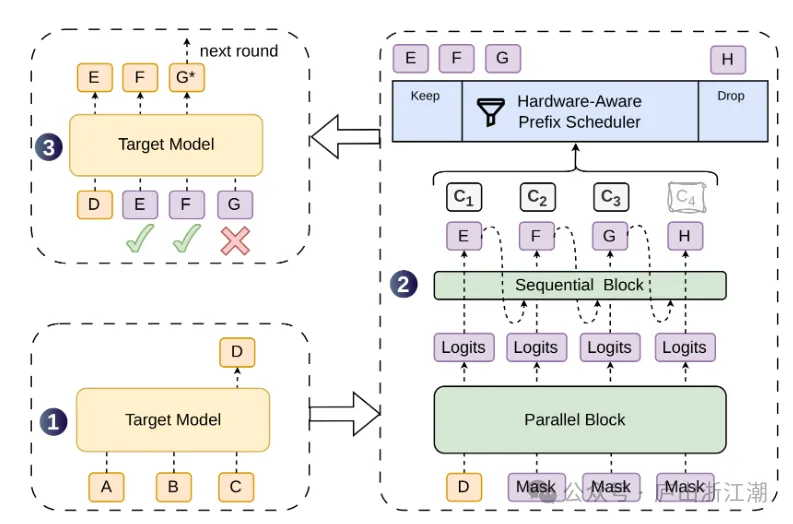
下图是参考论文里面的架构图示:
过程描述:
• 给定提示 token ABC,目标模型执行一步生成下一个 tokenD(草稿阶段的锚点);• 以 D为输入,DSpark 用重型并行主干(DFlash为基础) + 轻量顺序头生成草稿EFGH及置信度C1 ~ C4;• 硬件感知前缀调度器保留前缀 EFG、丢弃低置信H;• 目标模型并行验证被调度前缀, E、F接受而G拒绝,于是生成修正 tokenG*完成本轮。
相对于DFlash,DSpark做了如下更新演进:
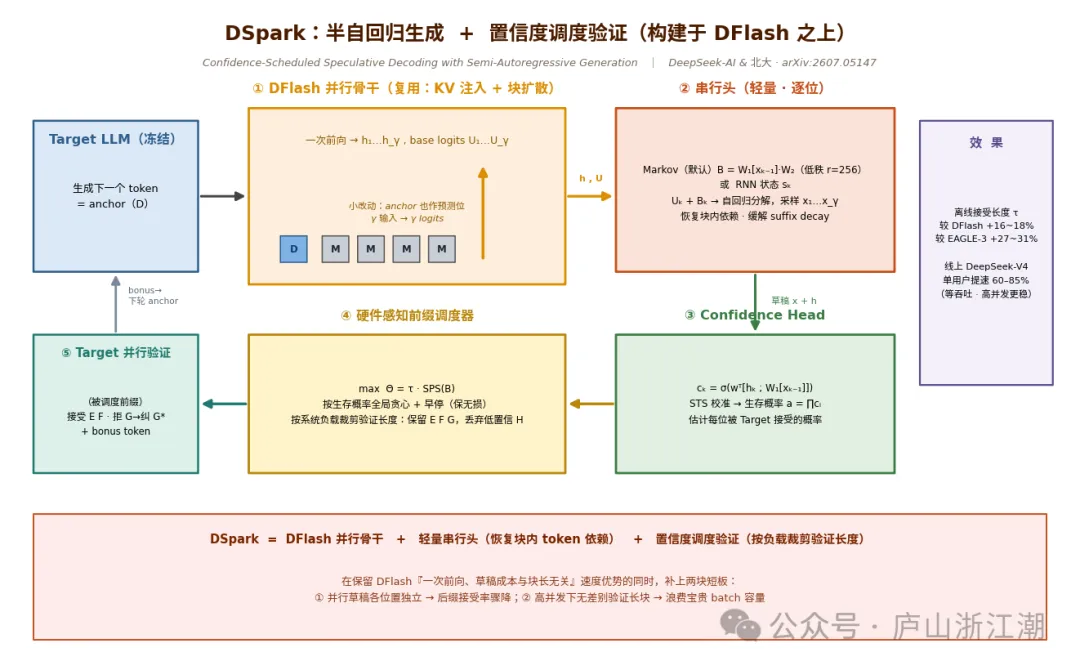
1)DSpark 直接复用 DFlash 作为并行骨干(唯一改动:anchor 位置也作为预测位, 个输入给出 个 logits)。
2)在其上新增两个轻量头与一个调度器:
1. 串行头(sequential head):给骨干的 base logits 加转移偏置,把"块内独立"变成"块内链式依赖"; 2. 置信度头(confidence head):预测每个草稿 token 被接受的概率,经 STS(Sequential Temperature Scaling 校准); 3. 硬件感知前缀调度器:按真实硬件的吞吐曲线选择最优草稿前缀,部署时异步运行。
从下面架构图里面可以清楚看到:DSpark 在 DFlash的主干①上面新增了串行头②,置信度头③和硬件感知调度器④部分:
本篇笔记主要来详细记录一下 DSpark 的半自回归生成 部分(即②串行头部分)。
2 半自回归分解(semi-autoregressive)
半自回归分解分为2个阶段 Parallel Stage 和 Sequential Stage
2.1 Parallel Stage
基于DFlash的一个并行主干对整块做单次前向,输出: 产生隐状态 和基础 logits 。
这里DSpark 对 DFlash 主干的唯一改动:
不再喂入一个锚点 token 加 个掩码 token 并只预测掩码位置,而是把锚点本身当作第一个预测位置,于是 个输入 token(锚点 + 个掩码)产出 个草稿 logits。这在维持相近草稿质量的同时减少了草稿计算。
即原来 DFlash : 个输入 token(锚点 + 个掩码) 个草稿 logits而现在DSpark: 个输入 token(锚点 + 个掩码) 个草稿 logits
2.2 Sequential Stage
纯并行的 DFlash 建模的是块内独立边缘分布的乘积;DSpark 把块内联合分布改成以已采样前缀为条件的链式分解:
这里
表示:在给定锚点 和已采样前缀 的条件下,在第 个位置取 token 的概率。对每个 都算一个值,就得到该位置完整的条件分布。
DSpark中,每个位置的条件分布在骨干 base logits 上加一个转移偏置 :
其中:
• :当前要预测的位置; • :该位置的一个候选 token; • :第 个位置上的随机变量; • :最终实际采样或确定的 token; • :骨干模型给出的第 个位置、候选 token 的 base logit; • ::串行头给候选 token 的转移偏置,输入是之前的token: 。 • 分母里的 也是词表里的候选 token,用来归一化,保证对所有 的概率和为 。
关键: 由极轻量的串行头产生,串行循环只走小矩阵(低秩),不走骨干。——所以并行骨架不动,串行代价仅 +0.2~1.3% 延迟。
通过 偏置的引入,在base logit上增加了和prefix-dependent transition偏置,这样在block内部的各个草稿位置之间引入因果依赖关系(类似于自回归的串行)。
与DFlash相比,这里的演进关系:
• DFlash: 把草稿从" 次串行前向"压成"1 次并行前向",但代价是块内独立假设; • DSpark :用一个几乎免费的低秩串行头把依赖关系补回来——并行拿速度,串行只走小矩阵拿质量。
2.3 串行头的两种形态
1)第一种:Markov 头(默认,最简):只看上一个 token,不看骨干隐状态 :即 只依赖于前一个token,一阶转移 .为方阵 ,近似分解为两个矩阵相乘 维度如下:
其中 用于embedding 查找表;用于logits 投影。即:在前一个位置上的草稿token 为输入,通过 进行embedding 查表,得到向量,再乘上 得到最终的 向量。
每步开销 = 一次 embedding 查表 + 一次 矩阵乘。开销很小。
这里, 是 的第 行,维度为 ,得到: , 最终覆盖整个词表 。
• 作为整个词表上的偏置向量:,其中第 个分量就是 。它和骨干 base logits 逐维相加,然后沿词表维 做 softmax。
维度变化如下式:
随后它与骨干 logits 逐元素相加:
总结:Markov 头就是用一个极小的查表矩阵()和投影矩阵(),以极低的计算代价,在并行的基础上注入了“前一个词对后一个词”的强关联引导。
物理含义: 理论上为方阵 ,物理含义是词表里面的词和其他词的关联性 ,但其实词与词之间的有效关联(转移规律)其实蕴含在一个很低的维度()里,所以可以做这样的近似处理。
2)第二种: RNN 头(变体,更强但略贵):维护门控状态 ,同时消费上一个 token 与骨干隐状态:
• Markov头在一步之外是无记忆的——位置 无法访问 之前的 token。 • RNN头通过维护一个递归状态 (可以理解为一个“记忆本”)来放松这点,它会把从块开始到当前的所有历史信息都压缩进 里,累积块内的完整前缀历史。
其分为3步处理:
1)输入向量 的拼接:
在每一步的位置,RNN头会把3个东西拼接起来:
• :历史的记忆(上一步的 RNN 状态),维度是低秩维度 。 • :前一个词的查表向量(就是 Markov 头里的那个查表,代表局部上下文),维度是 。 • :主干网络的隐状态(包含了整个全局大模型对当前词的宏观理解),维度是大模型的维度 。
拼接起来,输入向量的总维度就是 。
2)门控状态更新公式:(状态 的更新)
这是一个非常经典的 门控循环单元(GRU) 的变体,用来决定“保留多少旧记忆”和“写入多少新信息”。
• 和 (Sigmoid 函数):Sigmoid 会把数值压缩到 之间。这个结果 叫做门控信号(遗忘门/更新门)。它像一个水龙头,决定上一步的记忆 有多少能流过来。 • :这是根据当前输入 提炼出的候选新记忆。 把数值压缩到 之间。 是提取候选记忆的权重。 • (Hadamard 乘积):逐元素相乘。 • 整体逻辑: • 第一项 :保留旧记忆。如果门控值为 ,则全部保留;如果为 ,则全部遗忘。 • 第二项 :写入新记忆。如果门控值为 ,则 ,完全写入新记忆;如果为 ,则不写入。 • 两者相加,得到当前步的最新记忆 。
3) 输出公式:(计算偏置 )
有了更新后的输入向量 ( 里面包含了,从而更新的状态会来影响偏置),我们还需要把它转换成词表上的偏置 :
• :先用权重 把输入 投影到低秩维度 。 • :非线性激活。 • :这就是个投影矩阵,把 维空间映射回整个词表空间 。 • 最终得到 (长度为 的偏置向量),加到DFlash输出的的 Base Logits 上。
其中 对应为门(gate)、候选(candidate)、输出(output)三部分的权重矩阵。状态 初始化为零。 这里表示门控信号。
注意: 消融中 Markov 头已拿下大部分收益,RNN 头再略增,所以通常默认配置用 Markov。
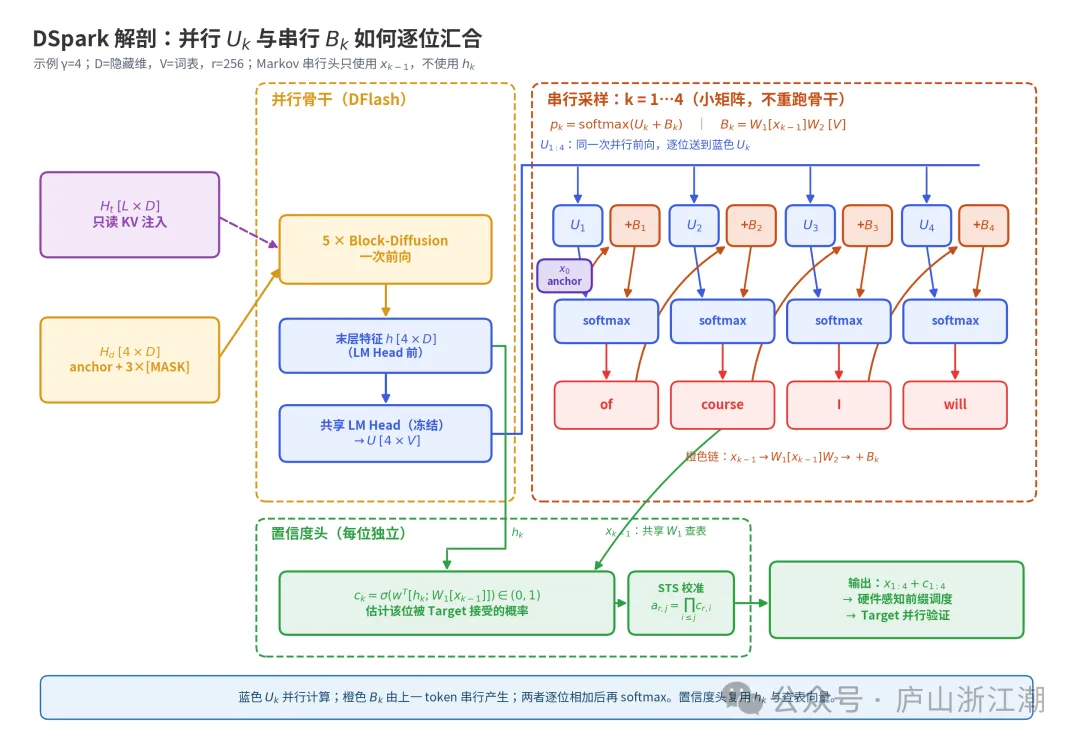
2.4 举例说明:
下图里面的串行采样部分,给出一个形象的图示说明基于Markov的串行头执行过程:
2.5 补充说明
这里补充说明一下前级DFlash骨干输出的 的用途:
是什么: = DFlash 骨干最后一个 Block-Diffusion 层的输出、送进共享 LM Head 之前的 feature。
输出用途有3个地方:1)生成草稿token的logits: 2) 用于置信度头的输入(下节再介绍)3) 如果串行头是采用RNN变体,则需要它进行输入拼接。
注意:Markov 头 不使用 骨干隐状态 ; 是喂给置信度头(及 RNN 变体)的。两者共享的只是 这份查表结果。

