PPT分享 | AI眼镜和传统XR有什么不同?拆解SoC、Micro LED与光波导的技术取舍
- 2026-11-10 03:17:20
合集标签: AI产业链深度拆解· 「产品篇」 > 后台回复关键词(见文末)领取完整 PPT 源文件
---
写在前面:
眼镜这个形态,其实不是第一次被尝试。2013 年 Google Glasses 就火过一轮,但它最终没有走进日常生活——太重、太怪、太贵,而且没有真正的"智能"可言。
十几年后它又回来了,这次带着大模型。而这一轮和上一轮最大的不同,我认为藏在一个很容易被忽略的细节里:
它里面塞了一颗 4nm 的手机级芯片。
这不是"加个蓝牙模块"那么简单。这意味着眼镜第一次拥有了本地的、足够的算力,去实时处理摄像头看到的东西、麦克风听到的声音。
这份 PPT 共 31 页,我把它重新组织成一条纯技术主线:从 AI 眼镜为什么能成为新载体,一路拆到 SoC 三大方案、Micro LED 显示、以及光波导的两条技术路线。
全篇不聊出货量、不聊价格带、不聊市场份额、不给任何倾向性判断——只讲清楚硬件架构与光学原理。
---
一、为什么是眼镜:它砍掉了什么
先回答一个根本问题——为什么 AI 落到眼镜上,而不是别的形态?
CES 2025 的信号
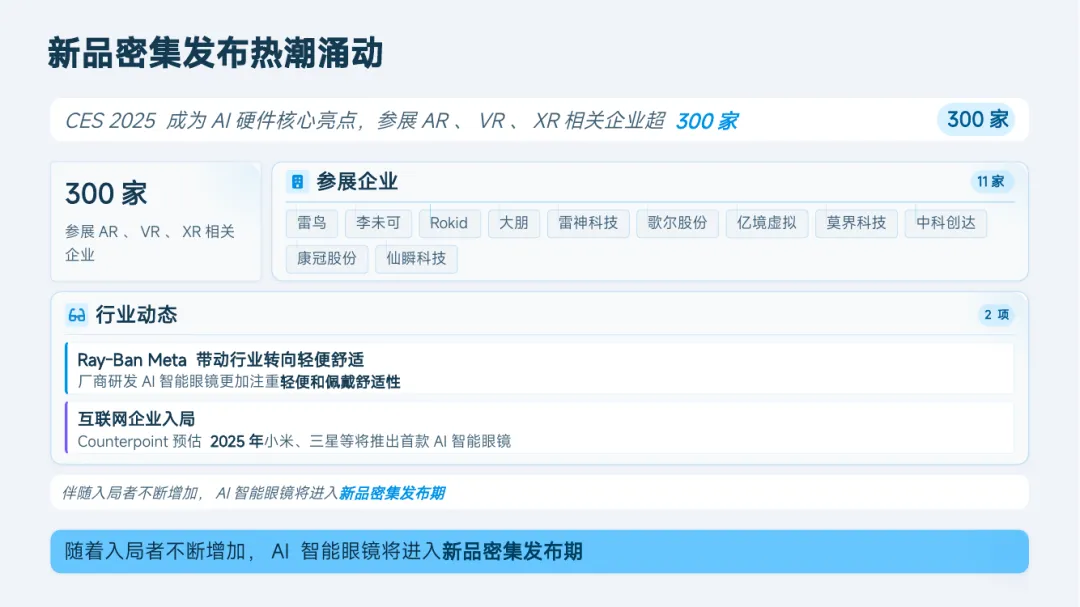
CES 2025 上,参展 AR、VR、XR 相关企业超过 300 家。
从品牌清单看,这已经不是某一家公司在探索,而是整条产业链同时入场:雷鸟、Rokid、星纪魅族、XREAL、歌尔、中科创达、Vuzix、光峰科技……覆盖了从整机到光学模组、从参考设计到微显示器的完整环节。
与传统 XR 的核心差异
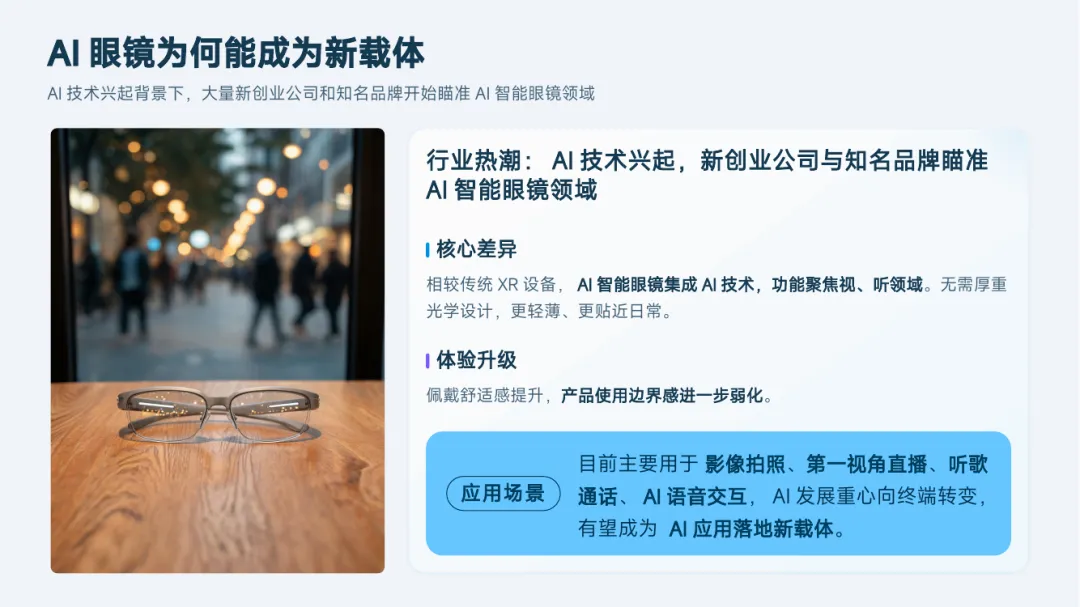
这是我认为最关键的一张对比,它解释了为什么这一轮能落地:
| 视、听领域 | ||
| 无需厚重光学设计 | ||
| 更轻薄、更贴近日常 |
PPT 里那句总结很准:
相较传统 XR 设备,AI 智能眼镜集成 AI 技术,功能聚焦视、听领域,无需厚重光学设计。
体验升级:佩戴舒适感提升,产品使用边界感进一步弱化。
当前主要场景:影像拍照、第一视角直播、听歌通话、AI 语音交互。
💡 请注意"砍掉了厚重光学"这个动作。 > 上一代 Google Glasses 和 VR 头显失败的共同原因,都是为了显示而牺牲了形态——又重又大,戴出去像"脸上挂了个仪器"。 > 而这一轮的思路是反过来:先把"显示"这个包袱丢掉(或做得很轻),只保留摄像头 + 麦克风 + 扬声器 + 算力——这四样恰恰是大模型最需要的输入和输出。 > 先做减法,才让它回到了"眼镜"该有的样子。
---
二、生成式 AI 加了什么:交互维度变多了
硬件之外,看软件侧的变化。
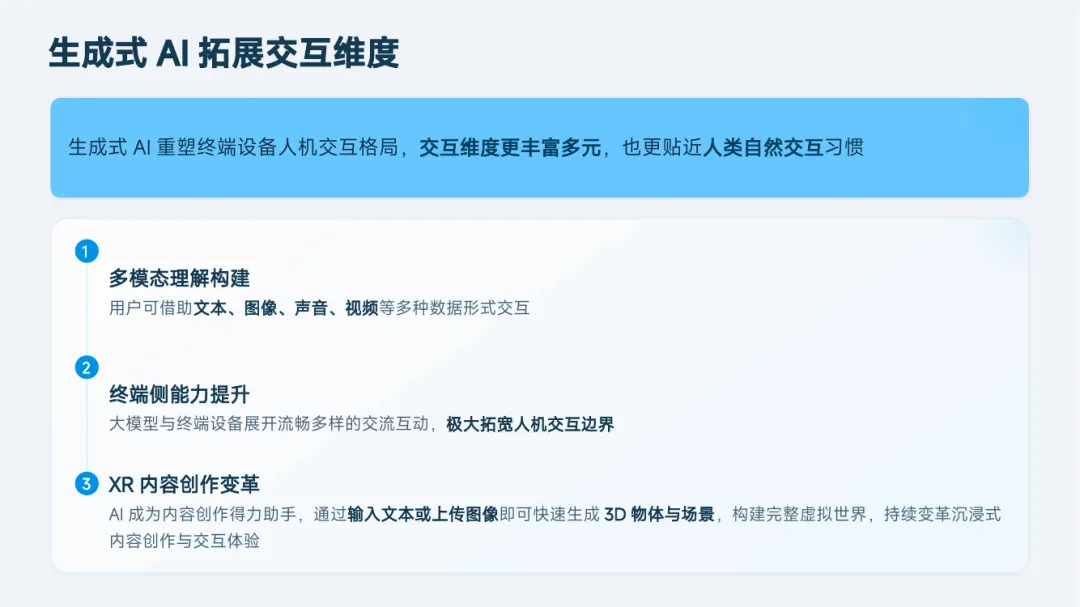
生成式 AI 重塑了终端设备的人机交互格局——交互维度更丰富多元,也更贴近人类自然交互习惯。具体是三个方向:
① 多模态理解构建
用户可借助文本、图像、声音、视频等多种数据形式交互。
💡 这正好对应眼镜的天然优势——它同时有摄像头(图像)和麦克风(声音),是离人体"感官输入口"最近的设备。多模态对眼镜来说不是新增功能,而是天生的输入通道。
② 终端侧能力提升
大模型与终端设备展开流畅多样的交流互动,极大拓宽人机交互边界。
③ XR 内容创作变革
通过输入文本或上传图像即可快速生成 3D 物体与场景,构建完整虚拟世界。
💡 AI 能生成 3D 内容,眼镜才有东西可显示。这两件事是互相成就的:内容生成门槛坍塌(3D生成篇),显示终端才有料可放(本篇)。
大模型落地的时间线
`` 早期探索 2013-2016 · Google Glasses 音频突破 2019-2021 · Bose Frames、Ray-Ban Stories AI 集成 2023 至今 · Ray-Ban Meta ``
2023 年初大模型崛起,带动了这一轮智能穿戴热潮。
各产品接入的大模型(这是技术集成视角,不是产品推荐):Llama 3、DeepSeek、通义千问、文心、GPT-4o、Gemini、Claude……几乎主流模型都进来了。
💡 这条时间线揭示了一个规律:硬件早就有了(2013),但缺一个"大脑"。 > 大模型出现之前,眼镜能做的只有"拍照、听歌、接电话"——它只是个挂在脸上的手机配件。 > 而大模型补上了"理解"这一环:它能看懂你看到的东西、听懂你说的话。硬件等了十年,等的是软件。
---
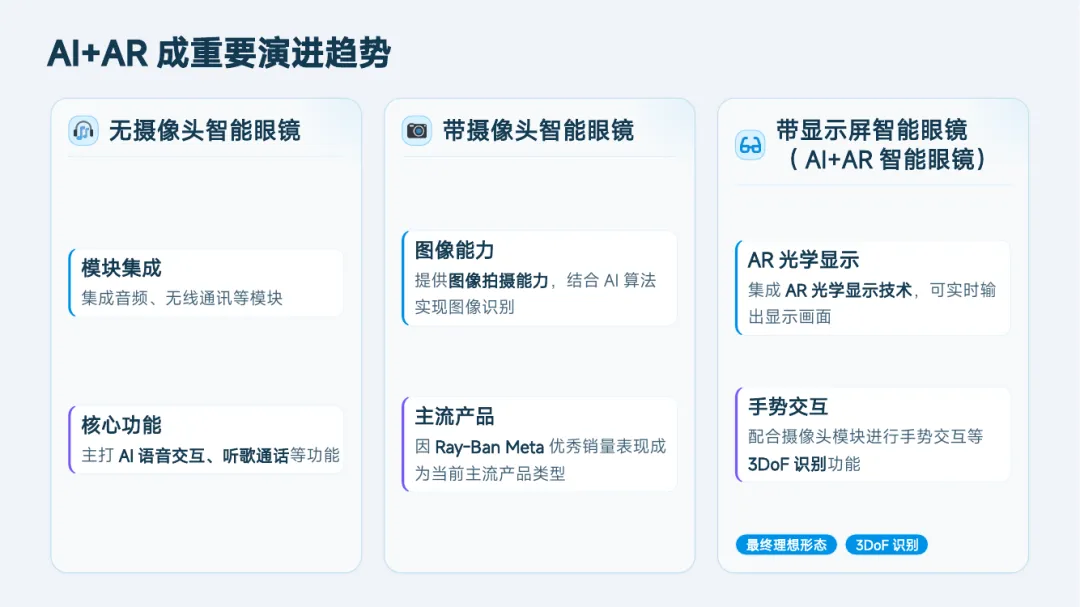
三、形态演进:三级台阶
这一章我认为讲清了"AI 眼镜"这个词的三种含义——很多人把它们混为一谈。
| ① 无摄像头 | ||
| ② 带摄像头 | ||
| ③ 带显示屏(AI+AR) | 待突破 |
最终理想形态是③——带显示屏的 AI+AR 眼镜。
💡 请注意成熟度标注的差异:①和②已成熟,③仍需软硬件进一步突破。 > 这个判断很重要,因为它意味着:市面上绝大多数量产产品其实是②(带摄像头),而真正"显示"的③还没有完全准备好。 > 后文会讲到为什么——难点全在光学上。
---
四、核心:SoC 是它的"大脑中枢"
先分清 AI 眼镜和 AR 眼镜
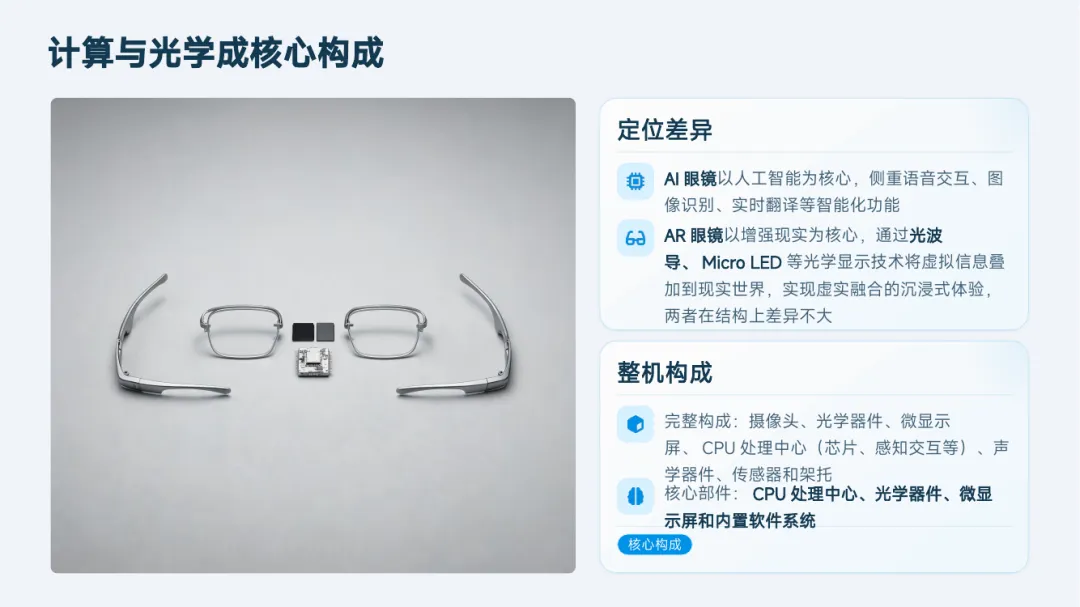
结构上差别不大,但定位不同:
| AI 眼镜 | AR 眼镜 | |
|---|---|---|
| 人工智能 | 增强现实 | |
| 虚实融合的沉浸式体验 |
整机构成:摄像头、光学器件、微显示屏、CPU 处理中心、声学器件、传感器和架托。
核心部件:CPU 处理中心、光学器件、微显示屏和内置软件系统。
💡 有意思的是那句"两者在结构上差异不大"——这说明硬件基础是共用的,差别在于算力花在哪:AI 眼镜把算力花在"理解"(语音、图像识别),AR 眼镜花在"渲染"(显示、虚实叠加)。
SoC 到底是什么
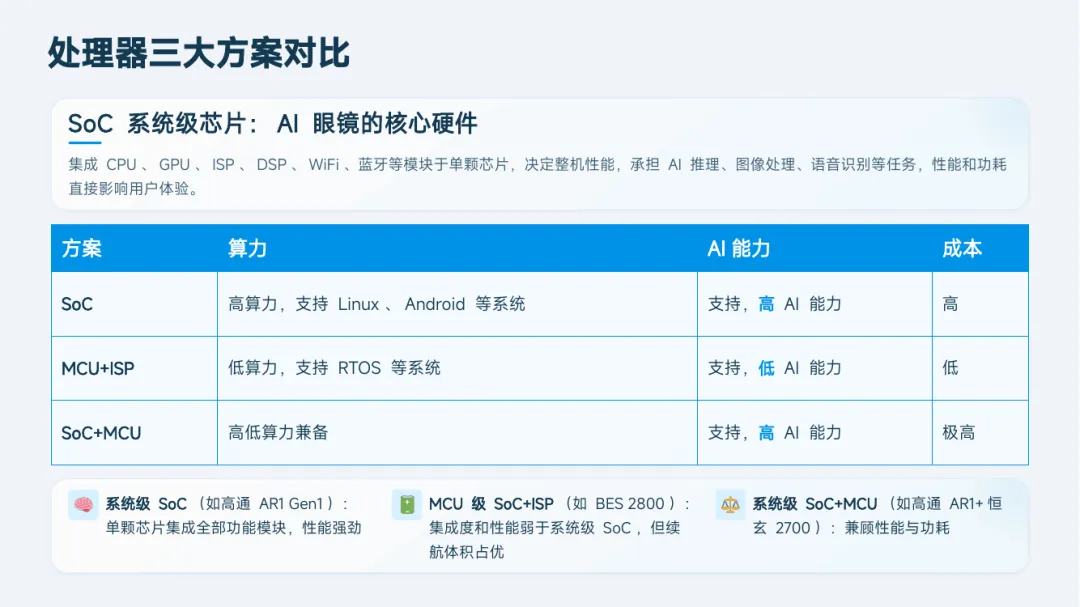
SoC(系统级芯片)——单颗芯片上集成 CPU、GPU、ISP、DSP、WiFi、蓝牙等模块。
它承担的任务:AI 推理、图像处理、语音识别。
性能和功耗直接影响用户体验。
三大处理器方案对比
这张表是全篇最实用的一页,它讲清了厂商面临的核心取舍:
| SoC | 高 AI 能力 | 高 | |
| MCU + ISP | 低 | ||
| SoC + MCU | 高低算力兼备 | 高 AI 能力 | 极高 |
三种方案各自的实现路径:
| 兼顾性能与功耗 |
💡 为什么会有"SoC + MCU"这种看似冗余的方案? 这其实是个很巧妙的工程思路—— > 大芯片干活时耗电,小芯片待机时省电。让高算力 SoC 只在"需要 AI 推理"时唤醒,平时由低功耗 MCU 维持基础功能(如蓝牙连接、唤醒词检测)。 > 这是所有电池供电设备的通用策略:手机有大小核、手表有协处理器,眼镜也不例外。续航是这类设备最大的敌人。
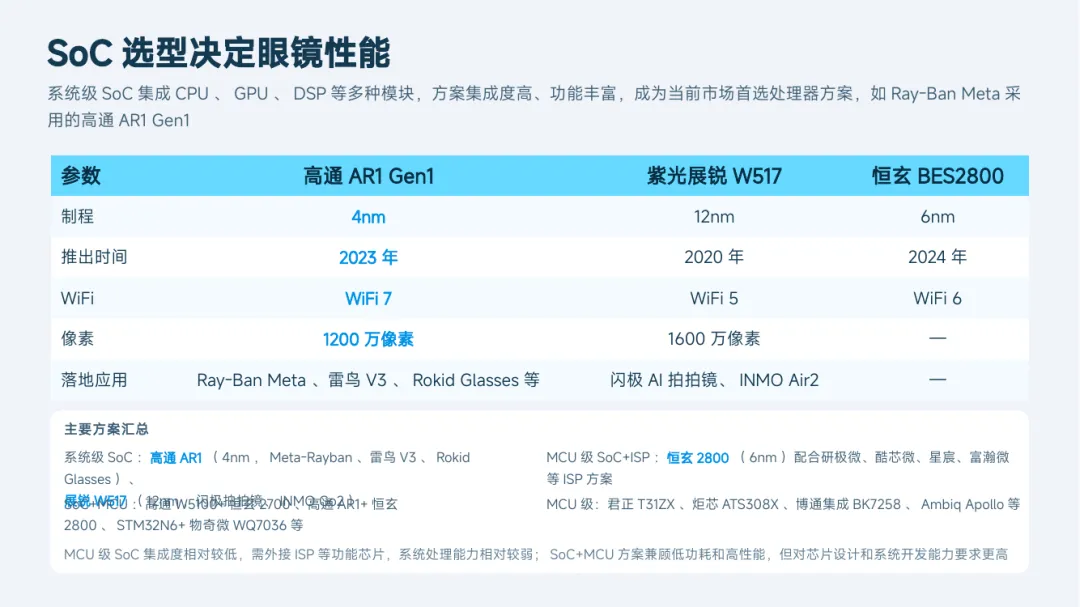
平台参数对比(纯技术规格)
| 制程 | 4nm | ||
| WiFi 7 | |||
💡 4nm 制程就是我在开头说的那个关键——它意味着眼镜用上了和手机旗舰同代的工艺。 > 为什么重要?因为端侧 AI 推理极其吃算力,而眼镜的体积决定了电池很小(通常一百多 mAh)。 > 要在这么小的电池下跑 AI,唯一的出路就是用最先进的制程换取能效比。4nm 不是"参数好看",而是这道物理题的唯一解。
高通 AR1 Gen1 平台细节
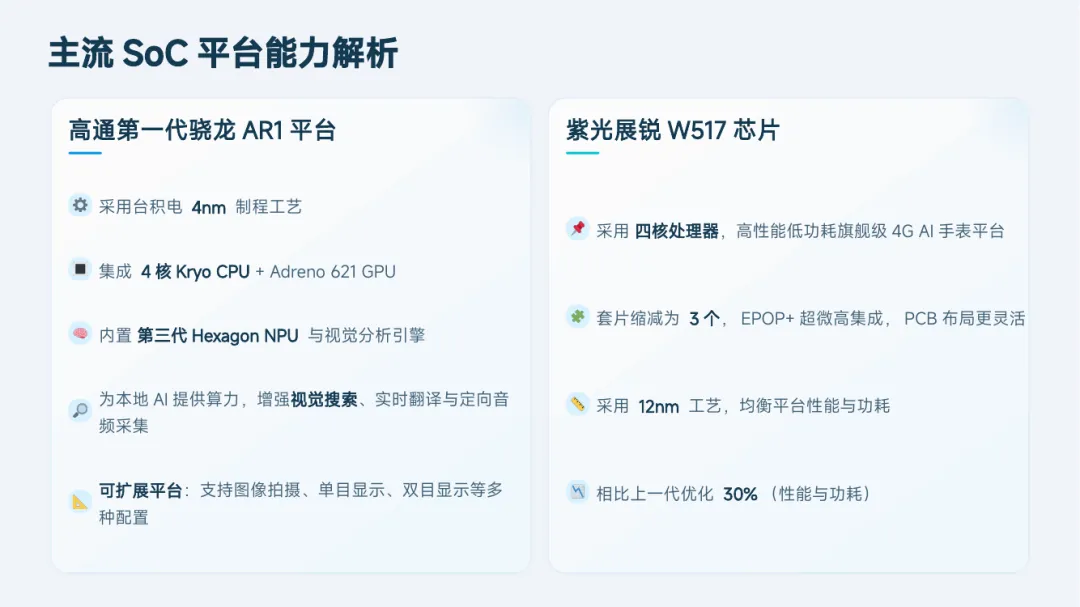
台积电 4nm 制程 - 4 核 Kryo CPU + Adreno 621 GPU
内置第三代 Hexagon NPU 与视觉分析引擎 为本地 AI 提供算力,增强视觉搜索、实时翻译与定向音频采集 可扩展平台:支持图像拍摄、单目显示、双目显示等多种配置
紫光展锐 W517: - 四核处理器,高性能低功耗旗舰级 4G AI 手表平台 - 套片缩减为 3 个,EPOP + 超微高集成,PCB 布局更灵活 - 12nm 工艺,均衡性能与功耗,相比上一代优化 30%(性能与功耗)
💡 "套片缩减为 3 个"这个细节很工程化——芯片数量越少,PCB 面积越小,眼镜才能做得更轻薄。 > 这和第⑦篇 AI 眼镜那篇讲过的"形态演进本质是结构件电子化"是同一条逻辑:每减少一颗芯片,就为镜腿腾出一点空间。
两代产品的代际差异(技术参数)
对比 Ray-Ban Stories 与 Ray-Ban Meta(仅看技术规格):
| SoC | AR1 Gen 1 | |
| 存储器 | 2GB + 32GB | |
| 5 麦克风阵列 · 空间音频 | ||
| AI | 不支持 | 接入 Llama 3 大模型 |
我认为最值得琢磨的两行:
① 存储器 4GB → 32GB,翻了 8 倍 —— 这不是简单的"容量升级"。 > 本地跑大模型需要加载模型权重,4GB 根本装不下。存储是端侧 AI 的硬门槛——这和第⑦篇讲过的"16GB 内存成 AI 手机基础配置"是同一个道理:参数量决定了存储下限。
② 电池 175mAh → 160mAh,反而变小了,但 AI 能力从"不支持"到"接入大模型" > 这个反差很说明问题:性能暴涨、功耗反而控制住了。原因就是前面说的制程进步(4nm)+ 大小核策略。 > 它证明的不是"电池变强了",而是"芯片变聪明了"。
---
五、显示:AI+AR 才是终极形态
讲完算力,看显示——这是第三章的核心。
Meta Orion:一次技术探索
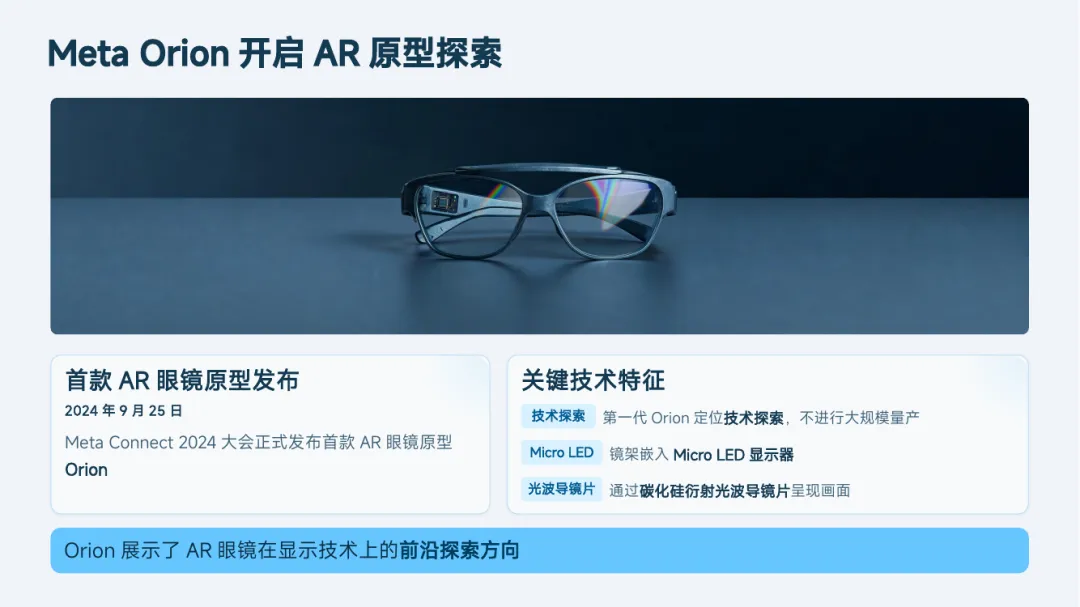
2024 年 9 月 25 日,Meta Connect 2024 发布首款 AR 眼镜原型 Orion。
关键技术特征: - 镜架嵌入 Micro LED 显示器 - 通过碳化硅衍射光波导镜片呈现画面
定位:第一代 Orion 定位技术探索,不进行大规模量产。
⚠️ "不进行大规模量产"这七个字很关键。它意味着:这套方案在技术上走得最远,但在工程上还不能普及。原型机和量产产品之间的差距,往往就是成本和良率。
为什么显示如此重要
先看一个基础事实:
视觉是获取外界信息的主要途径——眼睛接收光信号,经神经传导至大脑形成视觉。
所以显示能力决定了眼镜能承载多少信息。三档成熟度前面说过:
`` 无摄像头 → 已成熟 带摄像头 → 已成熟 带显示屏 → 待突破(需软硬件进一步升级) ``
带显示功能的眼镜能带来更广阔的应用场景,可最大化发挥 AI 技术的创新特性。
💡 判断的逻辑是:如果 AI 理解了世界,却只能"用声音告诉你",那它只是个语音助手。 > 只有把信息"投到你眼前",AI 的能力才能被完整释放——导航箭头叠在路面上、翻译字幕浮在对方嘴边、维修步骤画在设备上。这才是"AI+AR"的乘法效应。
Micro LED 的四大优势
| 亮度 |
| 对比度 |
| 刷新率 |
| 功耗 |
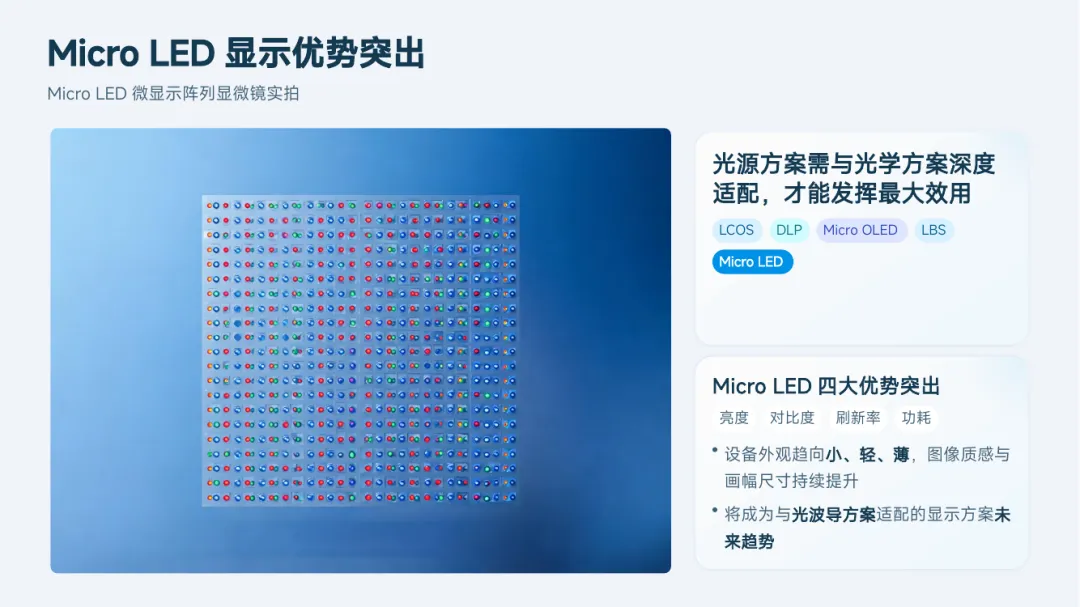
设备外观趋向小、轻、薄,图像质感与画幅尺寸持续提升,将成为与光波导方案适配的显示方案未来趋势。
一个很硬的技术指标(这是我认为全篇最有说服力的数据):
AR 眼镜满足户外场景使用,入眼亮度至少需 2000–3000 尼特。 > 目前 Micro LED 彩色光波导模组亮度可达 6000 尼特。
而且受益于像素级独立控制点亮特性,同等条件下功耗表现更好。
💡 为什么"户外亮度"这么关键? 因为眼镜和手机不同——手机在户外你用手挡一下就行,眼镜你没法给它打伞。 > 阳光直射下环境光可能上万尼特,如果显示器亮度不够,画面直接被冲没了。这就是为什么"2000-3000 尼特"是个硬门槛,而 Micro LED 能做到 6000 尼特——余量留得很足。 > 另外"像素级独立控制点亮"很妙:显示黑色时那个像素直接不发光,而不是"发弱光"。这和 OLED 的黑色省电同理,在大量暗色场景下能显著省电。
光源方案要与光学方案深度适配
光源方案需与光学方案深度适配,才能发挥最大效用。
可选光源:LCOS、DLP、Micro OLED、LBS、Micro LED。
⚠️ 这句话容易被当成套话,但它其实是整个 AR 光学设计的核心约束。 > 光源(发光)和光波导(传光)是耦合关系:不同光源的发光角度、偏振态、光谱特性不同,匹配错了效率会断崖式下跌。 > 所以"Micro LED 更好"不是绝对的——它必须和特定的光波导方案配合才能发挥优势。这就是为什么各家路线不同、且短期不会收敛。
---
六、光波导:两条技术路线
最后一章,讲光怎么从镜架"拐"到你眼睛里。
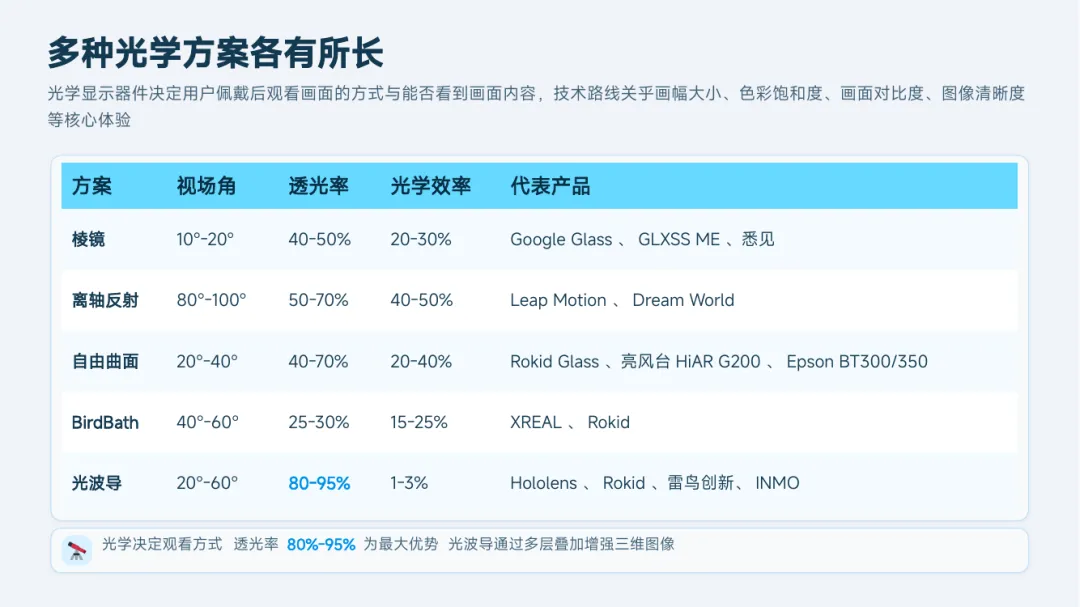
多种光学方案各有所长——PPT 列了完整的技术谱系,各方案在体积、视场角、光效、量产成熟度上各有取舍。
几何 vs 衍射:两条主流路线
几何光波导(阵列波导)与衍射光波导(表面浮雕/体全息)各有特色,是当前的两种主流实现路径。
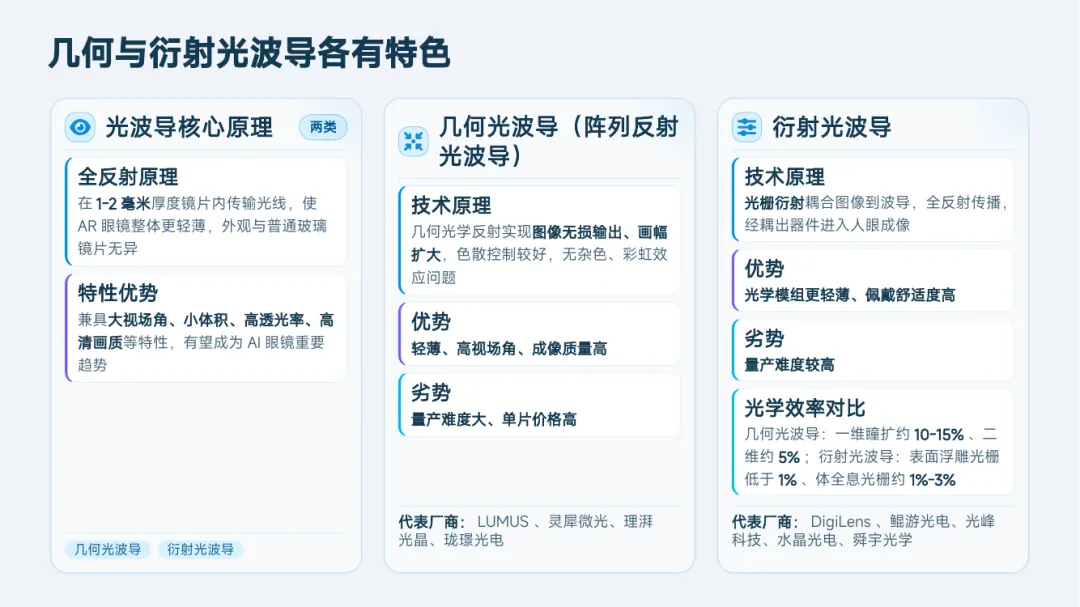
💡 用一个比喻理解它们的差别: > - 几何光波导像镜子迷宫——靠一系列半反射镜面把光"折"进眼睛。优点:色彩保真好、光效高;难点:镜面阵列加工精度要求极高,良率是瓶颈。 > - 衍射光波导像光栅——靠纳米级的周期性结构让光发生衍射。优点:可以做得很薄、易于批量复制;难点:存在色散(彩虹效应)和光效损失。 > > 这就是为什么两条路线并存:一个赢在画质,一个赢在可制造性。这与我们在第⑲篇 3D 生成讲的两条路线之争是同构的——工程上永远是在"性能"和"可制造"之间找平衡。
---
结尾:一个判断
因果链:
`` 大模型出现(2023) ↓ 需要理解能力 端侧算力升级(4nm SoC + 32GB 存储) ↓ 需要承载交互 形态做减法(砍掉厚重光学,先做视听) ↓ 需要解放体验 显示跟进(Micro LED + 光波导) ↓ AI+AR 终极形态 ``
这条链条里,任何一环缺席,眼镜都回不来。 2013 年 Google Glasses 失败,不是因为想法不好,而是链条上缺了最关键的两环——算力和大模型。
而我认为最容易被低估的,是那颗 4nm 芯片。
因为它是这条链条的"物理开关":没有足够的端侧算力,理解就必须上云,延迟和隐私都会崩。 > 这和我们在第⑪篇端侧 AI 讲苹果"70% 任务不出手机"的逻辑完全一致——端侧算力是"体验"和"隐私"的共同前提。
⚠️ 最后照例提醒一句:带显示屏的 AI+AR 眼镜,成熟度仍标注为"待突破"。 > Meta Orion 明确"不进行大规模量产",Rokid Glasses 等带显示产品"完成度仍需软硬件进一步升级"。 > 显示是终极形态,但不是今天就能普及的形态。 区分"已成熟"和"待突破",是理解这个品类现状的关键。
从炫技到实用,AI 眼镜正在成为下一代智能终端。
---
📦 硬核资料包
获取方式: 👉 关注公众号「哔咘的科技笔记」,后台回复【眼镜】,自动发送下载链接
👇 也可点击底部菜单「免费框架」领取更多产业资料
---
*合集:#哔咘的科技笔记 · 「产品篇」* *声明:本文为技术科普与产业观察,仅供学习交流,不构成任何投资建议。数据引自厂商公开信息与公开行业报告。*

