数据整洁:为什么你的 Excel表 AI 看不懂
- 2026-09-22 17:51:43
数据整洁:为什么你的Excel表AI看不懂
你把精心整理的 Excel 表丢给 AI,它却一脸懵——不是数据不够多,是格式不对。
01
PART
数据「看起来整齐」≠「机器能读」
SECTION
📱 10 Parts
➡ 向右滑动
PART 1
数据形状
SECTION
PART 2
整洁数据
SECTION
PART 3
数据格式
SECTION
PART 4
实战
PRACTICE
PART 5
六动词
SECTION
PART 6
管道符
SECTION
PART 7
踩坑提醒
SECTION
PART 8
技能总结
SECTION
PART 9
冷知识
TRIVIA
PART ///
下期预告
PREVIEW
上一期我们把 31 行脏数据洗成了 26 行干净数据。你可能以为:这下总能直接喂给 AI 了吧?
还不能。因为数据虽然「干净」了,但很可能还「不整洁」——内容正确≠结构正确,这是两个完全不同的问题。
举个例子。你统计了三个地区、三种作物的产量,Excel 表长这样:
对人来说,这张表一目了然——一列一作物,横向对比很方便。但对 AI 来说,这张表是「乱」的:Rice、Wheat、Corn 这三列的列名,本身不是数据的名字,而是数据的值。你问 AI「哪种作物产量最高」,它连「作物」这个字段都找不到——作物名藏进列名。
这就是为什么你的 Excel 表 AI 看不懂。问题不在数据质量,在数据形状。
02
PART
整洁数据三原则
SECTION
2014 年,R 语言大神 Hadley Wickham 发表论文《Tidy Data》,给「整洁」下了个精确定义。这篇论文后来成了数据科学的基石,pandas 和 tidyverse 的设计都受它影响。
整洁数据只有三条原则:
原则一:每个变量占一列。 地区是变量,作物是变量,产量是变量——每个变量单独一列。
原则二:每个观测占一行。 一行就是一次观测记录,比如「北部地区种水稻的产量」。
原则三:一个值一个格子。 一个格子里只放一个值,不放「520kg/亩」这种带单位的混合信息。
三条原则听起来像常识,但现实中的表格几乎条条都违反——因为表格是设计给人看的,不是给机器读的。
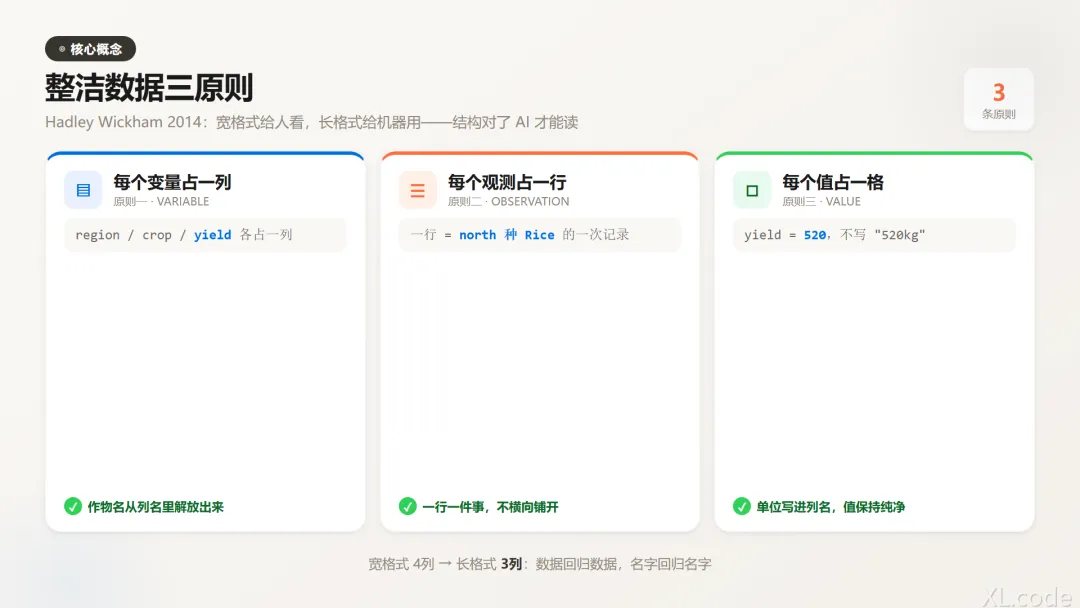
用这三条原则回头看刚才那张表:作物名藏在列名里,违反原则一;产量值散落在三列里,违反原则二。所以它不是整洁数据。
那整洁的版本长什么样?
三列:region、crop、yield。每个变量一列,每个观测一行,每个值一个格子。同信息不同结构——这个结构 AI 能直接读懂。
03
PART
宽格式 vs 长格式
SECTION
刚才那两种结构,有专门的名字。
第一种叫宽格式表格(wide format):一个变量的不同取值,铺开成多个列。它的优点是适合人看——横向对比一目了然,做报表、做展示很直观。
第二种叫长格式表格(long format):所有观测堆叠成少数几列。它的优点是适合机器算——筛选、分组、建模,所有操作都顺理成章。
一句话记住:宽给人看长给机器。
你的 Excel 表之所以是宽格式,是因为它是你的「工作成果展示」。但 AI 需要的是长格式——所以数据处理里最常见的操作,就是把宽格式宽转长操作,算完需要展示时再长转宽操作。
这两个操作,分别叫 pivot_longer(宽转长)和 pivot_wider(长转宽)。名字很直白:longer 是把列「拉长」成行,wider 是把行「摊宽」成列。
04
PART
️ 动手:宽转长实战
PRACTICE
我们用课程里的 crop_yield 数据集练手。先看宽格式的问题:
1
2
3
4
5
6
7
8
9
10
import pandas as pd
df = pd.DataFrame({
'region': ['north', 'north', 'south', 'south'],
'Rice': [520, 510, 460, 455],
'Wheat': [380, 390, 410, 405],
'Corn': [610, 600, 590, 585]
})
print(df.columns)
# Index(['region', 'Rice', 'Wheat', 'Corn'], dtype='object')
注意:作物名 Rice、Wheat、Corn 是列名的一部分。想算「所有作物的平均产量」,得手动指定三列;作物从 3 种变 30 种,代码就要改 30 处。结构绑死代码。
宽转长: 在 R 的 tidyverse 里用 pivot_longer,在 pandas 里对应的函数是 melt:
1
2
3
4
5
6
7
8
9
long_df = df.melt(
id_vars='region', # 保持不动的列
var_name='crop', # 列名收纳到这一列
value_name='yield' # 数值收纳到这一列
)
print(long_df.shape) # (12, 3)
# 长转宽(展示报表时用),pandas 用 pivot:
wide_df = long_df.pivot(index='region', columns='crop', values='yield').reset_index()
一行 melt,4 行 × 4 列的宽表,变成 12 行 × 3 列的长表。Rice、Wheat、Corn 从「列名」变成了「crop 列的值」——各归其位。
宽和长之间可以随意切换。记住一个经验法则:分析用长展示用宽。
05
PART
dplyr 六动词:数据处理的万能扳手
SECTION
宽转长只是第一步。真正日常的数据处理,80% 的工作用六个动词就能完成——这就是 R 语言 dplyr 包的六大动词,pandas 里都有对应操作。
select——选列。 只保留需要的列。filter——筛行。 按条件保留行。arrange——排序。 按某列升降序排列:
1
2
3
long_df[['region', 'yield']] # select:只留两列
long_df[long_df['yield'] > 500] # filter:只要高产记录
long_df.sort_values('yield', ascending=False) # arrange:产量从高到低
rename——改名。 列名改规范。mutate——造新列。 从现有列计算新列。case_when——条件分箱。 按条件给数据分类:
1
2
3
long_df.rename(columns={'yield': 'yield_kg'}) # rename
long_df['yield_ton'] = long_df['yield'] / 1000 # mutate:公斤转吨
long_df['level'] = np.where(long_df['yield'] > 550, 'high', 'normal') # case_when
六个动词,覆盖数据处理的绝大多数场景。先精通六动词。
这六个动词的设计哲学值得品味:它们都是「动词」,每个只做一件事,输入输出都是数据框。简单组合出表达力——这正是 Unix 管道思想在数据分析里的重生。
06
PART
️ 管道符:把动词串成流水线
SECTION
单个动词好用,连起来才叫威力。数据处理很少一步完成,通常是「转长→筛选→造列→排序」一串操作。管道操作符就是把这些操作串成流水线的语法。R 里写作 |>,读起来像「然后」:
1
2
3
4
5
6
# R / tidyverse 风格
long_df <- df |>
pivot_longer(cols = -region, names_to = "crop", values_to = "yield") |>
filter(yield > 400) |>
mutate(yield_ton = yield / 1000) |>
arrange(desc(yield))
读法就是:链式串联——每步的输出自动成为下一步的输入。Python 的 pandas 用方法链调用实现同样效果:
1
2
3
4
5
6
result = (df
.melt(id_vars='region', var_name='crop', value_name='yield')
.query('yield > 400')
.assign(yield_ton=lambda x: x['yield'] / 1000)
.sort_values('yield', ascending=False)
)
对比嵌套写法 sort(assign(query(melt(df)))),管道写法自上而下,和数据流动的方向一致——这就是它成为数据科学标准写法的原因。
顺带一提连接操作:多表合并时最常用三种——left_join 保留左表全部行,inner_join 只留两边都有的行,anti_join 只留左表独有的行;pandas 里对应 merge 的 how 参数。
⚠️ 最容易踩的坑
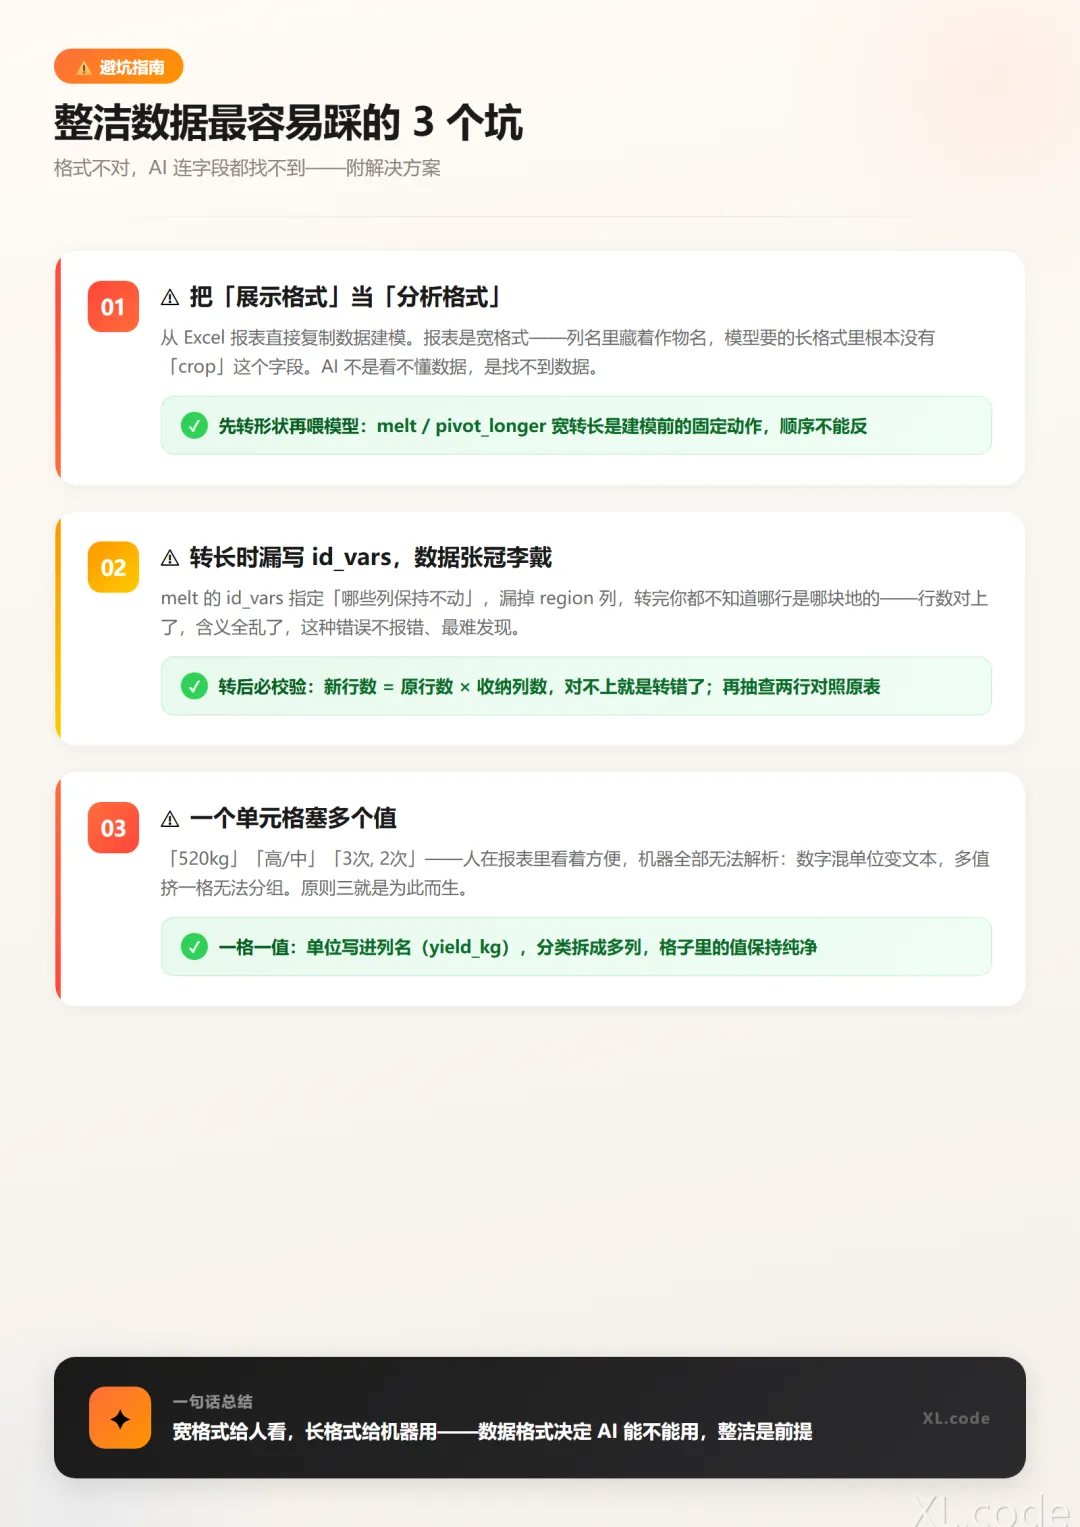
坑1:把「展示格式」当「分析格式」。 最常见:从 Excel 报表直接复制数据建模。报表是宽格式,模型要长格式——先转形状,再喂模型,顺序不能反。
坑2:转长时忘了 id_vars,数据张冠李戴。melt 的 id_vars 指定「哪些列保持不动」,漏写了 region 列,转完你都不知道哪行是哪块地的。转长后第一件事:核对行数,对不上就是转错了。
坑3:一个单元格塞多个值。 「520kg」「高/中」「3次, 2次」这种格子,人在报表里看着方便,机器全部无法解析。原则三就是为此而生:一格一值,单位写进列名,分类拆成多列。
08
PART
你已经学会的技能
SECTION
恭喜,你现在掌握了数据「塑形」的全套功夫:
更重要的是——你理解了格式决定可用性。模型再强,喂不进嘴的数据等于没有。
09
PART
️ 冷知识
TRIVIA
Hadley Wickham 那篇《Tidy Data》论文,2014 年发表在统计学期刊上,如今被引用超过一万次——被引用上万次。
有趣的是,这三条原则并非他凭空发明,而是来自数据库理论的「第三范式」——一个 1971 年就提出的老概念。Wickham 的贡献是把它翻译成数据分析师能懂的语言,并配上 pivot_longer 这样的工具。理论等工具几十年。
这个故事还说明一件事:工具塑造理论。「tidy」这个词现在比「第三范式」流行得多——不是因为理论更好,而是因为 pivot_longer 比 SQL 的规范化语法好学一百倍。
∞
LAST
下期预告
PREVIEW
现在你的数据又干净又整洁,结构完美——但盯着 1000 行数字看,你什么也发现不了。人脑不擅长读数字,擅长读图形:1000 行数据画成一张散点图,规律一秒浮现——这就是数据可视化的力量。
下一期讲怎么把整洁数据变成图:什么时候用散点图、什么时候用柱状图、ggplot 的图层语法为什么被称为「图形语法」。数据整洁是前提,让数据开口说话。
点赞👍 + 在看👁️ + 转发🔗,下期见!
⭐ 星标置顶「XL.code」,下一篇第一时间推到你手机上。
觉得有用?随手点个赞、在看、转发三连吧
THANKS FOR READING

