Pandas 读取超大Excel,openpyxl引擎分sheet读取大工作簿
- 2026-09-22 17:52:44
Pandas 读取超大Excel,openpyxl引擎分sheet读取大工作簿几十万行的Excel文件直接pd.read_excel读取极易内存溢出,openpyxl引擎支持按工作表读取、按需加载,处理大体积xlsx报表避免OOM崩溃。 场景:一份Excel包含多张业务sheet,每张sheet存放一个门店的订单流水,文件体积大,一次性读取全部sheet内存占用高。核心知识点:pd.ExcelFile、openpyxl引擎、sheet_names获取工作表、逐sheet循环读取。 查看数据情况 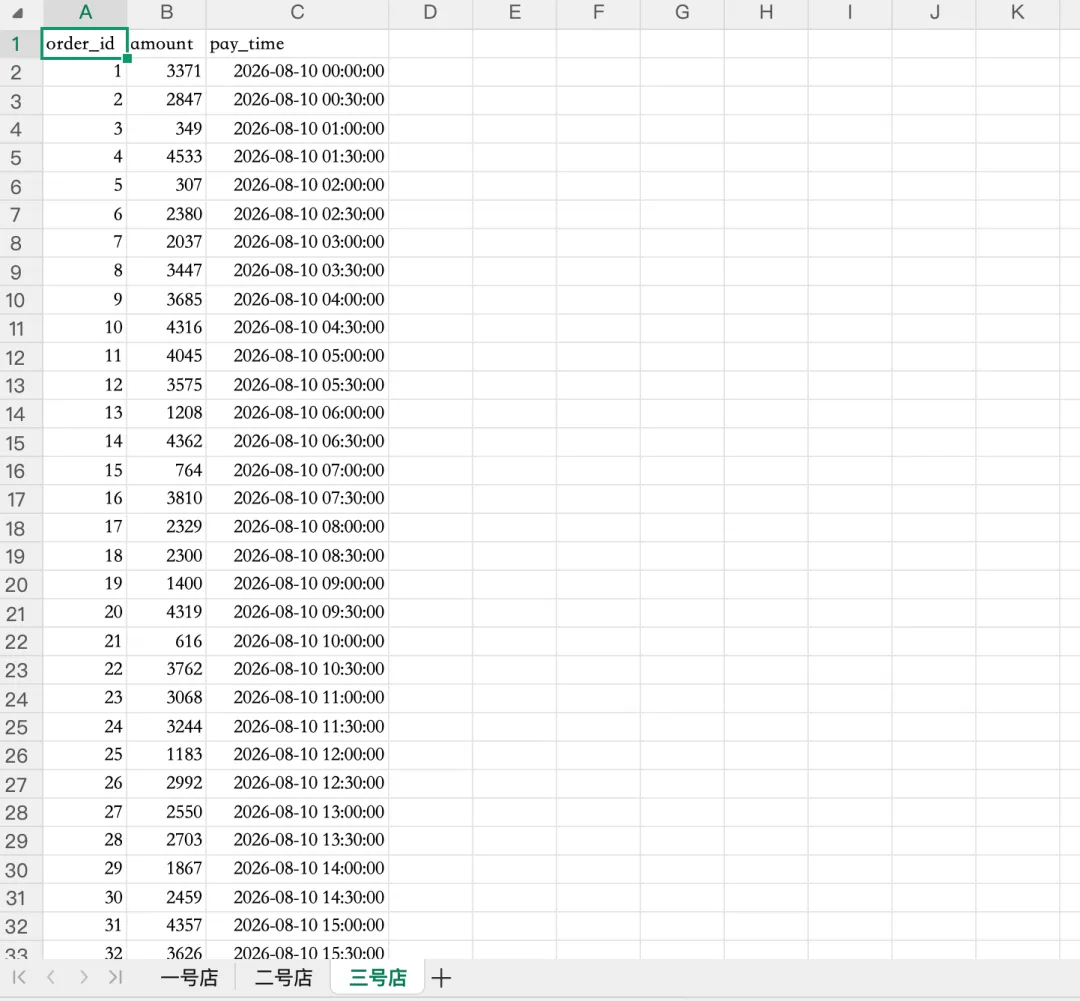
① 生成测试数据
import pandas as pdimport numpy as npnp.random.seed(88)with pd.ExcelWriter("multi_sheet_shop.xlsx",engine="openpyxl") as writer:for shop_name in ["一号店","二号店","三号店"]:df_tmp = pd.DataFrame({"order_id":range(1,61),"amount":np.random.randint(100,5000,60),"pay_time":pd.date_range("2026-08-10",periods=60,freq="30min")})df_tmp.to_excel(writer,sheet_name=shop_name,index=False)print("多sheet大Excel测试文件生成完成")
② 核心代码
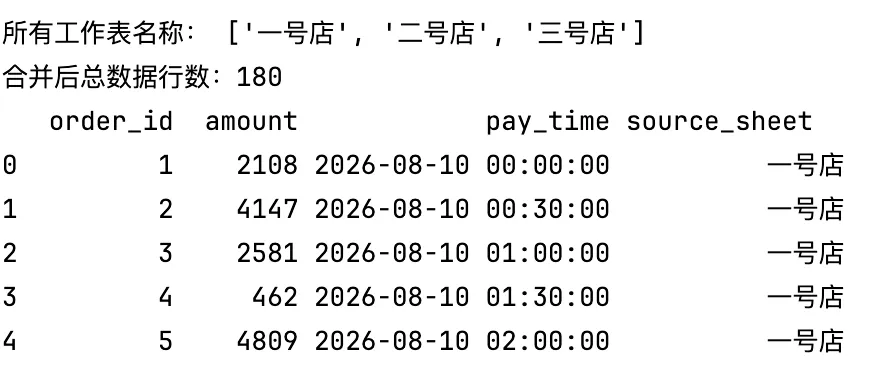
import pandas as pd# 使用ExcelFile打开文件,不会立刻读取全部内容excel_file = pd.ExcelFile("multi_sheet_shop.xlsx",engine="openpyxl")print("所有工作表名称:",excel_file.sheet_names)all_result = []# 循环逐个sheet读取for sheet in excel_file.sheet_names:df_sheet = pd.read_excel(excel_file,sheet_name=sheet)df_sheet["source_sheet"] = sheetall_result.append(df_sheet)df_final = pd.concat(all_result)print(f"合并后总数据行数:{len(df_final)}")print(df_final.head())
结果展示
总结
使用pd.ExcelFile可以延迟加载,适合多sheet大Excel;优先openpyxl处理xlsx文件;不要一次性read_excel读取全部sheet;读取完成后及时释放文件句柄,防止文件被占用。
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

