AI清洗Excel到底行不行?我把4个工具挨个考了一遍
- 2026-09-22 08:41:09
上周拜访一家老客户做AI落地的前期调研。对方信息化负责人颇为得意,现场向我演示:将一份8000余行的销售汇总表拖入对话框,输入寥寥数语,数秒之内,重复记录消失、金额列被统一为数值、缺失字段亦被补全。他随即反问我:这类脏活,往后是否无需专人处理?
我未置可否。并非刻意扫兴,而是此类场景见得太多。我在IT领域从业20年,从研发、售前、咨询、解决方案到部门负责人,如今主要协助企业落地AI能力。过去十余年与数据缠斗的经验,远多于写下的代码——系统上线、流程跑通之后,瓶颈往往卡在口径不一、主数据失序。因此每当见到AI自动清洗的演示,我的第一反应不是惊艳,而是追问:它依据何种规则完成清洗?
回到办公室,我并未采用客户的原始表,而是自建了一份样本。其中缘由在于,真实业务表的缺陷深嵌于业务语境,反而难以剥离讲清。我按几类典型病症拼出这份样张:同一客户因录入时多敲一个空格、或采用简称,被拆作三条;金额列混杂约12万、暂估之类非标表述;日期格式参差,兼有无值空行;最棘手的是区域一列,华东、华东、East China并存。
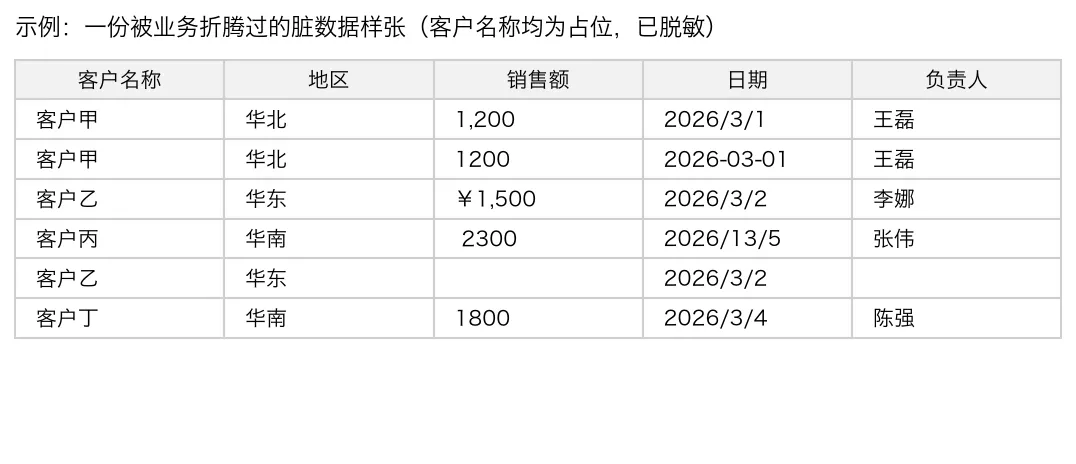
随后我将同一份样张分别投入四款企业使用频次最高的AI工具,逐项实测。评判标准只有一个:产出的结果,财务能否直接采信。
豆包与通义千问响应极快,指令门槛也低。上传文件、下达清洗指令,去重、补空、格式归一接连完成,成品观感颇为工整。问题恰恰出在工整二字。豆包将客户甲与客户甲(中间多一空格)判为两家,未能合并;反之,又将两家实际不同的客户,因名称局部重合而归并为一。通义稍佳,却在填补缺失金额时,径直以同区域均值写入——这一数值若进入对账环节,后果堪忧。二者共同的软肋在于:默认你给出的指令已足够,从不主动确认业务规则。去重以何字段为准、口径归属何人、何为异常,皆由模型自行决断。你不问,它便不说。
WorkBuddy与DuMate则走向另一条路径。同样上传、同样指令,它们并不急于动手,而是先反问:重复判定的主键字段是哪一类?客户甲与客户甲是否视作同一实体?区域列是否需统一为中文?DuMate更进一步,将每一条拟执行的变更列作清单供确认,并附变更依据。待我逐项认可,方才落笔。成品我仍抽取二十行复核,大体无误。
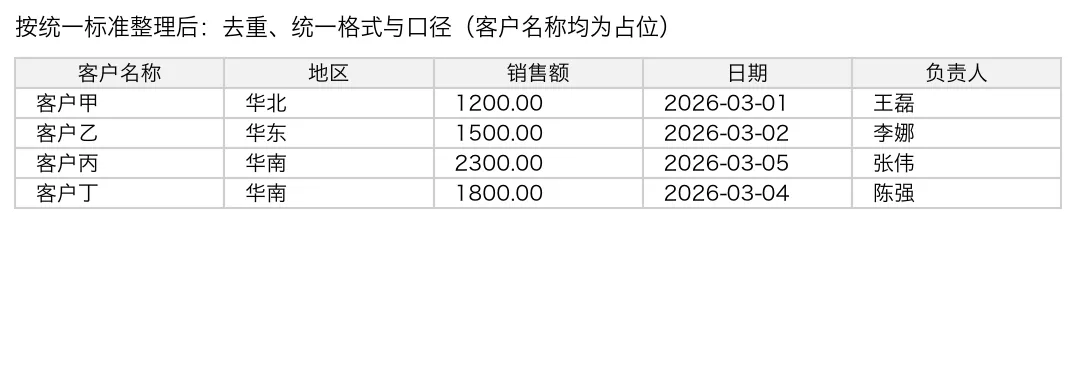
公允地说,前两者并非不可用,只是须有人在旁把关,适用于规则明确、容错率高的场景;后两者更接近于资深财务先问清再动手的做派,方具备进入生产的条件。二者差异的根源,在于产品设计取向:前者服务个人效率,以看起来完成为优;后者嵌入企业流程,以可追溯、可复核为纲。
然而我真正想指出的,并非工具优劣。当日客户以为解决的是洗表问题,实则不然。表为何而乱?录入口径无人界定,业务人员图省事随意填写,主数据根本无人治理。这些症结AI无力解决,它只是在你投喂的那张已然失序的表上,再做一层加工。
我曾亲历一家企业,斥资搭建AI中台,模型输出的经营分析结论却大面积谬误。排查半年方才定位:根因不在模型,而在底层客户主数据本身便存在三成误差。项目被迫回退,转而先行梳理数据标准。
故此,对一切意欲以AI提效的企业,我愿直言一句:莫急于让模型替代人力。请先将何为一条客户、金额如何计量、区域归属何方这些最朴素的命题界定清楚,再令工具进场。地基未固,AI不过将你二十年累积的紊乱,收拾得更为体面,却也错得更为隐秘。
---------------
本文无意推介任何产品。四款工具,包括其失当之处,皆已如实陈述。
若你亦在推演企业AI落地,困于数据与流程这一关,欢迎关注数智老 兵回复「落地」,我将整理主数据与口径治理的那套清单奉上。

