神经网络学习笔记(五):从 GNN 到 GAT——图神经网络与自注意力机制的数学原理
- 2026-11-07 02:46:31
神经网络学习笔记(五):从 GNN 到 GAT——图神经网络与自注意力机制的数学原理参考视频(部分图片来源): 1. GNN基础知识 1)基本概念 特征:用于描述节点属性的数据。每个节点通常对应一个特征向量,其中包含多个特征值。例如,在空间转录组数据中,可以使用每个 spot 的基因表达量作为节点特征。假设有 5 个 spots ,每个spot有 4 个蛋白质的表达量,则特征矩阵 X 的维度为 5*4。 节点:图中的1、2、3、4、5分别为对应的5个节点,在空间组学中通常为每一个 spot 划分为一个节点 邻接矩阵: 用来表示有哪些点是相关联的。对于无权图来说,构建一个“节点数*节点数”的0矩阵,如果两个节点之间有联系,就标注为1。对于加权图,矩阵元素也可以表示边的权重。无向图的邻接矩阵通常是对称的,而对角线元素是否为 1 取决于是否添加自环。 右图为根据节点的特征构建的特征矩阵。 2)特征线性变换 首先进行特征线性变换。通过设置隐藏维度,确定节点经过变换后的特征数量。例如,当前图中有 5 个节点,每个节点具有 4 个原始特征。我们期望经过特征变换后,每个节点得到一个 8 维的特征向量,因此将隐藏维度设置为 8。由于输入特征维度为 4,输出特征维度为 8,因此可以构建一个 4 * 8 的可学习权重矩阵W: 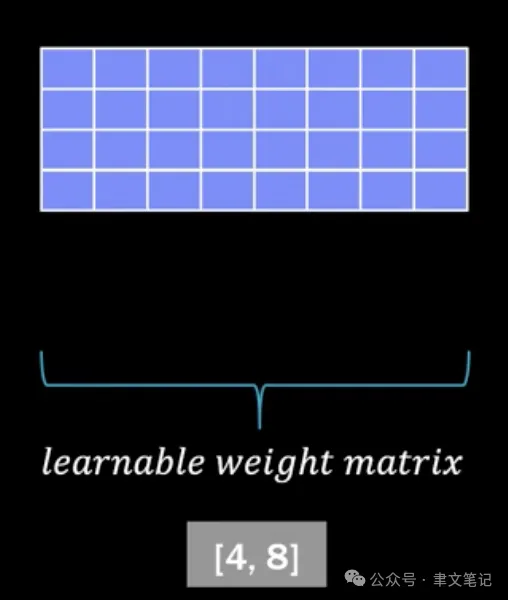
将特征矩阵和权重相乘之后,可以得到5*8(5是节点数,8是隐藏维度)embedding矩阵如下: 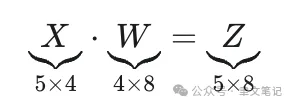
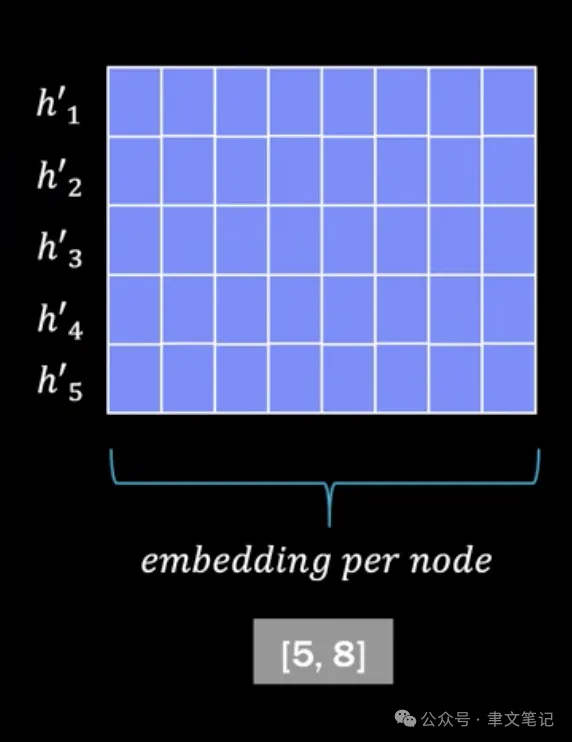
完整的步骤可以归纳为,在简单的 GNN 信息聚合模型中,可以使用 H'=sigma(AXW)表示节点特征更新过程。邻接矩阵决定哪些邻居参与信息聚合,权重矩阵负责特征变换,激活函数引入非线性。步骤展示如下: 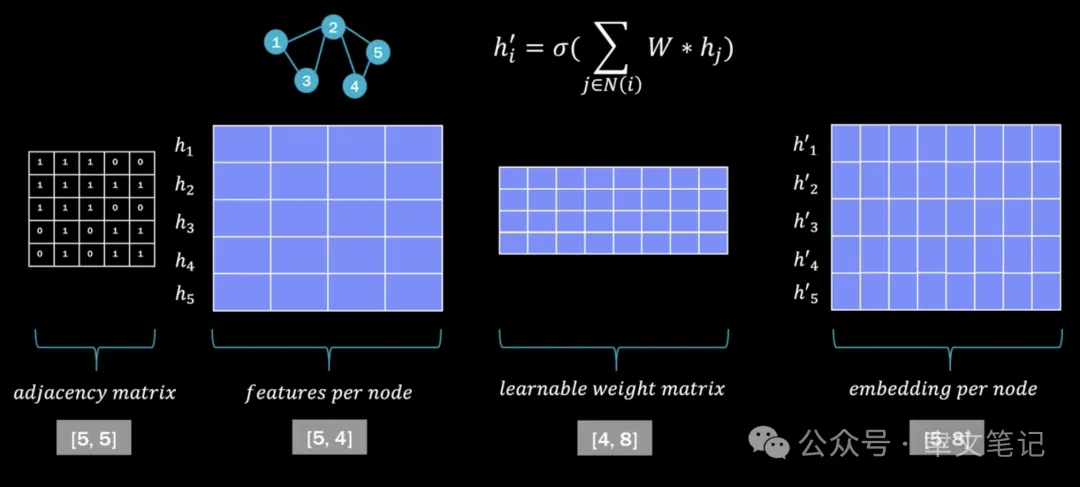
把其中每个步骤得到的结果记录为: 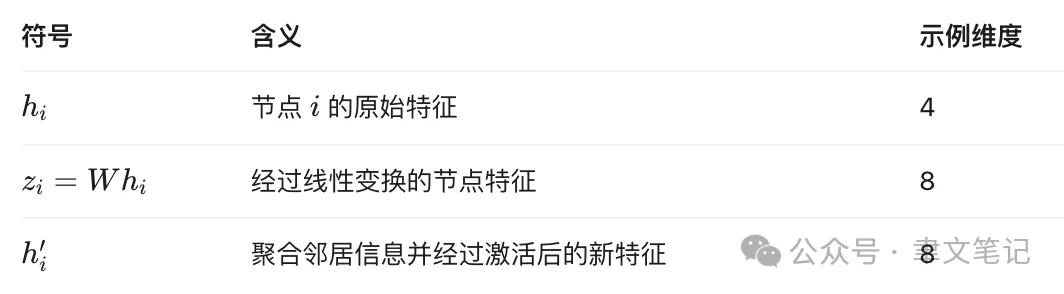
但要注意的是,直接使用邻接矩阵求和可能使高度数节点的聚合结果数值较大,因此标准 GCN 通常使用归一化邻接矩阵进行信息传播。 2. 自注意力机制 1)计算自注意力权重和归一化 自注意力基机制常用于大语言模型中。例如对于以下这个案例,要衡量哪个词语和'play'的关系越大,从直觉上来判断children和play关联度会the和play的关联度更高。 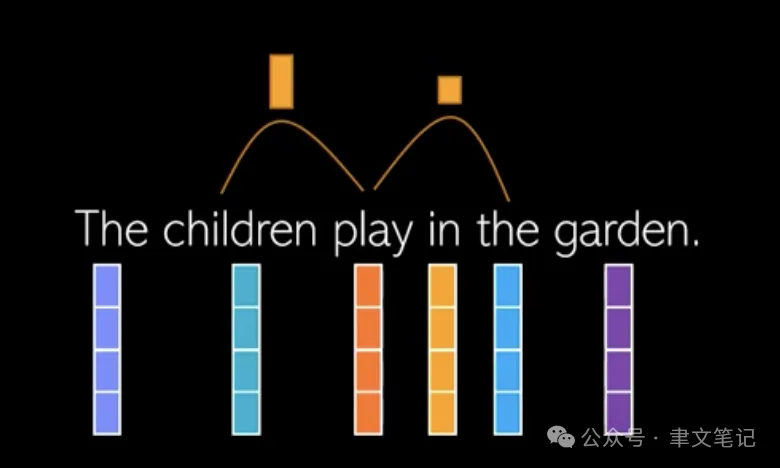
我们的目的就是衡量哪个节点在进入embedding时更应该被关注。与前面介绍的简单 GNN 不同,与前面介绍的直接对邻居特征进行求和的简单 GNN 模型不同,GAT 引入了可学习的注意力机制,使模型能够根据目标节点与邻居节点的特征,自适应地计算不同邻居的注意力权重,而不再仅依赖固定的邻接关系或预设的聚合权重。可以用函数概括为: 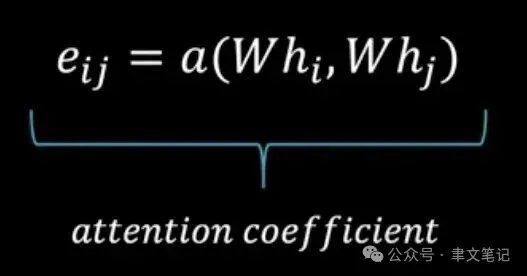
每个参数的含义为: 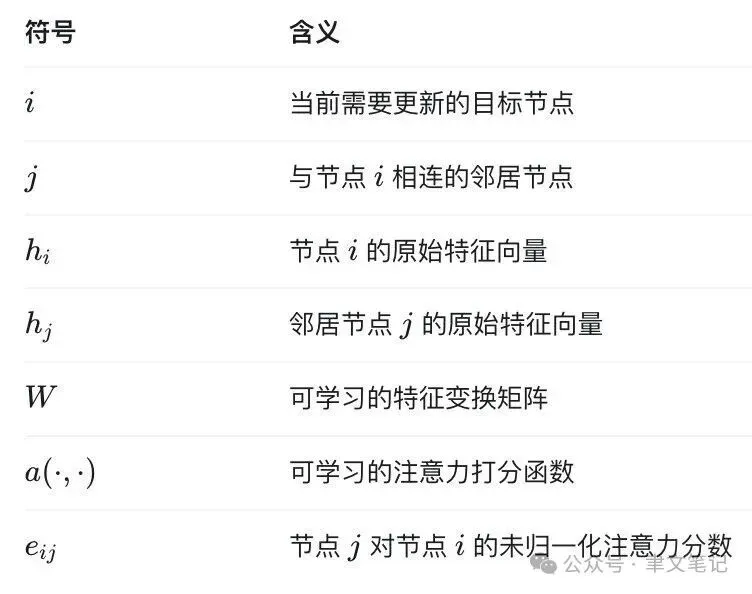
常用的经典GAT打分函数如下,在GAT论文中也同样使用了以下这个公式: 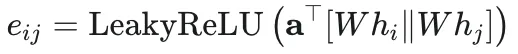
注意:在经典 GAT 中,需要区分注意力打分函数 a(·,·)和可学习注意力参数向量 a。前者表示根据两个节点特征计算注意力分数的函数,后者是该函数内部使用的可学习参数。与特征变换矩阵 W 一样,参数向量 a 也会在训练过程中通过反向传播进行更新。W 负责将原始节点特征映射到新的特征空间,而 aT 负责参与计算两个节点之间的注意力分数。在刚才的案例中,a应该为1*16的矩阵: 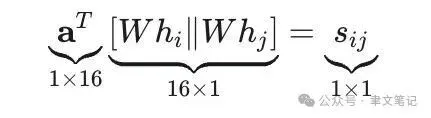
其中 || 表示向量拼接,不是求和也不是矩阵乘法。 但如果直接进行计算会出现一个问题,例如以下这个图: 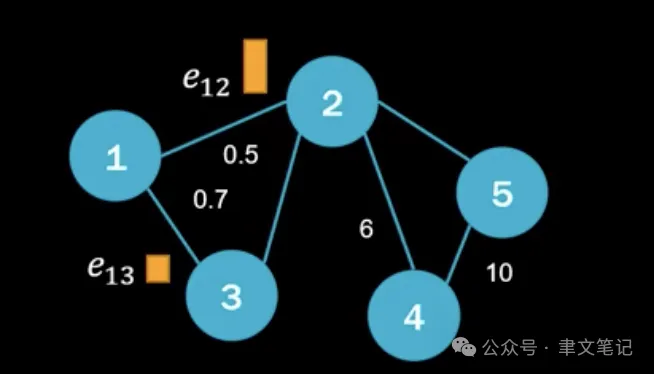
注意力打分函数得到的是未归一化的注意力分数,不同邻居对应的分数尚不能直接作为加权聚合的相对权重。因此,需要使用 Softmax 函数,对同一个目标节点的所有候选邻居的注意力分数进行归一化,使其转化为非负且总和为 1 的权重,从而衡量各个邻居在当前节点信息聚合过程中的相对重要程度。在GAT中使用的softmax公式如下: 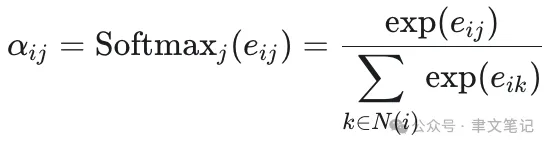
每一个值的意义为: 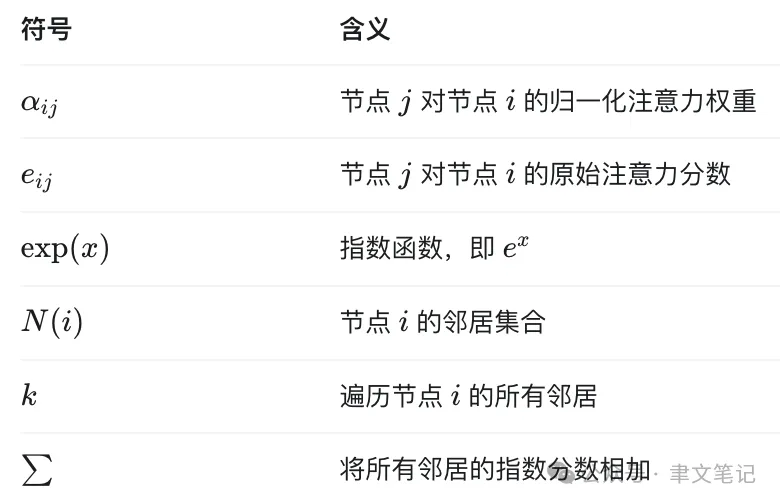
例如对于以下的情况(暂不考虑自环): 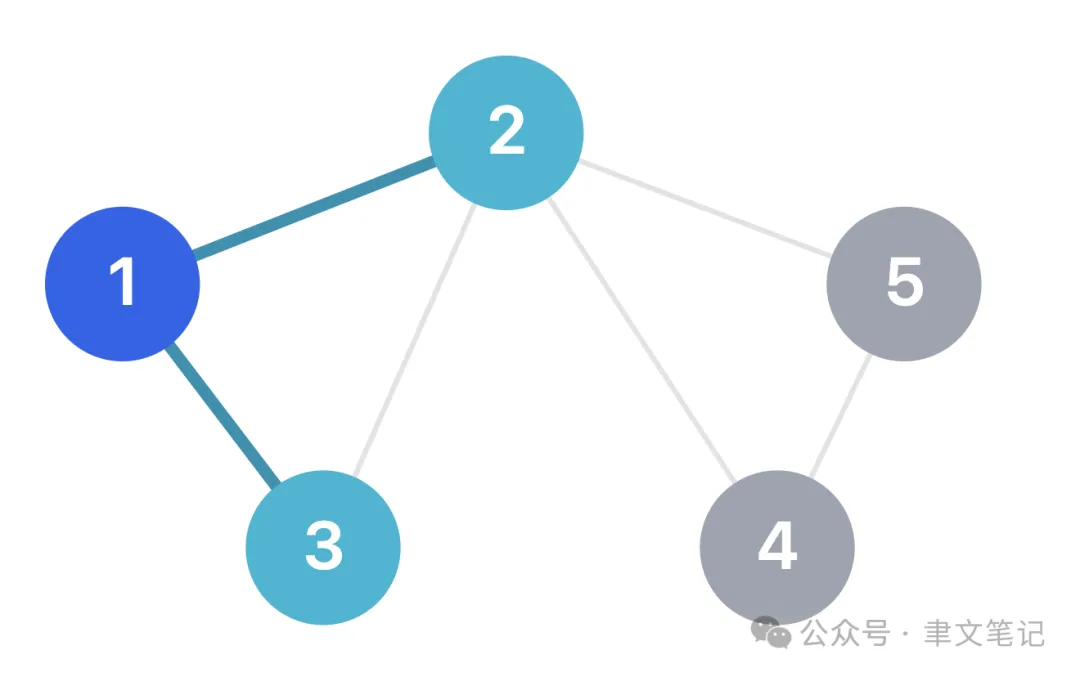
假设注意力打分函数计算得到: 那么进行归一化: 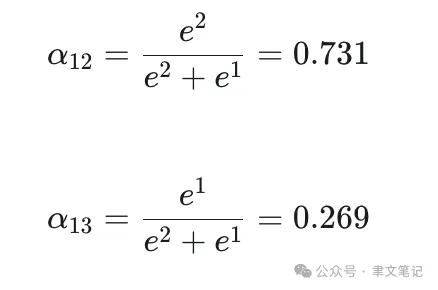
用完整的数学公式表示为: 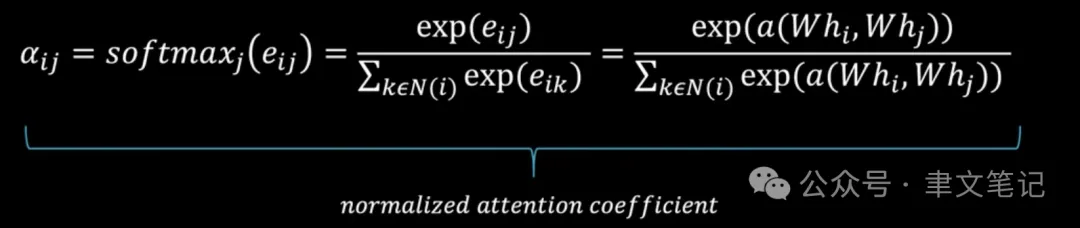
经过 Softmax 归一化后,同一个目标节点对应的所有邻居注意力权重之和为 1。GAT 使用掩码注意力机制,掩码顾名思义,会用来限制哪些节点能够参与注意力计算。根据图的邻接关系限制注意力计算范围,使目标节点只关注与其存在连接关系的节点(通常也包括自身)。在此基础上,Softmax 将这些节点的注意力分数转换为归一化权重,从而实现邻居信息的加权聚合。 引入自注意力函数并进行归一化GAT模型的关键创新点。对比传统GNN模型,GAT模型则是在数据特征值进入激活函数之前,引入了可学习的注意力机制,根据目标节点与邻居节点的特征计算不同的注意力权重。在进行邻居信息聚合时,方便理解可认为,注意力权重较大的节点通常具有更大的直接贡献,而权重较小的节点贡献相对较小。通过节点特征学习邻居之间的相对权重,使不同邻居在特征聚合过程中产生不同程度的贡献。但节点最终对聚合结果的实际贡献,还取决于其变换后的特征值。 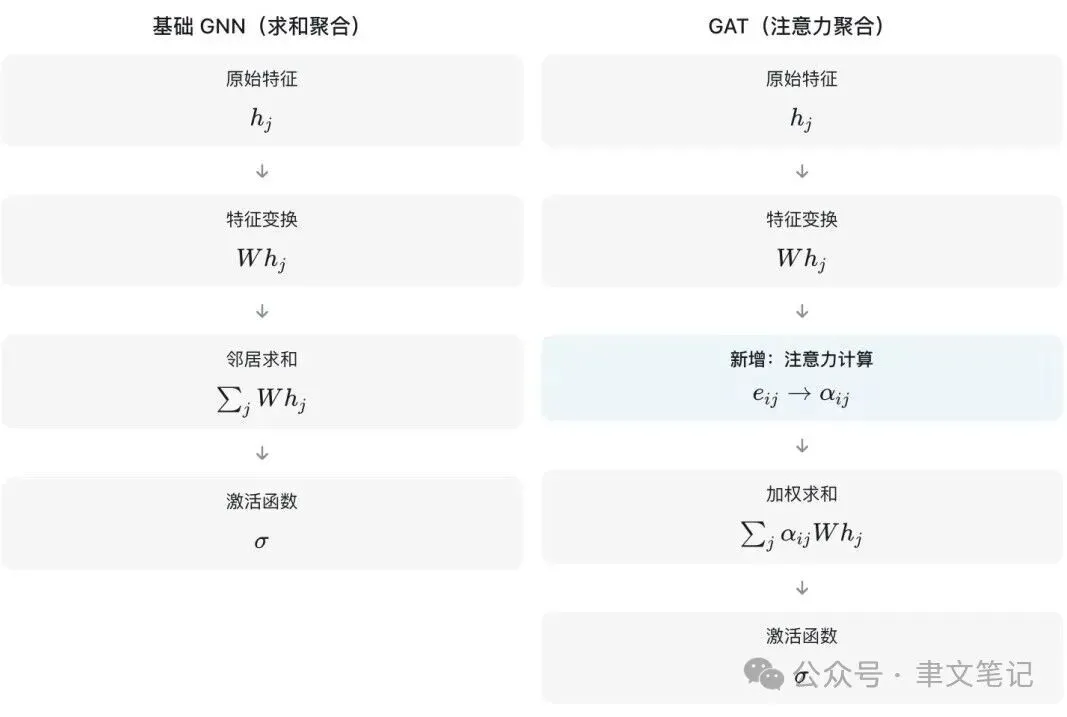
可视化流程图如下: 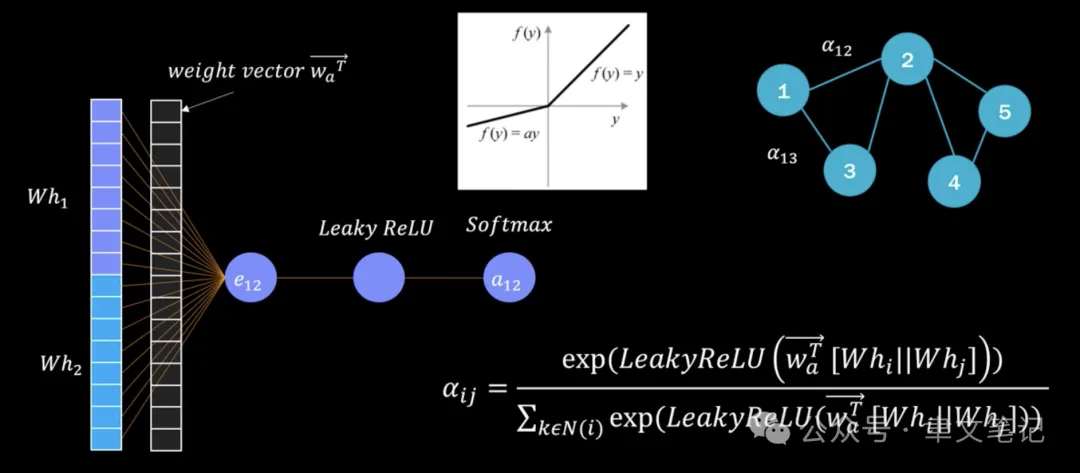
2)节点特征更新 完整的下一层节点的激活函数就可以被表示为: 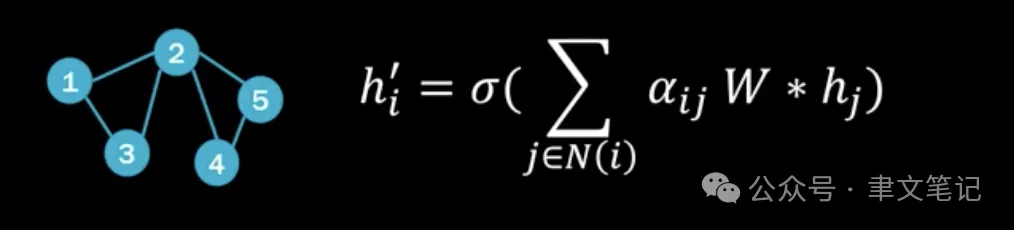
其中,N(i)表示参与节点 i 信息聚合的邻居集合。在常见的 GAT 实现中,通常会添加自环,使目标节点自身的特征也参与注意力计算和信息聚合。 在经典的单头 GAT 中,特征聚合分支和注意力计算分支共享同一个可学习的特征变换矩阵 W。和GNN类似,W是可学习的特征变换矩阵,用于将原始节点特征映射到新的特征空间。但注意力分支在变换后的特征基础上,还使用独立的可学习参数向量 a来计算注意力分数。因此,W负责特征变换,而 a 负责注意力打分,两者共同参与训练: 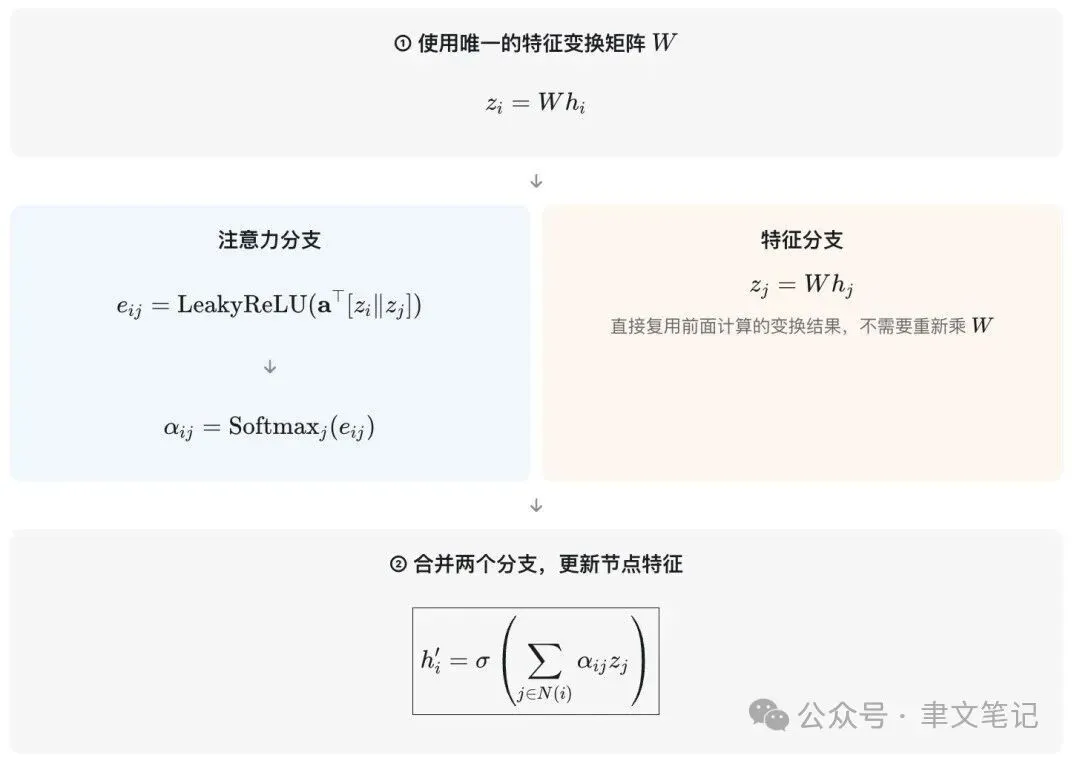
要注意:在经典单头 GAT 中,注意力计算分支和特征聚合分支共享同一个特征变换矩阵 W。最终完整的节点值计算就可以表示成: 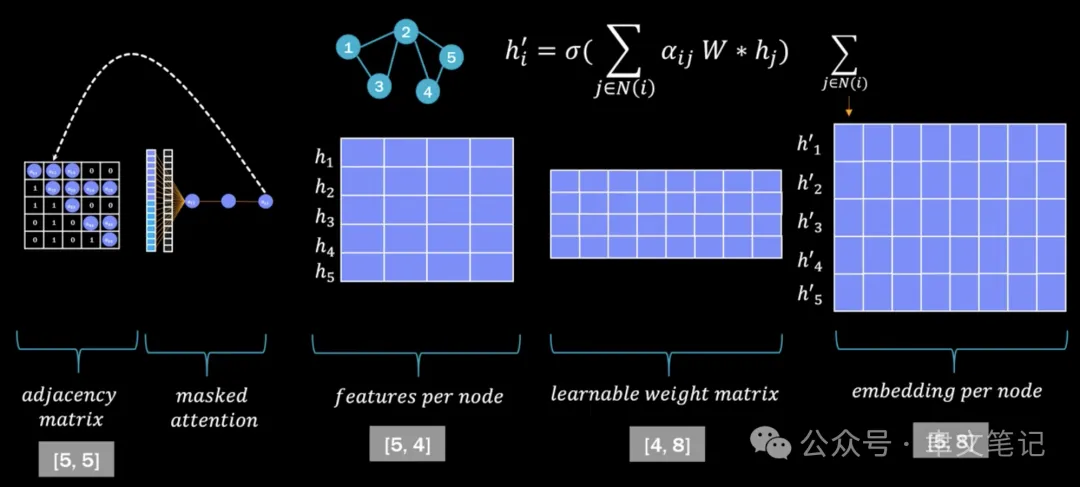
在实际的 GAT 模型中,通常还会使用多头注意力机制。多头注意力通过多个独立的注意力头,并行学习不同的特征变换和注意力分配方式,使模型能够从多个表示子空间提取邻居信息。不同注意力头的结果可以通过拼接或平均等方式进行融合,以增强模型的表达能力和训练稳定性。 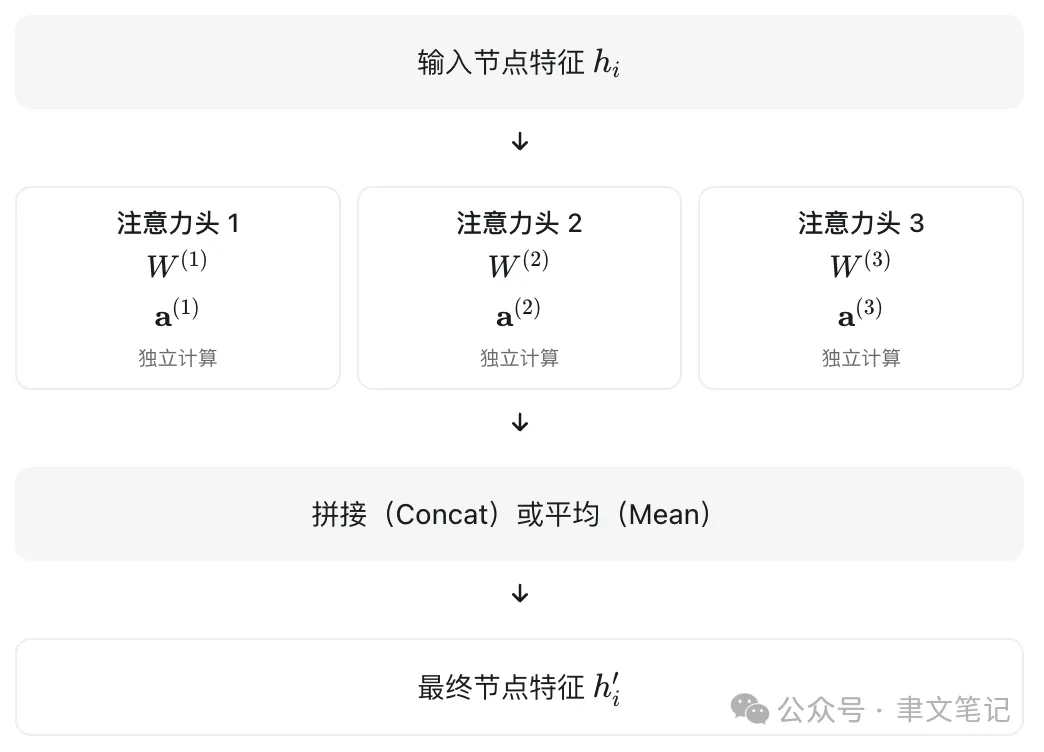
符号表一览:
https://youtu.be/eMlx5fFNoYc?si=FmEHrDOV7h2_dWR3
e_{12}=2, e_{13}=1
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

