DeepInfer 学习笔记02:Prefill 和 Decode
- 2026-11-05 08:27:07
上一篇,我们梳理了 DeepInfer 里一次 Inference 的基本过程。这次重点看 Prefill 和 Decode:模型怎样读完输入,又怎样接着生成回答。
实际上,在 Prefill 这一步之前,提示词(Prompt)会先经过分词(Tokenize),转换成词元(Token),然后给每个 Token 有一个对应的整形编号,就可以把一段提示词转换成一个整形的数组(或者称之为向量了)了。这个过程比较好理解,我就不另外展开了。
我们用一个小例子贯穿全文:输入是 A、B、C,模型接下来生成 x、y、z。
Prefill
Prefill 可以粗略地理解为:模型把整段提示词读一遍,留下后面能复用的计算结果,并生成回答的第一个 Token。
在我们的例子里,A、B、C 已经全部确定,可以一起送进模型。模型由许多计算层串联而成,数据逐层经过计算,最后用于预测下一个 Token。
这种逐层计算的基本结构,来自论文《Attention Is All You Need》提出的 Transformer。我们这里可以简单地先把它当成一个很多层的神经网络。经过一个很长的计算过程后,会产生这段输入提示词对应的下一个输出 Token。注意,这里经过了很多的计算,但是只输出了一个 Token!
计算过程中,模型会把后续需要复用的中间结果写入 KV Cache。可以暂时把它理解成阅读时留下的数值笔记:后面续写时,能拿这些结果接着算,省去对前面内容的重复计算。
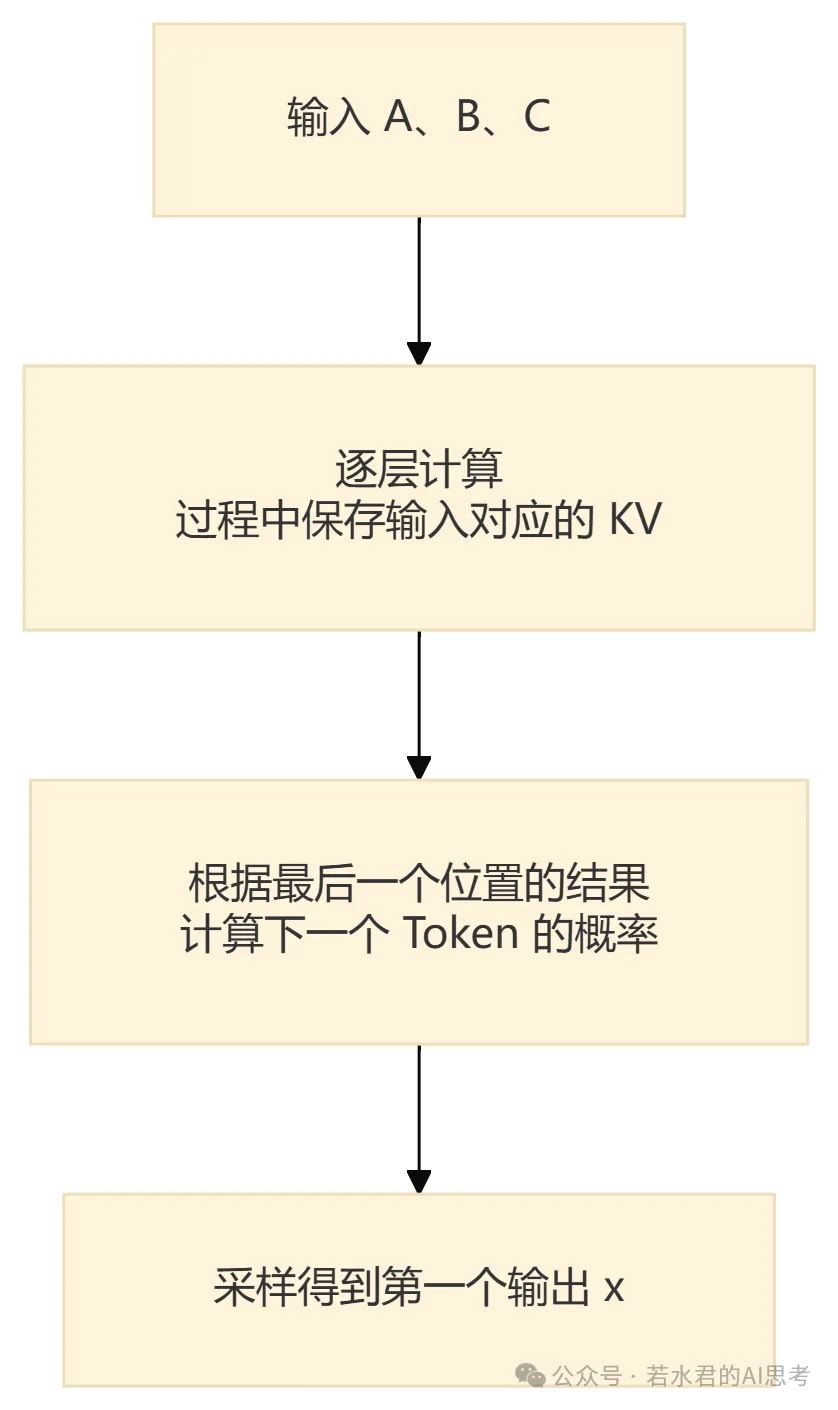
Prefill 结束时,我们得到两样东西:输入 A、B、C 对应的 KV,以及第一个输出 Token x。这时 x 刚刚被选出来,还没有作为输入走过模型。接下来的 Decode 会处理它。
DeepInfer 还提到了很多的技术细节,例如长提示词可以拆成多个 chunk,分几轮完成 Prefill。但是这些细节我们暂时就略过了,先简单认为,输入提示词可以一次性被处理完。
从用户侧看,Prefill 过程的延迟直接对应zh了 TTFT(Time To First Token),即从发出请求到收到第一个 Token 的时间。
Decode
第一个 Token x 出来之后,模型进入 Decode 阶段,继续使用同一个模型往下写。
第一轮把 x 送进模型,逐层计算时读取前面保存的 KV,并写入 x 对应的 KV。完成计算后,模型选出下一个 Token y。第二轮再输入 y,补上 y 的 KV,选出 z,如此继续。
注意这里的交接:一轮里新写入的 KV 属于这一轮的输入 Token。刚生成的输出 Token,要在下一轮作为输入时,才形成自己的 KV。前面的输入已经留下了可复用的结果,因此每轮只需加入最新的 Token,同时读取所需的历史 KV。
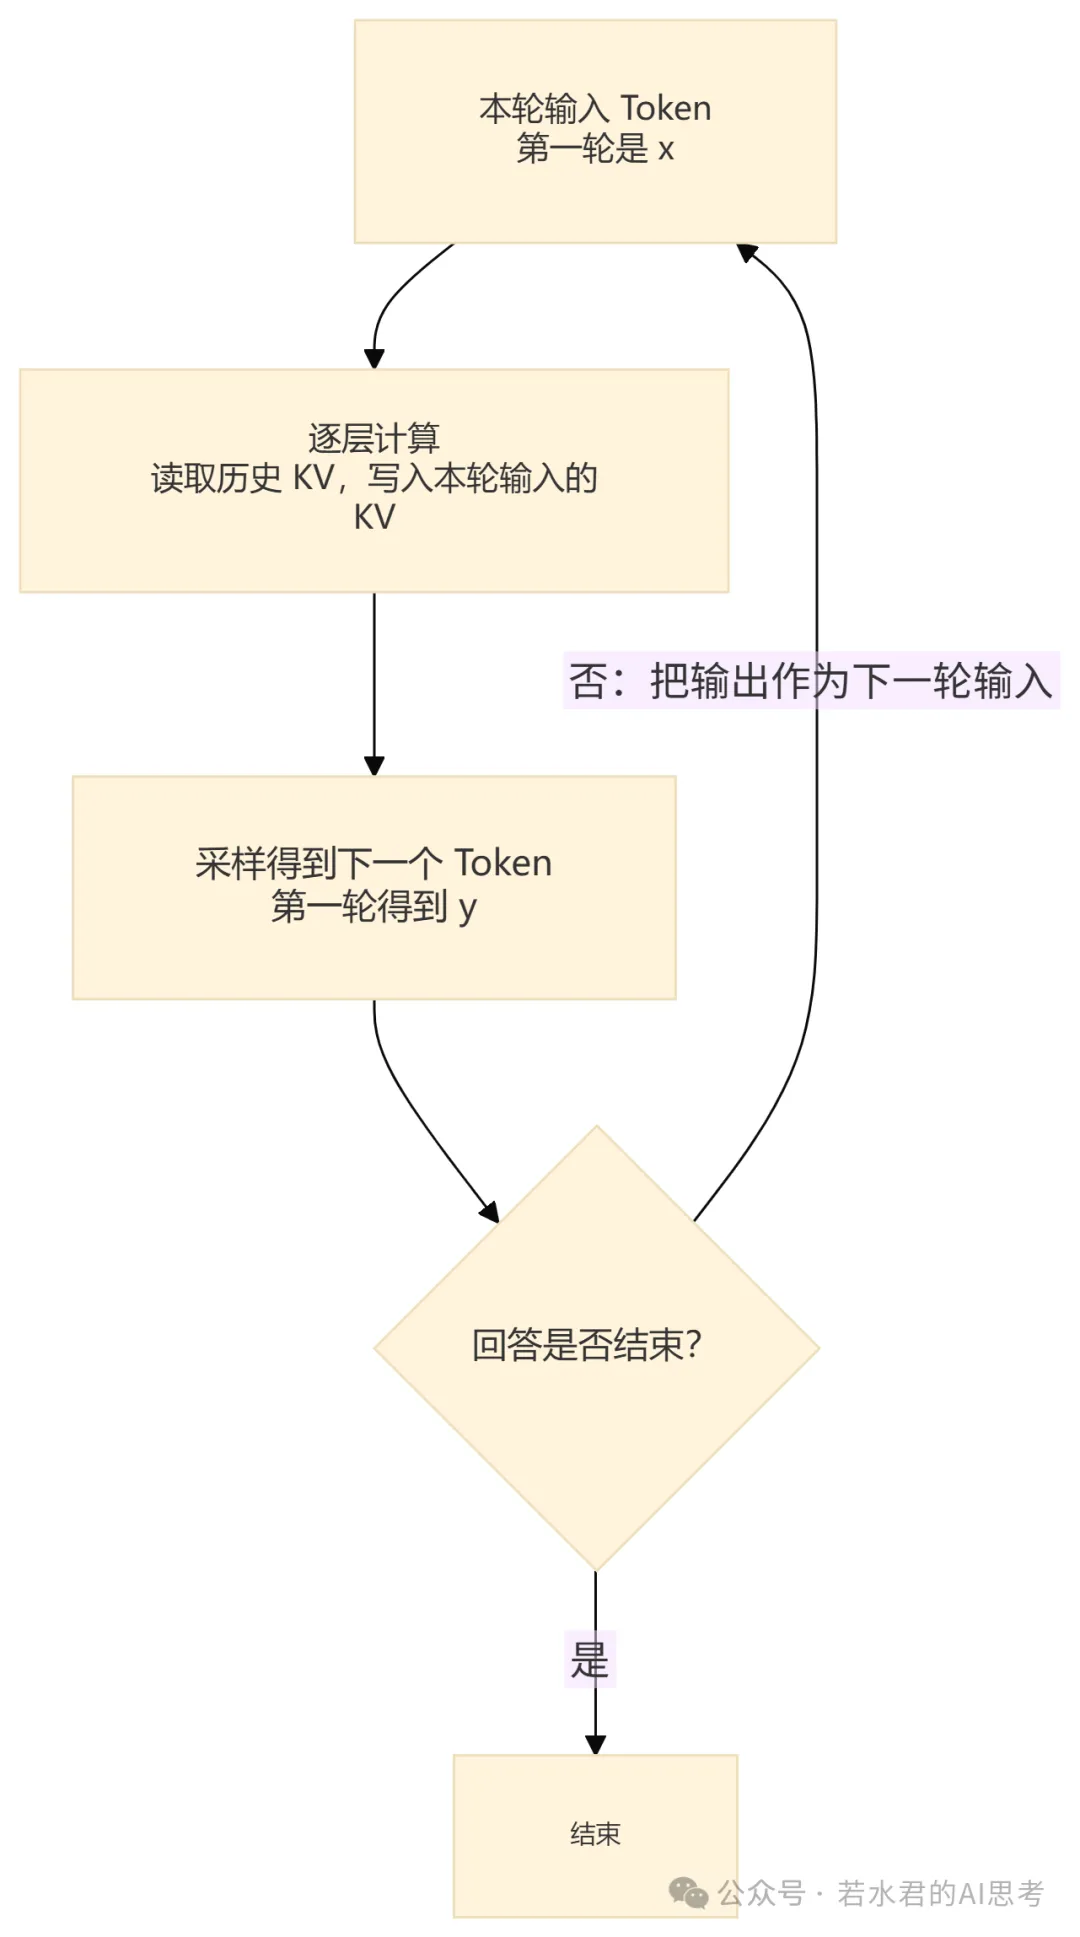
对照 Prefill 就能看出差别:输入 A、B、C 一开始就已知,输出 x、y、z 则需要逐步确定。基础 Decode 流程必须先选出 x,才能把它送进下一轮去算 y。实际引擎还会用投机解码,先提出多个候选再验证,减少主模型的计算轮数;这篇同样先不展开。
理解了这两个过程,有什么用
第一个角度是控制输出量,这会直接影响我们怎样设计 Agent。
假设要修复一个 bug,我们把一个 800 行的文件和问题描述一起交给模型。可以让它返回完整的修复后文件,也可以让它只返回某个函数中需要替换的几行。两种方式提供的文件内容相同,Prefill 工作量接近,但是 Decode 的工作量则差了很多。
完整返回文件,会把大量没有变化的代码重新生成一遍,大大增加 Decode 的轮次。只返回必要的修改,再由工具应用到原文件,通常能明显减少生成时间;而且输出 Token 往往比较贵,节省输出 Token 可以大大节省开销。
因此,Agent harness,在发出请求前就值得想清楚:这一步需要模型读什么,下一步的工具需要接收什么结果,尽可能减少输出的内容。
第二个角度是,两种工作负载会影响推理服务的部署方式。
我们前面分析过,Prefill 一轮处理所有的输入 Token,整个过程只需要加载一次模型权重到显存,然后就是大量的计算。而 Decode 则相反,每轮都要读取权重和所需的 KV,然后只能推进少量 Token,因此整个过程显存的 IO 是很大的。
这让 Prefill / Decode 分离部署有了意义:让不同的 GPU 实例分别负责读输入和续写,并把 Prefill 产出的 KV 交给 Decode 侧。这样可以分别配置资源、组织批次,独立优化首 Token 的等待和后续生成间隔;同时也要承担 KV 传输和跨实例协调的开销。
DeepInfer 的官方部署文档专门解释了这套分工。完整的跨实例协作代码没有全部开源,我们后续会结合文档和代码,用单独一篇笔记继续看这个过程。
下一篇,我们将拆解 KV Cache 到底干了点什么事情。另外,今天我们提到的注意力和 Prefill / Decode 分离部署,我也都会在后续分别学习并记录笔记。

