企业级AI落地:从Excel到数据库的避坑实录
- 2026-11-09 04:37:38
做石材采购有些年头了。电脑里存得最多的,就是供应商发来的各种 Excel、里面塞了各种石材名字、矿口产地、大板价、成活价、项目案例,还有排版图。
当文件足够多,清文件会成为很棘手的事情
但如果领导随口问一句:“某块石材现在哪家能供?大板多少钱?成活多少钱?有没有做过的项目?”
不好意思,真记不住。一年采购十几个品类,怎么可能记得住?
这时候,我一般就连开四五个几十MB的表格,一个一个检索。名字五花八门。同一款材料,这家叫古驰黑,那家叫古奇黑。图片全是小缩略图,死死嵌在单元格里,拉大看也是糊的。有些表格更随性,同一款石材,室内地面和外墙干挂混在一行报;还有把两三个工地的实景图塞进同一个格子里。
这活干得实在太累,还憋屈,好像记不住,就没认真干活似的。
之前我试过用 AI 识别照片去数石材,现场数板确实快了不少(样品选型堆成山?怎么用AI统计选型结果)。但那是解决单张图。要想团队不用每次都跑来问我,最好的办法,是把这几十份表格做成一个大家掏出手机就能查的在线工具。
很多人觉得,让AI写个工具,大概就是把文件扔过去,它啪的一下吐出一个好看的网页。
真动起手来才知道,如果一上来就想着做网页,后面全是灾难。AI会漏掉绝大部分嵌在单元格里的图片,会自作聪明把名字像的天然石材乱合一气,还会把去年的过期报价和昨天的最新报价混在一起。
要想做出能用的东西,第一步是先耐下心来,打好基础,把这堆乱七八糟的表格,洗成规规矩矩的数据库。
01 / 先立规矩,不准动我的原文件
开始干活前,我先给Codex定了三条死规矩:
规矩一:原始Excel绝对只读。不准覆盖,不准修改,不准另存。规矩二:每次往数据库写入之前,必须先出试算报告(Dry-run)。处理了多少条、漏了什么、哪里有冲突,我看过确认了,才准写。规矩三:只能用测试库,严禁碰正式环境,任何密码密钥不准进代码。
规矩定好,再定要干什么。第一版只给内部几个人用,场景比较具体:
电脑能查,手机能查(屏幕大概按 393×852 物理视口考虑); 能搜名字和别名; 能看实物图和项目案例; 能看每家供应商分别报的大板价和成活价; 别的下单、审批流程,一概不做。
范围缩到这么窄,事情就清楚了。
这时候可以用Codex或者Antigravity的plan模式,先基于这个规矩把整个项目做个规划,让你心里对整个项目会走向什么方向有个数。
02 / 盘盘家底,果然有怪事
让 AI 动手前,我让它把手头的源文件先摸一遍。
指令发过去:
请只读检查当前仓库和原始资料目录。输出以下清单:1. 本地 Node.js、Python 及包管理器的版本与可用性;2. 目录下所有源文件的文件名、扩展名、修改时间与 SHA-256 文件哈希;3. 检查各工作簿的 Sheet 名称、字段分布、有效业务行范围及图片存储机制;4. 标出跨文件重复的供应商文件、格式异常的 Sheet 以及存在单元格合并的区域。禁止修改源文件,不要在日志中输出敏感路径。
摸排结果一出来,就发现几个坑:
供应商经常更新报价,发来《最新报价2026.xlsx》,过两天又发来《最新报价2026_修改.xlsx》。后来AI通过文件的SHA-256哈希值,直接排除了4份名字不同、内容其实一模一样的重复表格。
还有表格里的空行。有的供应商习惯在第15行留个空行,纯粹为了打印好看。如果写普通脚本,一碰到空行就以为读完了,后面16行往后的上百种石材直接就被丢了。
最麻烦的是图片。只有三成多是普通的浮动图片。剩下六成多,全嵌在单元格里。
03 / WPS的图片,藏得真深
石材这行,没图根本没法谈。
但我用常规Python脚本去读表格时,石材名字和价格都出来了,图片那一列全空着。或者只有一串代码:=DISPIMG("ID_xxxx", 1)。
这就很头疼了。
WPS根本没把这种单元格图片当普通插图存。它的图片藏在底层结构里。.xlsx文件拆开来,其实是个压缩包。要把图抓出来,得先知道这张图对应哪一行石材,得顺着它的内部链路走:
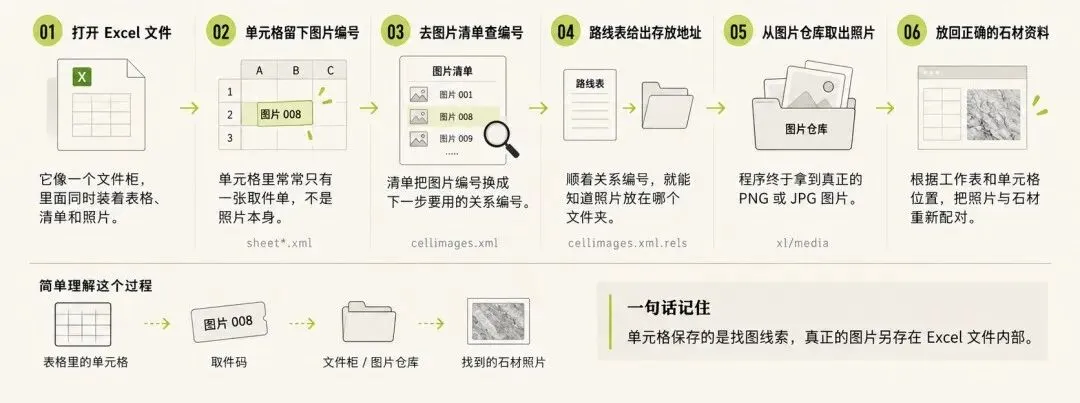
WPS 单元格图片底层 XML 结构关系与解析链路示意图
如果不管这套关系,只把压缩包里的图片解压出来,你手里就只有几千张乱七八糟的 image1.png、image2.png,谁知道哪张图是哪款石头。
我让 Codex绕过高层库,直接基于底层XML写了解析脚本:
请建立可重复运行的只读 XLSX ZIP/XML 导入器,解决 WPS 单元格嵌入图片与标准 Drawing 图片的提取问题。要求:1. 解包 .xlsx,定位 xl/cellimages.xml 与 xl/_rels/cellimages.xml.rels;2. 建立 DISPIMG 唯一标识、内部 r:id 与 xl/media/ 实际文件的映射字典;3. 解包出的媒体文件统一计算 SHA-256 哈希,相同哈希图片去重存储;4. 遍历工作表 sheet.xml,将公式所在单元格的行号、列号与图片映射绑定,精确对齐到业务行;5. 兼容标准 xl/drawings/drawing1.xml 体系下的 twoCellAnchor 浮动图片;6. 不以单个空行作为解析终结判定;7. 遇到无图、损坏图片、公式解析异常的记录,输出含文件名、Sheet名、行号的质检日志,不得静默跳过。
这套脚本跑完,数据就干净多了:
扫描范围:84个工作簿,112张表格; 图片提取:常规图片抓出 412张,WPS嵌入图抓出2,180张; 去重核验:给所有图片算了哈希去重,发现有648张是重复的——很多供应商其实都在用石材网上偷来的同一张宣传图; 实打实入库:独立图片1,944张; 异常挑错:排查出17处报错,都是供应商在格子里粘了打不开的网络缩略图。
图总算是干净整齐地拿到了。
04 / 石材名字,不能让 AI 擅自“合并同类项”
到底什么才算同一种石材?
要警惕AI的“自作聪明”。它看字面差不多,就想给你合并在一起。但在我们这行,名字像的可能是两码事,名字完全不相干的反而可能是同一个东西。
当时试算报告列出一堆冲突,大概是这几类:
译名差异:像“古驰黑”和“古奇黑”,纯粹是各家翻译习惯不一样,货其实是一样的,这种可以合; 矿山前缀:“威尼斯棕”和“意大利威尼斯棕”,也是同一个矿出来的,也能合; 单品多场景参数差异:遇到“贝金米黄”,就差点出事。
有个供应商在表里报了两次贝金米黄:一行写室内地面,报260元/㎡;另一行写外墙干挂,报380元/㎡。外墙要厚度,要做六面防护,要抗冻抗折,工法完全不一样,价格一平米贵了一百多块。
如果让AI顺手给去重合并了,外墙的报价和工艺直接就没了。
所以我给Codex 的指令里加了重锁:只准列清单,不准私自改。
请对提取的石材名称进行归一化分析,生成合并候选清单(Dry-run 报告)。输出要求:1. 提取所有名称相近、包含关系、常见错别字的石材分组;2. 每组列出:源文件名、行号、原始名称、建议规范主名、差异字段(色系、应用部位、报价口径);3. 评估合并影响:若执行合并,会影响几家供应商报价、涉及多少张图片及项目案例;4. 明确标注需要人工确认的争议项。未经指令确认,严禁修改任何数据,不得在内存中覆盖原始记录。
清单拉出来,我手工确认了38组确实是一回事的石材,做了合并。
至于贝金米黄,主档只保留一个标准名字。室内还是外墙,下沉到报价明细表里去,把不同的价格和工艺清清楚楚分开。把“古奇黑”存为“古驰黑”的别名。这样同事搜古奇黑能搜到东西,供应商报的真实底价也没有丢。
05 / 把大宽表彻底拆碎
Excel之所以越来越难用,就是因为它是张大宽表。一种石头,好几家供应商,大板价成活价,好几个工程案例,堆在几个格子里,越堆越乱。
最后一步,我用CloudBase PostgreSQL 把数据结构彻底“规范”起来。定了几条死原则:
石材是石材,供应商是供应商:分开两张表存; 大板价与成活价绝对分立:大板价(荒料切的毛板)和成活价(切好磨好含损耗的成品),拆成两条记录存,绝对不准算平均价,混在一起比价毫无意义; 图片归属清清楚楚:实物板面图挂在石材下面;工地完工照片挂在具体项目案例下面,不乱套; 全程保留追溯链条:加一个导入批次表。数据库里哪怕一个标点符号,都能顺着查到是来自哪一天、哪份 Excel 的第几行。
建好的关系大概是这样:
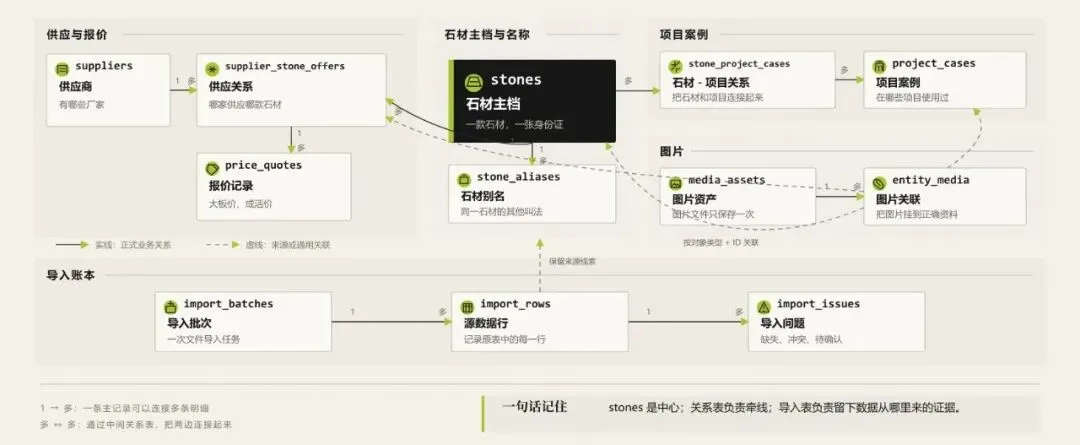
PostgreSQL数据库核心12张表实体关系简图
请基于确认后的字段映射,设计 CloudBase PostgreSQL 关系模型并编写版本化 Migration 脚本。核心实体设计:1. stones:标准品名、首字母、色系、材质分类、产地、主图 ID;2. stone_aliases:别名、主石材 ID、别名来源;3. suppliers:供应商企业全称、简称、联系方式、入库评级;4. supplier_stone_offers:供应商与石材关联、主供优势、矿山情况;5. price_quotes:关联 offer_id,含 price_type(slab:大板价 / installed:成活价)、min_price、max_price、unit、报价批次日期、当前有效标识(is_current);6. media_assets:图片 SHA-256、存储 key、原图宽高尺寸、文件大小、MIME 类型;7. entity_media:多态关联表,将 media_id 映射至 stone_id、offer_id 或 case_id,标明图片角色;8. import_batches / import_issues:记录每次导入的文件哈希、执行时间、成功行数、异常日志。要求:- 显式声明外键约束与级联动作;- 对石材品名、别名、色系、供应商 ID 建立 B-tree 索引;- 提供配套的 down.sql 回滚脚本;- 输出 dryRun 执行计划,确认无误后方可执行应用。
脚本跑完,12张表稳稳当当地建好了。06 / 折腾到这里,才算刚开局
回头看看这一通折腾:
84份表格,一份没坏; 提取出去重的图片1,944张,每张知道来自哪里; 理清了38组容易打架的品名; 数据库里12张表,清清楚楚。
以前那些散落在各个角落、连我自己都懒得翻的Excel,终于成了一套能随时调用的结构化资产。
但在本地折腾得再好,只要它还锁在我的电脑里,对团队来说就等于没有。
我当时也以为,数据理好了,下一步无非就是租个服务器把网页传上去,发个网址给大伙。
事实证明我想简单了。把东西放到公网上给几十号人一起用,完全是另一回事:
数据库密码怎么防抓包? 供应商报价这种敏感商业数据,怎么在数据库底层做行级权限隔离? 云端数据库升级时,遇到系统表权限报错该怎么安全回滚?
真正惊心动魄的上线部署,才刚刚拉开序幕。
下篇预告《企业级AI落地:如何用AI搞定上线部署与权限安全》聊聊我是怎么带着 AI 蹚过上线部署、密码加盐哈希与 RLS 权限这些深水坑的。

