我们训练了一个专门做 PPT 的模型
- 2026-11-06 15:35:40
一个专门生成PPT的模型,能做到什么程度?
做一份真正能拿去汇报的 PPT,到底有多麻烦?资料要找,结构要理,文字要压缩,页面还得一张张排。AI 的确已经能帮忙,但从能生成 PPT和生成完真的敢拿去开会,中间还有很长一段距离。
有些模型第一眼看起来不错,仔细一看却可能出现排版溢出、空白页面,甚至凭空编造文字;能力足够强的前沿模型效果更好,但如果要长期、大规模使用,成本又会很快上来。这也是所有 PPT 生成产品都会面对的一道难题:既要保证输出真的能用,又要把成本控制在一个可以规模化的范围内。
Genspark 的 Slides 就运行在这样的业务场景里。用户会用它做季度汇报、客户提案、董事会材料等真正要拿去展示的 PPT,每个月处理的 Token 已经超过 1 万亿。到了这个规模,模型质量和成本都会直接影响产品体验和商业化。最近,Genspark 和 Fireworks Lab 基于开放权重模型 MiniMax M3,继续训练出了专门做 PPT 的 Gen-1 Slides。
它不只是“帮你写几页 PPT”,而是会自己规划整份演示文稿的结构、写内容、生成页面、检查渲染结果,发现排版问题之后再自己修改。从规划、生成,到检查和修正,整个过程都由模型自己完成。
更关键的是,在 Genspark 的评估中,Gen-1 Slides 的整体PPT质量已经达到前沿闭源模型Opus 5的水平。
但这里有一个更有意思的问题:前沿模型已经这么强了,为什么做 PPT 这件事,还值得专门训练一个模型?
真正难的不是生成 PPT,是知道什么叫好 PPT
因为做 PPT 本身,就是一个非常具体、又足够复杂的任务。前沿模型虽然什么都能做,但 Genspark 真正需要的,是把其中“做 PPT”这一项能力单独做到更好:既能理解内容和叙事,又要兼顾视觉设计,还要在长流程里不断检查和修改。
一份 PPT 并不是一次模型调用就能完成的。模型首先要理解任务,规划整份内容的叙事结构,再写 HTML、渲染页面、检查效果。如果发现文字超框、布局有问题,还要返回去修改。一次完整任务可能持续几十轮,整个过程超过 10 万 Token。
这也是 Gen-1 Slides 和普通PPT 生成工具最大的区别之一。真正决定最终效果的,不只是模型会不会写内容,而是它在整个过程中不断做出的判断:这一页应该放多少信息?内容之间应该是什么关系?这里应该继续写,还是应该删掉?页面虽然成功生成了,但视觉上到底好不好?甚至更麻烦的是,一个错误可能在很早之前就已经埋下了。模型前面做出的一个布局决定,当时看起来没有问题,几十轮之后才导致最终页面渲染失败。所以,只把一堆优秀 PPT 丢给模型做模仿,并不能完整教会它如何一步步做出一份好 PPT。
这也是Genspark 和 Fireworks最终选择 RL (强化学习) 的原因。SFT (监督微调) 可以告诉模型好的 PPT 长什么样;RL要进一步训练的,是模型在几十轮操作中如何规划、判断、检查,再根据结果调整自己的行为。
但RL要真正发挥作用,还有一个前提:需要先把什么是好 PPT变成模型可以学习的标准。这也正是 Genspark 和 Fireworks 接下来要解决的核心问题。
Fireworks 做的,是把好 PPT一步步训练进模型
这次训练里,Genspark 和 Fireworks 的分工其实很清楚。Genspark最了解自己的用户,也最清楚什么样的 PPT 才真正能用。因此,他们把真实生产环境带进训练,定义 PPT 的质量标准,包括设计原则、评估方法,以及什么样的结果应该得到更高的分数。Fireworks Lab 则和 Genspark一起设计训练算法,并负责完整的训练过程,包括 Reward Engineering (奖励设计)、超过 100 次训练实验,以及支撑超长任务稳定训练的底层系统。
整个训练也不是一次微调结束,而是一层层往上加难度。
第一步,先做 SFT。
Fireworks 用经过筛选的高质量的Deck,让模型先建立对优秀 PPT 的基本认知,包括视觉设计和页面表达方式。
第二步,再进入短上下文 RL。
一开始不急着让模型完成特别长的任务,而是在相对较短的任务里训练,让奖励信号更清楚。这个阶段模型已经能生成更好的页面,但复杂布局还不够稳定。
第三步,再逐渐增加上下文长度。
等模型学会基本的判断和操作之后,再让它处理越来越长、越来越复杂的任务,最终训练完整的 PPT 制作流程。
这其实很像教一个新人做 PPT。先让他看懂什么叫好设计,再让他做一两页;会做之后,再让他负责完整汇报。最后训练的已经不是“这一页怎么排”,而是从理解任务、规划内容,到检查结果、发现问题和自己修改的一整套工作方式。
而RL还有一个很容易踩的坑:模型会想办法刷分。Fireworks的研究人员在训练过程中发现过一次,模型的视觉设计分数提高了,但任务完成度反而下降。单看总分似乎变好了,真正生成出来的 PPT 却没有变得更好。所以团队需要不断检查模型的完整训练轨迹,判断奖励信号上涨究竟代表模型真的变好了,还是它只是找到了评估体系里的漏洞。
到了这里,训练的对象其实已经不只是“一个会生成 PPT 的模型”。
Genspark 对什么是好 PPT 的判断,也被逐渐写进了模型。
做到Opus 5的水平,单份成本约降 90%
训练最后有没有用,还是要看实际结果。Gen-1 Slides目前已经成为Genspark AI Slides Standard模式的默认模型。在 Genspark 使用 200 个真实任务进行的内部评估中,Gen-1 Slides的整体表现达到前沿闭源模型 Opus 5的水平:视觉设计和综合得分领先,并且在三套独立评估体系的 9 个评分项中,有 8 项排名第一,全部 9 项进入前二。
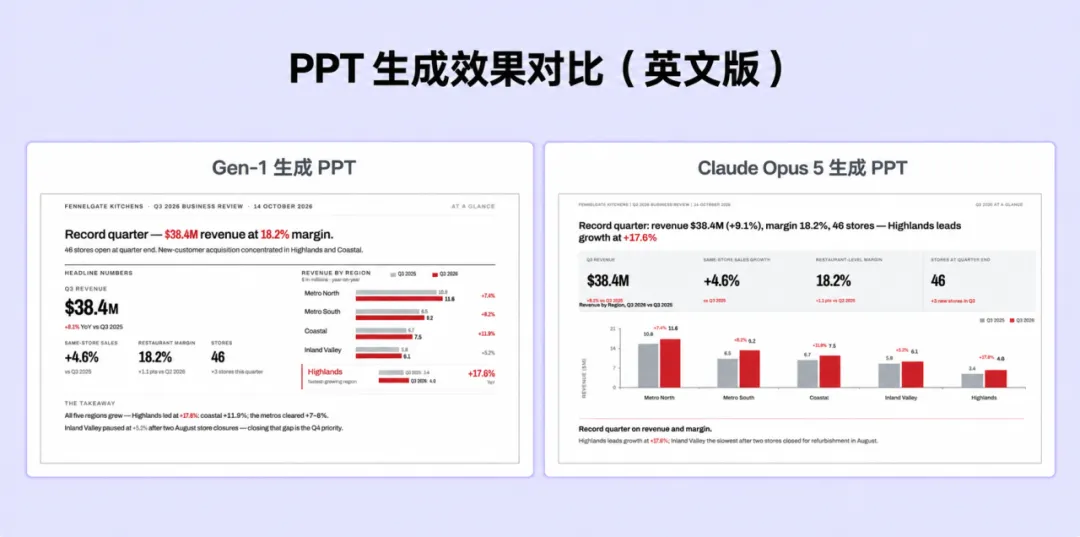
这里也同步解释一下为什么一直拿Opus 5做对比。Opus 5 是目前能力最强的一档前沿闭源模型,复杂内容生成和Agent任务都是它擅长的方向,但相应的使用成本也很高。所以对 Genspark 来说,真正有意义的目标不是单纯训练出一个更便宜的模型,而是能不能在 PPT 这个具体任务上,把效果做到这一档,同时把成本降下来。
那么我们具体来看成本计算。按照输入 Token 的公开价格计算,Gen-1 Slides大约只有 Opus 5 的 1/17。如果直接按照最终生成一份完整 PPT 的实际成本计算,Gen-1 Slides大约是Opus 5的十分之一。
换算成更直观的数字:一个团队每个月生成 1000 份 PPT,使用 Opus 5 大约需要 4200 美元,Gen-1 Slides 大约只需要 400 美元,成本降低约 90%。过去只能支撑1个人使用的预算,现在可以支撑大约 10 个人。
而且,这并不是简单地用小模型换便宜。在真实生产环境中,Gen-1 Slides 的各项指标已经与 Opus 5 相当;相比训练前的基础模型,用户低评分的 PPT 比例也从 18% 降到了 3.6%。
这才是前面这一整套训练最终换来的结果:不是为了训练而训练,而是把一个开放模型在 PPT 这件事上做到前沿模型级别,同时把单份PPT的成本降到约十分之一。
对用户来说,模型是谁训练的其实没那么重要
用户打开一个PPT工具的时候,大概率不会关心背后用了SFT、RL,还是跑了多少次训练实验。大家真正关心的很简单:生成出来能不能直接用,需不需要自己再改半天,以及这个能力到底贵不贵。
这也是Fireworks Lab在这次合作中的价值最终落到用户身上的地方。Genspark最了解自己的用户,也最清楚什么样的 PPT 才真正能用;Fireworks则提供训练、推理基础设施和研究能力,帮助它把这些原本存在于业务数据、评估体系和产品经验里的标准,真正训练进开放模型。最终得到的,是一个专门把 PPT 做好的模型。更重要的是,被训练下来的不只有 Gen-1 Slides本身,还有一套对“什么是好 PPT”的判断标准。
Genspark已经把这些标准沉淀进自己的 Reward (奖励机制) 和 Eval (评估体系) 里。未来出现更强的基础模型时,这套标准依然可以继续用于下一轮训练。基础模型可以换,但Genspark对PPT的理解、积累的数据和评估标准可以留下来,并随着产品继续迭代。
这也是 Gen-1 Slides 比“又发布了一个 PPT 模型”更值得关注的地方。随着通用模型越来越强,真正决定一个 AI 产品体验的,可能越来越不是它接入了哪个模型,而是它能不能把自己对业务的理解,持续变成模型能力。Fireworks 做的,就是帮助企业完成这个过程:把原本存在于数据、业务流程和人的经验里的标准,逐渐训练进模型。
而对每天要写方案、做汇报、赶DDL的人来说,这一整套技术路线最后带来的结果其实非常朴素:
AI做出来的PPT,比预想中更好,能直接拿去汇报,同时也更便宜。

