AI视频生成可以输入PPT了!阿里Wan3.0正式上线
- 2026-09-22 20:52:30
8月24日,阿里云视频生成模型Wan3.0正式上线。
官方首先强调的是时长:单次可生成最长30秒视频,支持声音、多个参考素材和跨镜头内容。相比常见的5秒或10秒片段,这确实能减少拼接时的人物漂移和镜头断裂。
但Wan3.0更值得关注的变化,不是多出来的20秒。
它允许用户把PPT、Word、Excel、PDF、Markdown乃至公开网页直接交给模型。视频生成的输入,第一次从提示词和图片,扩展到了企业每天都在使用的业务材料。
AI视频正在从会做镜头的模型,变成会读取资产的生产接口。
先看清楚它能做什么
根据阿里云8月24日上线页面,Wan3.0为原生30秒视频生成模型,支持多模态参考和视听要素联合生成。产品在8月6日开始公测,本次属于正式上线。
官方API文档给出了比发布稿更具体的边界:
生成时长为2至30秒,默认5秒,也可让模型自动决定时长; 输出分辨率包括480P、720P和1080P; 最多输入10张参考图片、5段参考视频或5段参考音频; 参考视频和音频总时长分别不能超过15秒; 可输入一个文件或一个公开网页,文件上限100MB,部分文档最多50页; 支持doc、docx、xls、xlsx、ppt、pptx、pdf、txt、md等格式; 任务采用异步接口,官方给出的通常处理时间为1至5分钟; 任务ID和结果链接只保留24小时,需要及时转存。
还有几项容易被忽略的限制。
文件和网页不能在同一次请求中并用;文件、网页或普通参考素材,不能与严格指定的首尾帧模式混用。API Key、调用地址和模型还必须属于同一地域。
所以,它不是把任何资料拖进去都能自动交付成片。它做的是扩大输入协议,不是取消制作约束。
为什么会读PPT,比30秒更重要
上一代AI视频工具的主要交互方式是提示词。
这对个人创作足够直接,对企业制作却很别扭。品牌部门掌握的是产品手册、色彩规范和历史物料;市场部门拿到的是活动方案和数据表;制作团队使用的是分镜、参考片和音频。真正有价值的信息分散在不同文件里,很少天然长成一段完整提示词。
过去要先由人把这些材料压缩成文字描述,再交给模型。压缩过程中,产品参数可能遗漏,视觉要求可能被简化,图片与文字的对应关系也会丢失。
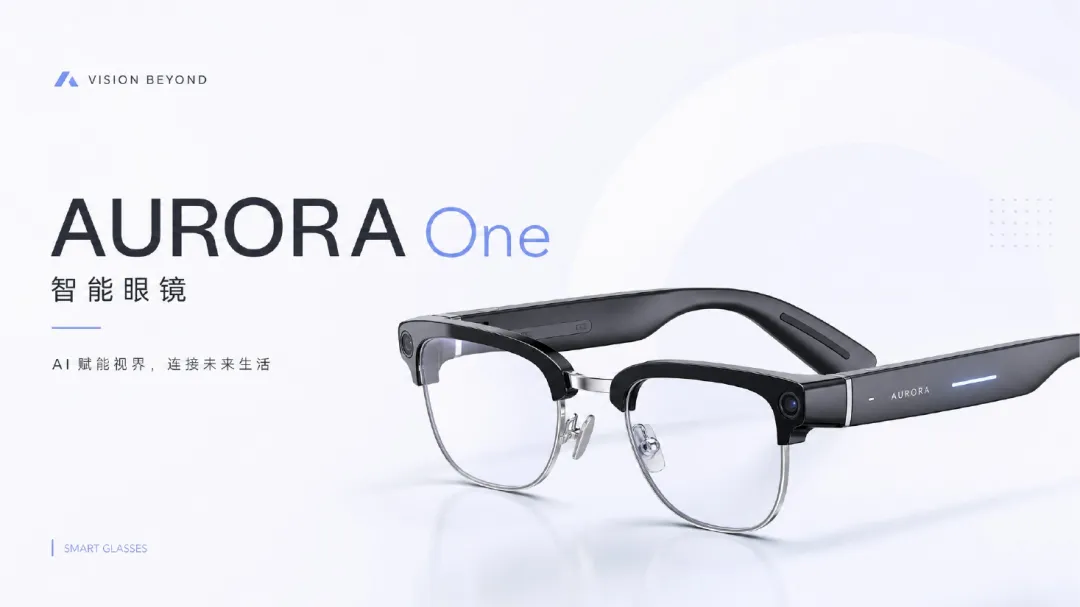
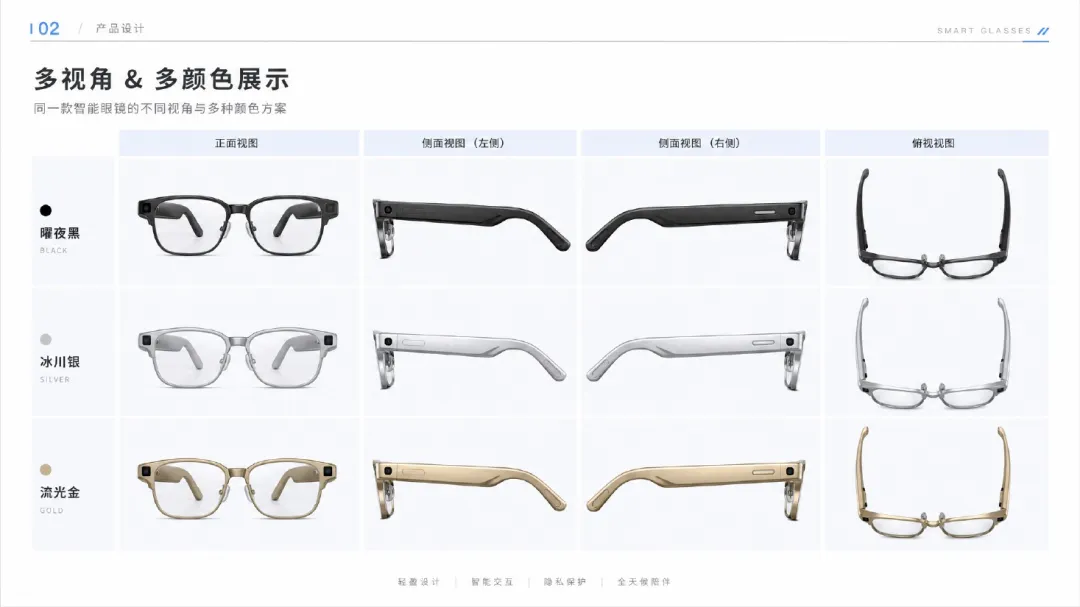
Wan3.0把文件和网页设为API中的正式媒体类型。用户可以在提示词里引用图1、视频1、音频1,模型据此组织角色、物品、动作和声音。官方示例甚至直接传入一份智能眼镜PPT,让模型读取产品材料后生成广告视频。
这意味着输入端从描述意图,走向提交证据。
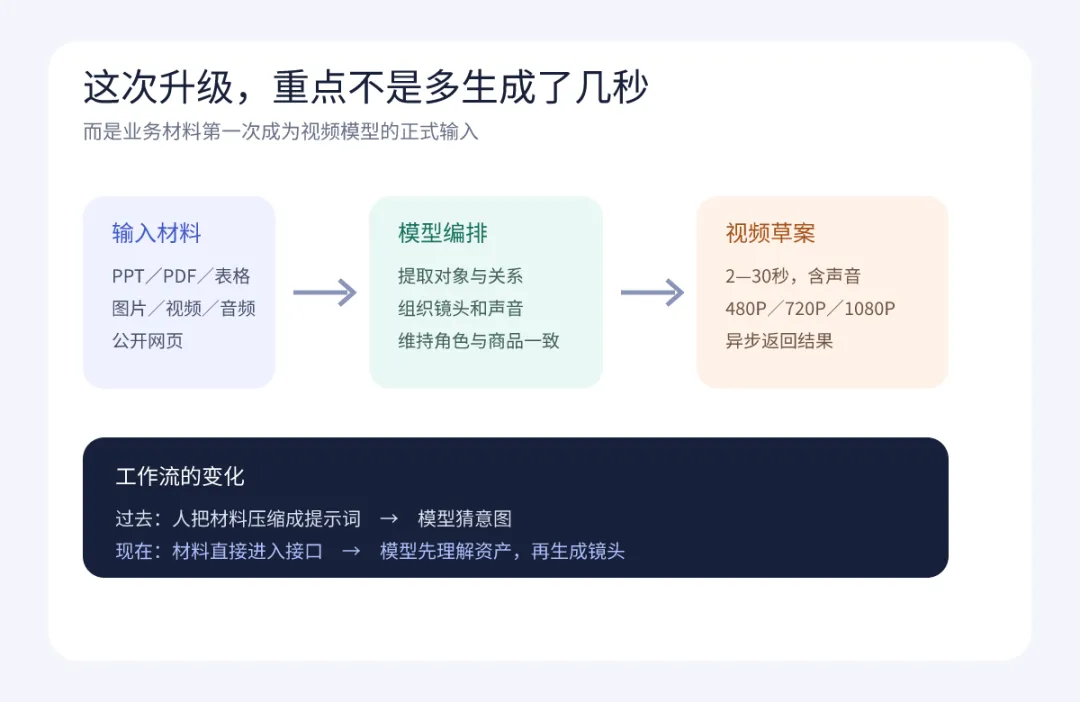
对企业来说,这一变化有三个实际价值。
一是减少人工转译。策划不必把几十页资料重新写成一条超长提示词,模型可以直接读取原文件。
二是提高资产复用。同一套商品图、品牌规范和脚本,可以进入不同尺寸、语言和渠道的视频任务。
三是让流程更容易接口化。文件输入、异步任务和结构化返回结果,意味着它可以接进内容管理系统,而不只存在于网页创作框里。
这也是生成式视频从演示工具进入生产系统的必要条件:输入必须能被程序稳定描述,输出必须能被任务系统追踪。
一个文件如何进入视频接口
官方API采用异步任务。下面这段简化代码保留了核心结构:
curl -X POST "$ENDPOINT/video-synthesis" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "X-DashScope-Async: enable" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan3.0-video",
    "input": {
      "prompt": "依据产品资料生成一支克制的新品介绍视频,不补充文件外参数",
      "media": [{
        "type": "file",
        "url": "https://example.com/product-brief.pptx"
      }]
    },
    "parameters": {
      "resolution": "720P",
      "duration": 15,
      "audio": true,
      "watermark": true
    }
  }'
接口会先返回任务ID,调用方再轮询任务状态。成功后的视频链接只有24小时有效。
这段代码里最重要的不是模型名,而是那句不补充文件外参数。它表达了一个生产要求,但不能保证模型百分之百遵守。参数、价格、认证和承诺仍需逐项核对。
解析文件,不等于理解业务责任
一份PPT里可能同时出现最终参数、旧版本数据、讨论备注和示意图片。模型可以解析这些内容,却不知道哪一页经过法务确认,也不知道某项性能是否允许对外宣传。
同样,模型能读取网页,不代表网页内容具备再次传播的授权;能模仿参考视频的动作和声音,也不代表其中的肖像、音乐和商标可以用于商业发布。
因此,文件输入越方便,素材治理反而越重要。
文档到视频不是一键发布,而是把原来藏在人工沟通里的制作步骤显性化。
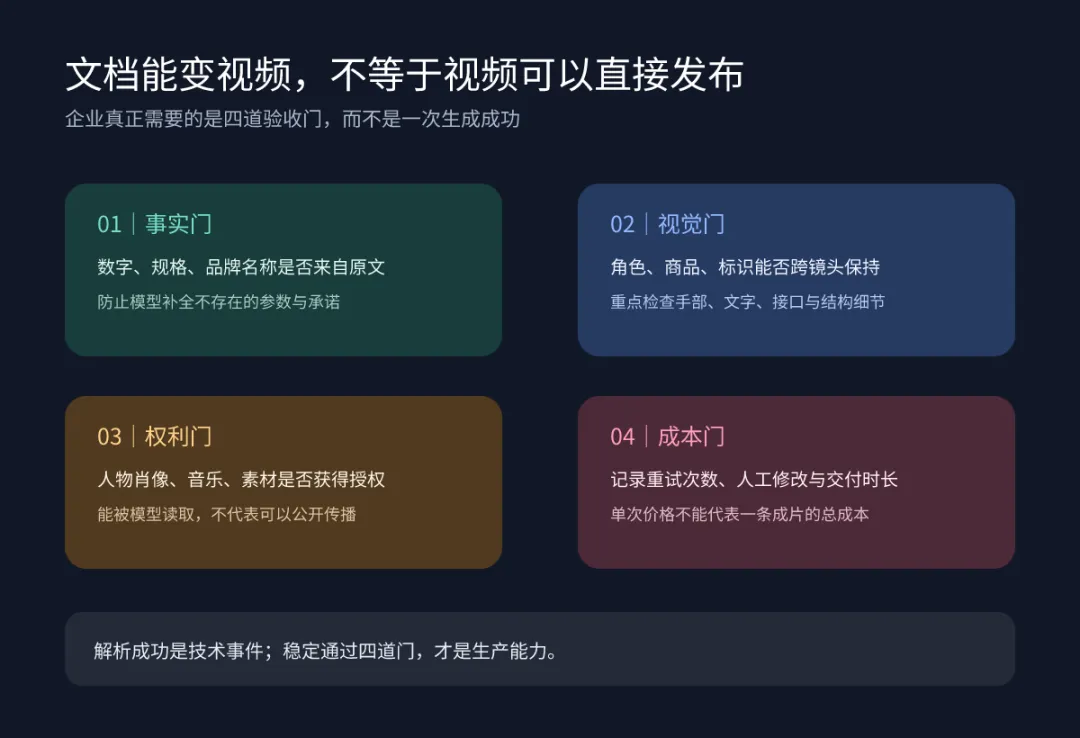
真正需要测试的是成片率
30秒视频比5秒片段更接近广告、产品介绍和知识短视频的基本长度,但时长增加也会放大误差。
人物在第3秒保持一致,不代表第25秒仍然稳定;产品在主镜头中正确,不代表侧面结构不会变化;背景音乐自然,也不代表对白、动作和节奏能够同时对齐。
企业评估这类模型,不应只比较单条样片的画质,也不能只看每秒API价格。更有用的指标是:
可用成片率 = 通过事实、视觉、权利和品牌验收的视频数 ÷ 总生成视频数
随后再计算一条合格视频消耗的生成次数、人工修改时间和总成本。
如果一条15秒视频平均要生成八次才能采用,名义上的单次价格没有太大意义。相反,如果模型能稳定读取产品材料,并把一次通过率提高到可预测范围,它才真正具备生产价值。
AI视频竞争,开始从模型效果转向工作流
Wan3.0没有公开一套足以独立验证所有质量主张的统一评测,官方展示也不能替代不同企业的真实素材测试。它是否能稳定处理复杂表格、长PPT和多角色叙事,还要看持续使用的数据。
但这次上线已经显示出清晰方向:视频模型的竞争不再只是更清晰、更长、更像电影,而是谁能更顺畅地接收业务材料、保持资产一致,并进入企业现有系统。
提示词时代强调个人表达。文件和接口时代强调组织协作。
当AI视频开始读取PPT,真正被重新定义的不是创作灵感,而是从资料、审核到交付的整条生产链。

