AI 读 Excel 错 161% 都不报错?huashu-excel:先体检再对账,算不对不交差
- 2026-09-21 02:30:01
先看一个吓人的场景
把一份乱七八糟的 Excel 丢给 AI 分析,会发生什么?
假设表里:标题占了第一行、表头有两级、地区列用了合并单元格、金额带千分位、中间夹着一行「华东小计」、表格尾巴还有三行「合计/占比/同比」。
你问它:「1 月总销售额是多少?」
主流 AI 工具的做法是 pd.read_excel() 一把读进来,再求和。
结果呢?算出来 34,893,234,真值是 13,367,767,误差 +161%。
更可怕的是:全程零报错、零 NaN、零警告。它交付给你的数字,长得和正确答案一模一样,你根本看不出它错了。
错在哪三处,也很有代表性:
表里的「合计」行(15,368,317)被当成了一家门店; 「华东小计」(6,157,150)又被当成一家门店; 有一行是粘贴事故造成的完全重复,被算了两次。
AI 写代码,错了会抛异常;但 AI 做数据分析,错了什么都不会发生。这正是今天这个项目存在的全部理由。
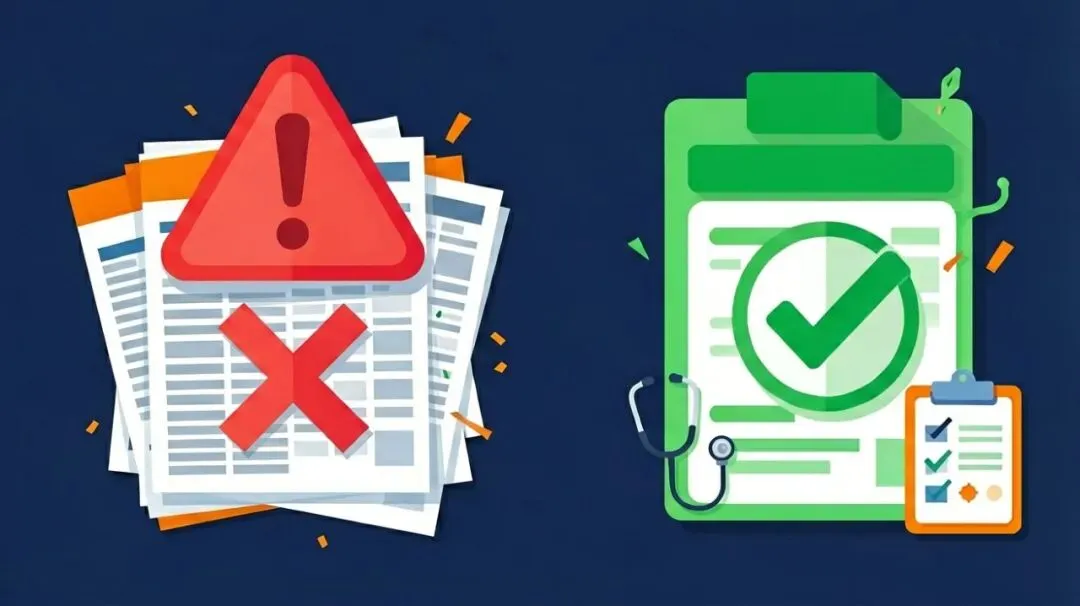
主流读取 vs huashu-excel 体检,同样一张脏表两种结局
项目:huashu-excel,一个真正懂数据分析的 skill
huashu-excel(花叔数据分析大师)是一个开源的 AI Skill,作者是「花叔」。它的口号就一句话:
给我一份 Excel,给你交一份专业报告。
它干的不是「读表」,而是「数据分析与 Excel 全流程」:体检 → 清洗 → 对齐 → 分析 → 对账 → 交付。核心卖点有四个:
- 先读原始单元格,再动 pandas
。 pd.read_excel()读进来的那一刻,合并单元格、单元格格式、原始类型就全丢了。而这个 skill 先用 openpyxl 读原始格子,再判断怎么处理。 - 把表里的「合计」行当成免费的校验和
。所有工具都把汇总行当噪音过滤掉,但它拿清洗后的明细自己去对「合计」行——对不上就说明有一方错了,必须报出来。 - 交付前跑 master check,不通过就不给数字
。 - 最后一步质控:另派一个没参与创作的 agent 从原始数据重算
,专门拆台。
依赖只有 openpyxl,不联网、不用 pandas、不依赖任何 agent 平台特性,纯标准库都能跑。
八步标准作业流程
它把一次数据分析拆成八步,一步都不省:
1 体检:这张表长什么样,先看再算 2 清洗:变成规范分析表,每一步可追溯 3 对齐:摸底 → 查外部基准 → 问清用户要什么 → 定口径 4 分析:扫陷阱,每条发现都推到「所以呢」 5 对账:行数守恒、总和守恒、与表内合计交叉验证 6 交付:Excel / 图表 / 报告,口径随数字一起交付 7 验图:渲染出来看画错了没有 8 质控:另派 agent 从原始数据重算,拆你的台其中第 3 步「对齐」特别值得一提。作者的观点是:用户开口时往往还不知道自己要什么,因为他也没看过这份数据长什么样。所以澄清不放在最开始,而是放在「你已经看懂数据、他也能看懂你的描述」之后——先出一段人话摸底,再带着它去问用户要回答什么问题。
而第 8 步「质控」是最容易被省掉的一步,却恰恰能抓到最多问题:退出码验的是「算得对」,不是「结论对」。一份内部对账分毫不差的报告,可以整体错一个财年,只要那一列的列名不是它字面的意思。
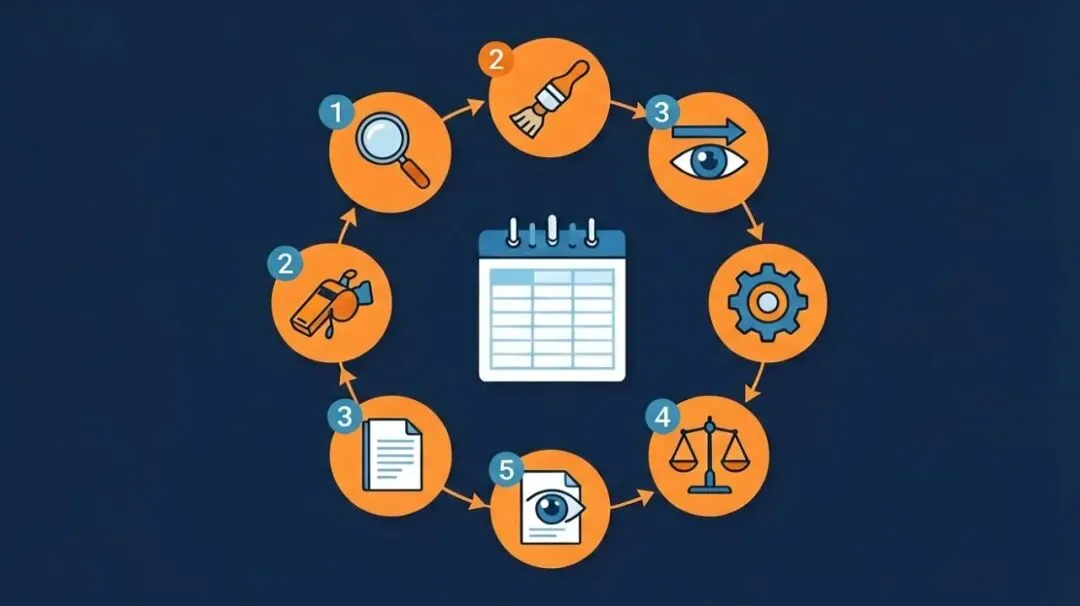
八步标准作业流程:体检→清洗→对齐→分析→对账→交付→验图→质控
同一个例子,它怎么做?
回到开头那份脏表。huashu-excel 的体检阶段会把问题全列出来,一个都不猜:
【必须先处理】 1. 表头不在第 1 行:真表头在第 3、4 行 2. 两级表头,要用 header=[2, 3] 读 3. 4 个汇总/小计行混在数据区(第 12、17、18、19 行) 4. 1 行与前面完全重复 5. 3 处合并单元格落在数据区 【逐列】 E 列:10/10 个数字被存成文本 → 直接 sum() 会变字符串拼接 I 列:缺失值被写成「—」「无」「N/A」 D 列:日期格式不统一,四种写法混在一起然后拿清洗后的明细,去对表里自带的合计行:
✗ 对账 · F 列「2 月」 vs 第 12 行「华东小计」 表内写 6,490,430.00,明细算得 6,490,420.00,差 10.00 MASTER CHECK:不通过。在解决之前,不要把这些数字写进任何交付物。那个差 10 块钱的错,是造数据的人手填小计时填错的。相对误差 0.00%,肉眼永远发现不了,脚本一次揪出来。
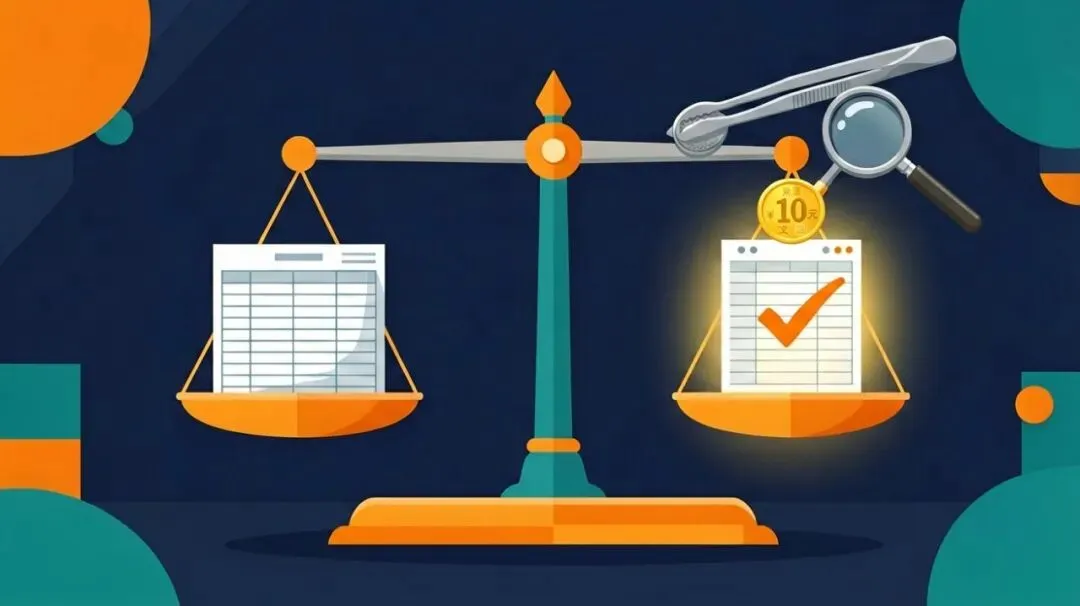
清洗后的明细 vs 表内合计行对账,天平上揪出差 10 块的错误
五个和别的工具不一样的地方
一、它不是一个分析师,是一个团队。 依次扮演领域专家 / 数据分析师 / 战略顾问 / 视觉设计师 / 前端工程师 / 质控,角色之间打架的地方保留下来,那是信息量最大的部分。
二、默认给五数概括,不给均值。 业务数据几乎总是右偏的,均值在偏态分布下描述的不是任何一个真实对象。它默认输出 min/Q1/中位数/Q3/max + IQR,这是 Tukey 的抗差统计。
三、图表诚实性检查。 柱形图数值轴强制从 0(编码长度,截断即失真);折线图不强制从 0;类别超过 3 个时拒绝生成饼图;不完整的最后一期画虚线;套用色盲友好色板——约 8% 的男性有红绿色觉障碍。
四、报告直接写,不套模板。 HTML 报告直接写 HTML/CSS,自包含、无 CDN、图表用内联 SVG。PPT 则明确外包给作者另一个项目 huashu-design,不硬做。
五、机器判事实,人判品味。 「行数对不对、数字能不能追回源单元格」机器验死、自动跑;「分析有没有意义」明确交还给人,绝不用一个分数冒充客观。
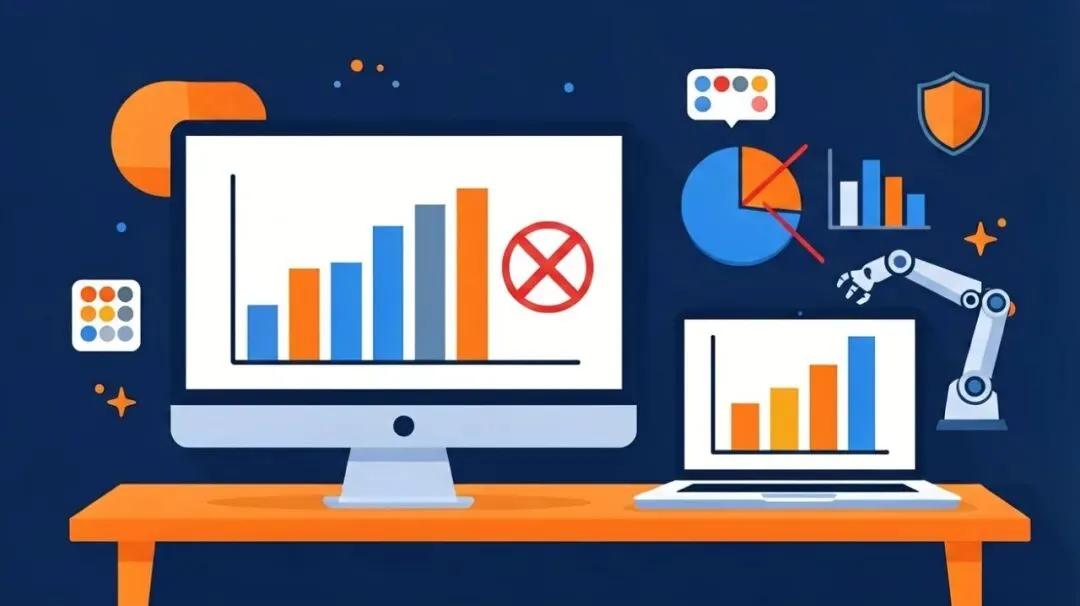
图表诚实性:柱状图强制从 0、类别过多拒绝饼图、色盲友好色板
装上就能用
安装只需要一条命令:
npx skills add alchaincyf/huashu-excel跨 agent 通用,Claude Code、Cursor、Codex、OpenClaw、Hermes 都能装。也可以直接 clone 到对应目录:
Claude Code
git clone https://github.com/alchaincyf/huashu-excel ~/.claude/skills/huashu-excelCodex / Kimi Code
git clone https://github.com/alchaincyf/huashu-excel ~/.agents/skills/huashu-excel装完直接说人话就行:
「帮我分析下这份销售表」 → 走完整八步 「这两个数怎么对不上」 → 体检 + 对账,先找口径差异 「这个表有多少行是脏的」 → 只跑体检 「帮我把这份表洗干净」 → 体检 + 清洗 「这个数你怎么算出来的」 → 对账 + 口径回溯为什么值得关注
Panko(1998)的研究显示,86% 的电子表格含有错误。欧洲电子表格风险兴趣组(EuSpRIG)从 1995 年起持续收录见诸媒体的事故——最著名的是 Reinhart-Rogoff 论文,Excel 选区少选了 5 行,把 +2.2% 的 GDP 增速算成 −0.1%,而那篇论文当时是全球紧缩政策的主要学术依据。
一个算错还「自信满满」的 AI 助手,比没有助手更危险。huashu-excel 的可贵之处,是把「这句反问能答上来」当成了硬指标——每个数字都能追回源单元格,每个结论都先过了对账和质控。
如果你经常和 Excel 打交道,不管是财务、运营还是分析岗,都值得装上它试试。给它一份 Excel,让它先体检、再对账,算不对就让它别交差。
觉得有用?点个关注,后面继续挖好用的 AI 工具。

