AI 学习笔记-08:企业知识库
- 2026-11-07 22:23:40
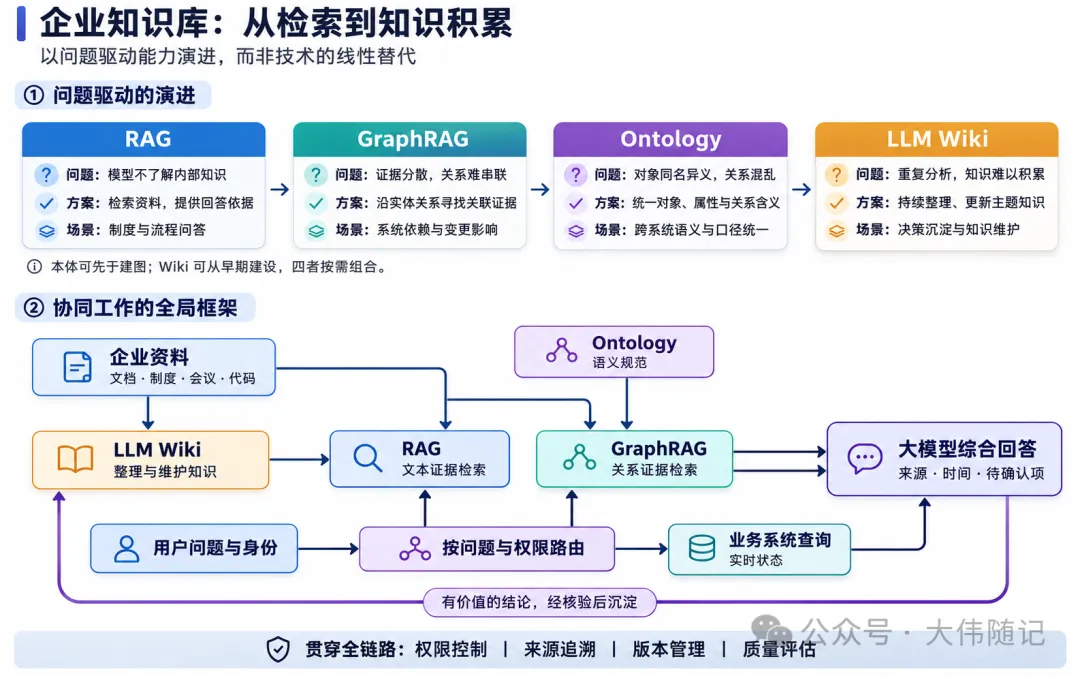
企业知识库的建设,可以从一个问题开始:大模型具备通用理解和表达能力,但并不天然掌握企业内部、持续变化且受权限约束的知识。如何让它可靠地回答业务问题?
沿着应用需求逐步深入,就会引出 RAG、GraphRAG、Ontology 和 LLM Wiki。下面是一条需求驱动的建设路径,并非这些技术的历史发展顺序。
第一阶段:模型不知道内部知识,需要 RAG 找依据。
例如,员工问“我们的付款失败处理流程是什么”,答案存在内部文档中。将全部文档塞进上下文既昂贵,也难以维护,因此需要先检索相关内容,再交给模型回答,这就是 RAG。
它解决了“知识不在模型里”的问题,适合制度查询、技术问答和操作指导。但基础的文本检索主要找到相关片段,不一定覆盖完整业务链路。
第二阶段:答案分散在多份资料中,需要 GraphRAG 串联关系。
问题进一步变为“修改付款接口,会影响哪些业务和系统”。仅检索包含“付款接口”的段落,可能遗漏间接依赖。
因此,需要将系统、接口、业务等对象连接起来,沿关系寻找证据,再结合原文生成答案,形成 GraphRAG。它适合依赖分析、变更影响评估及跨文档归纳,但关系是否准确、对象是否被正确识别,会成为新的瓶颈。
第三阶段:关系有了,含义却不统一,需要 Ontology 明确语义。
不同系统可能混用“提现单”“付款单”“支付指令”。如果直接建图,就可能把不同对象合并,或者把“调用”“归属”“依赖”混成一种关系。
Ontology 定义业务对象、属性和关系的含义,为建图、数据映射和查询提供共同标准。它解决语义一致性问题,但不会自动补齐事实;本体也可以在建图前建立,减少后续歧义。
第四阶段:每次都重新分析,需要 LLM Wiki 积累知识。
当团队反复询问“为什么这样设计”“历史上有哪些例外”,即使能够检索和关联,也可能每次重新整理相同资料。
LLM Wiki 将经过核验的概念、决策和综合分析沉淀为持续维护的主题页面,并随新资料更新。它解决知识积累与维护问题。这项需求也可能很早出现,不必等到图谱建成后再做。

