LLM学习笔记-51- Attention系列-MLA
- 2026-11-07 15:19:23
本篇介绍 Compression along Channels(沿通道压缩) 分类下面的MLA(Multi-head latentattention:多头潜在注意力) 。
MLA 是由Deepseek团队提出。通道压缩减小的是每条 token 记忆的宽度,而非副本数量。DeepSeek-V2、V3 系列和 Kimi K2 都用了这个技术。
🟠参考论文:【1】DeepSeek-AI et al. “DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts LanguageModel”. In: arXiv preprint arXiv:2405.04434 (2024). arXiv: 2405.04434. URL:https://arxiv.org/abs/2405.04434.
🟠在学习过程中,要关注三个要点:① 低秩联合压缩——把 K/V 联合低秩压缩成一个隐向量 ,推理时只缓存 ,需要时再上投影出 K、V。(注意:此时没有头维度,所以相比MHA,大大压缩缓存)
② 解耦 RoPE——位置信息无法吸收进低秩矩阵,需额外缓存一小段共享 RoPE key(注意:Q和K都有各自的RoPE处理和拼接)
③ 吸收技巧——推理时把 吸收进 、 吸收进 ,注意力直接在 latent 空间算(注意:这里是MLA的训练态和推理态(decode)的差异点)
1. MLA 的处理步骤描述
我们以Deepseek V2 的参数为例,详细说明MLA的每一步的处理过程:
• 模型维度 ,头数 ,头维度 ; • KV 潜向量维度 ,Q 潜向量维度 ,解耦 RoPE 维度 。
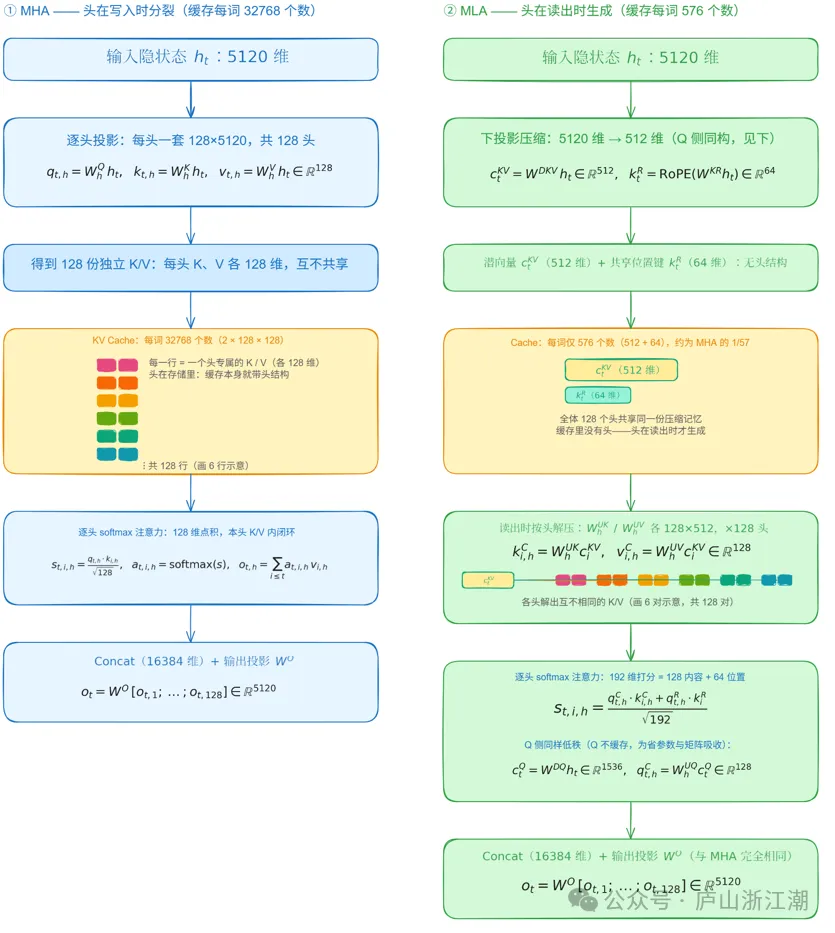
第一步:写入记忆——压缩(无"头"的概念)
这一步完全没有头。
1)对KV 一并进行低秩压缩:
• 是 KV 的下投影矩阵,这里KV只有1份,5120 维的隐状态被压成一个 512 维的潜向量
2)生成K的位置向量:
• 是 K的位置投影矩阵,经过RoPE变换后,得到K的 64 维的共享位置键 ,解耦 RoPE 键,全局共享一份}
缓存里每个词只存 ,每词 个数,共 个数(对比 MHA 要存 个)。
这份记忆里既没有"第几个头"的标签,也没有 K 和 V 的区分——它是 K 和 V 共同的压缩码。
第二步:读出记忆——按头解压("头"在这里诞生)
每个头有自己专属的解码矩阵,分别对K/V 进行解码操作:1)K 解压部分:
2)V 解压部分:
• 和 分别为每个头的K的上投影矩阵和V的上投影矩阵。 • 把 128 个头叠起来看,就是 、,
——这样,同一份 512 维的码,被 128 个不同的"解码器"读成 128 份不同的 128 维 K 和 128 份不同的 V。
第三步:查询侧(Q也进行类似的先低秩压缩,再解压过程)
查询侧同样走低秩(,)并拼上自己的 RoPE 部分:
1)低秩压缩: 为Q的下投影矩阵,(注意:这里没有头概念),作用于输入的隐向量 ,计算1份。
2)按头进行解压:
• 是头的Q的上投影矩阵,作用于前面计算的潜向量
3)按头生成Q的位置信息:
• 是头 的对应Q的位置投影矩阵,注意,这里作用于1)上已经生成好的潜向量,再经过RoPE变换后,得到头的对应Q的 64 维的位置向量 (注意,这里是每个头有自己的)
4)内容部分和位置部分,二者进行拼接:
这里,Q 侧也走低秩(先压到 1536 维再按头解压到 128 维),这不是为了缓存——Q 不用缓存——而是为了让矩阵吸收在 Q 侧同样成立,并顺带省下 Q 投影的参数量和激活内存。
第四步:注意力计算(每个头独立,在 192 维空间打分)
这一步按头计算:
1)K的解压的内容部分和位置部分,二者进行拼接:把第二步解压出来的每个头的K的内容部分 和K的位置共享键部分进行拼接(维度192)
2)进行打分计算和求softmax:
• 第三步Q的拼接输出 和 1)里面的K的拼接输出进行相乘和归一化得到
• 再求softmax输出,和第二步解压得到的当前头的进行加权合并:
每个头独立做一次完整的 softmax 注意力:打分用的向量是 192 维(128 内容 + 64 位置),读出的是 128 维的 V。这里和 MHA 的结构一模一样——头数、打分方式、归一化方式都没变。
第五步:整合
128 个头各产出 128 维,拼成 16384 维,再投回 5120 维。与 MHA 完全相同。
2. MHA 对照描述
我们再按照完全相同的配置走一遍 MHA:, 头,,注意力内部维度 。
第一步:写入记忆——按头投影("头"在这里就分裂了)
对每个头 各做一次。把 128 个头叠起来看:——同一个 5120 维的隐状态,被 128 套互不相同的投影矩阵,直接投影成 128 份不同的 K 和 128 份不同的 V。
缓存里每个词存的是全部分裂后的结果:,共 个数。记忆本身带有完整的头结构——头之间相互看不到。
第二步:注意力计算(每头在 128 维空间独立打分)
每个头是一次完整的、闭环的注意力:自己的 Q 查自己的 K,加权重自己的 V。头与头之间在整个注意力计算中零交互——每个头是同一个 投影出来的不同副本。
第三步:整合
128 个头各产出 128 维,拼成 16384 维,投回 5120 维。
逐步对比:MHA vs MLA(同配置)
| 无 | ||
| K 最终形态 | ||
| Q 最终形态 | ||
| 打分(训练态) | ||
| 打分(推理态) | ||
| 整合 | ||
| Q+K+V 投影参数量 | ||
| 存储里 | 解码器里 | |
🟣二者的对比图示如下:
3. MHA的训练态和推理态(decode)的差异点
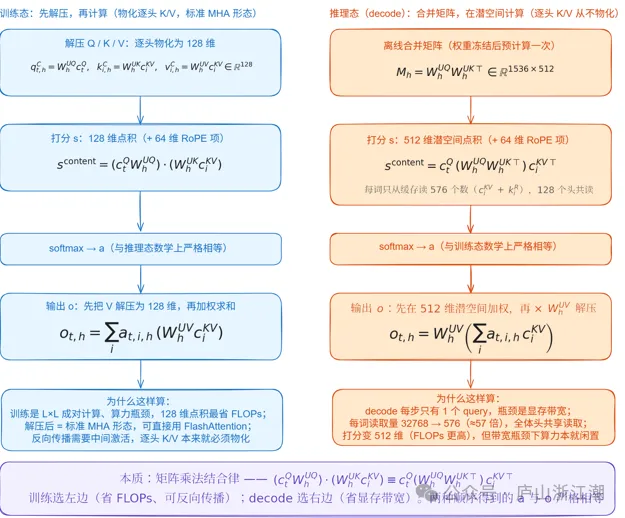
理解他们的差异的关键核心就是:同一个公式,两种不同的乘法结合顺序:
1)MHA(每头一个 128 维点积,单一项):
2)MLA 训练态(解压后计算,与 MHA 同构,只是向量是 192 维、logit 两项):
3)MLA 推理态(矩阵吸收,不物化逐头 K/V):打分——先把合并矩阵离线算好 ,每个 query 在潜空间得到一个 512 维的"吸收查询",直接与缓存点积:
读出——先在 512 维潜空间加权求和,最后才解压一次:
具体看:我们把解压过程和打分过程写在一起:( 是 1536 维, 是 512 维):
矩阵乘法满足结合律,所以有下面两种计算顺序:
顺序 A(训练态):先解压,再点积
顺序 B(推理态):先把两个矩阵合并,再在潜空间点积
两种顺序的结果逐位相等。
总结一下:
| 物化 | 从不物化 | |
由于顺序 B 的合并矩阵 一旦合并,反向传播就没法分开更新 和 了——所以训练必须保留两个参数矩阵各自的形态和梯度路径。这样,流程是:训练时用 A 学出两套矩阵 → 推理部署时把它们的乘积离线算出来存好 → 解码时跑 B。
🟣二者对比示意图如下:
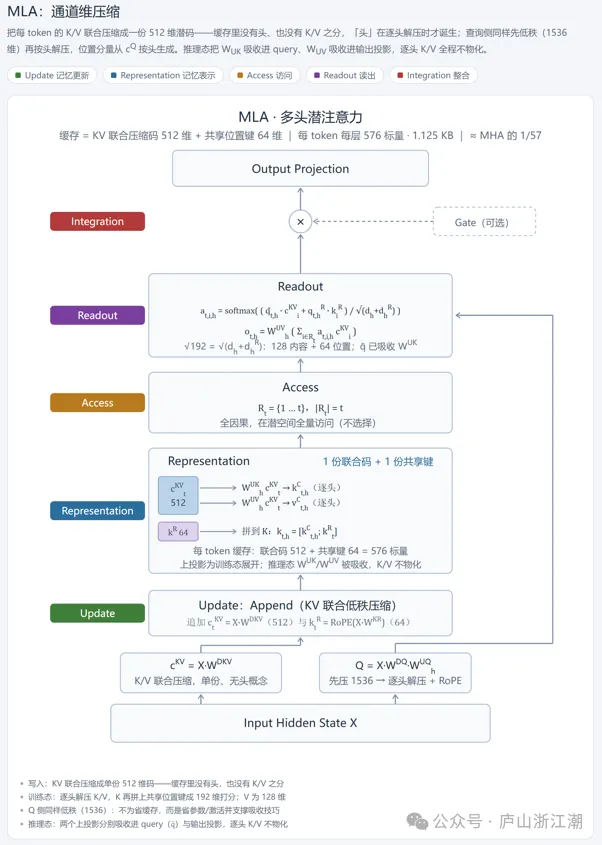
按照完整的Attetion的5个角度给出MLA的框图: