云化架构超算中心设计方案(71页PPT)
- 2026-11-08 04:16:11
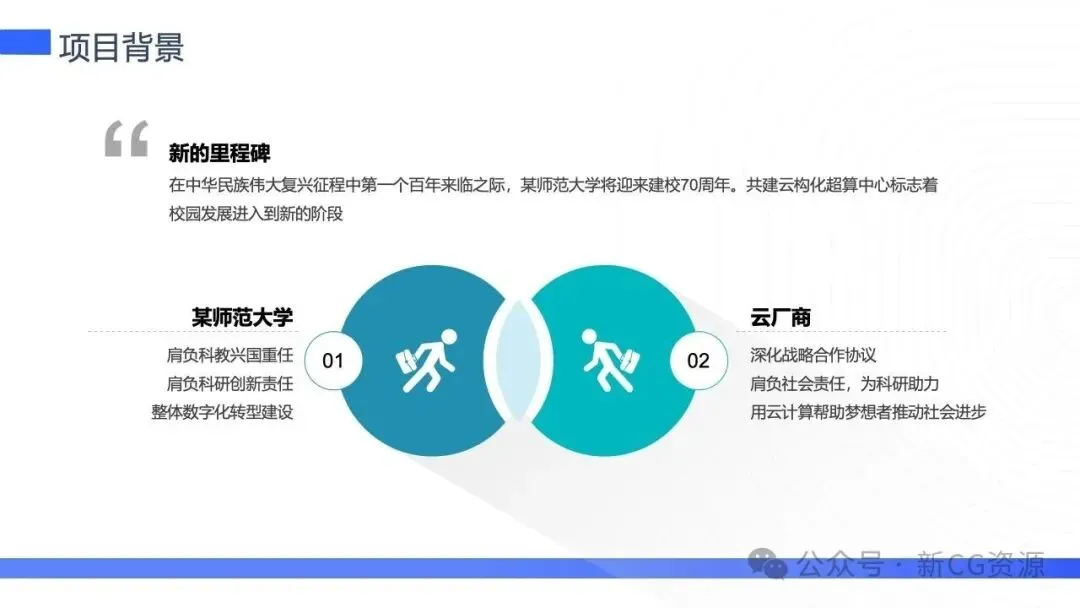
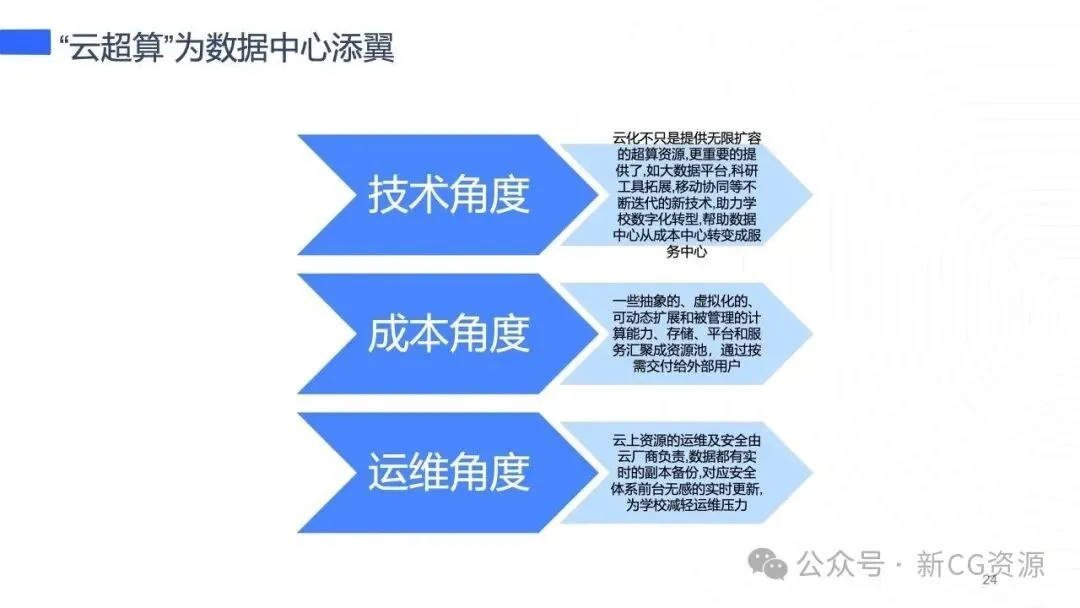
高校超算中心多年困在一个循环里。预算批下来就买机器,机器装好就排队等机时,机时排满再等下一轮预算。某师范大学在建校七十周年之际与云厂商共建的云化架构超算中心,把这个循环从源头改了。设备清单只是表象,真正变的是算力的供给方式,从一次性采购的资产,变成随时可调的服务。
一、环境背景
科研负载的形态已经变了。AI for Science 把训练任务推到 GPU 集群上,多物理场仿真、分子动力学、遥感反演、气象模式在同一个校园里同时要算力,需求曲线很难预测,长时间低负载中间夹着几天几夜的尖峰。高校自建超算的三重错配因此被放大。算力迭代以十八到二十四个月为一代,预算和采购周期却按两三年滚动,机器交付时往往落后半代。峰值配置按最重的课题定,日常负载远低于峰值,业内普遍观察到不少高校 GPU 节点的年均利用率停留在三成上下。运维团队编制有限,一套并行文件系统加一套调度器,出问题只能靠少数几个人扛。学校要的又恰恰是稳定,课题组的作业跑到一半断了,损失的不止电费,还有几个月的实验数据。
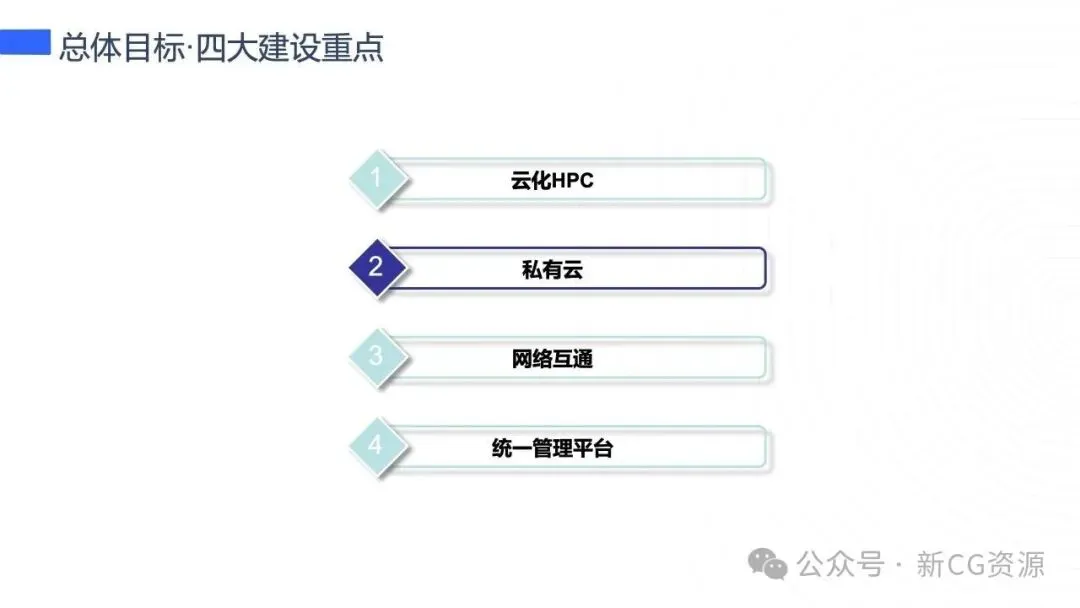
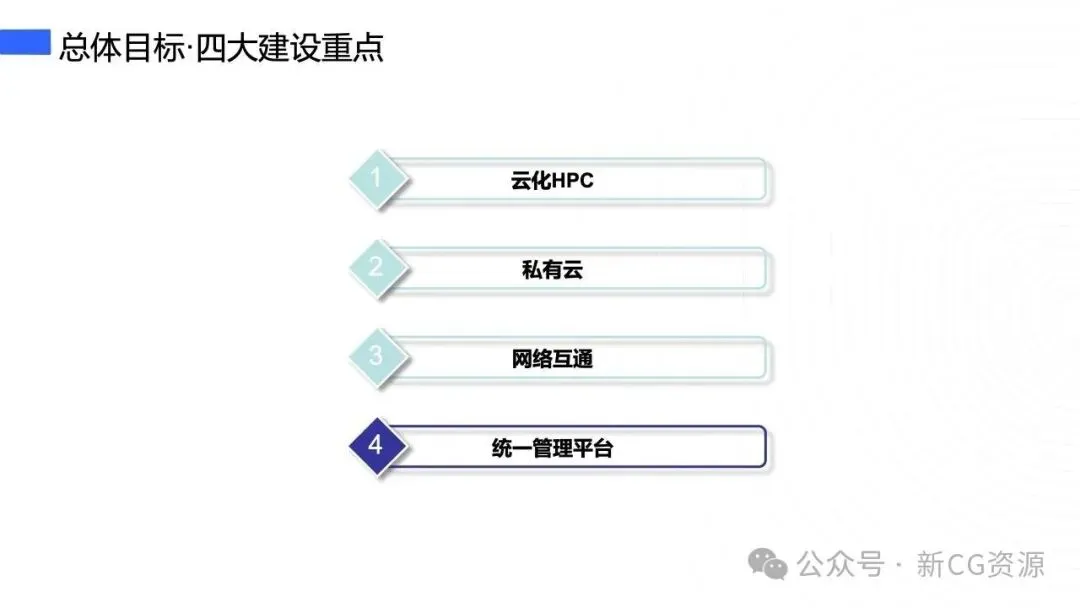
卡点还在机器数量之外。混合云喊了很多年,多数落地成了把专线接进机房,本地 HPC 和云端资源池各跑各的调度,账号、计费、监控各有一套后台,师生要用算力得先搞清楚自己在哪个系统里。算力被切成孤岛,网络路径没为 TB 级的作业传输做过设计,管理界面有几套就要登录几次。这三处断点不打通,买再多的卡也只是把闲置从机房搬到云上。破局方向由此清晰,本地既有投资要保住,云端弹性要能用上,中间的互联和统一管理得一起设计,缺一角就退回到老路上。
二、解决方案
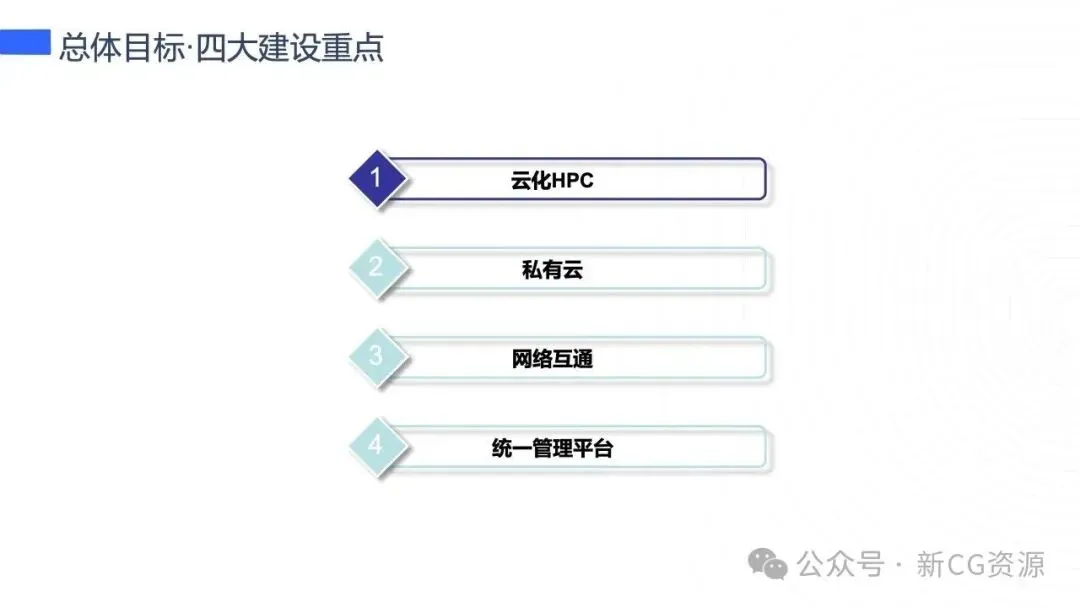
(一)云化HPC与本地算力池的重新分工
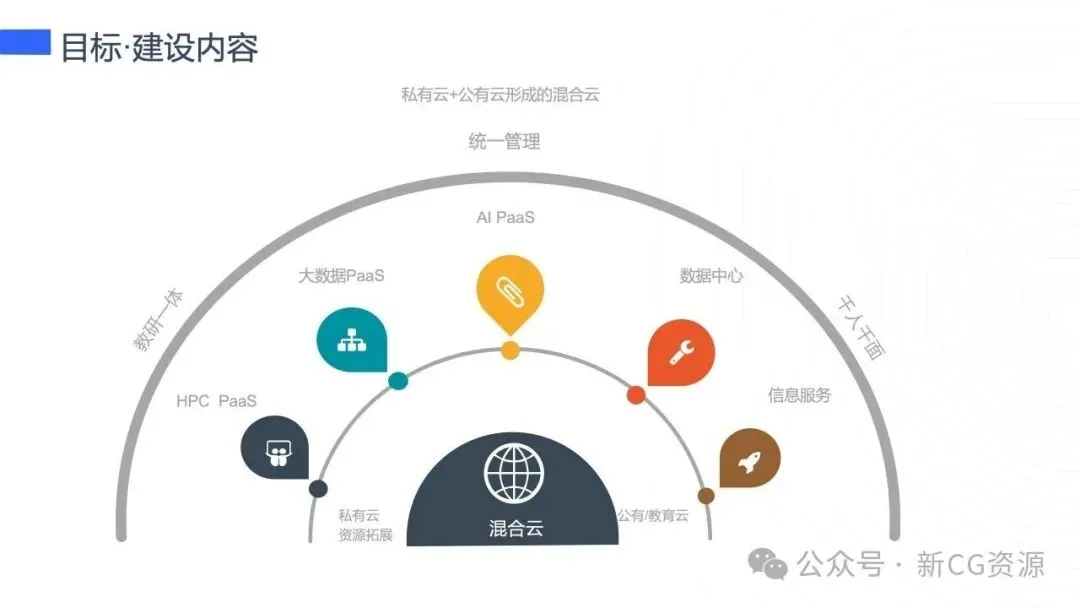
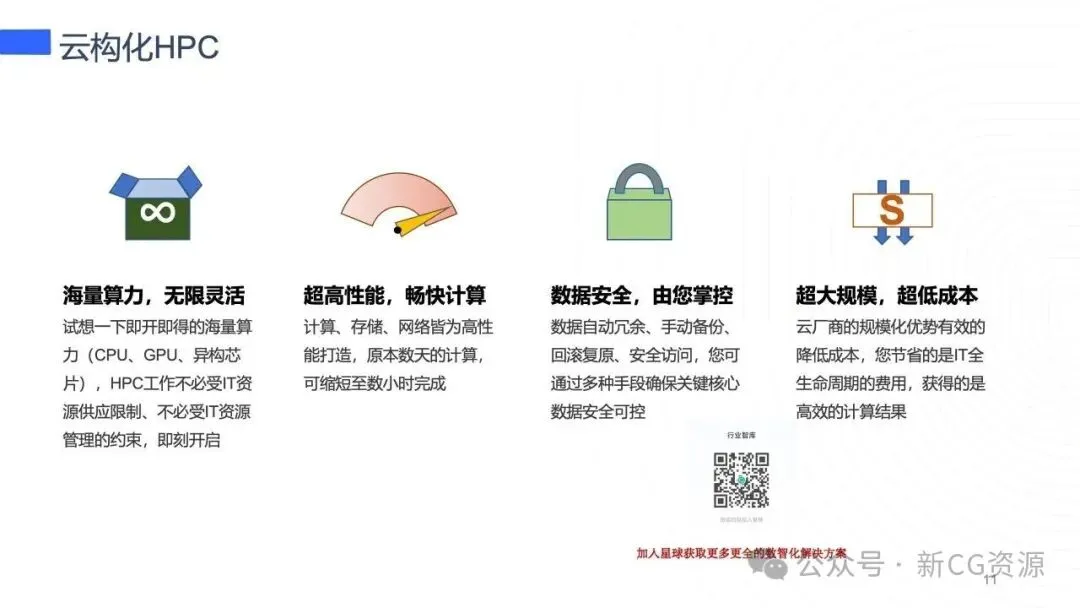
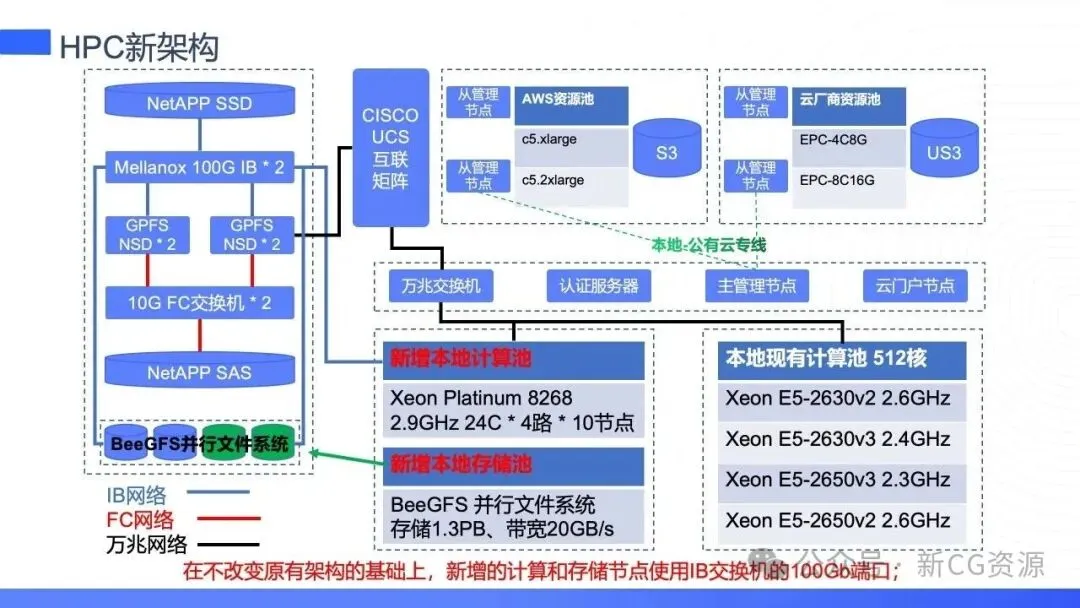
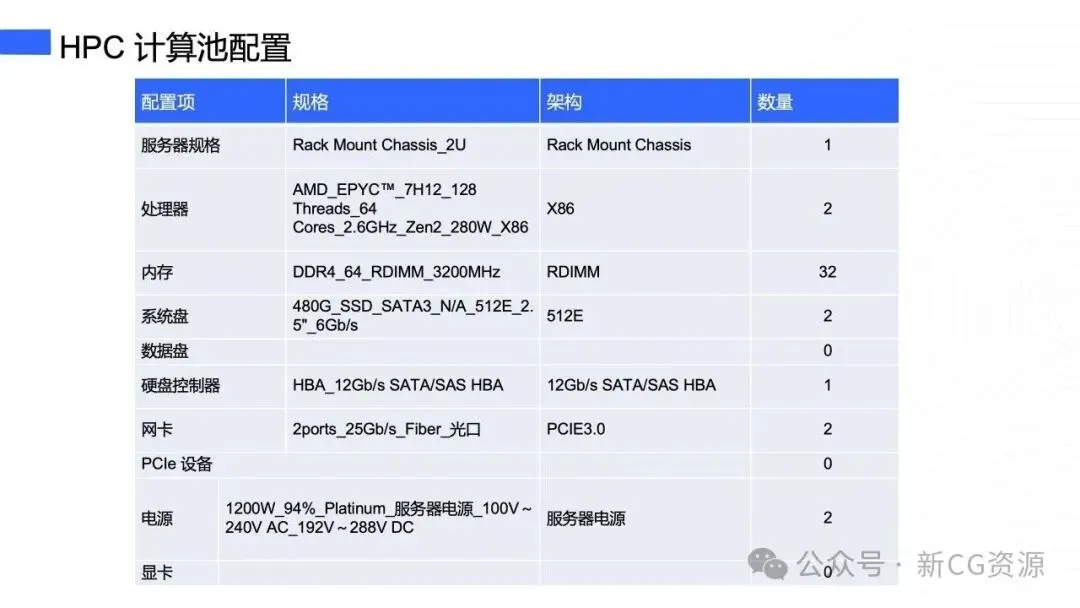
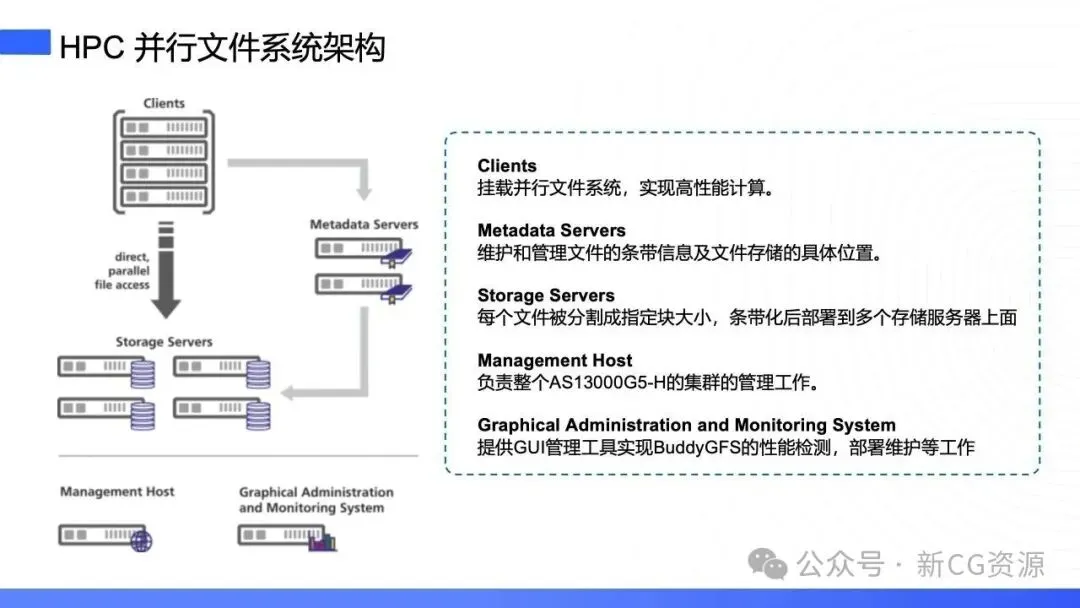
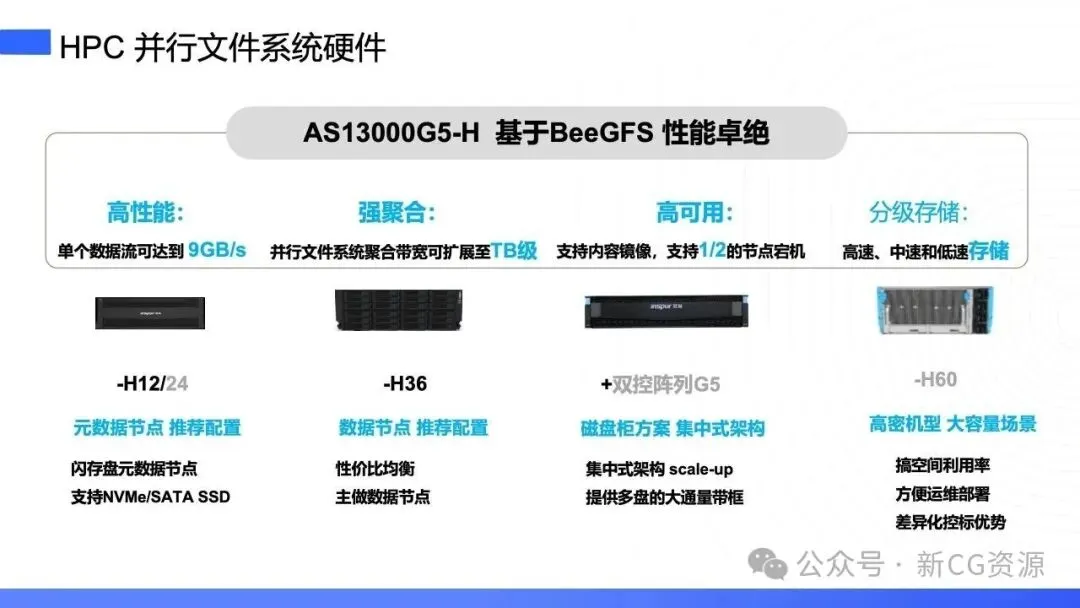
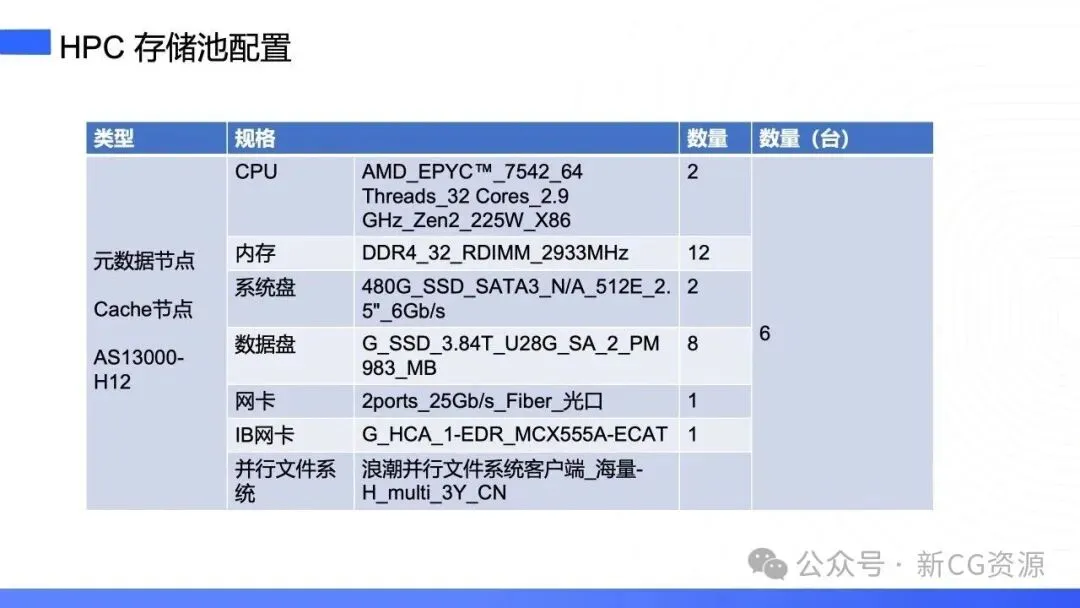
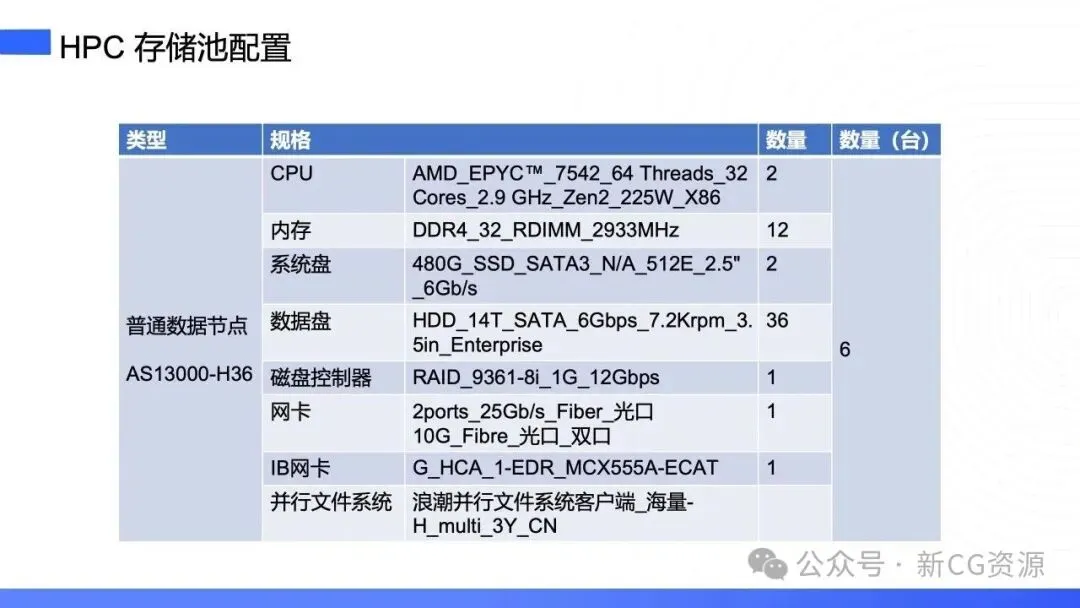
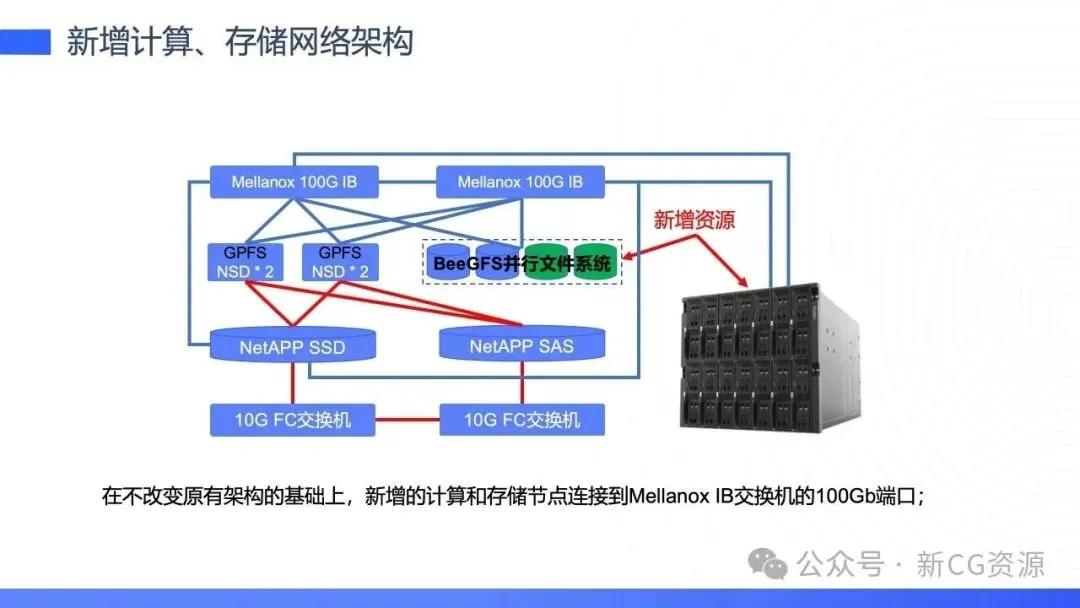
云化HPC 常被理解成把超算整体搬到公有云。这套方案的取向相反,本地集群一台不拆,原有 512 核计算池继续服役,新增的本地计算池用 Xeon Platinum 8268 二十四核四路、十个节点,通过 Mellanox 100G IB 交换机的新增端口并入同一张高速网络,原有 GPFS 与 NetAPP 存储不动。存储侧新上 BeeGFS 并行文件系统,1.3PB 容量、20GB/s 聚合带宽,单条数据流跑到 9GB/s,支持半数节点宕机不停服。这是典型的 scale-out 思路,元数据节点、数据节点、缓存节点分层,容量和带宽按需叠加,不必整机替换。
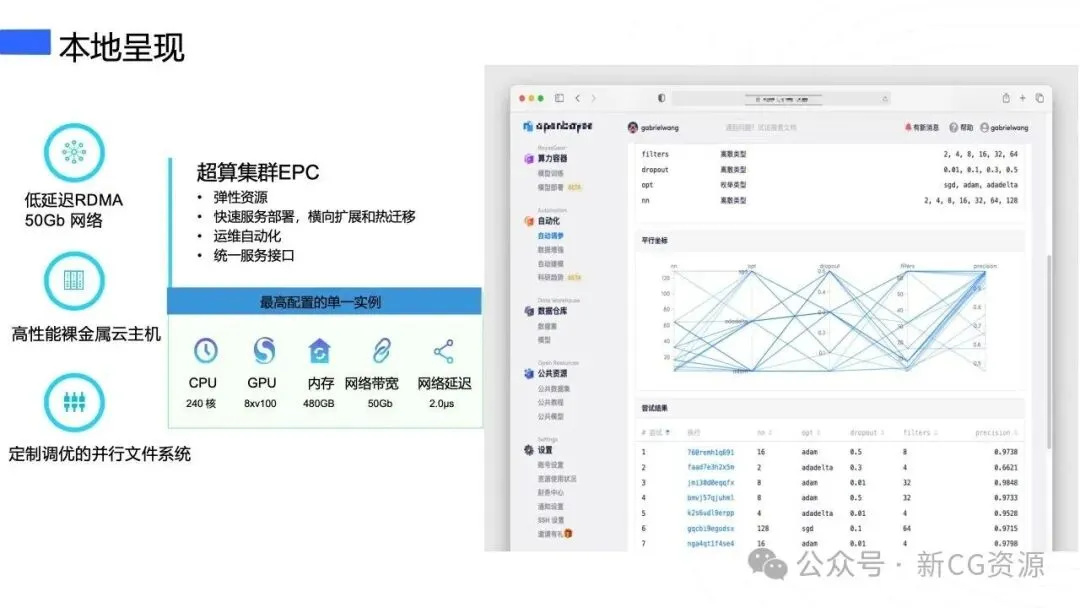
云端提供的是裸金属高性能实例,单实例最高 240 核、8 张 V100、480GB 内存、50Gb RDMA 网络,实测延迟 2.0 微秒,配定制调优的并行文件系统和弹性伸缩。本地与云上各管一段,合成一张算力网的两个池子。
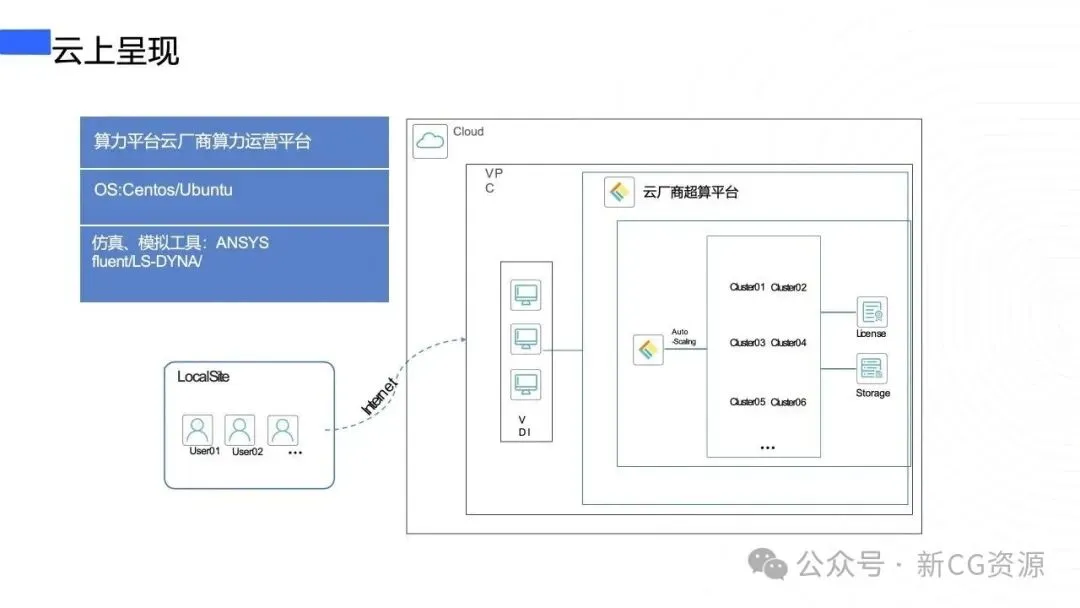
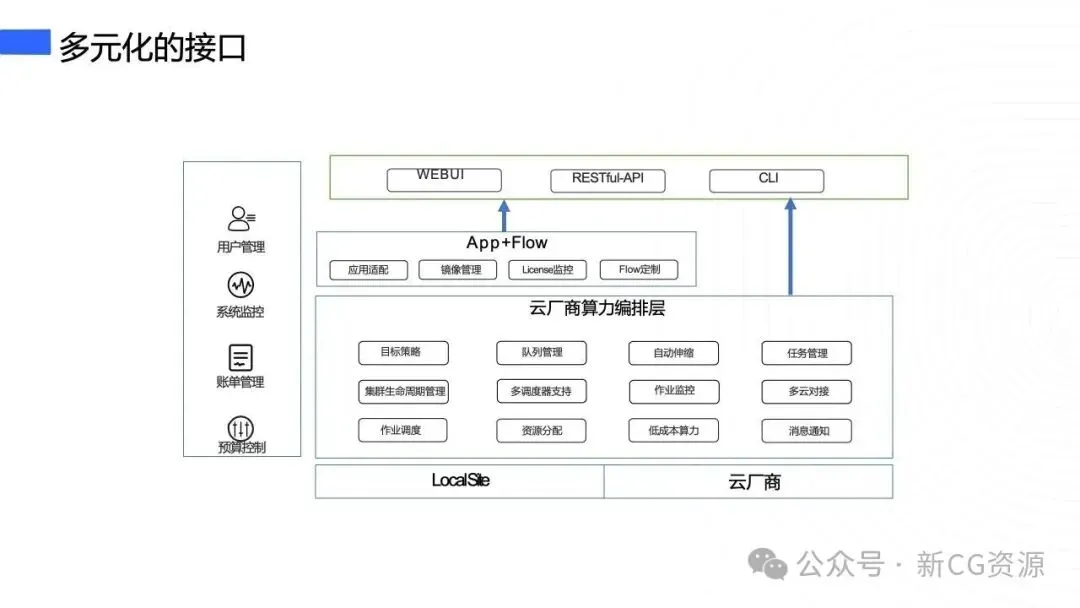
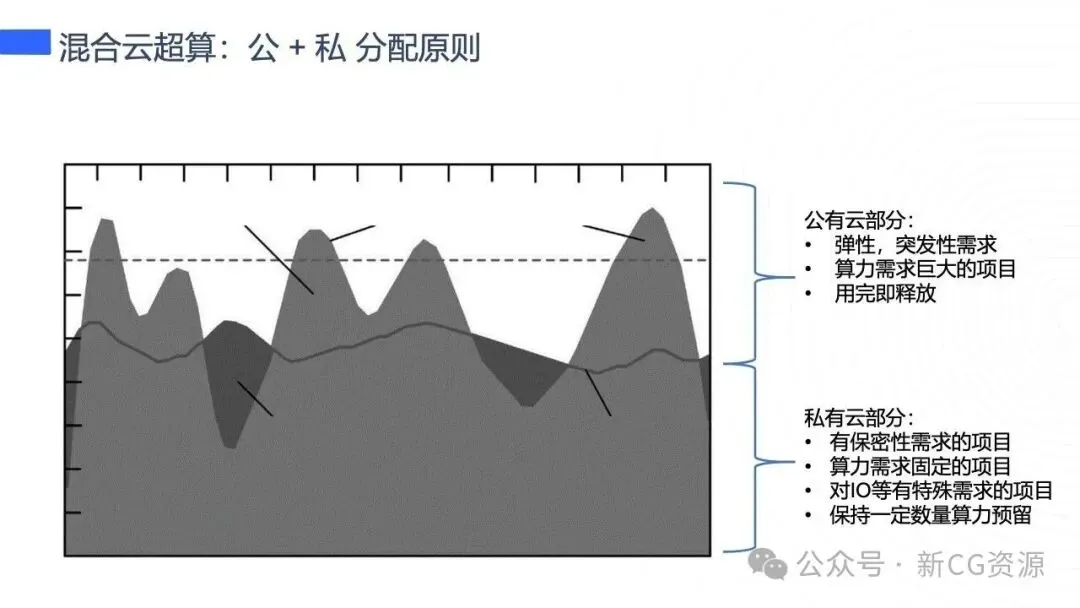
让两个池子连起来的是中间那层算力编排。队列管理、作业监控、集群生命周期、多调度器对接、镜像与 License 监控、自动伸缩全收在一层里,对外只暴露 WEBUI、CLI 和 RESTful 接口。师生通过 VDI 登录,界面上是熟悉的 ANSYS、Fluent、LS-DYNA,底层任务落到哪个池子由策略决定。分配原则写得很直白,有保密要求、算力需求固定、对 IO 有特殊要求的课题留在私有云侧并保持一定预留,弹性突发、算力需求巨大、用完即释放的作业走公有云侧。这条界线划清楚,预算才不会在两套账本之间来回漏。
(二)私有云底座上自主可控与高可靠的工程兑现
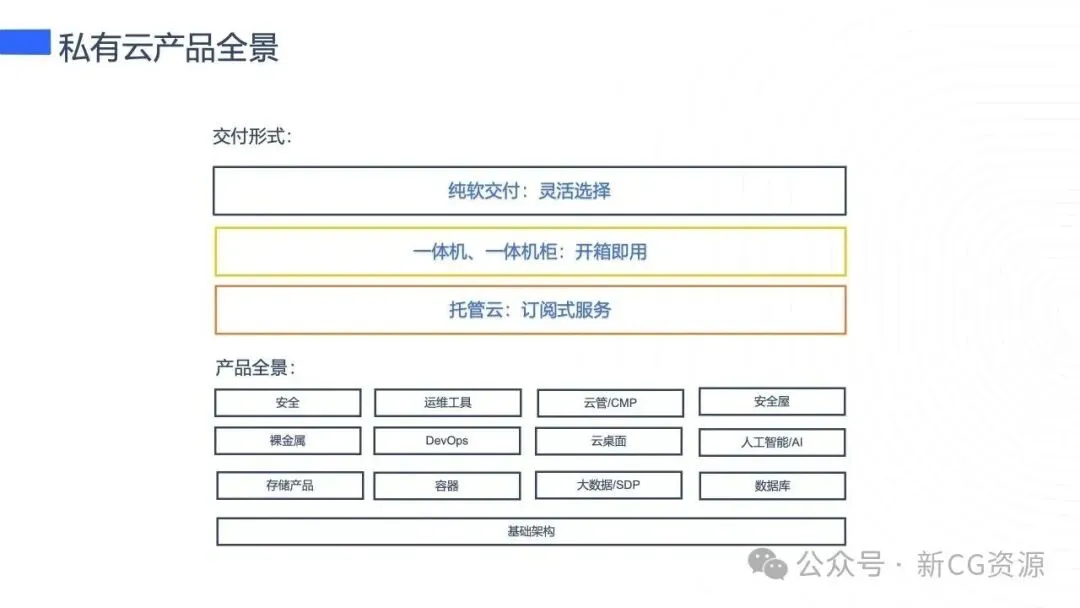
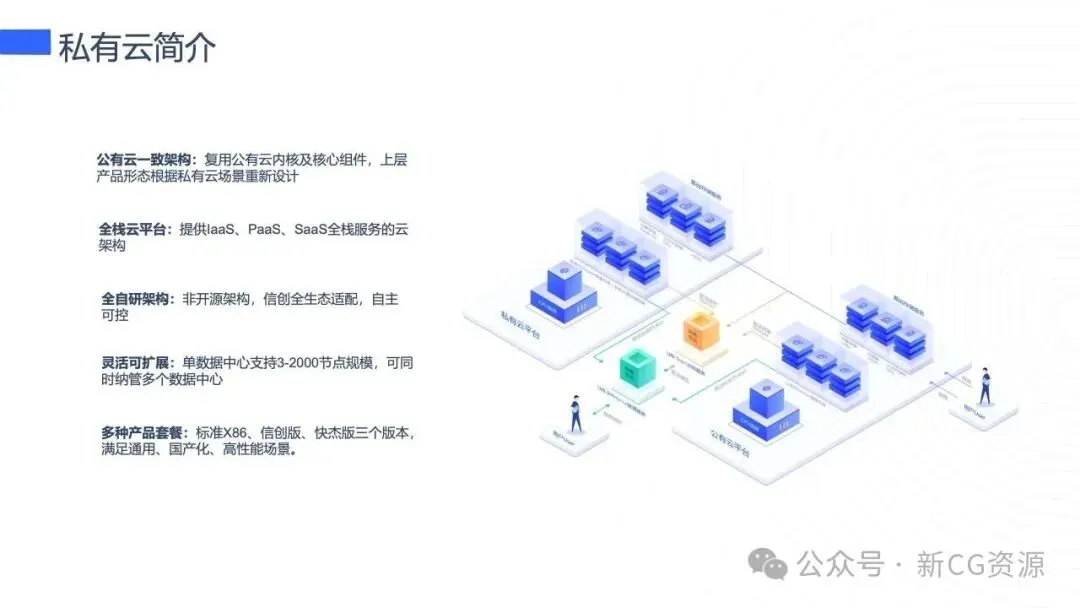
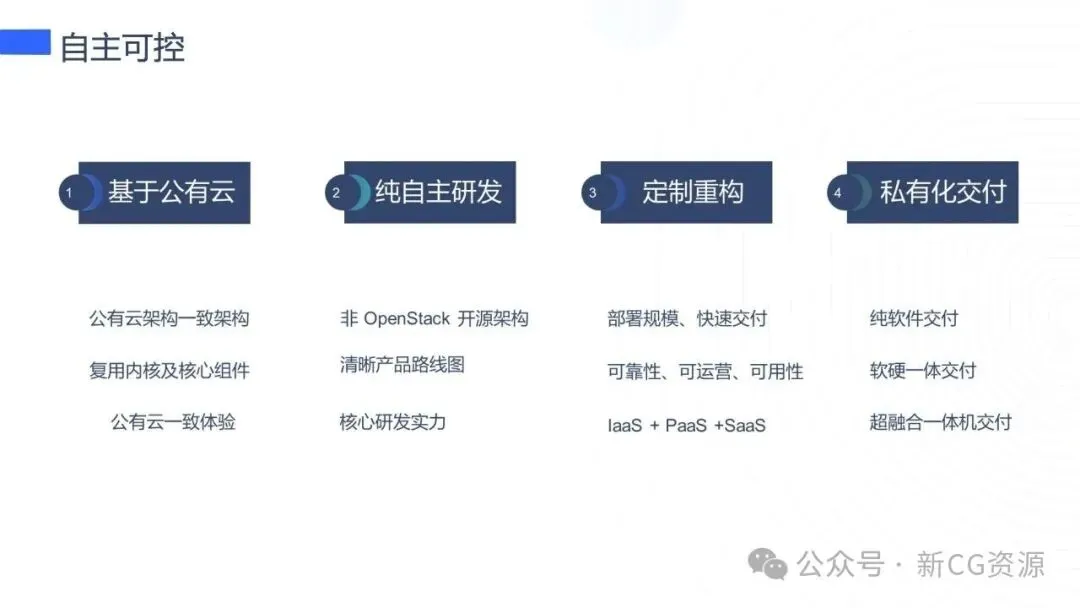
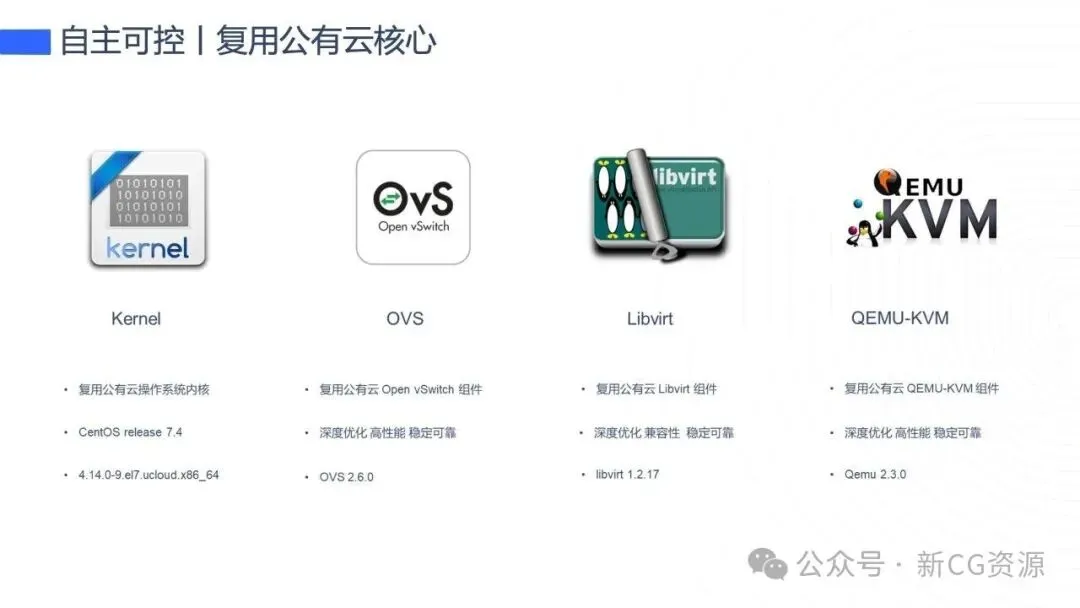
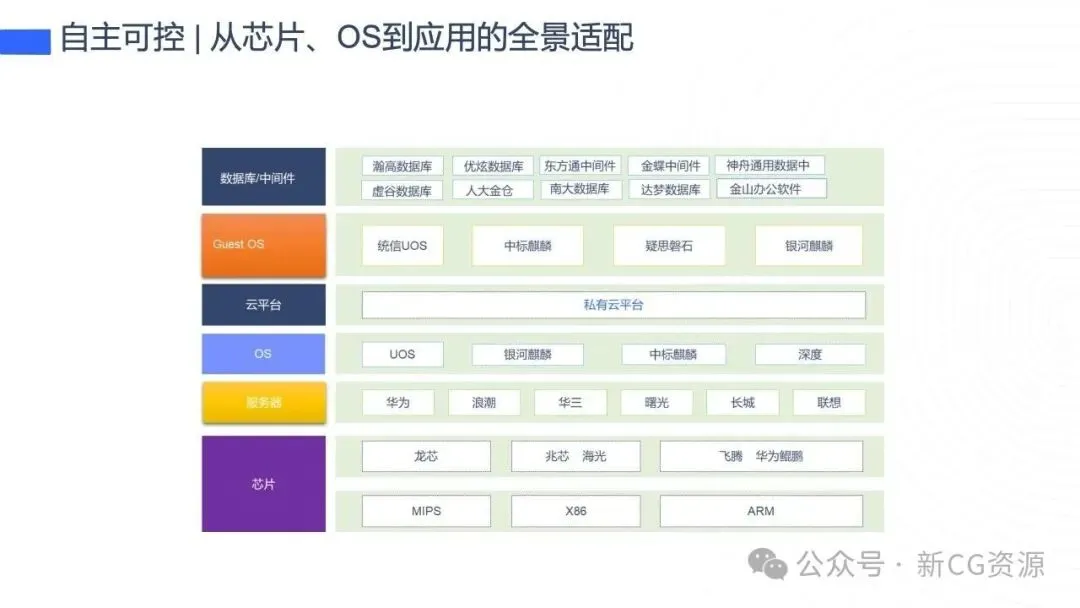
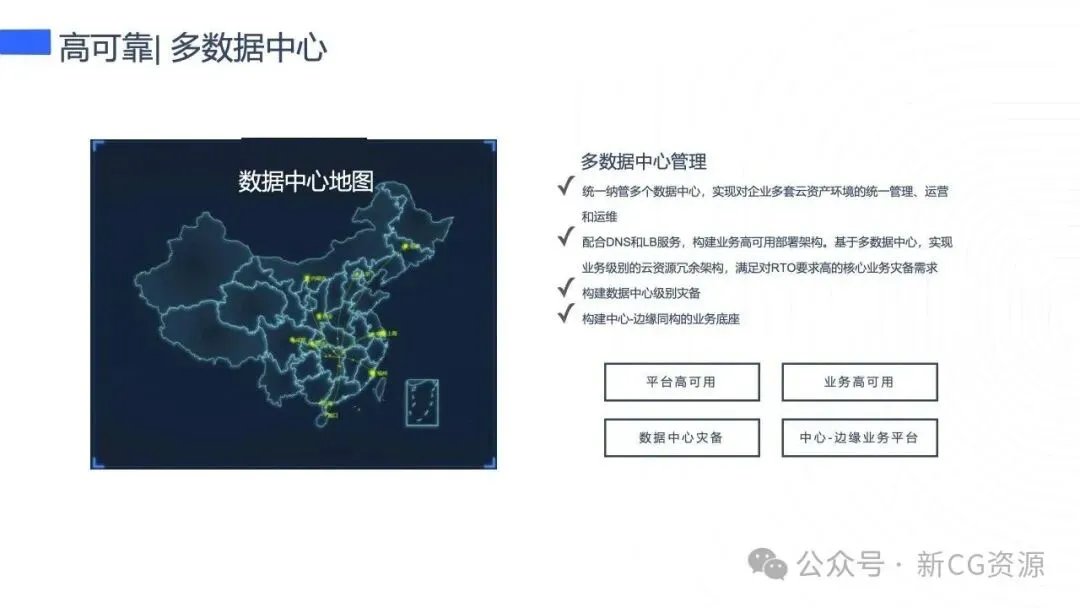
私有云这一层最容易被做成服务器加虚拟化软件的堆叠。这套方案复用了公有云的内核与核心组件,上层产品按私有云场景重新设计,全自研而非开源拼装,单数据中心支持 3 到 2000 节点,可同时纳管多个数据中心,提供标准 X86、信创版、快杰版三套产品形态。从芯片、操作系统到应用做全景适配,信创生态跑得通,核心科研数据才留得住。
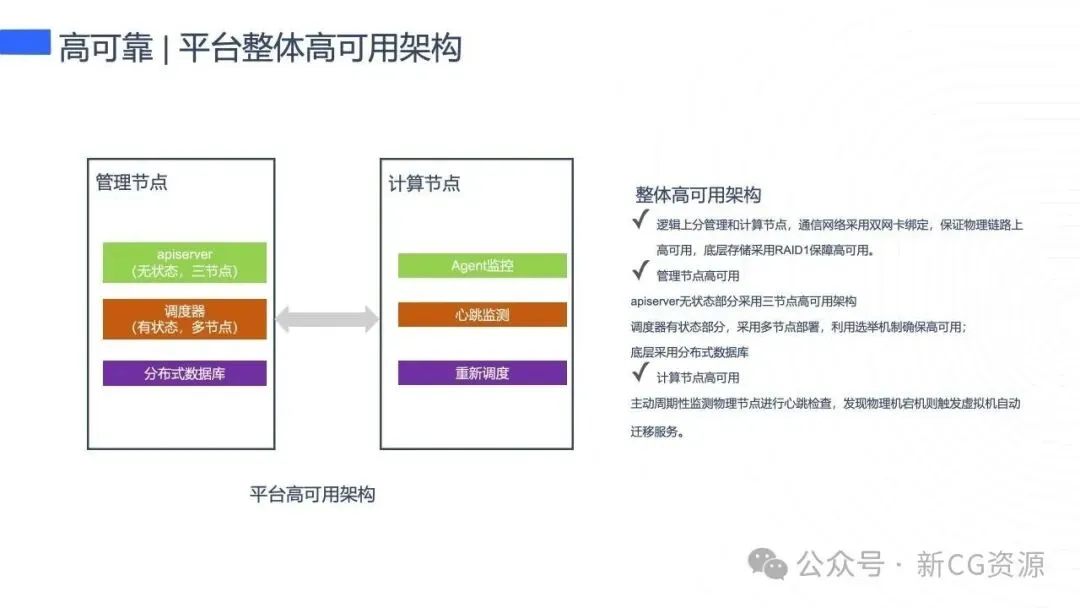
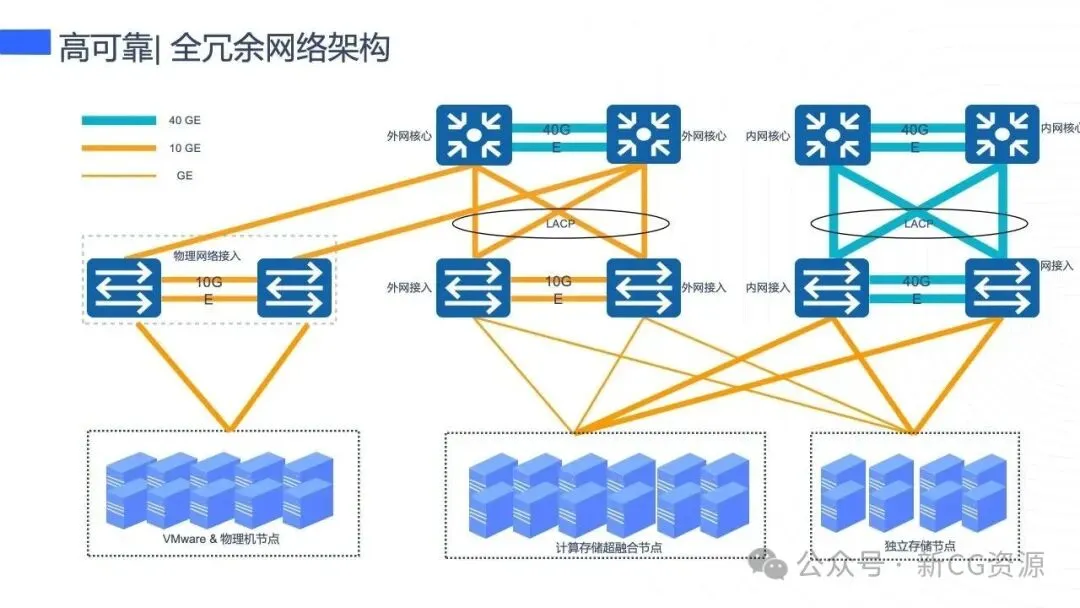
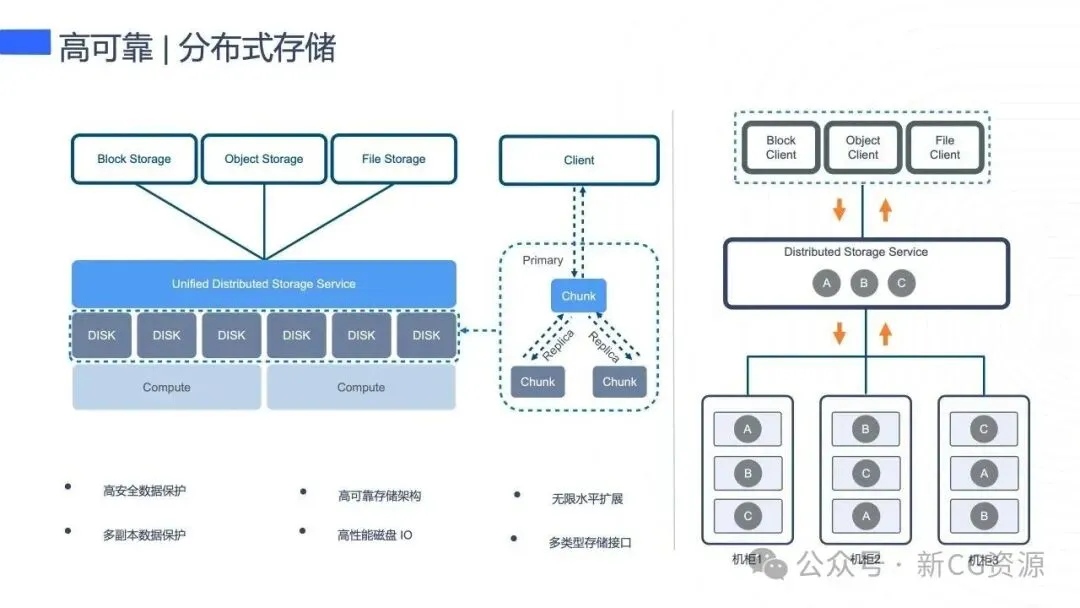
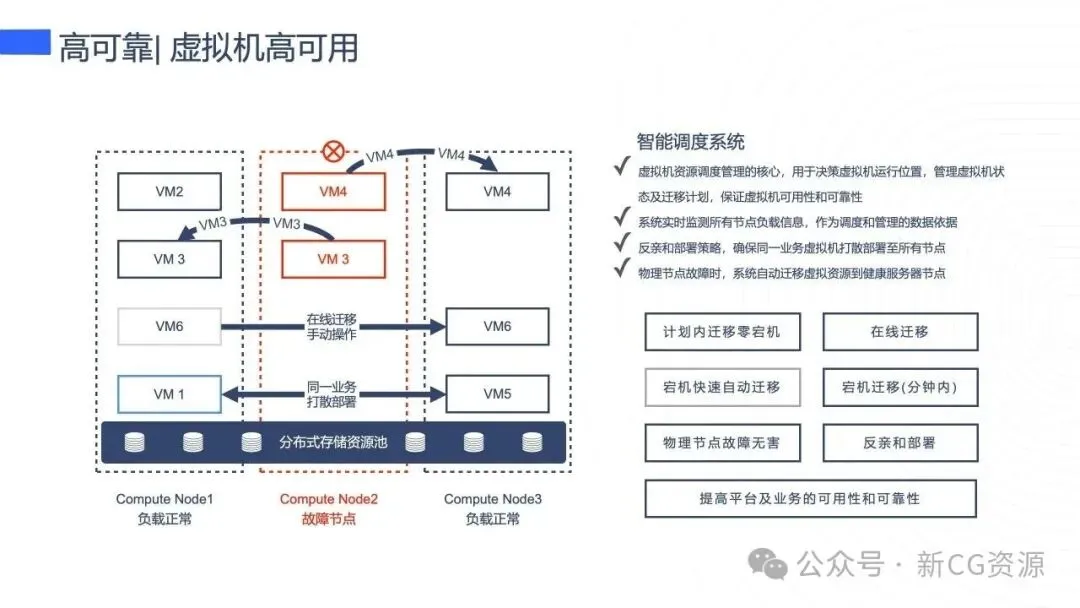
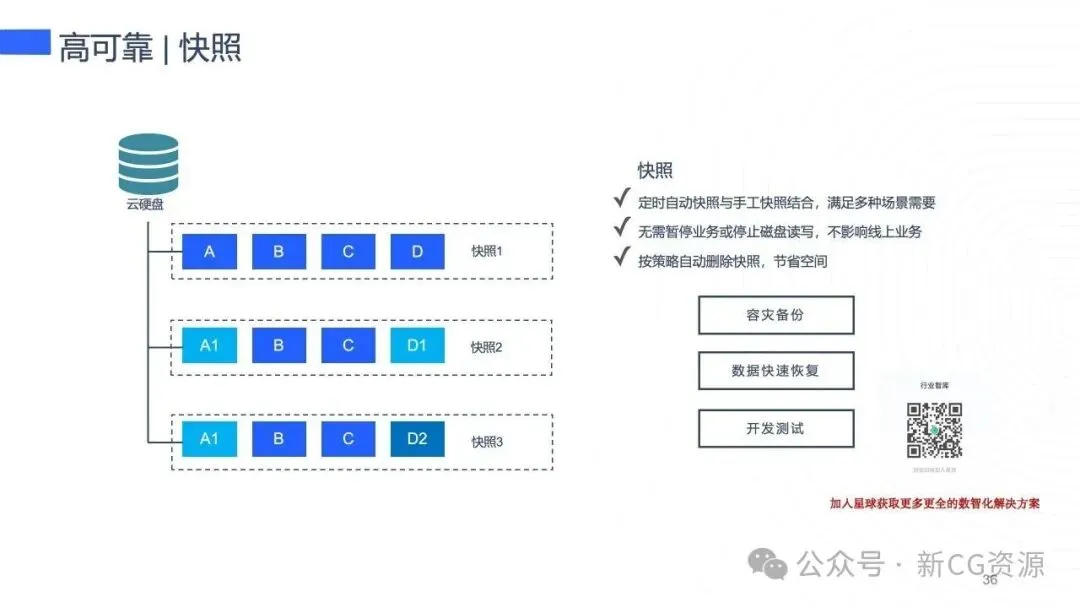
可靠性做在三个层面上。平台层把 apiserver 这类无状态组件做三节点高可用,调度器这类有状态组件多节点部署靠选举机制接管,底层压一套分布式数据库。网络层内外网各配双核心,LACP 链路聚合,40GE 到接入,任何一条链路断开业务不感知。数据层用分布式存储的多副本机制,副本跨机柜打散,配定时自动快照,不需要暂停业务也不影响线上读写。虚拟机层面再补一道,反亲和策略保证同一业务的虚机分散到不同物理节点,节点故障时按心跳判定并触发分钟级自动迁移,计划内维护可以零宕机完成。
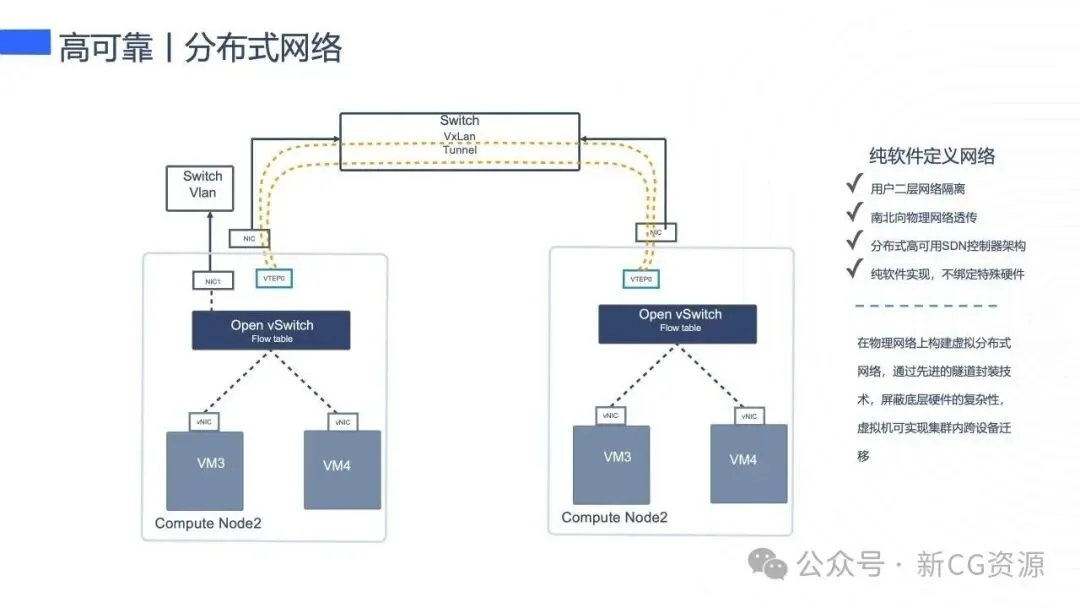
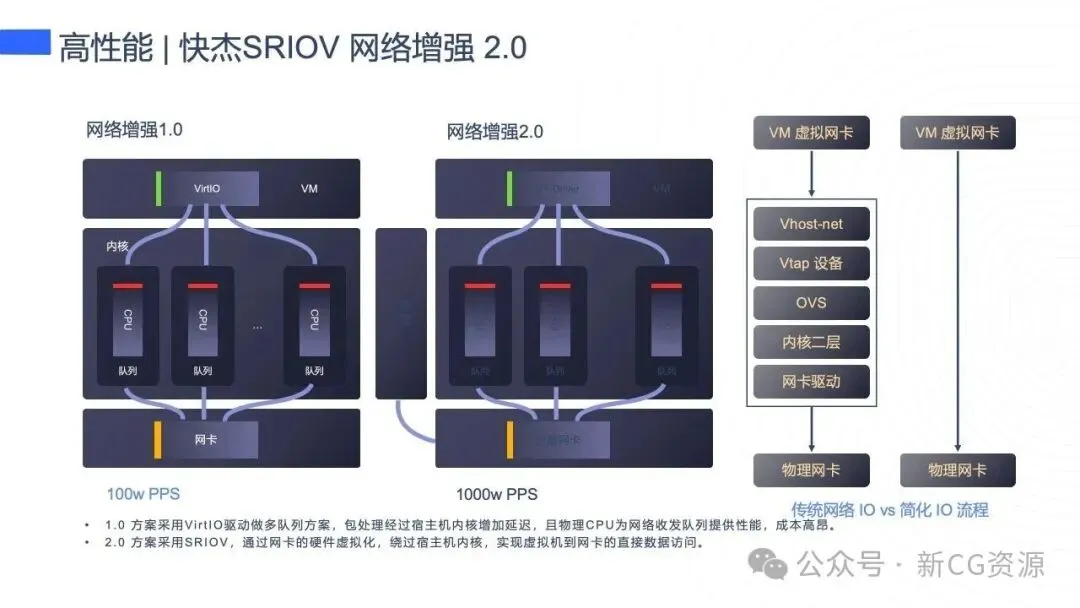
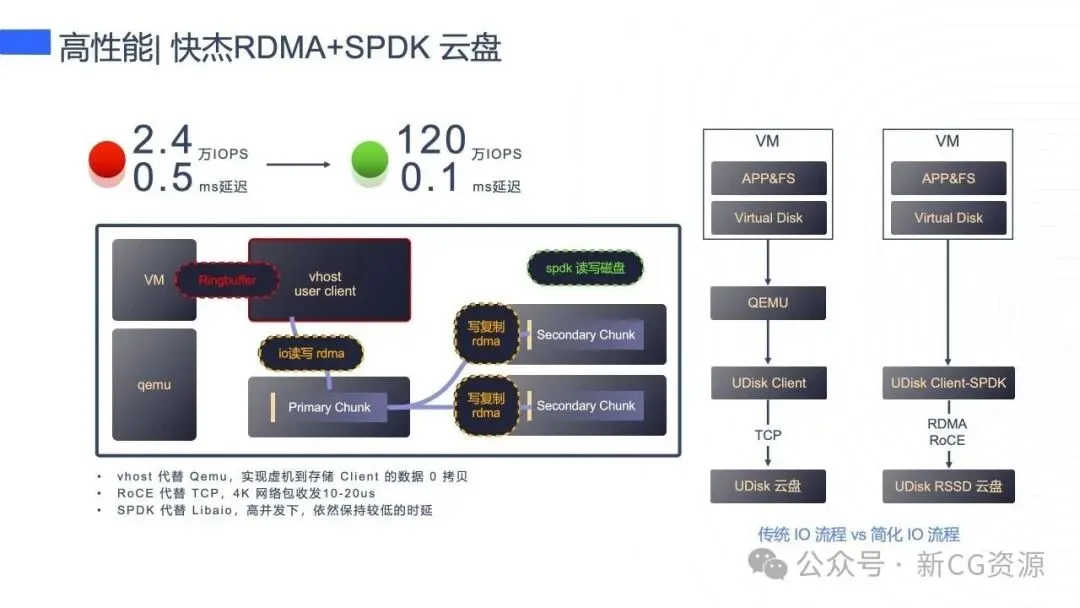
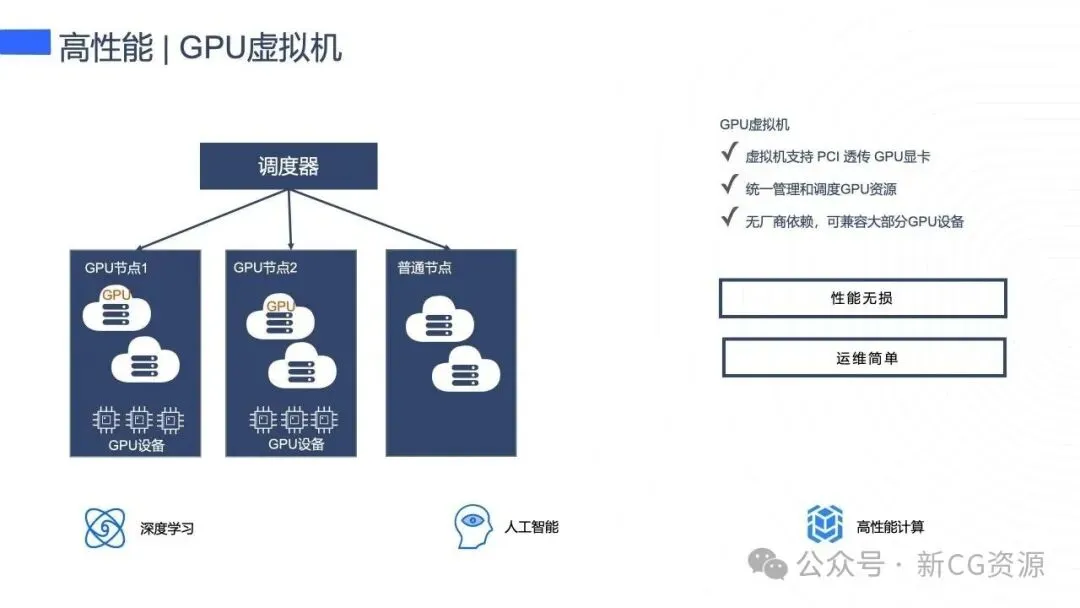
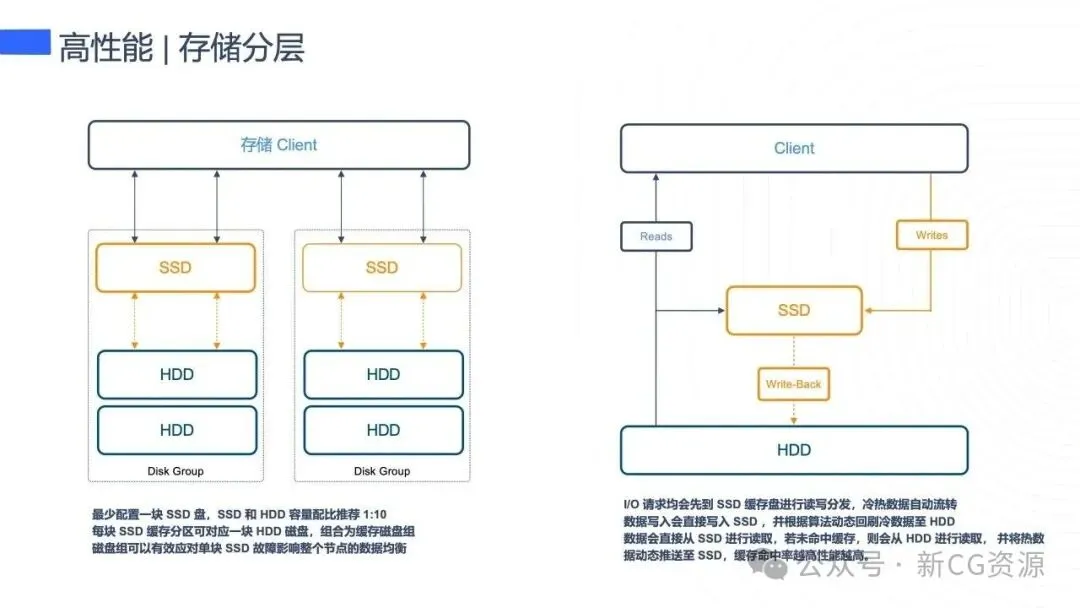
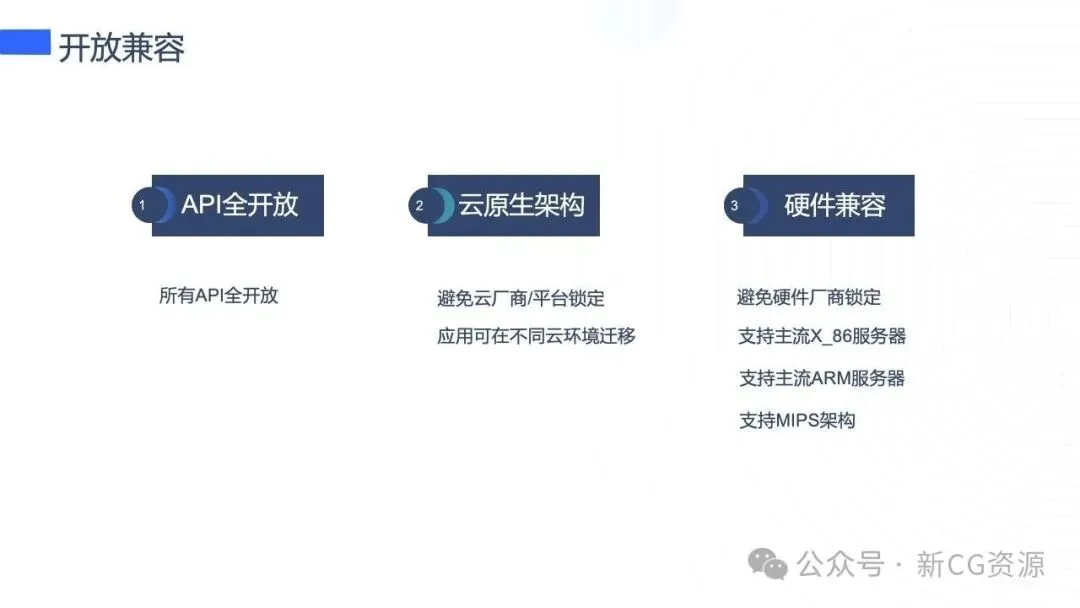
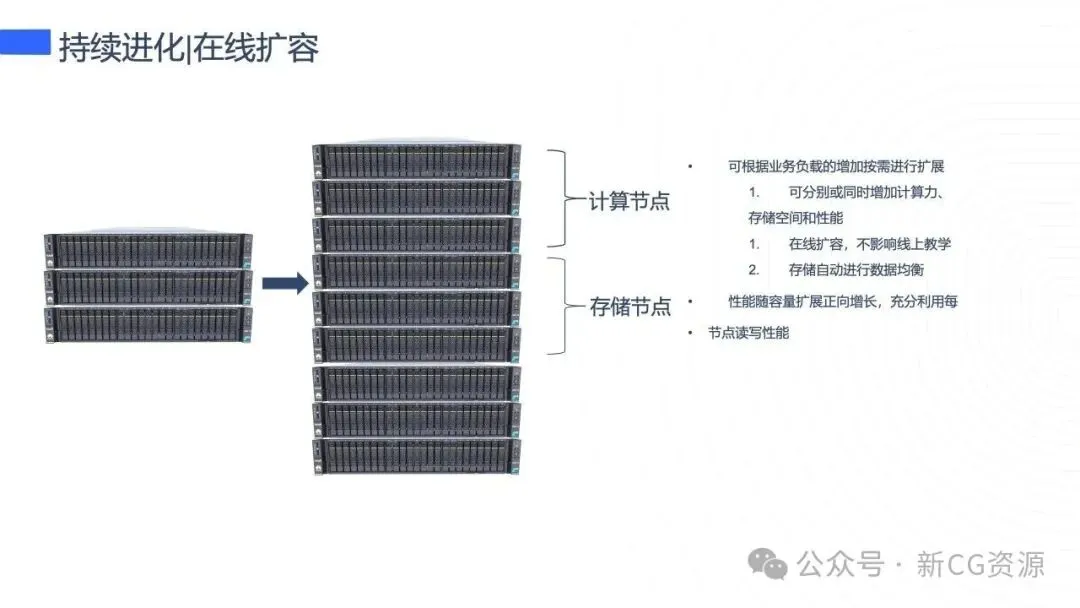
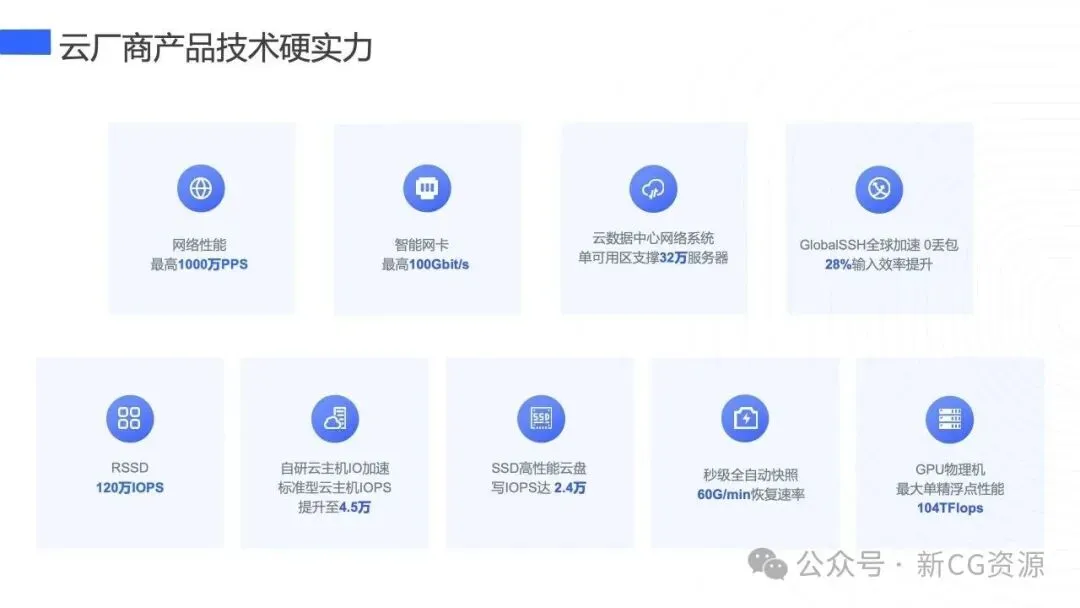
性能上的取舍同样具体。网络走 SRIOV 硬件虚拟化,绕过宿主机内核,包处理从百万级 PPS 提到千万级。云盘走 RDMA 加 SPDK,虚机到存储客户端零拷贝,4K 随机读写从 2.4 万 IOPS、0.5 毫秒延迟,做到 12 万 IOPS、0.1 毫秒。GPU 用 PCI 透传,性能不衰减,也不绑定特定厂商。存储做 SSD 与 HDD 一比十的缓存分层,热点数据自动上浮。开放兼容补上最后一块,API 全开放,x86、ARM、MIPS 都支持,应用换环境不用重写。集群在线扩容不停机,教学季加节点不用等寒暑假。
(三)网络互通与统一管理把多云收敛成一套入口
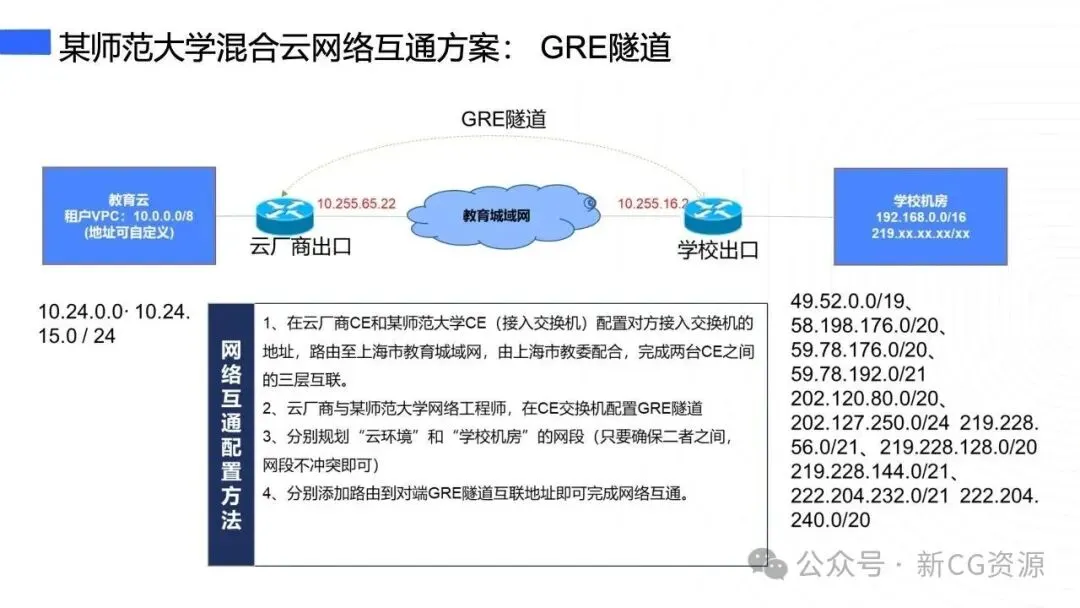
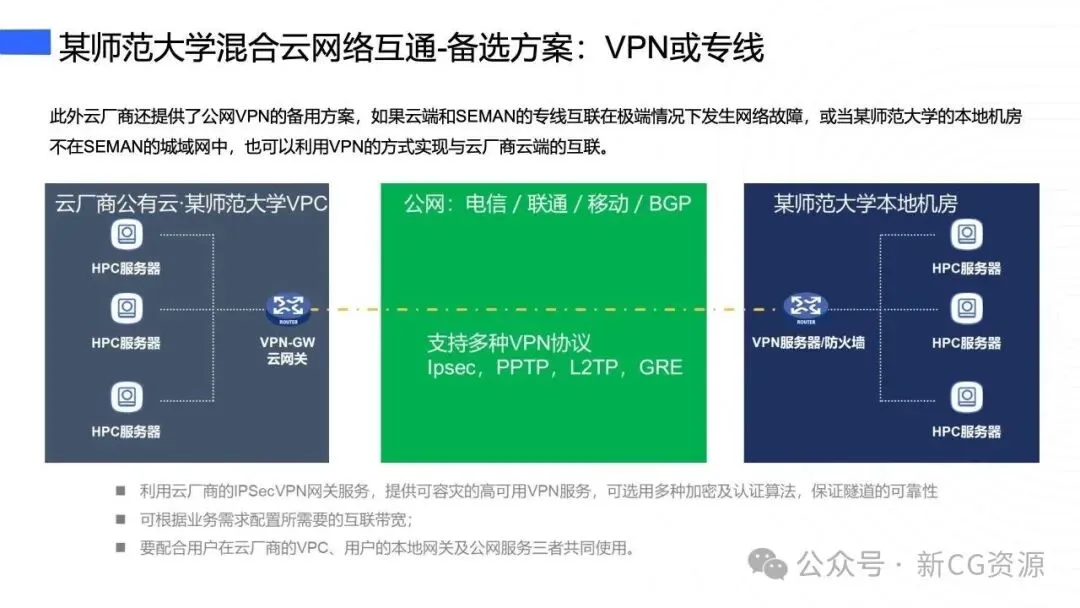
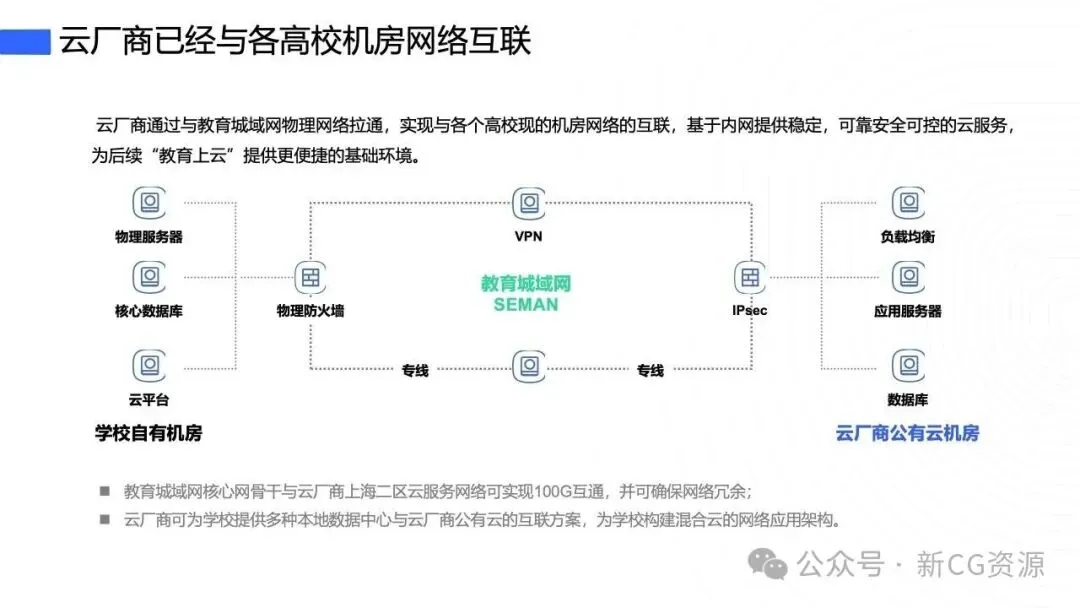
跨云的第一条通道是 GRE 隧道,另备公网 VPN 与专线两条路径。让这条路真正稳的是底层关系,云厂商与教育城域网 SEMAN 已完成物理网络拉通,骨干网与云上区域之间 100G 互通并做冗余,本地机房只要在城域网内,接入就是内网级体验,不必每年为一根专线的价格反复谈判。
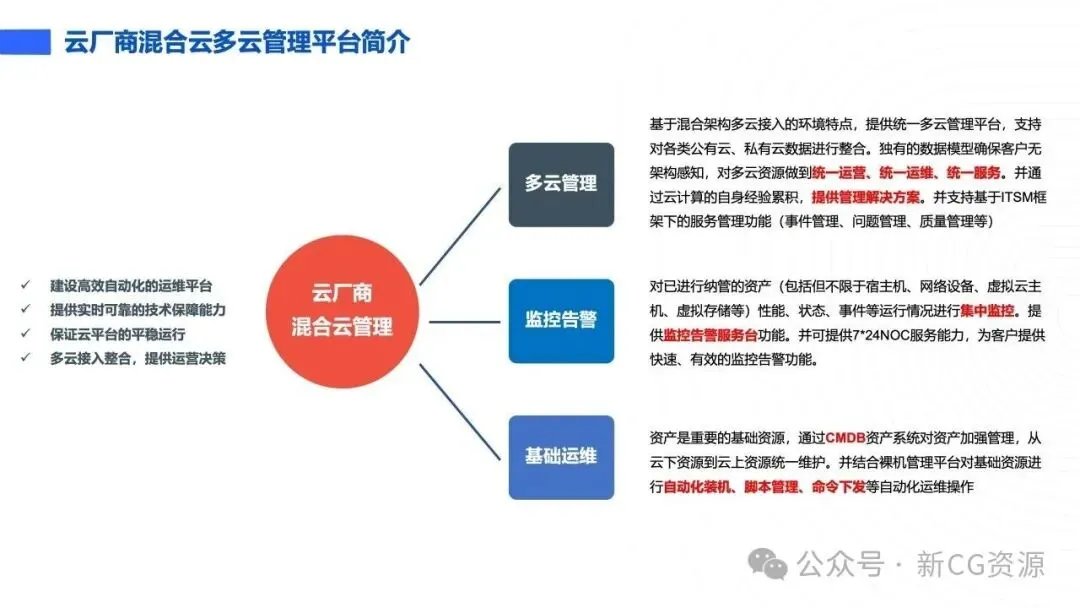
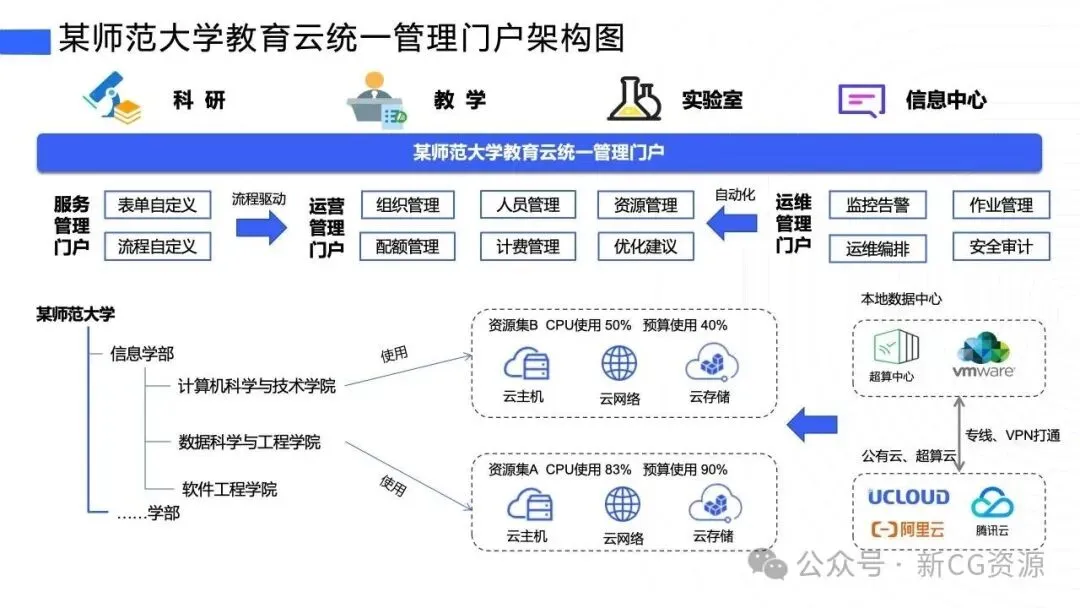
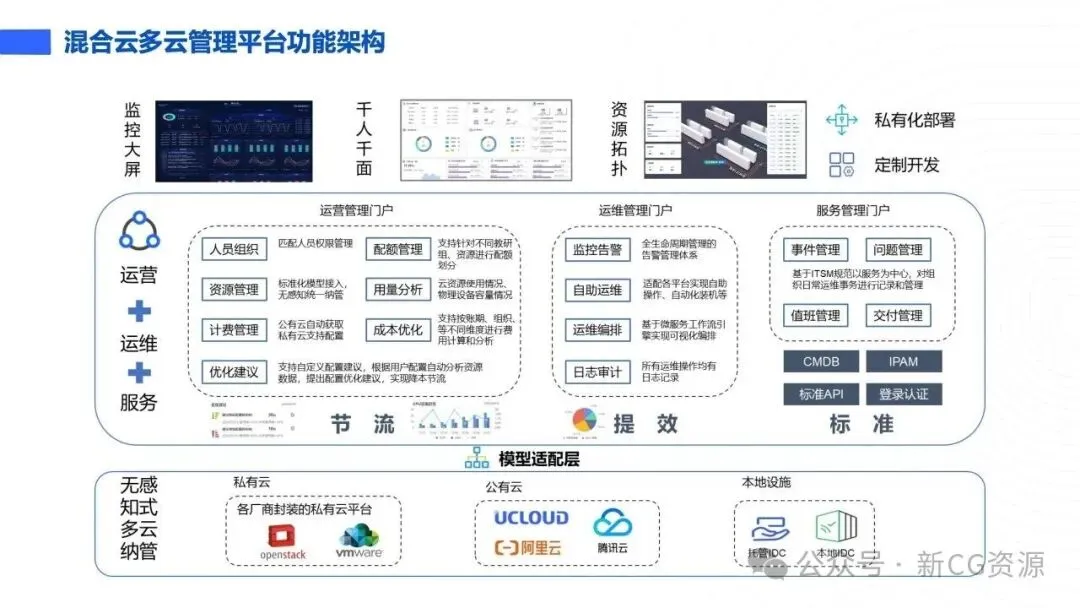
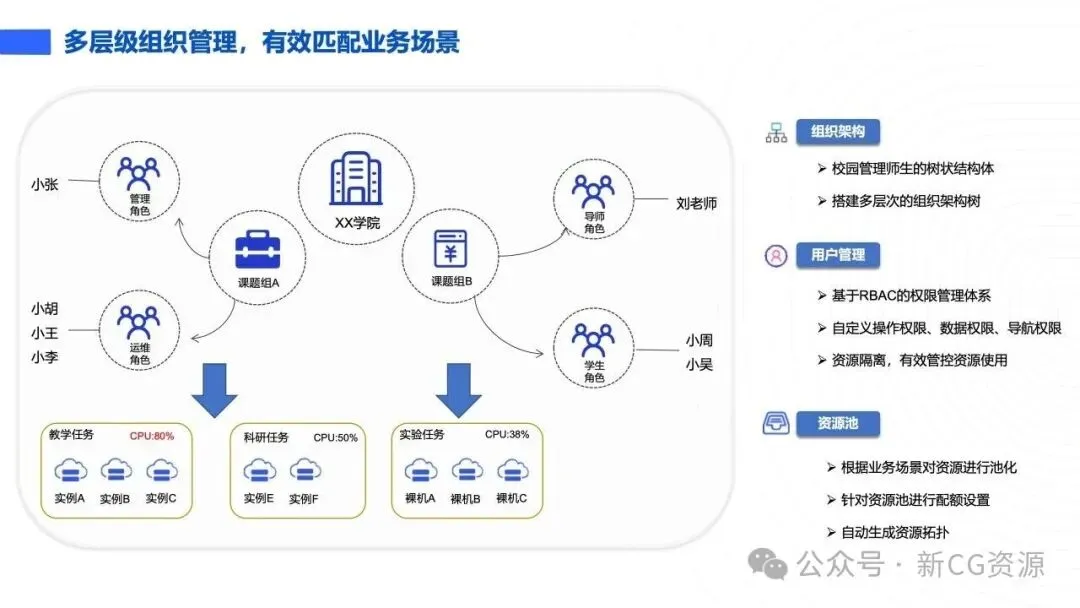
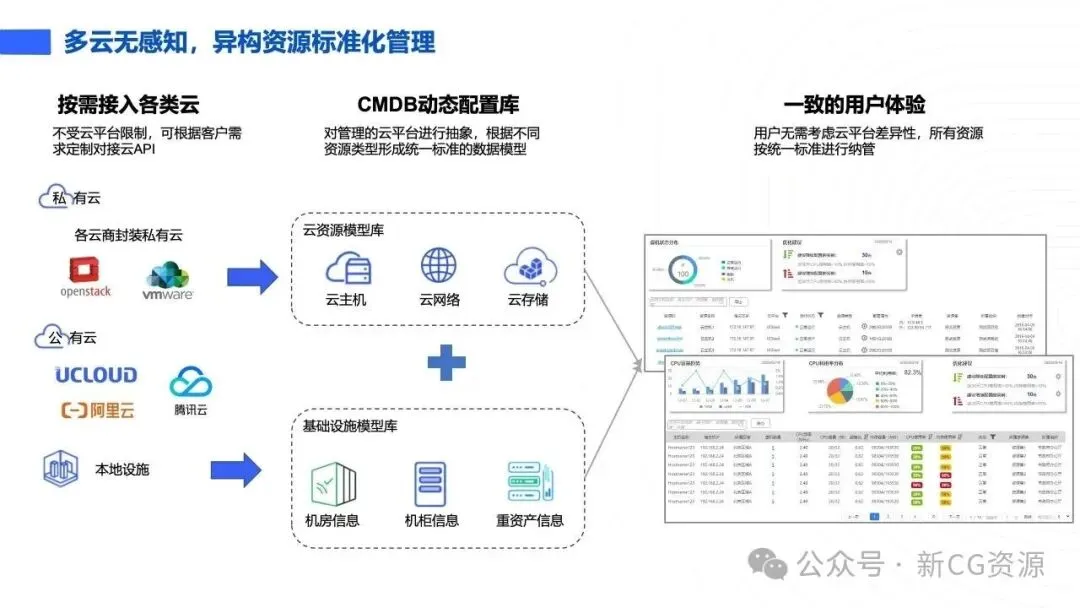
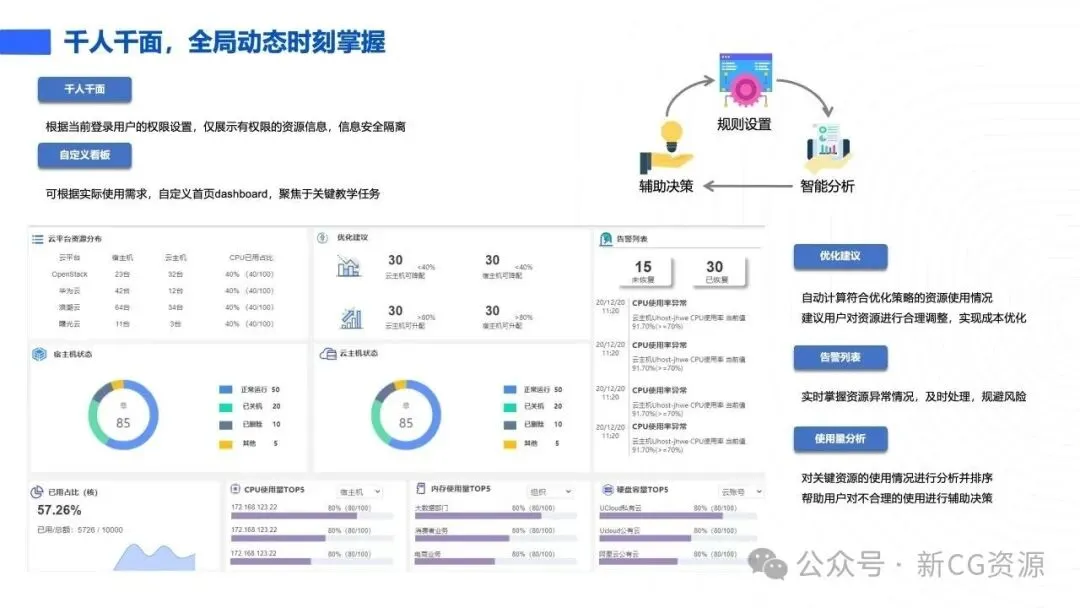
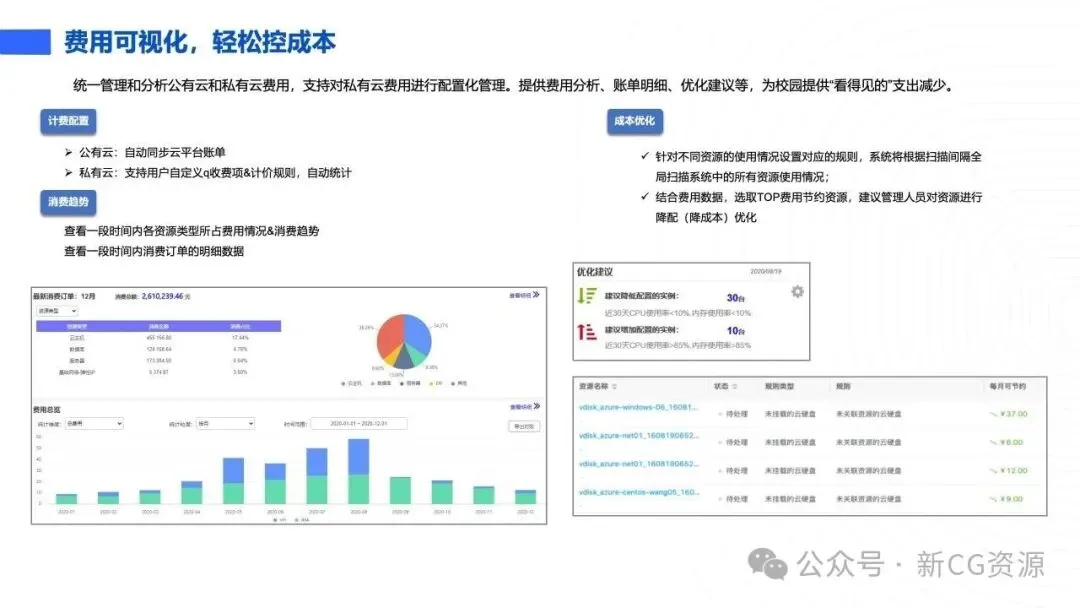
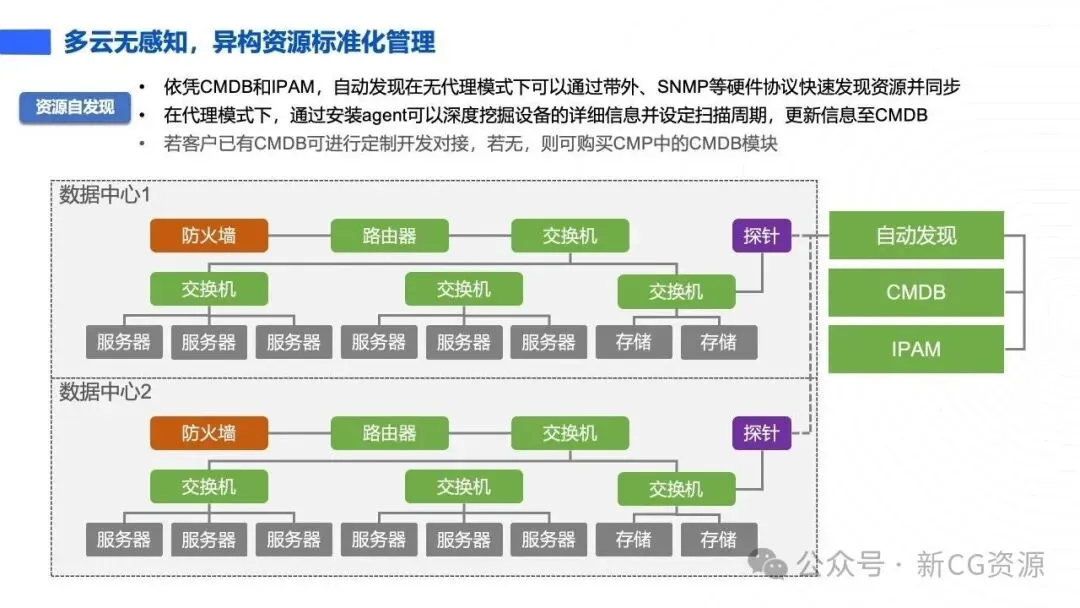
管理侧建的是统一门户,服务门户、运营门户、运维门户三套视图对应三类角色。底层用 CMDB 统一数据模型把私有云、公有云和本地设施抽象成同一套资源语言,不同云平台的差异被吃在模型里,师生不必知道自己用的是哪一朵云。组织管理按校园的树状结构搭,学院、课题组、导师、学生各有角色,基于 RBAC 分配操作、数据、导航三类权限,资源池按业务场景切分并设配额。首页看板千人千面,只显示有权限的资源,费用侧把公有云账单自动同步、私有云自定义计费项,系统扫出高耗低效的资源并给出降配建议。
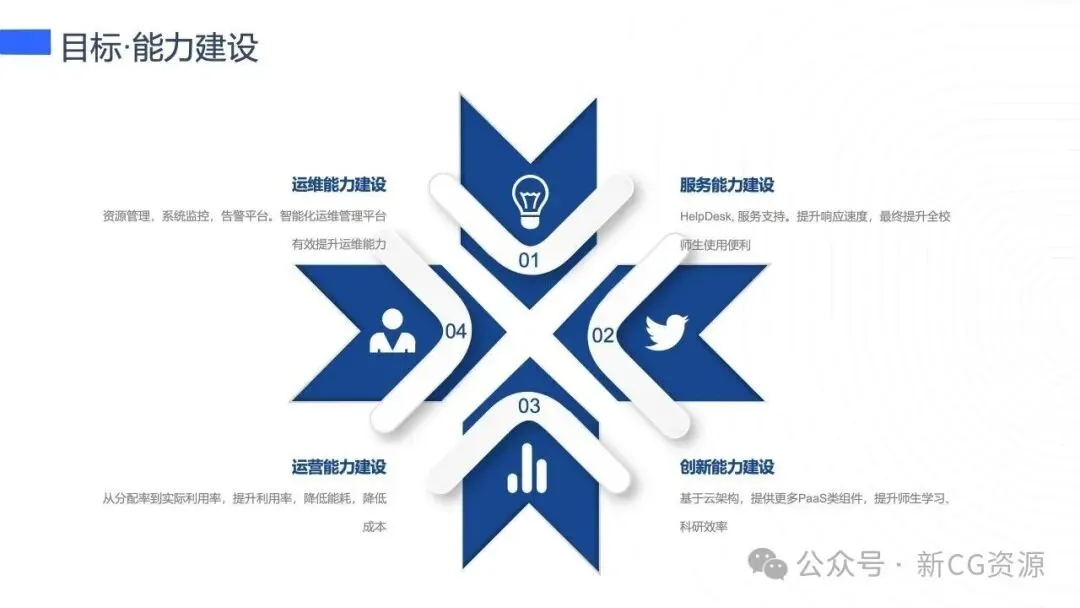
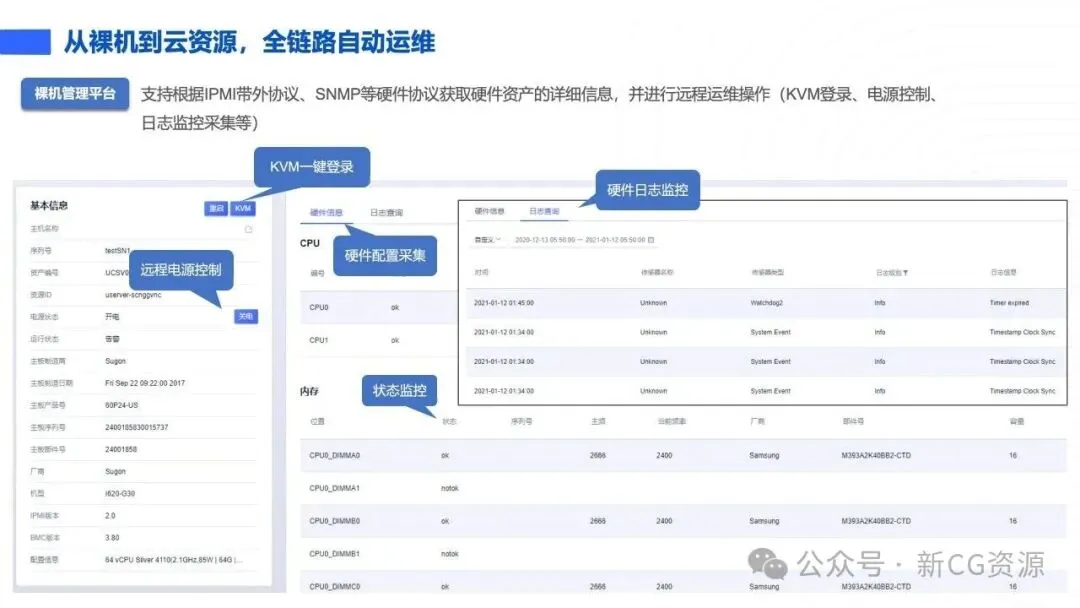
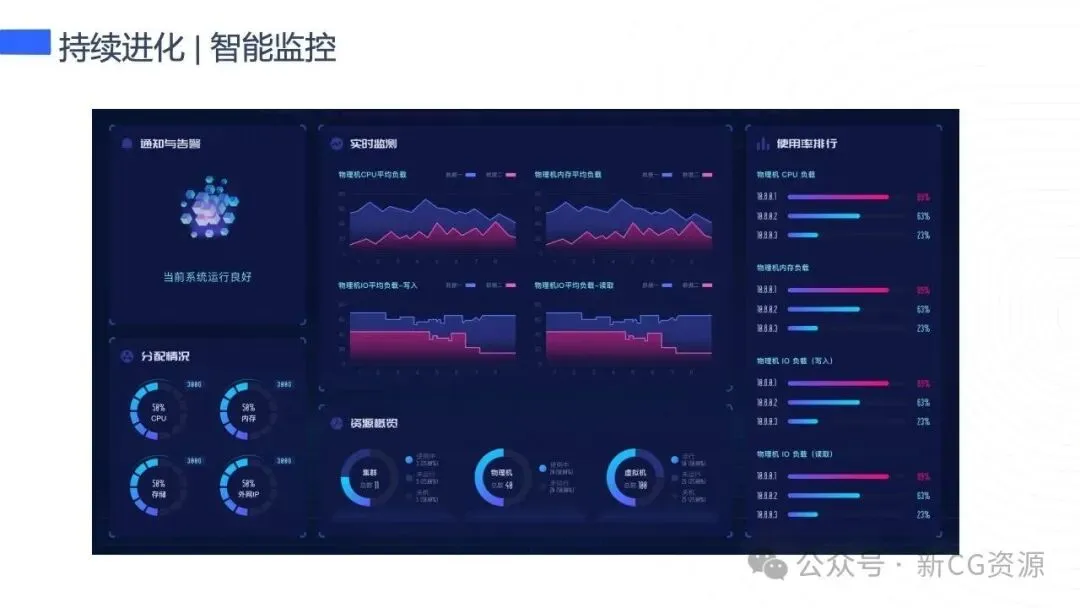
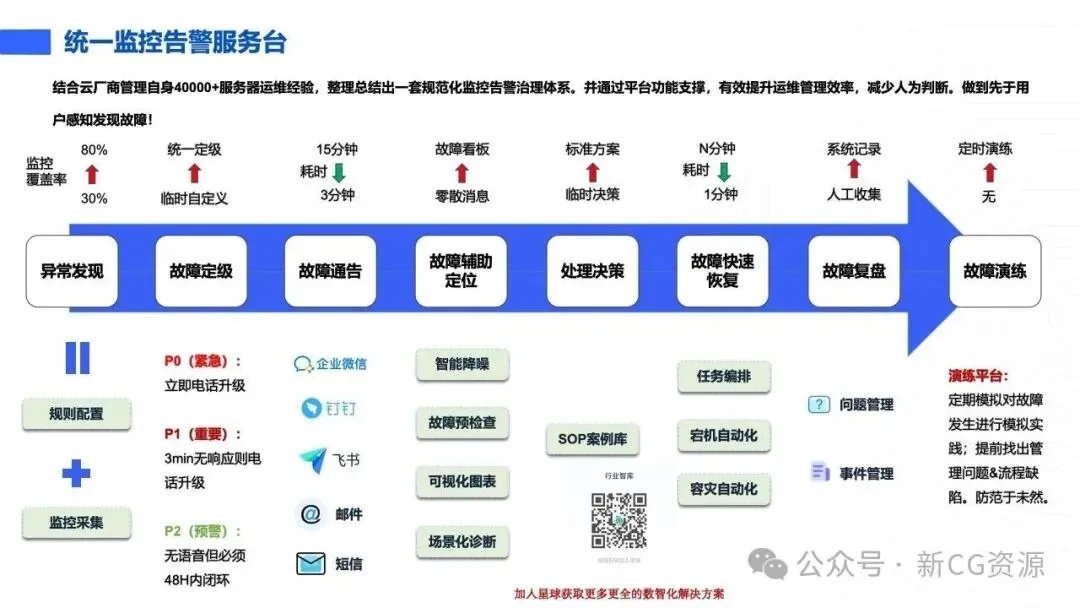
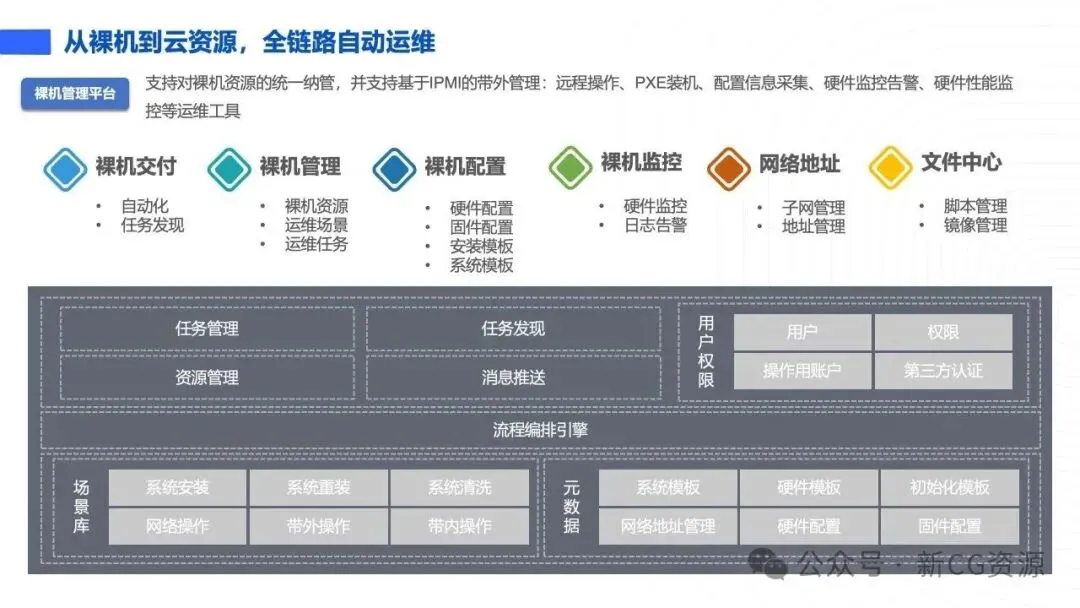
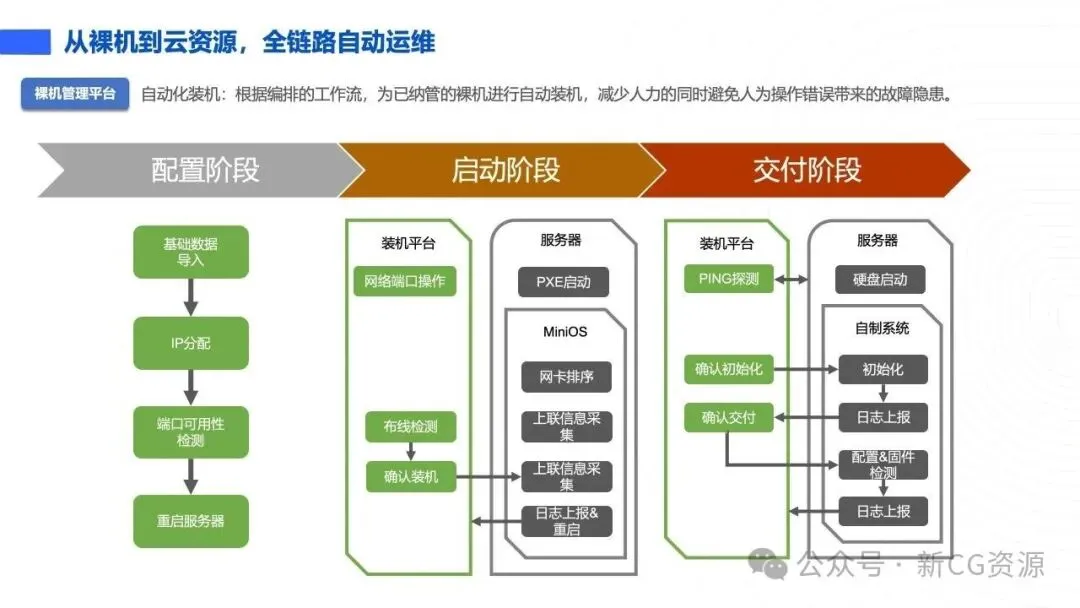
监控与运维是这套平台里最见功力的部分。故障按 P0、P1、P2 三级定级,紧急事件立即电话升级,三分钟内无响应自动升级,监控覆盖率做到八成,定级时间从人工收集压到三分钟。背后是 SOP 案例库、智能降噪、容灾自动化和定期故障演练,这套体系是从运维数万台服务器的经验里沉淀出来的。裸机侧另有管理平台,基于 IPMI 带外协议做远程开关机、KVM 登录、固件与配置采集,PXE 自动装机把上架到交付的整条链路串成工作流,装机完成后再交给云管平台接管。
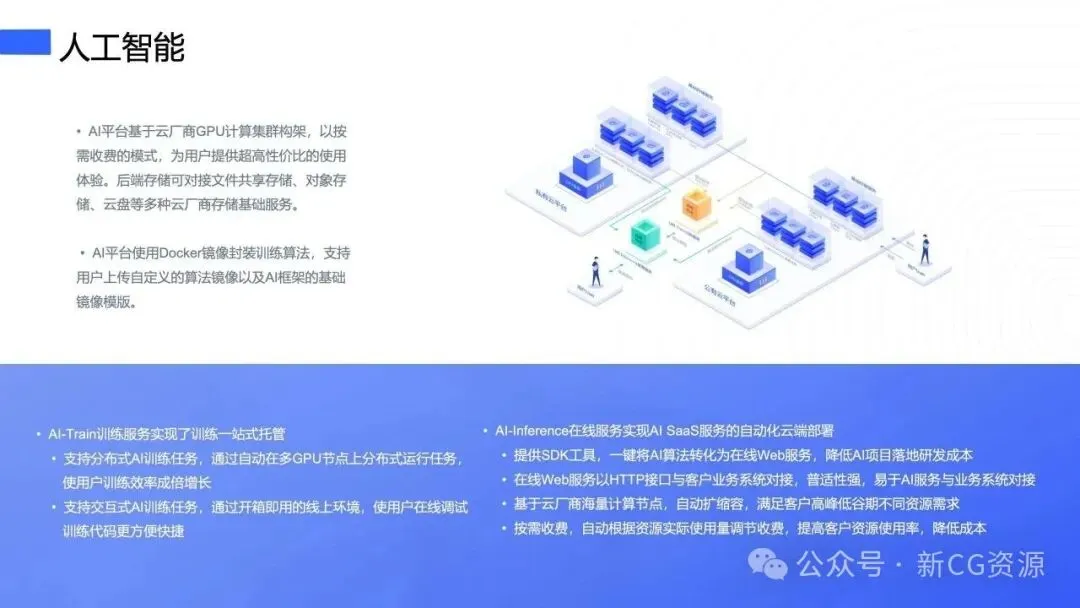
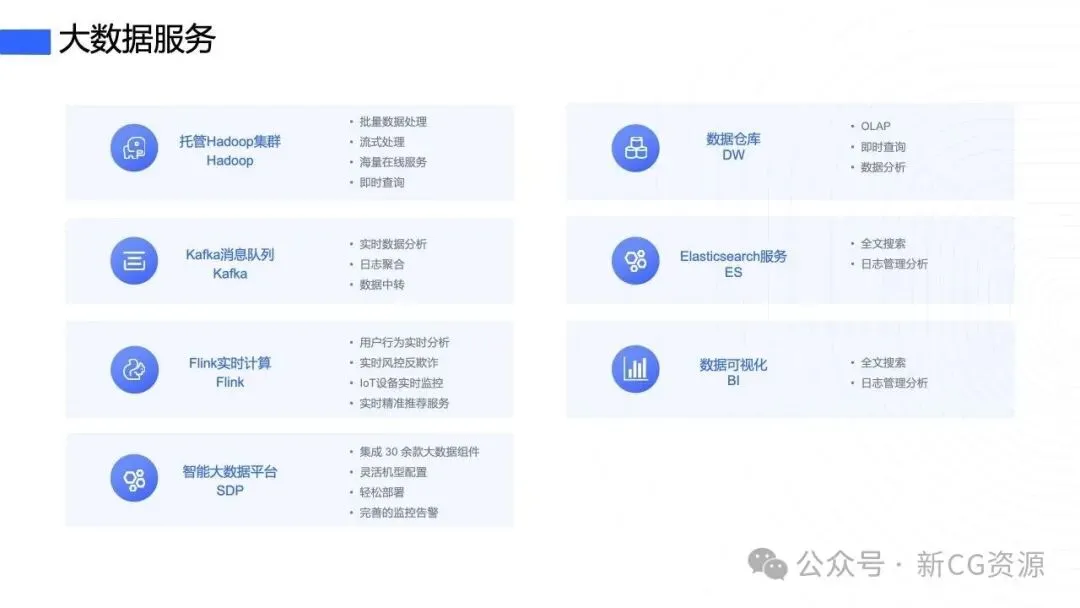
底座的另一层价值在增值服务上。超算中心建好之后,机器学习训练、数据分析和可视化这类需求会顺着算力自然长出来。AI 平台基于同一套 GPU 集群按量计费,用 Docker 镜像封装算法,训练任务支持分布式并行和交互式在线调试,推理服务能通过 SDK 一键转成 HTTP 接口挂到业务系统上。大数据侧提供托管 Hadoop、Kafka、Flink、数据仓库、Elasticsearch 和 BI 工具,三十余款组件按需组合。学校不必为每个新需求单独立项采购,这是集约化建设最实在的红利。
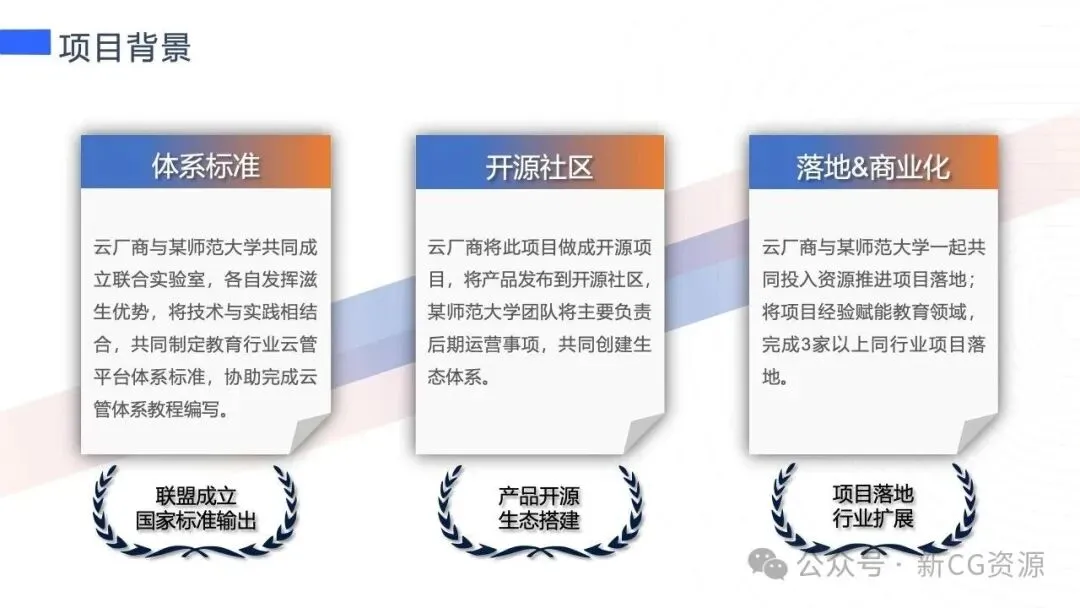
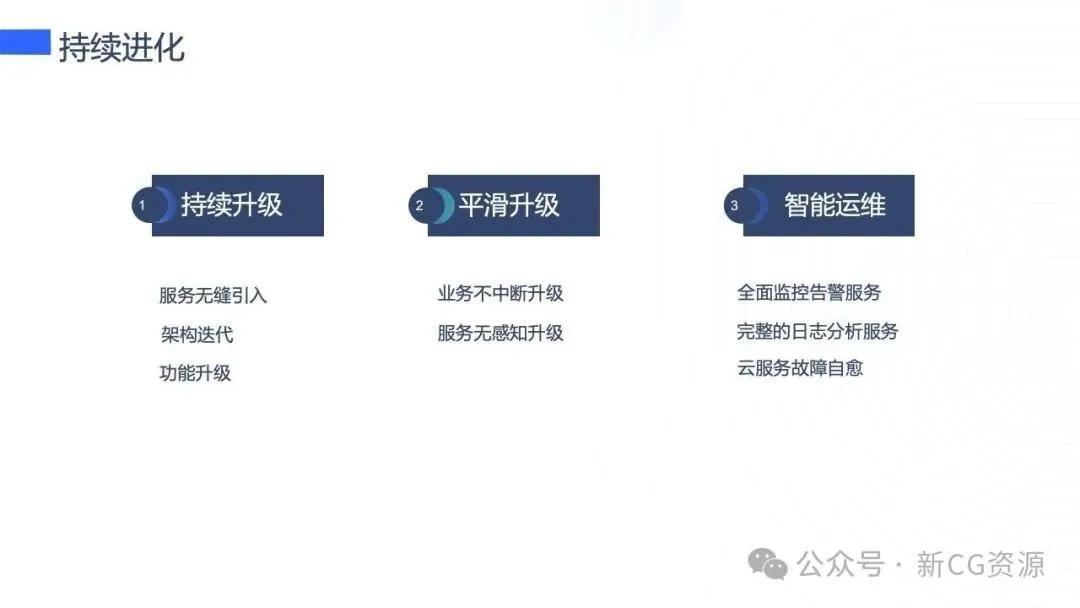
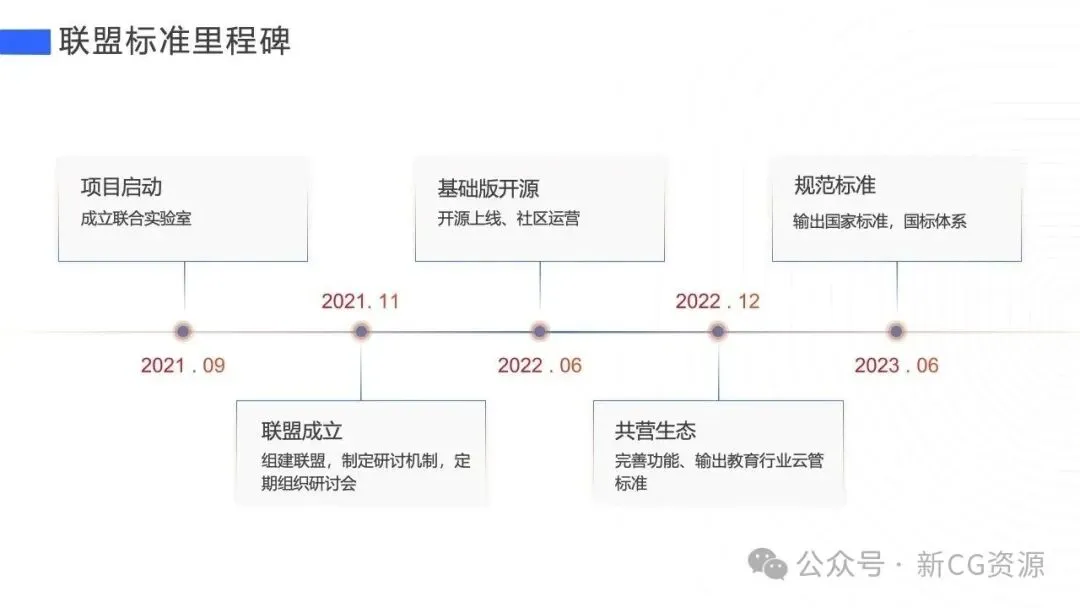
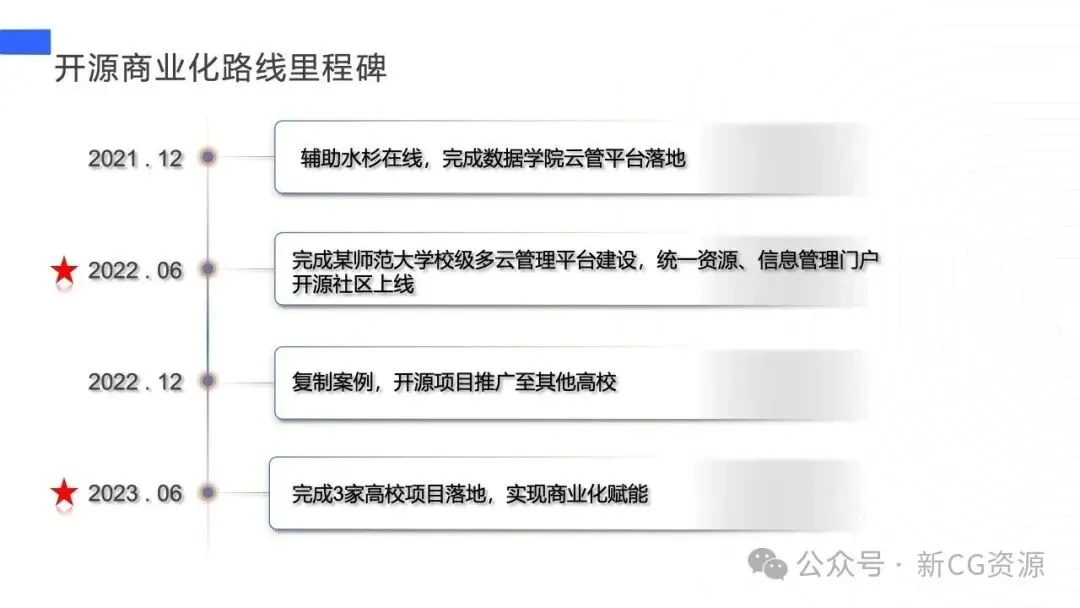
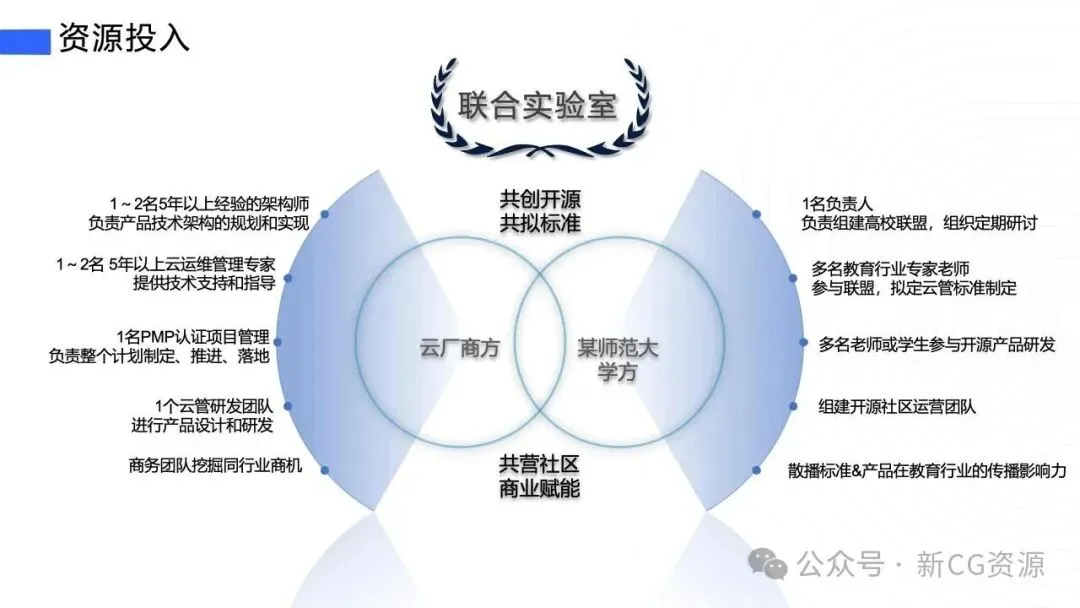
实施节奏一开始就按三年排布。2021 年 9 月项目启动并成立联合实验室,同年 11 月联盟成立,2022 年 6 月基础版开源、同步完成学院级云管平台落地,2022 年 12 月开源社区上线并进入共营生态,2023 年 6 月输出国家标准体系并在三所以上高校复制。云厂商投入架构师、研发团队、PMP 与云运维专家,校方投入教育行业专家、师生研发力量和社区运营。标准、开源、商业化三条线互相喂养,这也是整套方案里最不技术的一部分,却决定了它能不能走出一个校园。
三、方案价值
算力随需,管理归一,这八个字是云化架构超算中心的落点。本地投资被保住,云端弹性被打开,标准与开源源码留在教育行业的公共池里,学校从算力的使用者变成规则的参与者。当科研竞争力越来越取决于谁能更快拿到算力、更细地管好算力,这种供给方式的改变,比任何一代芯片都更耐久。
在此环境下,分享一套解决方案:《数据中心建设解决方案》值得参考借鉴~