LLM学习笔记-49- Attention 学习路径
- 2026-11-04 11:19:26
LLM学习笔记-49- Attention 学习路径
后面我们就按照综述顺序,依次进行学习和记录。
梳理完投机解码部分后,本来是打算回过头去再继续Linear Attention的继续学习。 和AI聊了一下后继的学习路径后,找到一篇2026年来自阿里团队的一篇最新的综述《The Evolution of Attention in Large Language Models: Mechanisms, Trade-offs, and Emerging Trends》,初步浏览了一下,这篇综述很不错,至少对我来说,给了一个很系统的角度来看待各个attention (之前有篇笔记当时的初衷就是想区分清楚各种"Attention")。 顺便也给出了一个好的学习路径:计划后面按照综述的方式来分几条线进行学习:
• Softmax Attention• Sparse Attention• Linear Attention• State Space Models• Hybrid Architecture
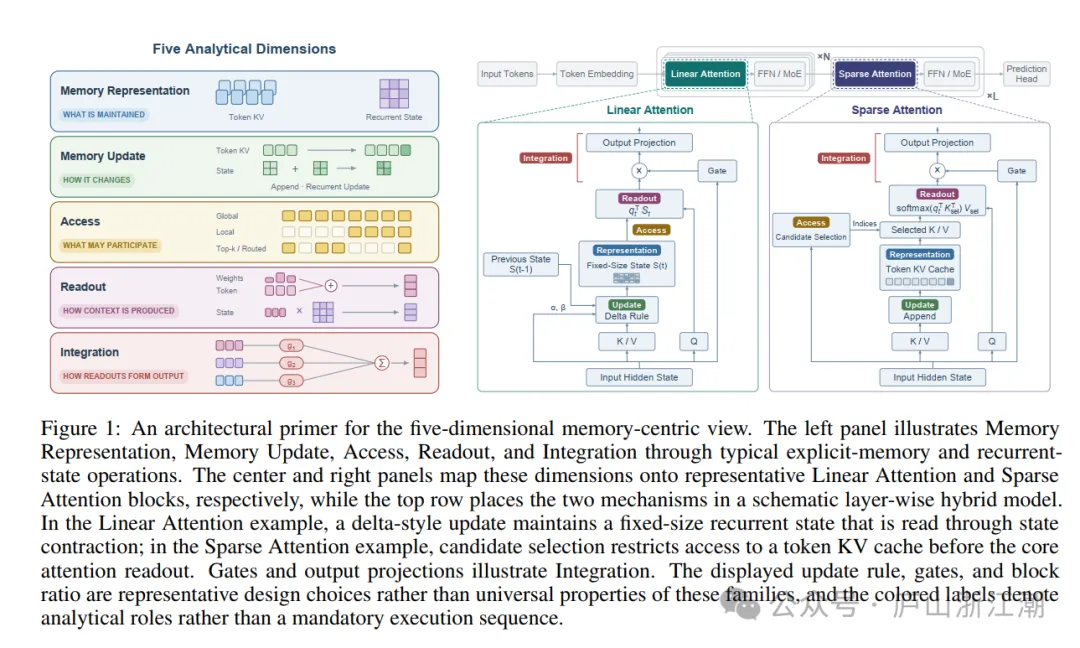
另外,综述给了一个特别的角度:把这些“Attention”相关机制,统一看成是“contextual memory management” ,即"模型如何管理上下文记忆"的统一框架下面,从5个维度进行差异对比:
这5个方面就是5个问题,不同的Attetion方法对应了到底是对哪一块在进行优化。
如下图所示例子:(混合Linaer Attention 和 Sparse Attention)
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

