关于海洋预测和 AI 的一点学习笔记(二):从概念方程到三维可微海洋模式 NeuralPOM
- 2026-11-03 15:13:51
工作宣传|NeuralPOM:具有可微动力学与分阶段学习的混合海洋预报模式
近期,我们完成了三维混合海洋状态预报模式 NeuralPOM 的研究工作,论文题目为 New Wine in an Old Bottle — NeuralPOM: A Hybrid Ocean Forecast Model with Differentiable Dynamics and Staged Learning(《旧瓶新酒——NeuralPOM:具有可微动力学与分阶段学习的混合海洋预报模式》)。
- 开源代码仓库
:https://github.com/ChiyodaMomo01/NeuralPOM - 逾 10 万模式日三维基准数据集
:https://www.modelscope.cn/datasets/chiyodamomo01/NeuralPOM
在上一篇学习笔记中,我们从概念层面梳理了物理海洋模式与数据驱动方法的结合思路,把混合建模写成“物理方程趋势项加神经网络修正项”的微分方程形式,并讨论了离线训练与在线训练的区别。那篇笔记写完后,我们一直在思考一个更具体的问题:当走出二维准地转或浅水方程这类理想化模型,真正面对一个包含自由面起伏、正压与斜压模态分裂、三维温盐输运、非线性状态方程和垂向湍流闭合的三维原始方程海洋环流模式时,概念公式与可运行的预报系统之间究竟隔着哪些物理与数值门槛?
这正是我们开展 NeuralPOM 研究的初衷。预测海洋的物理状态及其长期演化,本质上是在涡旋允许(eddy-permitting)分辨率下寻找一条兼顾物理守恒与中尺度涡旋精度的道路。传统粗网格数值模式受限于网格分辨率,经验次网格闭合难以仅凭可分辨流场的局地应变恢复未分辨中尺度涡的空间位相[1,2];纯数据驱动的神经预报器虽然单步推理很快[3–5],但在数周至数月的自回归滚动中容易产生轨迹漂移,在逐点均方误差(MSE)目标下抹平近网格尺度变率[6–8],且缺乏内建的体积、热量与盐量守恒约束[8,9]。作为系列笔记的第二篇与第三篇,我们将结合 NeuralPOM 的建模过程与实验结果,分享其中的方法设计与研究体会。本篇聚焦三维可微动力框架的重构、受守恒约束的状态更新接口,以及 100 天全状态预报与波数谱机制诊断;下一篇则专门探讨跨物理求解器的分阶段训练机制与高频温盐更新激发的斜压反馈控制。
为什么选择三维原始方程模式“旧瓶装新酒”
在已有的海洋混合建模研究中,许多探索是在准地转或单层浅水模型上完成的[10–13]。这类简化模型非常适合验证算法原型,但它们省略了业务化海洋环流模式中最核心的三维斜压热力学过程与快慢模态耦合。我们之所以把论文题目定为“旧瓶新酒(New Wine in an Old Bottle)”,是因为选择了物理海洋学界非常经典的三维地形跟随坐标环流模式——普林斯顿海洋模式(POM)[14,15]作为物理基座。
在水平交错 Arakawa-C 网格和垂向地形跟随 坐标( 由海面 延伸至海底 ,水柱总厚度 )下,POM 求解静力、Boussinesq 原始方程[14]。记水平速度为 ,垂向速度为 ,物质导数为 ,科氏参数为 ,参考海水密度为 ,静水压力为 ,现场密度为 ,位温与盐度等示踪物为 ,次网格动量与示踪物混合项分别为 与 ,控制方程与垂向积分自由面连续方程写为:
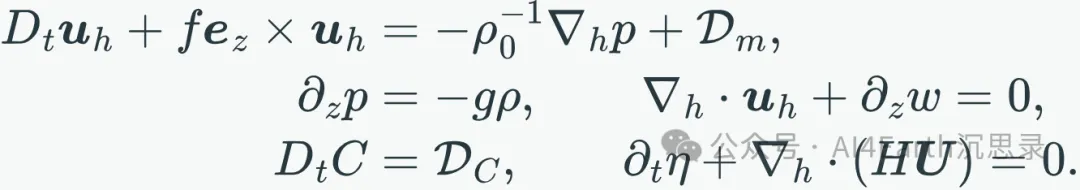
在这套方程里,位温 和盐度 通过非线性 Mellor 状态方程决定现场海水密度 [16],进而通过静力平衡关系 驱动水平斜压压强梯度力;垂向粘性系数与扩散系数则由求解湍动能与混合长度乘积 的 Mellor–Yamada 2.5 阶湍流闭合方案给出[17]。
要把这套传统 Fortran 模式改造成支持反向传播的可微动力框架,首先遇到的物理障碍是快慢时间尺度分离。在 2000 m 水深的海盆中,表面外重力波相速度约为 ,比典型内模态斜压流速(约 )快两个数量级。为了系统弄清外模态时间积分方式如何影响混合建模,我们在 PyTorch 中实现了两套共享三维斜压、温盐和湍流算子(内模态步长 )的可微动力框架。
第一套是显式模态分裂动力框架(Explicit)。它忠实还原了标准 POM 的模态分裂算法:在每个 的斜压步内,用 30 个短时间步()的正压蛙跳子步显式积分自由面高度 与深度平均速度 ,并累加区间平均水位与网格面体积输运量,以此保证正压与斜压模态之间的体积收支一致。反向传播时,梯度直接沿展开的正压子步回传。
第二套是半隐式自由面动力框架(Implicit)。它省去了 30 个正压子步,直接在 的斜压步长上对表面压力梯度施加隐式时间权重 ,将前向自由面高度 的求解转化为二维椭圆型 Helmholtz 方程 (其中 为水深加权水平散度—梯度算子):
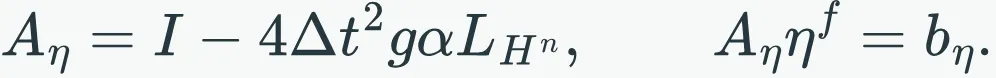
前向积分时,我们采用带离散正弦变换(DST)谱预条件子的共轭梯度法(PCG)求解该椭圆方程。如果在反向传播时把几十步 PCG 迭代直接展开进计算图,不仅显存开销大,还会把迭代截断误差混入梯度。为此,我们利用算子 关于网格单元面积矩阵 的自伴性质 ,设计了隐式微分伴随算子:给定损失函数 对前向水位的上游梯度 ,只需调用一次相同的线性求解器算出伴随场 ,即可直接求得对任意前序状态变量 的精确梯度:
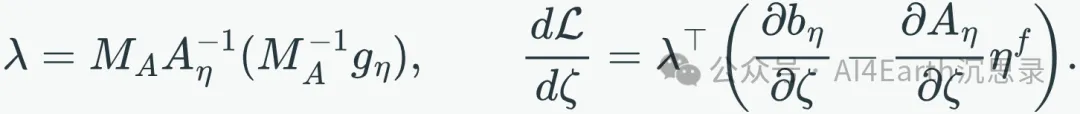
在把神经网络接入之前,我们在 64 位双精度下将这两套可微 PyTorch 动力框架与原始双精度 Fortran POM 进行了严格的对标验证。从理想化的双涡旋海盆、近岸潮汐、层结海山,到具有复杂岸线与浅滩地形的胶州湾真实地形 15 天 潮汐算例(图 1),显式框架在起转阶段与 Fortran 达到机器舍入精度吻合,两套可微框架在胶州湾受迫潮汐平衡态下的全域水位均方根差异均控制在 以内。这为我们后续开展百日尺度的物理—神经耦合实验提供了可靠的动力底座。
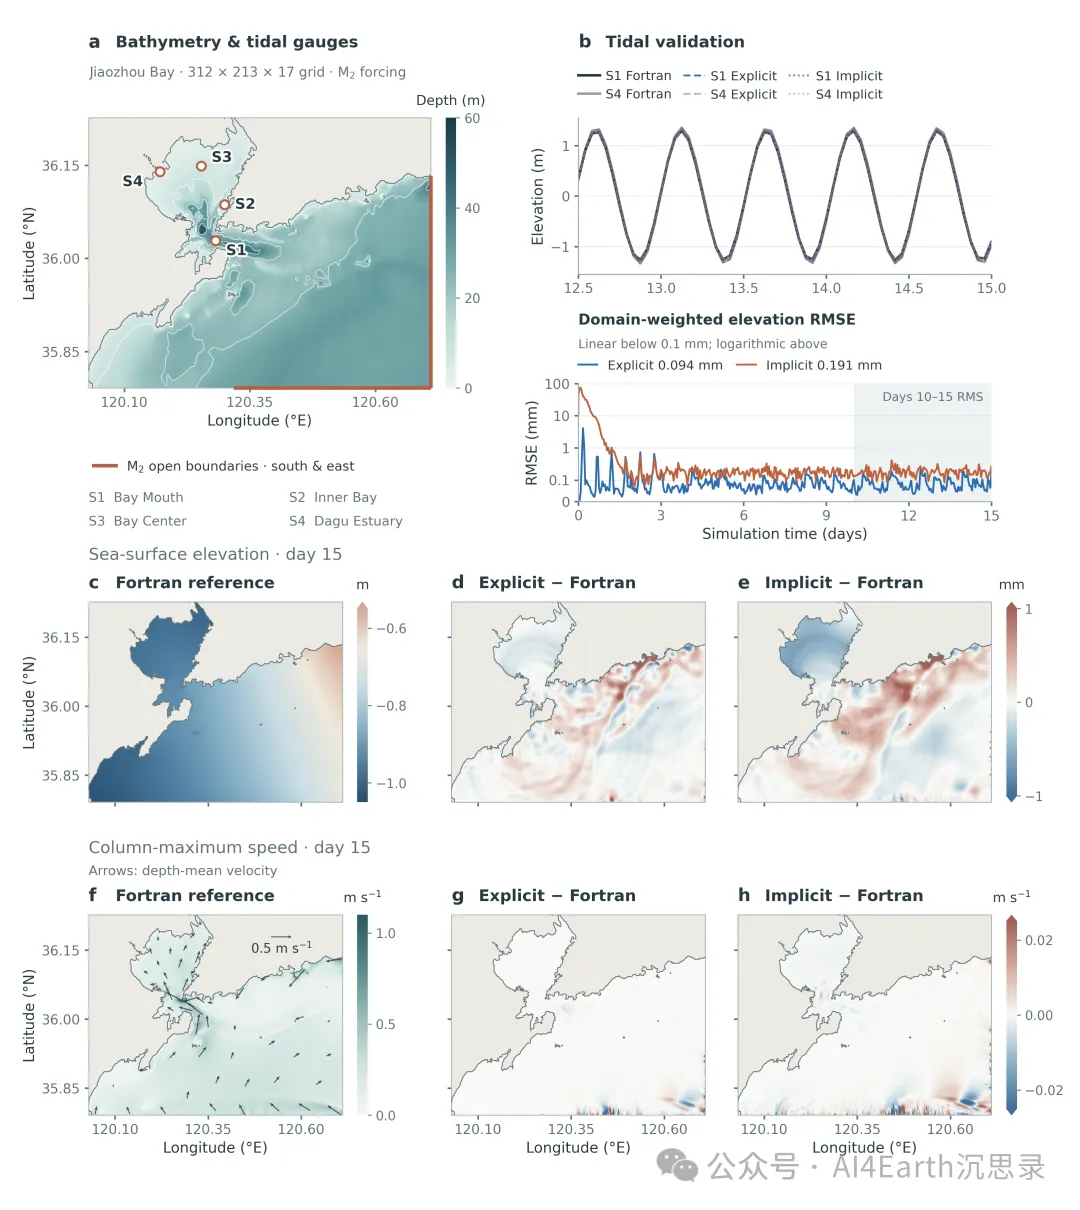
图 1:真实地形胶州湾 15 天 潮汐验证基准算例。(a)近岸水深、南侧与东侧开边界及湾内四个验潮站位置。(b)验潮站水位序列对比(上)与相对于双精度 Fortran POM 参考解的全域面积加权自由面高度 均方根误差时间序列(下)。(c–e)第 15 天 Fortran 参考自由面高度 及 Explicit、Implicit 两套可微动力框架的逐点差值。(f–h)第 15 天水柱最大水平流速及两套可微动力框架的逐点流速差值。来源:NeuralPOM 论文图 9。
神经网络如何与原始方程状态安全耦合
有了可微动力框架,接下来的问题是:神经网络应该怎样修改海洋状态?在单时间层的简化模型里,把网络预测的增量直接加到状态变量上似乎顺理成章。但在三维原始方程求解器中,每一次物理推进都需要当前时间层()与历史时间层()上完整的 45 变量状态向量。我们在早期尝试中很快意识到,任何不加物理约束的直接状态修改,都会立刻破坏水柱体积收支或蛙跳时间层的一致性,在下一步物理积分中激发出虚假的外重力波或蛙跳计算模态。
因此在 NeuralPOM 中,我们将预报推进设计为“物理积分 + 受约束状态更新”的交替循环(图 2a)。记第 个循环后的完整模式状态为 ,时间间隔 (本文同时考察高频 与低频 )上的原始方程积分算子为 ,受守恒约束的神经状态更新算子为 :

在每个物理积分区间末端,残差 U-Net 接收当前与历史时间层的三维速度和温盐场以及二维外模态场,输出 15 个活跃 层上的水平速度与温盐原始增量 。在写入模式状态之前,算子 会依次执行三道物理约束。
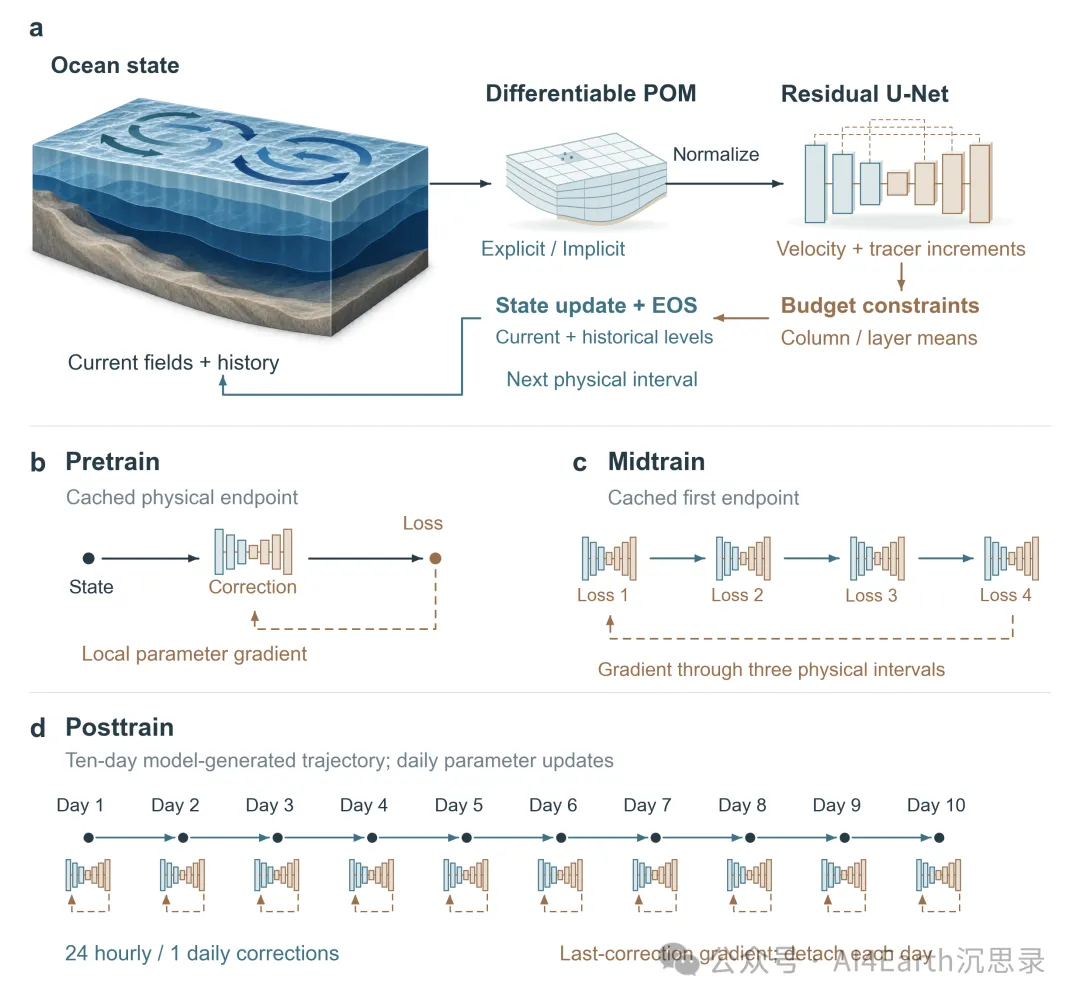
图 2:NeuralPOM 的物理–神经耦合循环与三阶段训练流程。(a)在每个耦合步,可微 POM 动力框架将海洋状态输入残差 U-Net,网络输出的原始速度与温盐增量 经水柱/层均值守恒投影、密度法向阻尼与限幅后,同步更新当前与历史蛙跳时间层并重算状态方程密度 ,再进入下一物理积分区间。(b–d)依次推进的单步预训练(Pretrain)、跨求解器多步可微训练(Midtrain)与 10 天闭环滚动训练(Posttrain)。来源:NeuralPOM 论文图 1。
第一道约束是正压与斜压职责分离。我们将水平速度增量投影为水柱层厚加权平均为零,同时将位温和盐度增量投影为每个活跃 层上的湿体积加权平均为零(记 为第 层的湿体积加权水平平均):
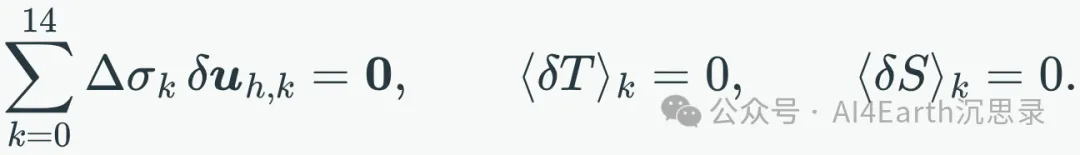
这一设计体现了混合建模中非常关键的物理分工:去除水柱平均速度增量后,神经网络的直接动量修正被严格限制在斜压垂向切变上,水柱的垂向积分体积输运继续完全由外模态连续方程控制;去除逐层平均温盐增量后,网络只能在每个 层内部水平重新分配热量与盐量,不会向任何水层引入净热源或净盐源。一个很有意思的推论是,尽管神经网络从不直接修改自由面高度 ,但它对内部斜压切变与温盐层结的修正,会在随后的物理积分区间 中通过正压—斜压模态耦合自然调整海面高度。
第二道约束是针对温盐增量的密度法向阻尼(Density-Normal Damping,DND)与成对极值限幅,用来滤除高频耦合下可能激发虚假斜压压强梯度的跨等密面密度扰动(这一机制我们将在第三篇笔记中重点剖析)。
第三道约束是蛙跳时间层同步更新。我们将经过守恒投影和阻尼后的物理增量 同步加到当前()与历史()两个蛙跳时间层上:
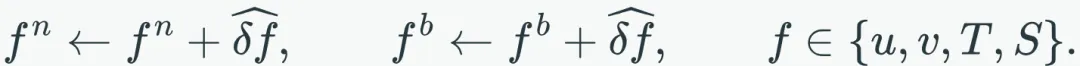
同步修改两个时间层保持了时间层差值 不变,从而避免了单层跳变激发的蛙跳计算模态。随后,三维海水密度 立即由非线性状态方程重新计算,而自由面高度 、垂向速度 与湍流混合变量则在下一个物理积分区间内按照原始方程完成动力平衡。
逾十万模式日基准上的百日全状态预报
为了在收支严格闭合、没有观测稀疏性与再分析同化偏差干扰的环境下检验这套系统,我们在跨越 、水平尺度 、水深 的三维风生双涡旋海盆(double-gyre)中,针对显式与半隐式两套动力框架各积分了 8 个细网格(水平格距约 ,涡旋分辨尺度)集合成员,每个成员连续积分 9,000 个模式日,累计超过 10 万个模式日。定常纬向风应力在海盆中驱动出副热带与副极地双涡旋对、强劲的东向分离急流以及饱满的三维中尺度涡旋场(图 3)。我们将细网格参考场经体积加权守恒限制映射投影至约 的粗预报网格(涡旋允许尺度),从未参与训练的独立测试成员上选取 16 个起报日,开展连续 100 天的三维海洋物理状态预报。
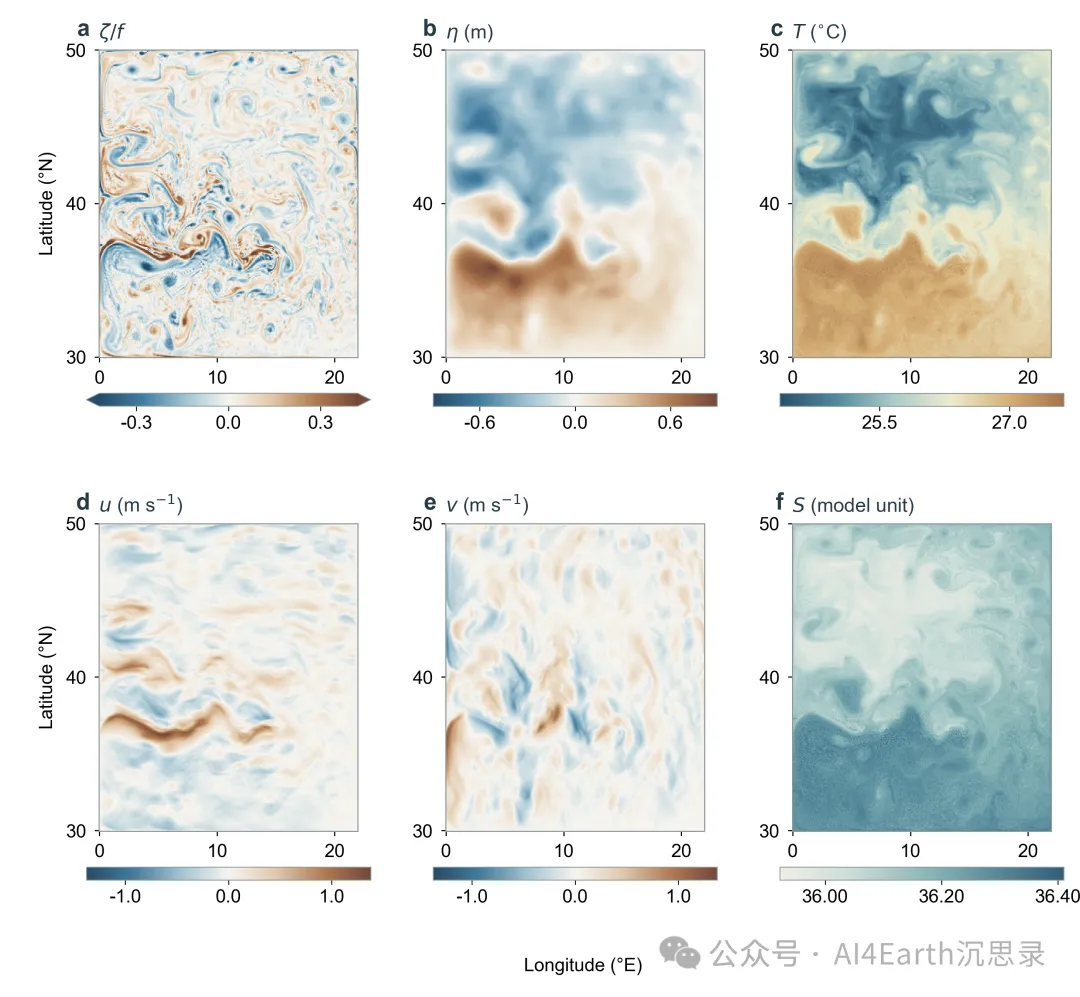
图 3:细网格风生双涡旋海盆参考数据集中充分发展的三维环流场。图示细网格 Explicit 参考模拟最上层活跃 层的瞬时归一化相对涡度 (a)、自由面高度 (b)、位温 (c)、纬向流速 (d)、经向流速 (e)和盐度 (f)。来源:NeuralPOM 论文图 2。
围绕 100 天长时效预报,我们重点对比了两类代表性基线:一类是在同一 粗网格 POM 求解器上运行的三种经典次网格物理闭合方案(标准二阶谐波 Smagorinsky 扩散、四阶双调和粘性 Biharmonic,以及将耗散动能回注可分辨流场的动能逆散射方案 Backscatter);另一类是不调用物理求解器、直接以自回归方式逐日推进全部 313 个状态通道的五种时空神经网络架构(Triton[18]、ResUNet、SimVP[19]、ConvLSTM[20] 与 PastNet[21],均依次完成单步预训练 Pre 与 10 天闭环滚动训练 Post)。
实验结果呈现出两条清晰的规律。首先,与粗网格物理基线相比,NeuralPOM 在显式与半隐式两套动力框架上全面降低了全部五个预报变量 及诊断海水密度 的 100 天均方根误差(RMSE):在逐日耦合下,水平流速与海表高度(SSH)误差较 Smagorinsky 基线降低 5%–10%,位温与盐度误差分别降低 10%–12% 和 15%–18%;在逐时耦合配合 DND 下,环流与海表高度取得最大改善(水平流速误差降低 7%–10%,SSH 误差降低 12%–13%)。相反,在未校正粗网格上改用四阶双调和粘性 Biharmonic 或动能逆散射 Backscatter,反而使全变量 100 天误差上升了 4%–17%。
| 0.07926 | 0.11970 | 0.29351 | 0.03382 | ||
| 0.08180 | |||||
| NeuralPOM Post-DND (ours) | 0.07415 | 0.07789 | 0.11227 | 0.26537 | 0.02822 |
表 1:混合模式 NeuralPOM 与粗网格物理基线及五种直接神经网络预报模型在 16 个测试起报日上汇总的 100 天 RMSE(半隐式参考场)。每列最优结果以浅绿背景加粗体标出,次优结果以下划线标出(按未舍入数值排序);Pre 与 Post 分别对应单步预训练与 10 天闭环滚动训练模型,盐度 为模式单位。来源:NeuralPOM 论文表 2。
其次,对比表 1 中的五种纯数据驱动神经网络可以看到,仅经过单步预训练(Pre)的模型在 100 天滚动中发生了明显的轨迹发散;引入 10 天闭环滚动训练(Post)虽然帮助直接神经网络稳住了大尺度环流,使流速 与海表高度误差接近粗网格物理基线,但纯数据驱动映射在百日尺度上依然无法维持三维温盐 结构,其 100 天盐度误差达到物理求解器的 3 至 8 倍。嵌入可微原始方程框架的 NeuralPOM 则在所有变量上均取得最低误差,较各变量最强的直接神经网络基线分别降低 5%–12%(水平流速与海表高度)、28%(位温 )和 74%(盐度 )。
波数谱视角:为什么纯物理闭合与纯 AI 走入相反的困境
为什么在粗网格物理模式里调小耗散或加入动能逆散射反而会增大误差,而纯 AI 模型又为何难以兼顾长时效精度与小尺度结构?格点均方根误差把“涡旋强度对不对”和“涡旋位置准不准”混在了一起。为了把这两件事拆开,我们对预报后期(第 51–100 天)的水平速度场做二维傅里叶变换,在径向波数 空间考察三个无量纲指标:预测动能与参考动能之比能量比 ( 表示能量水平与参考场一致)、度量预测与参考涡旋空间位置相干性的位相对齐度 ( 表示位相完全对齐),以及误差能量与参考能量之比归一化谱误差 。三者满足精确恒等式:
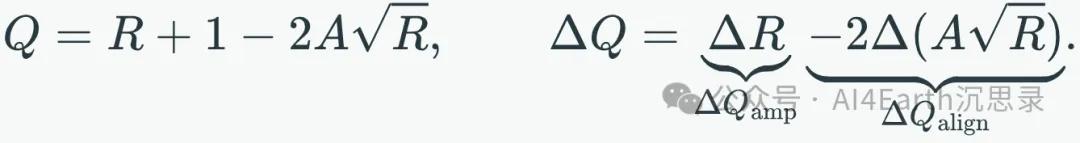
这个简单的恒等式把湍流预报中的“双重惩罚(double penalty)”效应[7,8]写得非常透彻。在小尺度或长提前期下,涡旋的精确位置很难预测(位相对齐度 接近 ),此时谱误差近似为 。如果一个模型激发出了很强的小尺度涡旋( 变大),但位置没有对准( 没有提升),多出来的能量就会变成纯粹的振幅惩罚(),反而推高总误差 ;反过来,如果一个模型为了讨好均方误差指标,干脆把不可预测的小尺度涡旋全部抹平(令 ),虽然表面上降低了 ,却丢掉了真实的海洋小尺度动力结构。
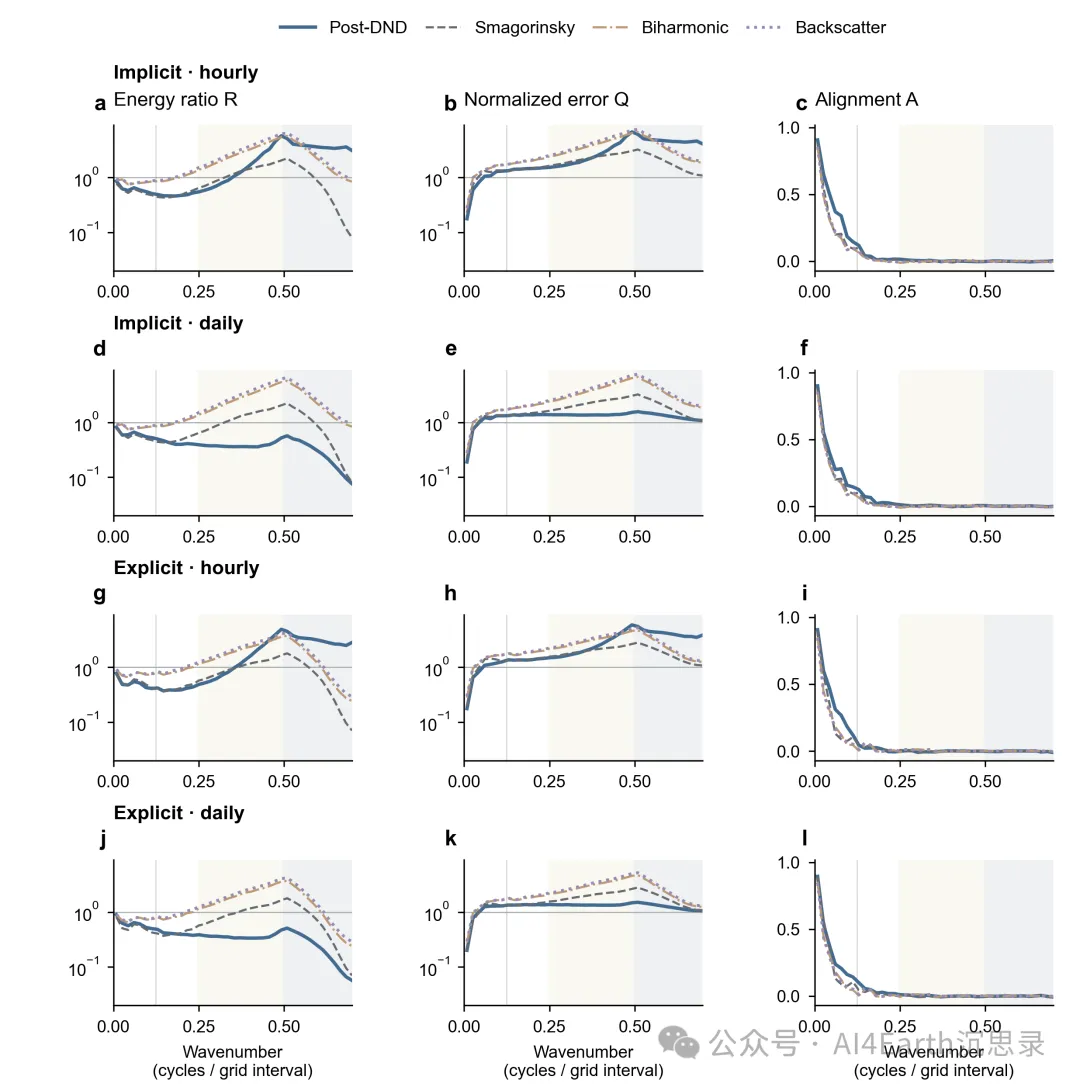
图 4:预报后期(第 51–100 天)层厚加权的径向波数水平速度谱。四行分别对应四种混合配置(Implicit 逐时、Implicit 逐日、Explicit 逐时、Explicit 逐日)及其粗网格物理闭合基线(Smagorinsky、Biharmonic、Backscatter)。左列为动能比 ,中列为归一化谱误差 ,右列为位相对齐度 ,横轴为径向波数 (周/格距,);浅色与深色阴影分别标出近网格波段()与角波数带。来源:NeuralPOM 论文图 4。
对照图 4 的后期波数谱,三类方法的物理行为便一目了然: 在未校正粗网格上改用双调和粘性 Biharmonic 或动能逆散射 Backscatter,确实在近网格尺度注入了充沛的涡旋动能(图 4 左列虚线 明显抬升);然而,仅凭粗网格自身的应变率并不能算出未分辨涡旋的真实空间位相(右列位相对齐度 未见改善),错位的涡旋能量直接转化为正向振幅惩罚 ,推高了中列的总谱误差 。 五种纯数据驱动神经网络(Post)则走向了另一端:为了在逐点均方误差训练下规避位相惩罚,它们将近网格波段()的动能比 强烈压低至 ,表现为流场的小尺度平滑。 相比之下,NeuralPOM(深蓝实线)依托底层原始方程求解器维持了物理可分辨的涡旋动能水平(高频逐时耦合下近网格能量比保持在 附近),同时依靠周期性神经状态更新拉升了中尺度波段的位相对齐度 ,使谱误差 的下降几乎全部来自位相对齐项的改善()。
回顾从概念微分方程到三维混合模式 NeuralPOM 的搭建过程,我们最大的体会是:在三维海洋环流问题上,物理模式与人工智能并不是非此即彼的替代关系。让可微原始方程动力框架守住体积连续性、逐层热盐收支与近网格湍流变率,让受约束的神经网络专注于校准粗网格缺失的中尺度斜压位相,才能在百日积分中兼顾物理一致性与预报技巧。当前基准算例建立在零海表浮力通量的理想化双涡旋海盆之上,但这一耦合机制为迈向真实区域与全球海洋预报提供了清晰的蓝图。那么,当神经网络进入这个可微原始方程循环之后,跨物理求解器的反向传播梯度在训练中究竟什么时候不可或缺?为什么高频逐时耦合在带来最强环流引导的同时,会引发温盐—斜压反馈失稳?我们将在下一篇笔记中继续拆解。
参考资料
[1] Fox-Kemper, B., Adcroft, A., Böning, C. W., et al. (2019). Challenges and Prospects in Ocean Circulation Models. Frontiers in Marine Science, 6, 65. https://doi.org/10.3389/fmars.2019.00065
[2] Hewitt, H. T., Roberts, M., Mathiot, P., et al. (2020). Resolving and Parameterising the Ocean Mesoscale in Earth System Models. Current Climate Change Reports, 6(4), 137–152. https://doi.org/10.1007/s40641-020-00164-w
[3] Cui, Y., Wu, R., Zhang, X., et al. (2025). Forecasting the eddying ocean with a deep neural network. Nature Communications, 16(1), 2268. https://doi.org/10.1038/s41467-025-57389-2
[4] El Aouni, A., Gaudel, Q., Regnier, C., et al. (2025). GLONET: Mercator's end-to-end neural global ocean forecasting system. Journal of Geophysical Research: Machine Learning and Computation, 2(3), e2025JH000686. https://doi.org/10.1029/2025JH000686
[5] Niu, Y., Huang, Q., Zhong, X., et al. (2026). A deep learning global ocean forecasting model with sub-daily and eddy-resolving resolution. npj Climate and Atmospheric Science, 9(1), 194. https://doi.org/10.1038/s41612-026-01444-2
[6] Chattopadhyay, A., Gray, M., Wu, T., Lowe, A. B., & He, R. (2024). OceanNet: a principled neural operator-based digital twin for regional oceans. Scientific Reports, 14(1), 21181. https://doi.org/10.1038/s41598-024-72145-0
[7] Leith, C. E. (1974). Theoretical skill of Monte Carlo forecasts. Monthly Weather Review, 102(6), 409–418. https://doi.org/10.1175/1520-0493(1974)102<0409:TSOMCF>2.0.CO;2
[8] Kochkov, D., Yuval, J., Langmore, I., et al. (2024). Neural general circulation models for weather and climate. Nature, 632(8027), 1060–1066. https://doi.org/10.1038/s41586-024-07744-y
[9] Zanna, L., Gregory, W., Perezhogin, P., et al. (2025). A framework for hybrid physics-AI coupled ocean models. arXiv preprint, arXiv:2510.22676. https://arxiv.org/abs/2510.22676
[10] Bolton, T., & Zanna, L. (2019). Applications of Deep Learning to Ocean Data Inference and Subgrid Parameterization. Journal of Advances in Modeling Earth Systems, 11(1), 376–399. https://doi.org/10.1029/2018MS001472
[11] Ross, A., Li, Z., Perezhogin, P., Fernandez-Granda, C., & Zanna, L. (2023). Benchmarking of Machine Learning Ocean Subgrid Parameterizations in an Idealized Model. Journal of Advances in Modeling Earth Systems, 15(1), e2022MS003258. https://doi.org/10.1029/2022MS003258
[12] Frezat, H., Le Sommer, J., Fablet, R., Balarac, G., & Lguensat, R. (2022). A Posteriori Learning for Quasi-Geostrophic Turbulence Parametrization. Journal of Advances in Modeling Earth Systems, 14(11), e2022MS003124. https://doi.org/10.1029/2022MS003124
[13] Yan, F. E., Frezat, H., Le Sommer, J., Mak, J., & Otness, K. (2025). Adjoint-Based Online Learning of Two-Layer Quasi-Geostrophic Baroclinic Turbulence. Journal of Advances in Modeling Earth Systems, 17(7), e2024MS004857. https://doi.org/10.1029/2024MS004857
[14] Blumberg, A. F., & Mellor, G. L. (1987). A description of a three-dimensional coastal ocean circulation model. In Three-Dimensional Coastal Ocean Models, Coastal and Estuarine Sciences, Vol. 4, pp. 1–16, AGU. https://doi.org/10.1029/CO004p0001
[15] Xu, S., Huang, X., Oey, L.-Y., et al. (2015). POM.gpu-v1.0: a GPU-based Princeton Ocean Model. Geoscientific Model Development, 8(9), 2815–2827. https://doi.org/10.5194/gmd-8-2815-2015
[16] Mellor, G. L. (1991). An Equation of State for Numerical Models of Oceans and Estuaries. Journal of Atmospheric and Oceanic Technology, 8(4), 609–611. https://doi.org/10.1175/1520-0426(1991)008<0609:AEOSFN>2.0.CO;2
[17] Mellor, G. L., & Yamada, T. (1982). Development of a turbulence closure model for geophysical fluid problems. Reviews of Geophysics, 20(4), 851–875. https://doi.org/10.1029/RG020i004p00851
[18] Wu, H., Gao, Y., Shu, R., et al. (2025). Advanced long-term earth system forecasting by learning the small-scale nature. arXiv preprint, arXiv:2505.19432v1. https://arxiv.org/abs/2505.19432v1
[19] Gao, Z., Tan, C., Wu, L., & Li, S. Z. (2022). SimVP: Simpler yet better video prediction. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), pp. 3170–3180.
[20] Shi, X., Chen, Z., Wang, H., et al. (2015). Convolutional LSTM network: A machine learning approach for precipitation nowcasting. In Advances in Neural Information Processing Systems (NeurIPS), Vol. 28, pp. 802–810.
[21] Wu, H., Xu, F., Chen, C., et al. (2023). PastNet: Introducing physical inductive biases for spatio-temporal video prediction. arXiv preprint, arXiv:2305.11421. https://doi.org/10.48550/arXiv.2305.11421

