智能体学习笔记分享系列(四)——感知与环境理解:多模态与传感器
- 2026-11-02 22:58:50
医生接诊一位病人时,会同时做三件事:看病人的气色和检查单(视觉)、听病人描述症状(听觉)、结合历史病历(历史行为)。任何单一信息来源都不足以诊断,必须把多个信息源合在一起判断——智能体感知环境也是同样的道理。
智能体的所有决策都建立在"感知"之上:不知道前方有没有障碍,就无法规划避让路径;不知道仓库还剩多少货,就无法决定补货。本章讲清楚一个问题:智能体到底是怎么"看见"世界的?
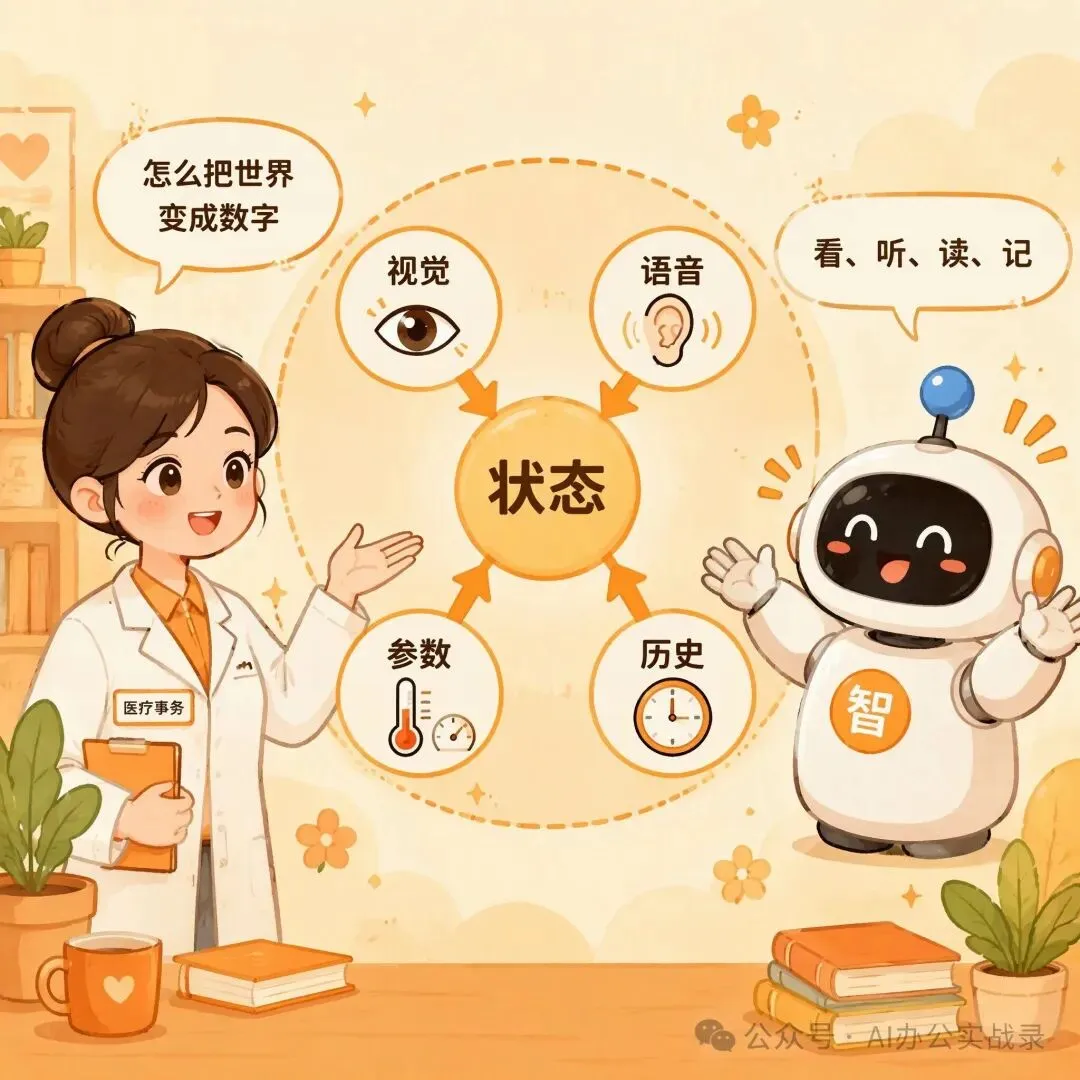
感知:把世界变成可计算的状态
你问导航"还要多久到公司",它不会回答"地铁站有一群人在等车,张阿姨刚刷卡进站",而是返回"剩余12.3公里、预计28分钟"。导航把真实的、模糊的世界,压缩成了它能计算、能决策的抽象参数。
感知(Perception) 是智能体把环境中的物理信号转换为内部可计算表示的过程。原始数据——像素、声波、温度、电压——对智能体没有直接意义;感知的任务是把它们提炼成状态(State) ,即一组刻画"现在发生了什么"的结构化信息,例如"前方3米有障碍物""室内温度26摄氏度""用户情绪偏急躁"。
感知有两条基本要求:
- 可计算:
感知结果必须能被规划、推理模块直接使用,所以通常是数字化的状态描述,而不是原始波形。摄像头画面要变成"障碍物清单",语音要变成"文本意图"。 - 及时与可靠:
状态反映的是"现在"的世界,过期的感知比没有感知更危险——自动驾驶系统如果拿1秒前的地图去决策,早就撞车了。
多模态大模型时代的感知更进一步:把图像、文本、音频、视频等不同模态统一处理,通过"模态对齐"消除语义隔阂,让机器人不仅"看到像素",还能"理解场景"。也就是说,感知正在从"采集数据"升级为"理解环境"。
多模态感知:视觉、语音、结构化参数、历史行为
多模态(Multimodal) 指同时使用多种类型(模态)的信息来源。一个"看、听、读、回忆"并用的人类观察者,就是天然的多模态感知系统。智能体的多模态感知通常包括四类输入:
- 视觉(Visual):
摄像头、深度相机、激光雷达提供的图像与三维数据,回答"环境里有什么、在哪、长什么样"。这是自动驾驶、机器人、安防感知的主力输入。 - 语音(Audio):
麦克风采集的声音,经语音识别(ASR)变成文本,再经语义理解变成意图;也包括声音事件识别,比如"听到婴儿哭声"。 - 结构化参数(Structured Parameters):
传感器给出的数值型状态——温度、湿度、电压、库存量、GPS坐标、设备报警码。它们不是"看懂"的,而是直接"读"出来的字段。 - 历史行为(Historical Behavior):
用户在过去的操作记录、对话历史、浏览足迹等带时间的信息,回答"他以前是什么样",用于个性化与预测。
为什么要多模态:单一模态总有盲区。看视频听不到声音,听声音看不见画面;只看对话记录,不知道用户此刻的脸色。多个模态互补,才能逼近"完整理解"。
常见传感器逐个讲
传感器(Sensor) 是把物理世界的信号转成电信号或数字信号的器件,是智能体感知的"感官"。下面介绍八类常用传感器,分别讲清楚它们"看什么、怎么工作、适合什么任务"。
(1)摄像头(Camera)——智能体最普及的"眼睛"
它采集三维世界在镜头上的二维投影,输出RGB彩色图像,适合做目标识别、车道线检测、人脸识别。缺点是纯摄像头没有距离信息,受光照影响大。自动驾驶的感知方案几乎都以摄像头作为多传感器组合中的基石之一。
(2)激光雷达(LiDAR)——"自动测距的雷达"
激光雷达(Light Detection and Ranging,LiDAR) 通过发射激光并测量反射回来的时间(飞行时间法TOF)计算目标距离,扫描一周就能得到周围物体的三维坐标集合,即点云。它不靠环境光工作,夜间、逆光下依然可靠,是自动驾驶、测绘机器人的主力测距传感器。
(3)IMU惯性测量单元——"体感传感器"
惯性测量单元(Inertial Measurement Unit,IMU) 一般集成了三轴加速度计与三轴陀螺仪:加速度计测"多快在加速",陀螺仪测"怎样在旋转",两者结合就能推算物体自身的运动姿态与位移轨迹。它不依赖外部信号,短时间非常准,但会随时间累积漂移误差,所以常与GPS、视觉配合使用相互校正。
(4)RGB-D深度相机——"带深度的摄像头"
RGB-D相机在普通彩色图像(RGB)之外,还输出一张深度图,每个像素记录相机到物体的距离,形成"彩色+距离"的数据形态。实现原理主要有三类:结构光、飞行时间法(ToF)、双目立体视觉,各有量程、分辨率与成本上的取舍。它让机器人"看见"物体立体形状,广泛用于抓取、避障与人机交互。
(5)麦克风阵列与波束成形——"会听声辨位的耳朵"
单个麦克风在嘈杂环境下很难听清远处的声音;麦克风阵列把多个麦克风按一定几何排列,通过算法处理各路信号的时间差,实现波束成形(Beamforming) ——把拾音"波束"集中对准声源方向,同时抑制其他方向的噪声,还能定位声源。会议室的吊顶麦克风、智能音箱、车载语音系统都依赖这项技术实现远场拾音与多音区交互。
(6)红外成像(热成像)——"看温度的相机"
一切高于绝对零度的物体都在辐射红外线,红外相机捕捉这种辐射并转换成温度图像。它完全不需要可见光,能在黑夜、浓雾下"看见"有温度的物体(行人、动物、设备发热点),用于夜间驾驶辅助、安防巡检、工业设备测温。
(7)多光谱相机——"多波段的眼睛"
普通相机把光合成红绿蓝三色;多光谱相机在多个狭窄波段分别成像,可以看到人眼看不见的近红外等波段。
(8)点云
严格说,点云不是传感器,而是激光雷达、深度相机等输出的一种数据形态:空间中大量三维点的集合,每个点带坐标(有时带强度、颜色)。
传感器融合:为什么融合、互补与冗余
你过马路时会同时用眼睛看车、用耳朵听喇叭、用余光感受风。单用眼睛,雨天看不清;单用耳朵,静音电动车听不见——多感官并用的本质是互相补盲区、互相验证。
传感器融合(Sensor Fusion) 把来自多个传感器的数据在共同的参考系与时间同步基础上进行综合处理,形成比任何单一传感器更完整、更可靠的感知结果——它不是简单堆叠数据,而是有组织、有时间同步、有统一坐标系的深度融合。
融合的价值来自两个机制:
- 互补(Complementary):
不同传感器看到世界的不同侧面。激光雷达给距离、摄像头给颜色和纹理、IMU给运动姿态,互相填补盲区;比如只用摄像头判断"那是人"但算不出精确距离,加上激光雷达的距离值就完整了。 - 冗余(Redundant):
多个独立传感器观测同一信息,可以互相校验。某个传感器故障或被遮挡时,系统仍能从其他传感器拿到数据——这是安全关键系统(如自动驾驶、电力监控)必须冗余的根本原因。
下一篇,我们聊聊智能体怎么"记住"事情——记忆系统是怎么回事。
本文为个人学习笔记,由AI辅助整理,仅供学习交流,不代表任何机构观点。

