Excel 表格喂 AI:CSV 比 JSON 省 62% 字
- 2026-11-01 15:37:16
你是不是也这样:一份 200 行的客户明细,Ctrl+A 复制粘进 AI 对话框,它读了三行就开始答非所问,或者干脆甩你一句"内容过长"。
我把同一张表导成 CSV、Markdown、JSON 三种格式实测:17,275 字、22,550 字、45,830 字——最贵那份是 CSV 的 2.65 倍。
照着跑,三分钟就能算出你自己的表格该用哪种格式喂 AI。
先看效果:同样的表格,JSON 多花 1.65 倍字
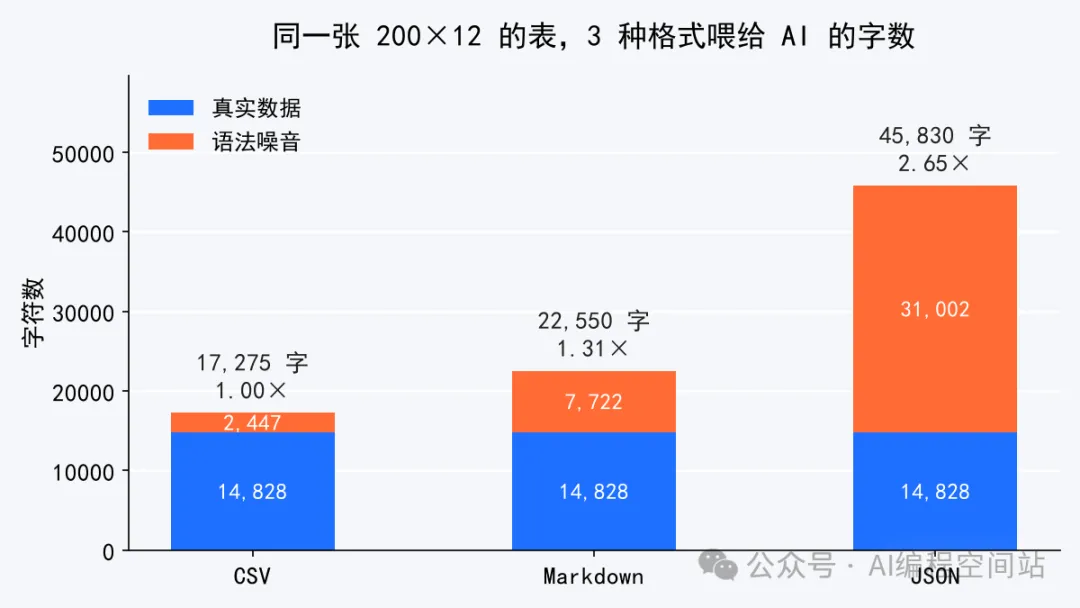
三根柱子里,蓝色部分完全一样高:14,828 字。那是真实数据,一个字都省不掉。
橙色是语法噪音——引号、逗号、竖线、还有每一行都要重复一遍的列名。CSV 只占 14%,JSON 占了 68%。
换句话说:你把 JSON 贴给 AI,三分之二的字花在了括号和重复的字段名上。
准备工作
Python 3.8 以上,装一个库 pip install matplotlib(只用来画图,不画图可以不装)一张自己的表,另存为 明细.csv放同目录;没有也行,脚本会自动造 200 行样本表的第一行必须是列名,列名和脚本里的 COLS对得上
上代码
# -*- coding: utf-8 -*-import csv, json, io, os, randomCOLS = ["订单号", "下单日期", "客户名称", "手机号", "省份", "城市","产品名称", "数量", "单价", "金额", "负责人", "更新时间"]DROP = ["订单号", "手机号", "更新时间"] # AI 用不上,手机号还涉及隐私defload(path="明细.csv"):"""有 明细.csv 就读你自己的;没有就造 200 行样本,保证开箱能跑"""if os.path.exists(path):withopen(path, encoding="utf-8-sig") as f: # 必须带 BOM 处理returnlist(csv.reader(f))[1:] random.seed(20261028) rows = []for i inrange(1, 201): q = random.randint(1, 20) price = random.choice([199, 499, 1299, 2999, 6999]) rows.append([f"SO2026{i:05d}",f"2026-0{random.randint(1,9)}-{random.randint(1,28):02d}", random.choice(["恒信", "和顺", "百川", "金鹏"]) + str(random.randint(1, 99)) + "公司","1" + "".join(random.choice("0123456789") for _ inrange(10)), random.choice(["广东", "广西", "浙江", "江苏"]), random.choice(["深圳", "南宁", "杭州", "苏州"]), random.choice(["云存储", "数据库年包", "CDN流量包", "安全套餐"]), q, price, round(q * price, 2), random.choice(["张伟", "李娜", "王强"]),f"2026-10-{random.randint(1,27):02d} 10:{random.randint(10,59)}", ])return rowsdefbuild(rows, cols=COLS):"""把同一批数据序列化成 3 种格式,返回 {格式: 文本}""" idx = [COLS.index(c) for c in cols] data = [[r[i] for i in idx] for r in rows] buf = io.StringIO() w = csv.writer(buf, lineterminator="\n") # 别用默认 \r\n,白多 200 字 w.writerow(cols) w.writerows(data) md = ["| " + " | ".join(cols) + " |", "|" + "---|" * len(cols)] md += ["| " + " | ".join(map(str, r)) + " |"for r in data]return {"CSV": buf.getvalue(),"Markdown": "\n".join(md),"JSON": json.dumps([dict(zip(cols, r)) for r in data], ensure_ascii=False, indent=1), # 中文别转 \u }defreal_chars(rows, cols=COLS):"""真实数据字数:不含引号、逗号、括号、表头这些语法符号""" idx = [COLS.index(c) for c in cols]returnsum(len(str(r[i])) for r in rows for i in idx)# ====================== 下面开始实测 ======================rows = load()print(f"样本:{len(rows)} 行 × {len(COLS)} 列\n")base = Nonefor name, text in build(rows).items(): base = base orlen(text) noise = len(text) - real_chars(rows)print(f"{name:9s} 总字数 {len(text):>7,} 噪音 {noise:>6,}"f"({noise / len(text) * 100:.0f}%) {len(text) / base:.2f} 倍")lean = [c for c in COLS if c notin DROP]print(f"\n砍掉 {'/'.join(DROP)} 之后:")for name, text in build(rows, lean).items(): before = len(build(rows)[name])print(f"{name:9s}{len(text):>7,} 字 省 {(1 - len(text) / before) * 100:.1f}%")跑出来的结果:CSV 9,062 字,JSON 30,230 字
样本:200 行 × 12 列CSV 总字数 17,275 噪音 2,447(14%) 1.00 倍Markdown 总字数 22,550 噪音 7,722(34%) 1.31 倍JSON 总字数 45,830 噪音 31,002(68%) 2.65 倍砍掉 订单号/手机号/更新时间 之后:CSV 9,062 字 省 47.5%Markdown 13,119 字 省 41.8%JSON 30,230 字 省 34.0%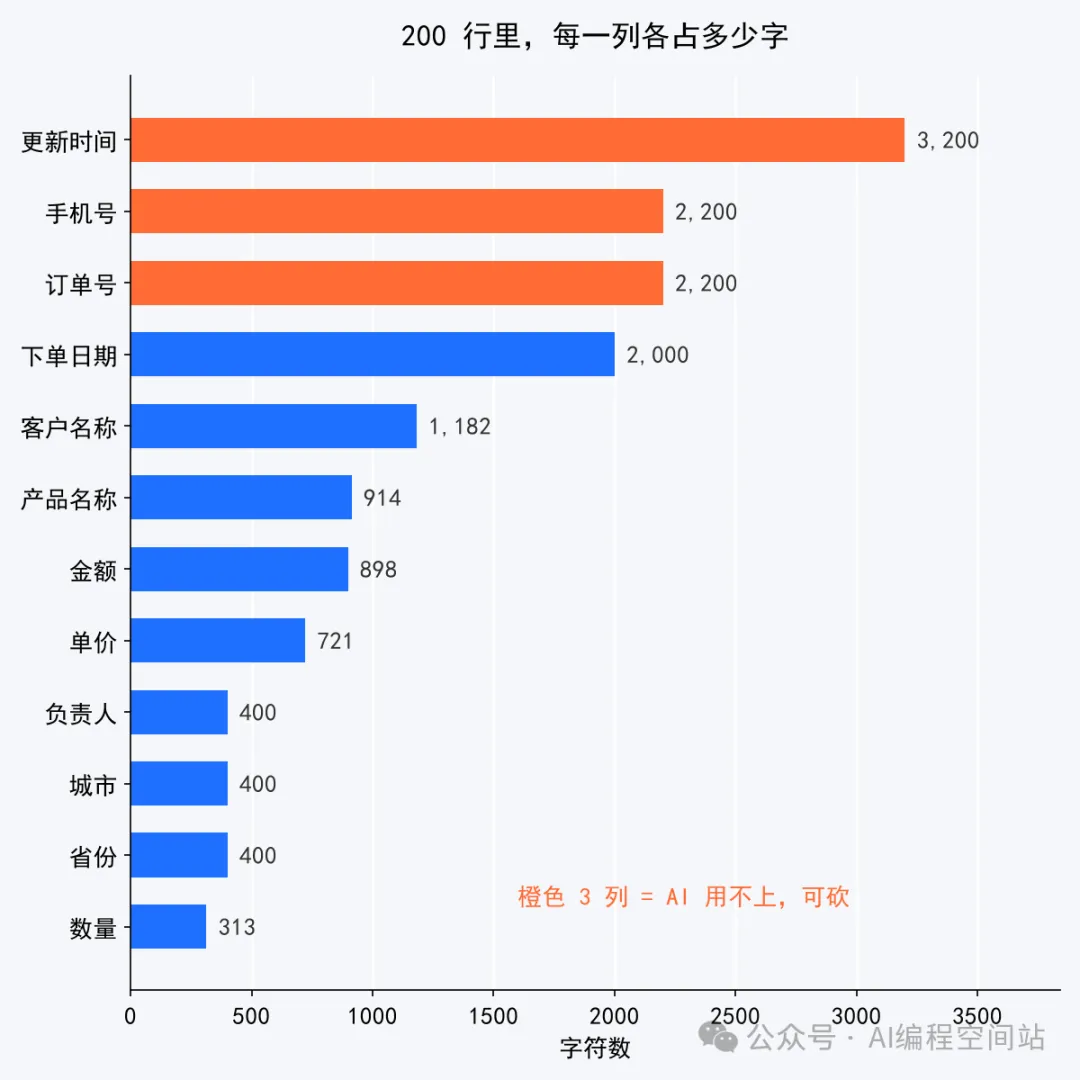
最扎心的是这张图的前三名:更新时间 3,200 字、手机号 2,200 字、订单号 2,200 字——加起来 7,600 字,占了整张表四成多,而对"帮我分析下这个月哪个产品卖得好"这个问题,一个字都用不上。
手机号还多一层:它是客户隐私。你把它连同订单贴上公网模型,等于主动做了一次数据外泄。
砍掉这三列之后,CSV 从 17,275 字掉到 9,062 字,省 47.5%。同样的表格,一半的字是你自己白送的。
为什么这么写
JSON 像每封信都重抄一遍收件人地址。 JSON 的每个对象都要自带一份 key 名,200 行就是 200 份"订单号""下单日期""客户名称"。字段名越长、行数越多,重复得越狠——这才是那 31,002 字噪音的来源。
Markdown 像给每列加了一副相框。 每个格子前后各一个竖线、一个空格,200 行 × 12 列就是近五千个框。它换来的是人和 AI 都更容易对齐列,值不值看你多缺那 5,000 字。
CSV 像一本电话簿,只有名字和号码,没有形容词。 逗号是全世界最便宜的列分隔符,一个字符。所以它噪音只有 14%。
"噪音"这个数是这么算的:总字数减去所有单元格真实内容的字数,差多少就是纯语法开销。这个口径不依赖任何模型,你用记事本数也是一样的结果——所以它可复现。
踩坑提示
① JSON 忘了 ensure_ascii=False,字数直接翻倍。json.dumps 默认把中文转成 \u5e7f\u4e1c 这种转义序列,45,830 字会涨到 94,590 字,2.06 倍。这一条不报错,只是悄悄变贵,最难发现。
② CSV 默认行尾是 \r\n。 Windows 上不写 lineterminator="\n",每行白多一个不可见字符,200 行就是 201 字——17,275 变 17,476。单个文件无所谓,但你拿它算"省了多少"的时候会差一点点,对不上账。
③ Excel 另存的 CSV 带 BOM,第一列列名会读成 '\ufeff订单号'。 然后 COLS.index() 直接抛 ValueError: '订单号' is not in list,你会盯着屏幕怀疑列名是不是打错了。解决办法就一个:open(..., encoding="utf-8-sig")。
一页速查
| CSV | ||
| 先聚合再喂 |
喂之前先砍这三类列:唯一编号(订单号、流水号)、隐私字段(手机号、身份证、地址)、系统字段(创建时间、更新时间、操作人)。
一条命令记住:df.drop(columns=[...]).to_csv(index=False) —— 砍列、去索引、一步到位。
明天见
明天周四,还是文件与办公:同一个 PDF 转 Word,为什么有的表格线全丢、有的连公式都能保住——我会拿三份真实合同各跑一遍,把丢线的原因定位到具体的 PDF 内部结构。
如果这篇帮你省下了每月几十块的 token 费,点个关注,这个号每周一到周日只写一件事:用一段能跑的代码,解决上班族今天真实遇到的小麻烦。
转给那个每次都把整张 Excel 复制粘贴给 AI 的同事,他大概率正在为"内容过长"发愁。