Codex入门:从安装到做出第一张Excel,一次走通
- 2026-11-08 20:32:57
刚打开Codex,第一句话说什么?
AI生成概念图,非真实软件界面或项目现场。
先给它一个看得见结果的小任务:把豆瓣电影资料里的排名、电影名称、年份和评分,整理成一张Excel。
这篇从安装、登录和配置工作目录开始,最后做出一个能打开、能核对的文件。演示沿用豆瓣Top250这个题目,实际处理前10条,不把小样说成已经采完250条。
第一步:从官方入口安装,登录后选Codex
打开ChatGPT官方下载页(https://chatgpt.com/download/),选择与你电脑系统对应的版本,按页面提示安装。
已经装好的,直接打开现有应用。
接下来按这个顺序操作:
打开桌面应用,登录你可使用的ChatGPT账号。 新建一个项目或打开本地文件夹。 在模式入口选择Codex,创建新对话。
截至2026年10月21日,官方桌面入门页给出的就是这条路径。终端里的Codex CLI、编辑器扩展也有各自的入口,初次跟做这篇,用桌面端即可。官方入门说明(https://learn.chatgpt.com/docs/quickstart)
原教程里还有CC Switch接DeepSeek的路线。CC Switch是第三方配置管理工具,接入第三方模型也涉及另外的账号、调用和兼容条件。这篇采用上面的官方登录路线,不把它列为必装软件;也没有重新安装、实测这一第三方组合。CC Switch项目说明(https://github.com/farion1231/cc-switch)
如果账号登录、模式入口还没正常出现,先停在这一步解决,不要拿后面的数据整理指令反复测试登录问题。
第二步:把练习放进一个单独的文件夹
在桌面新建文件夹,叫“Codex入门练习”,在应用里打开它。
这就是本次工作的范围。输入资料放这里,做好的文件也保存在这里,找结果时不用翻下载目录。
模型先用账号当前可用的默认选项。需要读取文件或新建结果时,看清提示对应的文件夹,再按实际需要授权。
先发一句简单的话:
确认目录能正常使用,再放资料。
第三步:取到页面内容,先用10条跑通
打开豆瓣电影Top250(https://movie.douban.com/top250),能看到电影列表后,先取前10条。
你也可以先让Codex读取这个公开页面,说明只要排名、首个中文片名、年份和评分。页面如果要求验证、登录或拒绝访问,就停下来,改用自己正常看到并复制的内容。
本次演示中,公开网页阅读工具能读到首屏资料,但普通HTTP请求返回了418。因此,实际使用的是已读页面的前10条摘录,再由Codex整理成本地Excel;没有绕过访问限制,也没有采集完整Top250。
下面这组资料与随文的《电影页面片段.txt》对应。每部电影依次是排名、片名、年份及类型、评分及评价人数。保存成这个文件名后,放进练习文件夹即可。
这份摘录读取于2026年10月21日。榜单和评分会变化,后续重新取数时,以你那次实际看到的页面为准。
第四步:把需要的Excel说清楚
资料放好以后,复制下面这段指令。它与本次实际保存的输入、结果文件相对应。
你不需要先学会写数据处理代码。Codex可以根据任务生成处理脚本,把页面里的多种信息拆开,再保存成文件。
其中最容易说漏的是“电影名取哪个”和“按什么排序”。没有这两句,外文名可能挤进同一格,原来的榜单名次也可能被评分排序打乱。
第五步:打开结果,再核对一次
本次已经生成《电影榜单_前10条演示.xlsx》,包含10条记录。下面是实际导出结果的预览:
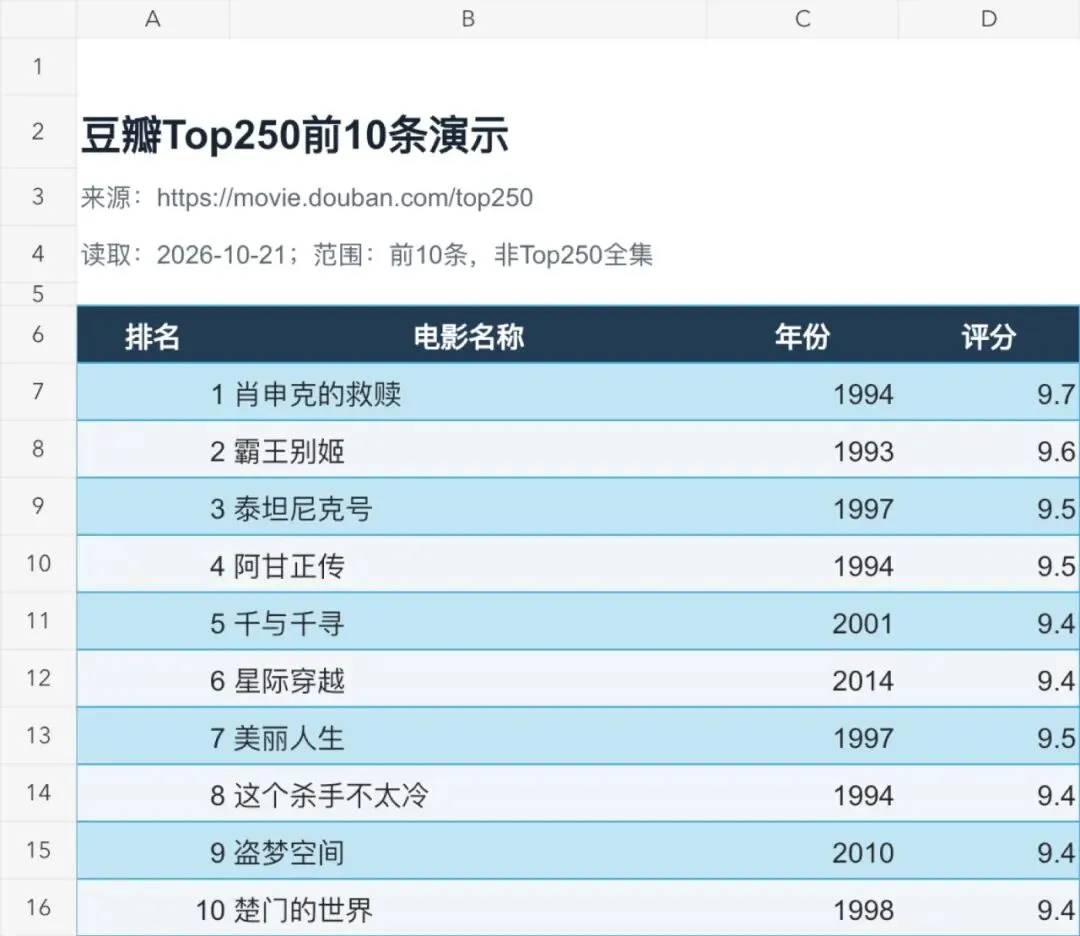
本次实际生成的Excel,10条电影数据,非完整Top250。模拟范围与数据来源见正文。
导出后又重新读取了保存的文件:四列齐全,排名、年份、评分都是数字,没有缺失字段或重复排名;首条是“肖申克的救赎”,第10条是“楚门的世界”。
自己跟做时,也打开Excel看四个地方:
有多少条:这次应该是10条,别被文件名里的“Top250”误导。 片名有没有混进别名:第一部应是“肖申克的救赎”。 年份和评分有没有取错:第一部对应1994年、9.7分,不是评价人数。 顺序有没有变:保留页面排名,同分电影不由AI重新排位。
如果发现一列取错,直接指出具体问题,例如:
先把10条做对,再考虑扩大范围。如果以后处理250条,要逐页确认实际拿到了多少、是否有重复和缺页;只读到了部分,就按部分交付。
这次先完成一件小事:让AI把一页电影资料变成真正的Excel。跑通“给资料、说清字段、保存文件、打开核对”这几个动作,再把它用到你下一份需要整理的资料里。

