AI 做 PPT,最靠谱的路居然最土
- 2026-11-08 19:52:18
先说结论:AI 做 PPT,最靠谱的路不是「生成」,是「改文件」。
这不是我的判断,是 Anthropic 官方那个 pptx skill 自己写的分工。
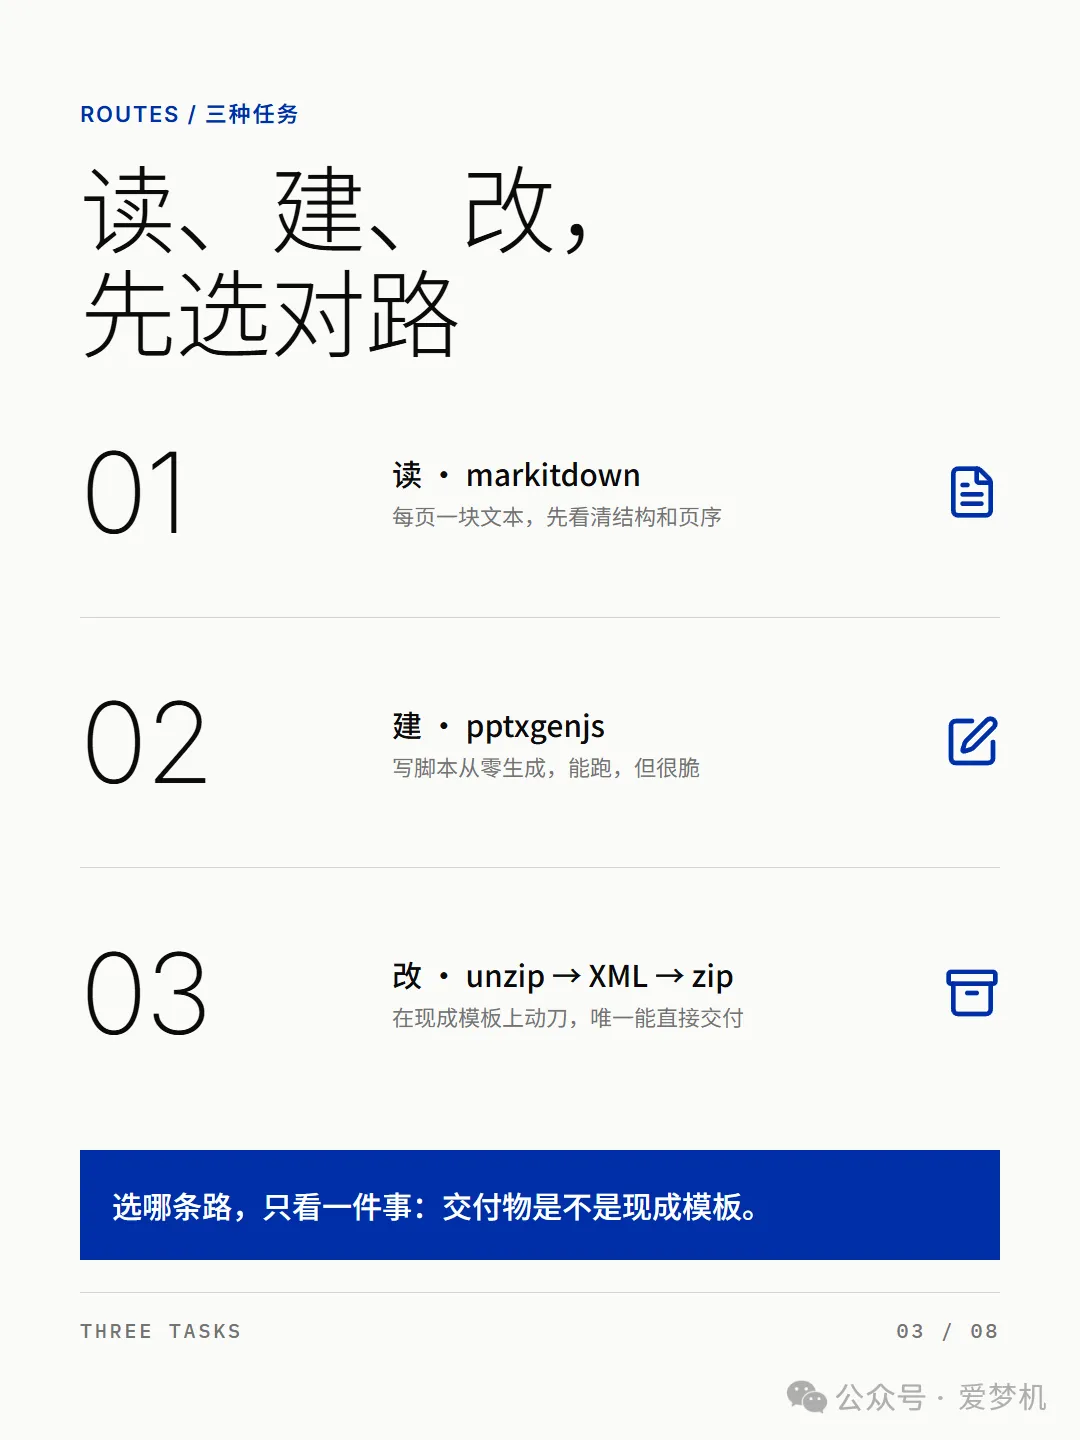
它没有一上来就教你「一句话生成整套幻灯片」,而是先把 PPT 需求分成三类,对应三条完全不同的路。
第一条,读。 用 markitdown 把 pptx 每一页转成文本,先看清结构、页序、每页在说什么。这一步不产出任何东西,但决定了后面会不会白干。
第二条,建。 用 pptxgenjs 写脚本,从空白画布开始画。听起来最像「AI 一键生成」,也是最多人想走的路。
第三条,改。 把 .pptx 当成一个 zip 包解开,只改里面那一页的 slideN.xml,再打包回去。最土,最不性感,也最少人愿意走。
前两条看着先进,第三条看着原始。但真正能直接交付的,只有第三条。
为什么?
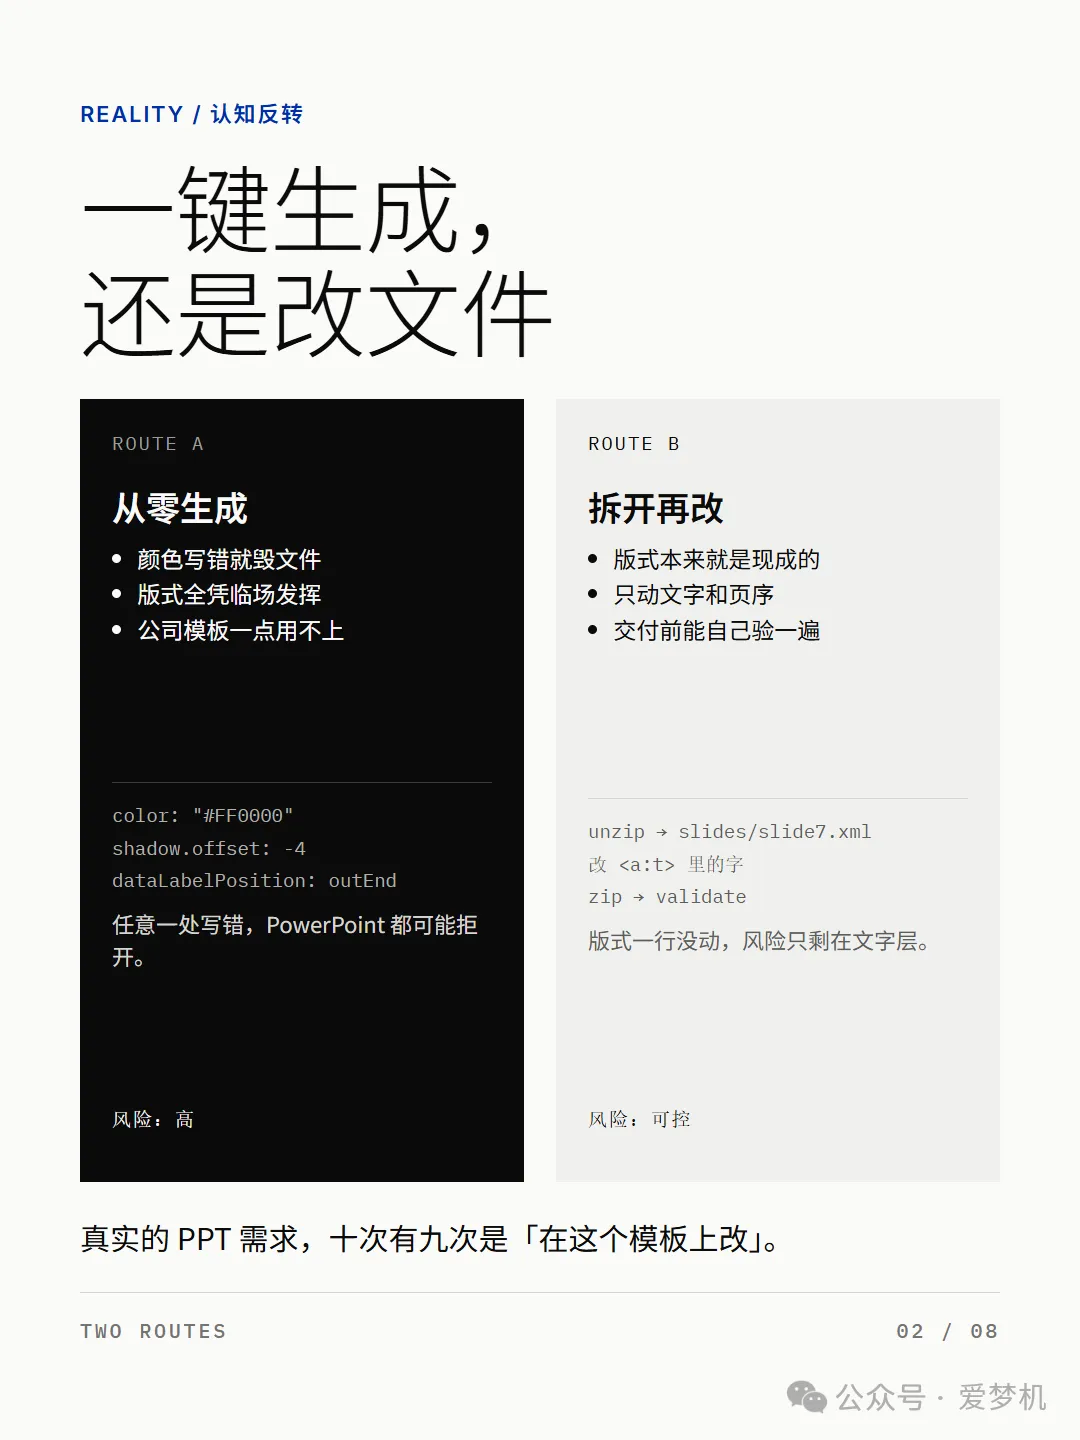
因为真实的 PPT 需求,十次有九次不是「帮我做一份 PPT」,而是「在这个模板上改一下」。
从零生成出来的东西,版式是猜的,字号是猜的,颜色也是猜的。好看可能是真好看,但甲方那份用了三年的公司模板,一眼都用不上,你还是得重做。
而「改文件」这条路,母版、版式、字体占位符、页脚页码全是现成的,你只动文字层。风险被压缩在一页 XML 里,出了问题也能立刻定位到哪一页、哪一个字段。
当然,如果你确实要从零新建,这条路也能走,只是有四个固定的坑在等你。
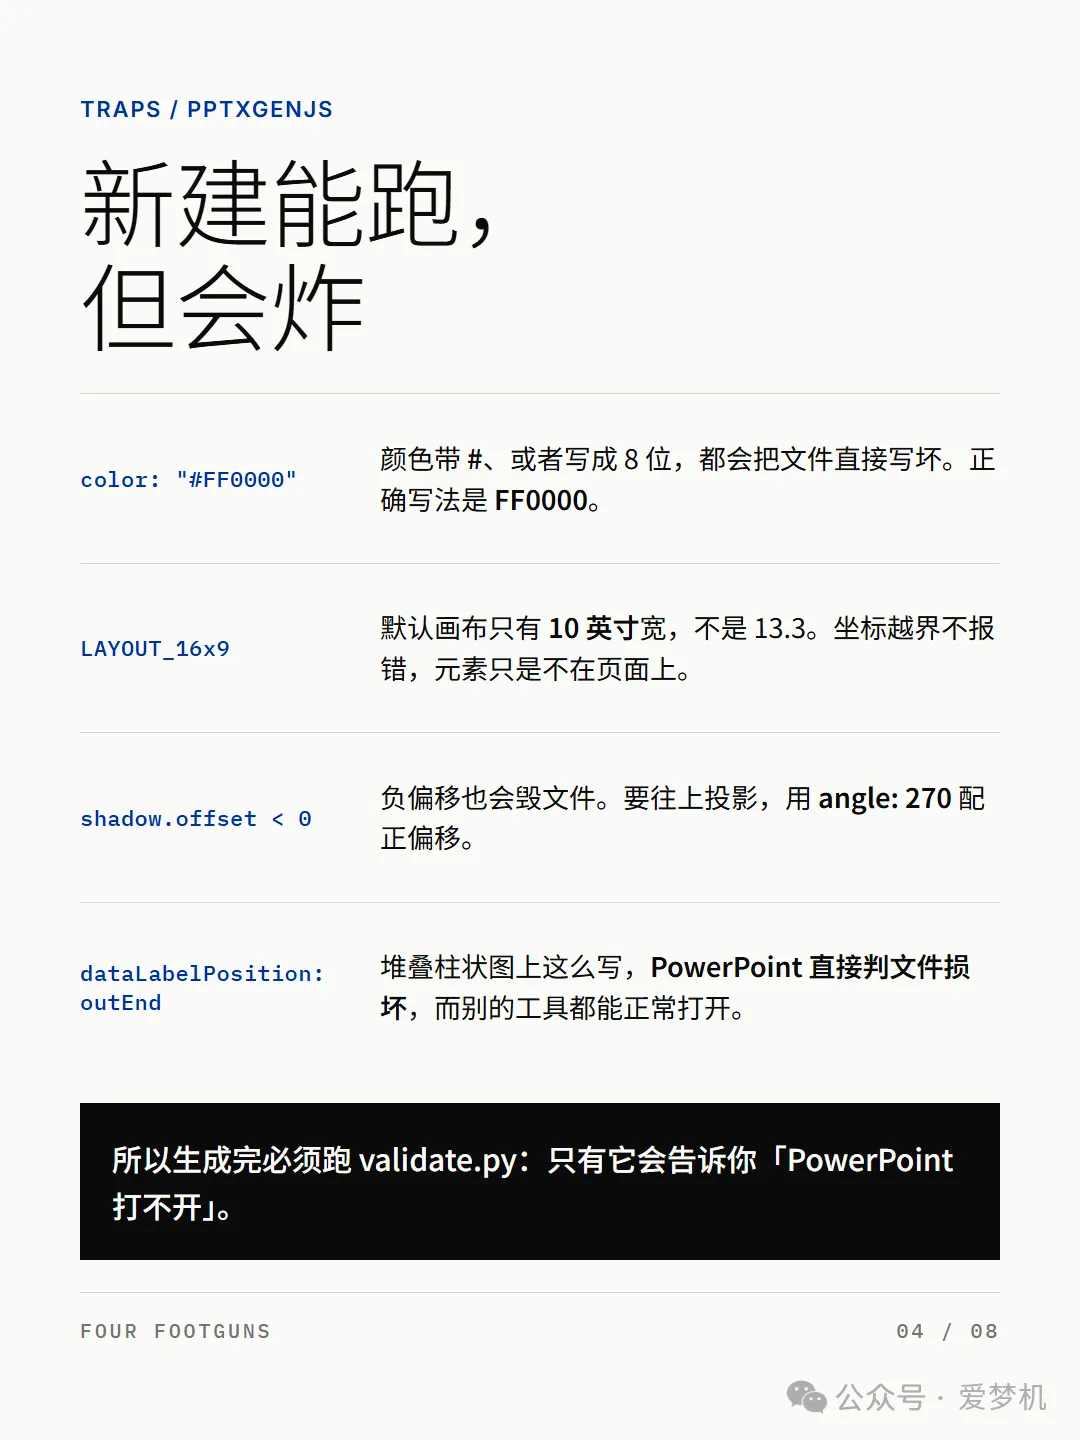
颜色带 # 就会毁文件。 写 "#FF0000" 是错的,正确写法是 FF0000,也不能写成 8 位。
LAYOUT_16x9 不是你以为的 13.3 英寸。 它的默认画布只有 10 英寸宽。坐标算错不会报错,元素只是安静地待在了页面外面。
阴影偏移不能给负数。 想往上投影,得用 angle: 270 配一个正偏移。
堆叠柱状图的数据标签不能写 outEnd。 这么写,PowerPoint 会直接判定文件损坏——而 python-pptx 打开它一点事都没有。
这四个坑的共同点是:工具链全都告诉你「成功」,只有 PowerPoint 告诉你「打不开」。所以官方脚本里才会有一个 validate.py。
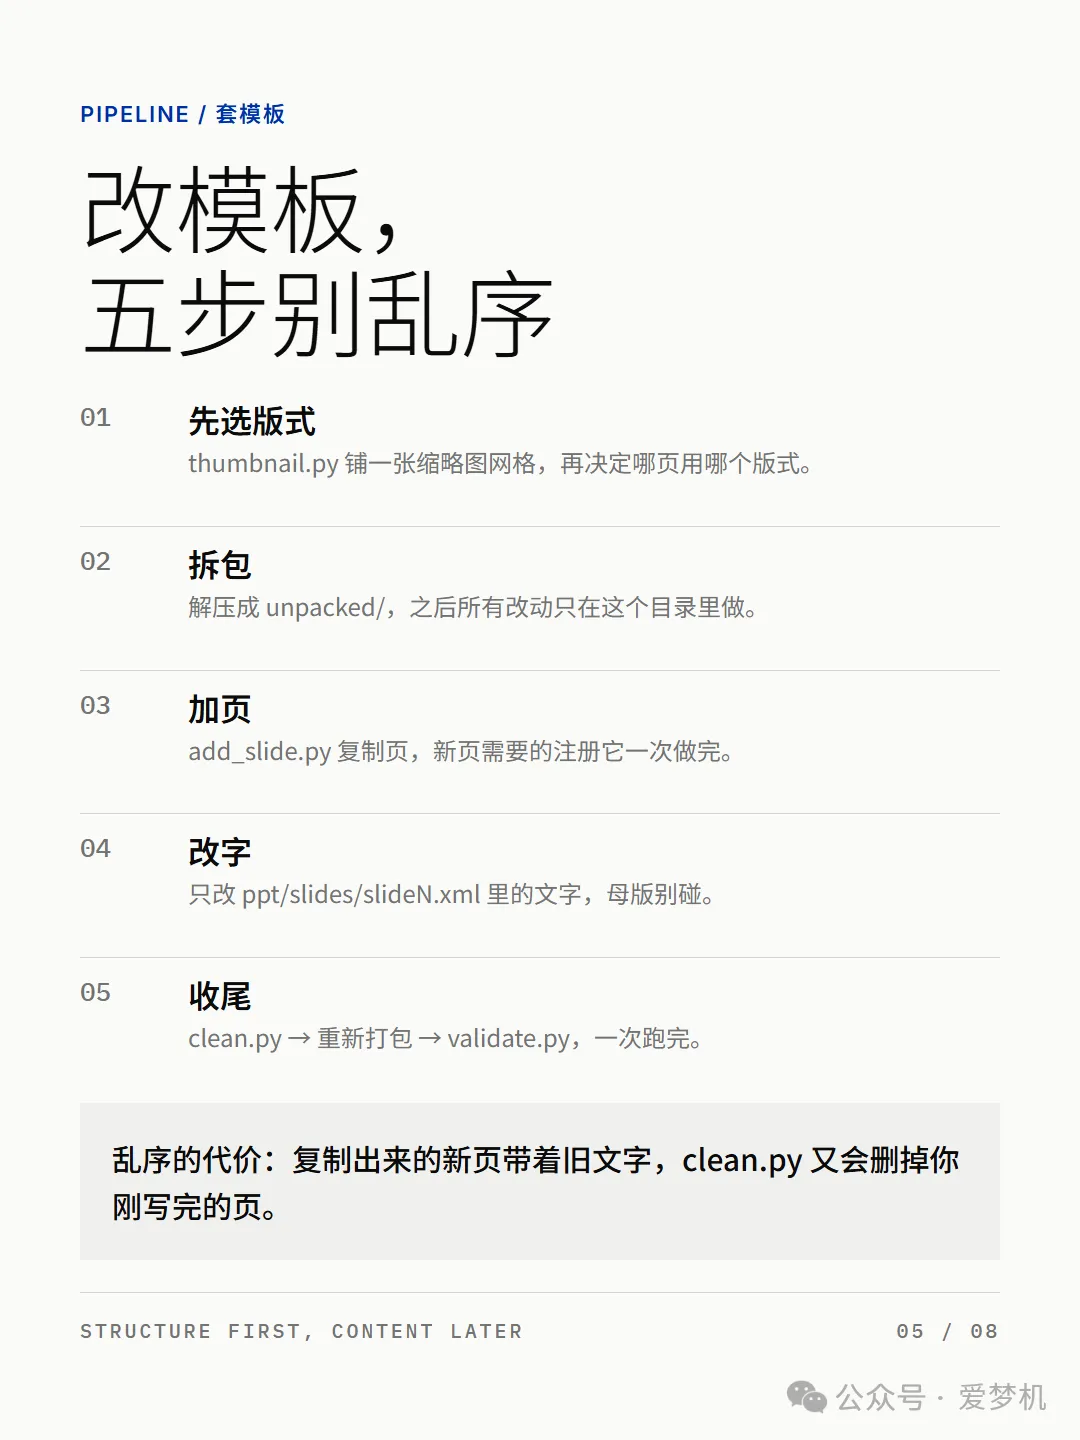
如果你走改造那条路,官方给的顺序是这样的,五步,别乱序。
01 选版式:用 thumbnail.py 先把整份模板铺成一张缩略图网格,看清楚有哪些版式可用,再决定哪页用哪个。
02 拆包:解压成 unpacked/ 目录,之后所有改动都在这个目录里做。
03 加页:用 add_slide.py 复制页,新页需要的注册、关系文件,它一次做完。
04 改字:只改 ppt/slides/slideN.xml 里的文字,母版别碰。
05 收尾:clean.py 清理,重新打包,最后 validate.py。
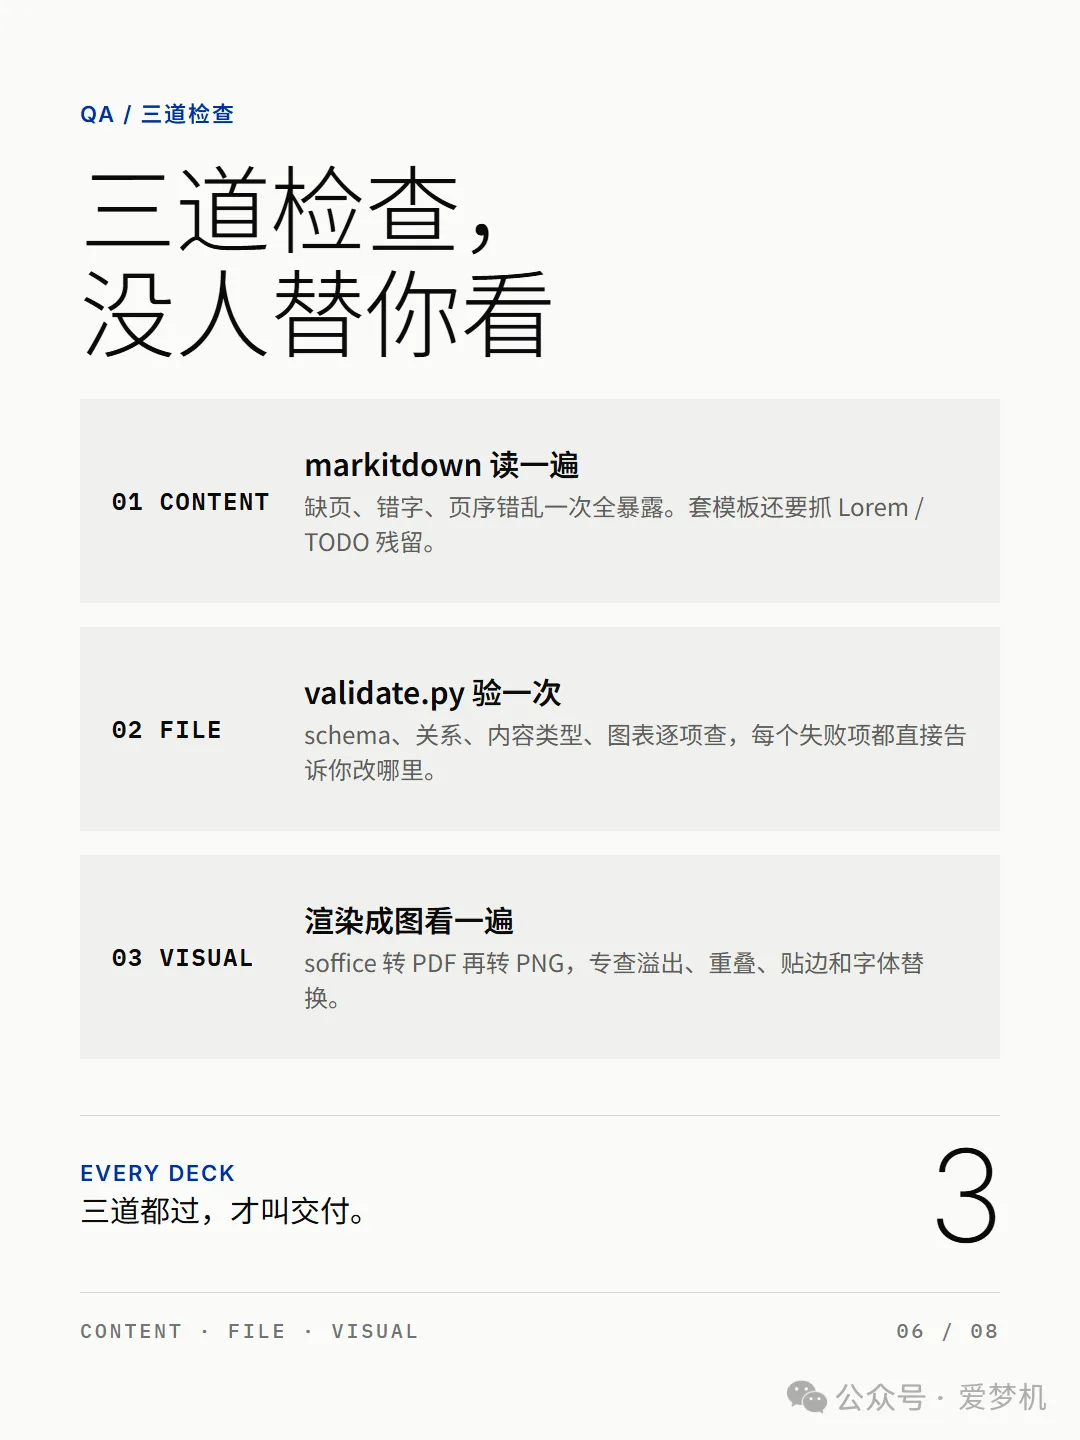
这套流程里最值钱的,其实是最后那三道检查。它们不产出内容,只负责让你别在客户面前打开一个打不开的文件。
内容 QA。 markitdown 把成品读一遍,缺页、错字、页序错乱一次全暴露。套模板的稿子还要专门抓 Lorem、TODO、上次留下的旧公司名。
文件 QA。 validate.py 逐项检查 schema、关系、内容类型、图表,每个失败项都会直接告诉你该改哪里。
视觉 QA。 soffice 转 PDF,再转 PNG,用眼睛看。溢出、重叠、贴边、字体被替换成宋体,只有渲染出来才发现。
完整的命令序列是这样,可以直接抄:
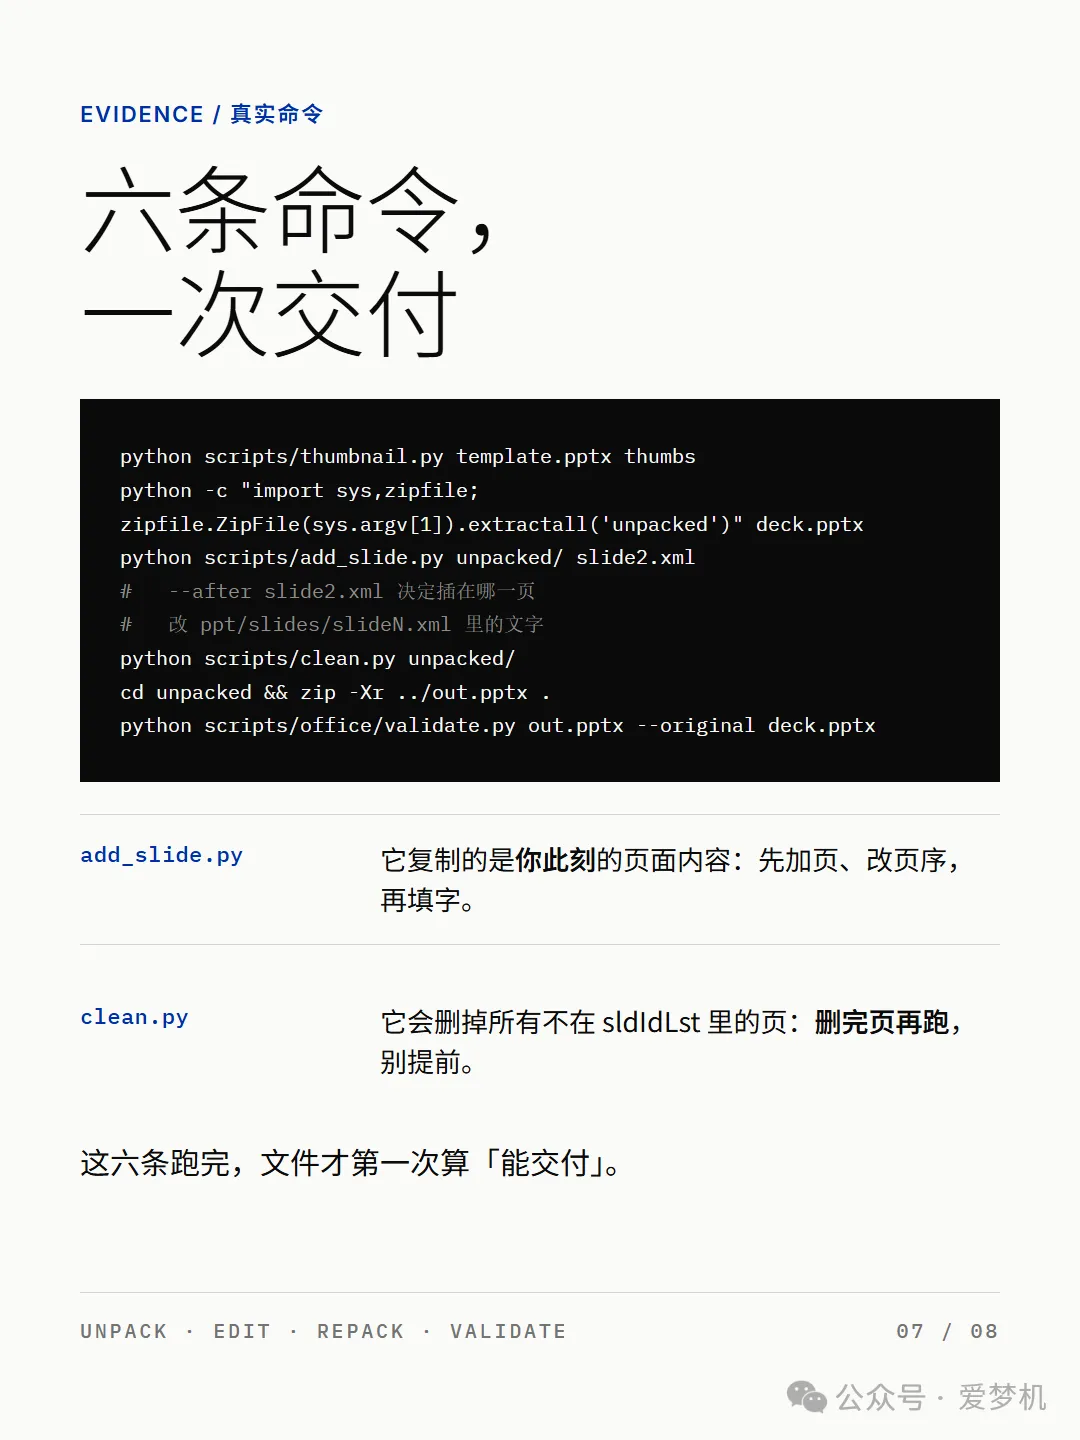
最后还有两个顺序坑,都是脚本行为决定的,不是经验之谈。
add_slide.py 复制的是你「此刻」的页面内容。所以先加页、改页序,最后才填字。反过来的话,你复制出来的新页会带着上一页的旧文字。
clean.py 会删掉所有不在 sldIdLst 里的页。所以删页要在它之前做完,否则你刚写完、还没来得及注册的那一页会被一起删掉。
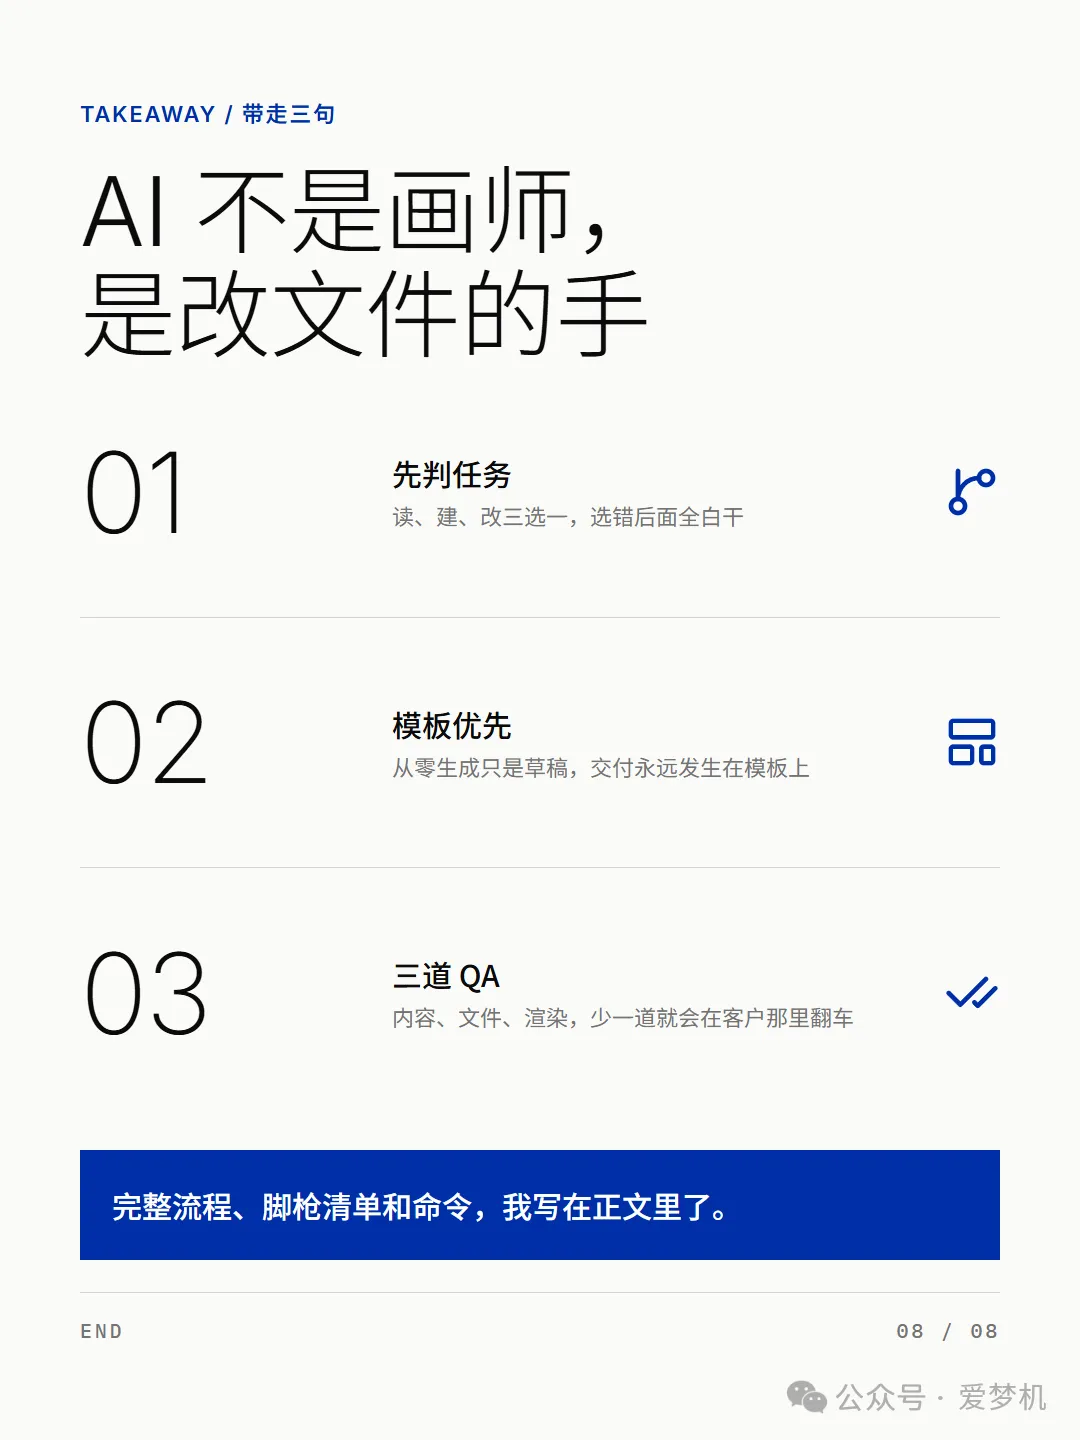
所以 AI 做 PPT 的正确姿势是什么?
别把它当画师,把它当一双能改文件的手。
判断任务、选对路径、模板优先、三道 QA—这四件事做完,AI 才真的能替你交付一份 PPT,而不是交给你一堆看起来很美的草稿。

