背景介绍
2026 上海世界人工智能大会,以 “智能伙伴,共创未来” 为主题,华为集中亮出昇腾 950 真机、Atlas 960 SuperPoD 超节点等重磅成果,同时抛出 Agentic Infra 新范式、“百模千态,云聚共赢” 生态计划,勾勒出国产 AI 算力面向智能体时代的全新发展蓝图。受制于外部制裁带来的制程约束,华为没有硬拼单芯片纸面性能,走出一条系统级突围路线:依靠昇腾 950PR、950DT 差异化双芯片,突破内存墙瓶颈;依托开源灵衢全光互联协议打造万卡级 Atlas 超节点集群,用集群整体算力弥补单卡差距,实现算力利用率大幅提升。
硬件之外,华为搭建起 “根技术层‑核心硬件层‑系统软件层‑行业应用层” 四层全栈自主可控体系,将 CANN 全面开源,壮大开发者与合作伙伴生态。如今昇腾不再停留实验室验证,已经落地医疗、金融、智慧城市、能源制造多个领域,不少方案直接进入政企核心生产系统,国产算力规模化商用时代已经到来。
当然挑战依旧客观存在:单芯片性能和海外头部产品尚有代差,CANN 生态成熟度不及 CUDA,供应链、AI 人才缺口仍是现实阻碍。对此华为一方面迭代芯片路线,持续打磨软件工具链;另一方面加速全球化布局,拓展海外市场。
站在 “十五五” 人工智能 + 行动的时代节点,昇腾生态的价值早已不止芯片与服务器。它为国内千行百业智能化提供自主算力底座,探索脱离海外生态的产业路径。本文将从技术、生态、落地、挑战多维度,拆解 WAIC 之后华为 AI 算力生态的机遇与困局。
华为在2026年世界人工智能大会后,其AI及算力生态的发展态势
核心观点:华为以全栈技术闭环为核心,构建面向智能体时代的算力基础设施生态。
从昇腾950超节点真机首秀,到Atlas 960 SuperPoD架构披露,华为正重塑国产AI算力版图。当前最新状态:Atlas 960 SuperPoD 为华为新一代万卡级超节点,依托灵衢全光互联协议,最大可扩展至 15488 张昇腾卡,具备全局统一内存编址能力华为。通过系统级架构创新弥补单卡性能短板,大幅提升集群算力利用率,面向万亿级大模型与大规模 Agent 智能体训推场景,计划 2027 年Q4推出,可组建百万卡级集群,是国产面向智能体时代的核心算力底座。
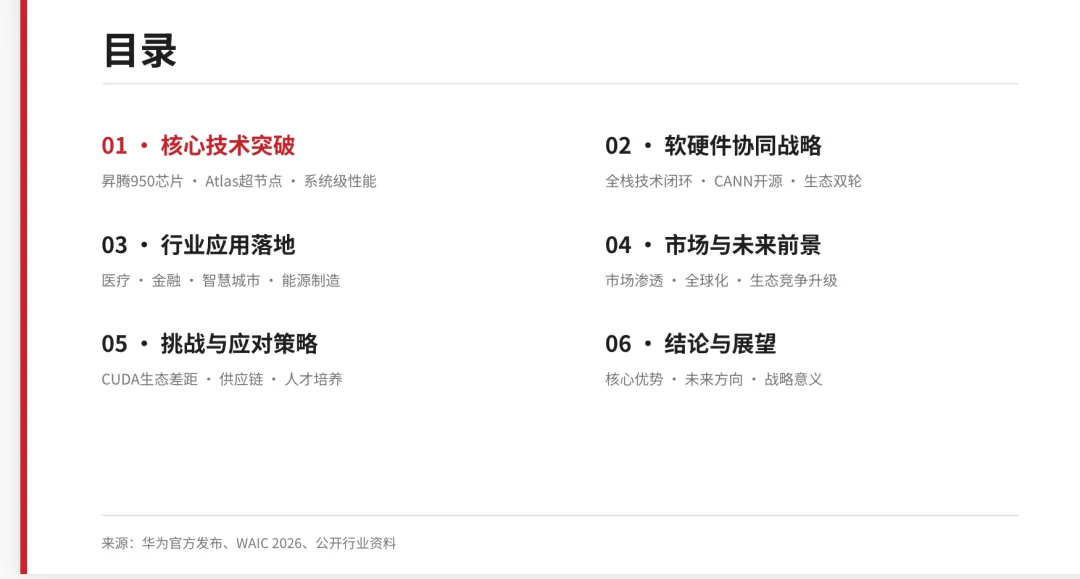
核心技术突破:华为从单颗芯片到万卡超节点的系统级创新路径
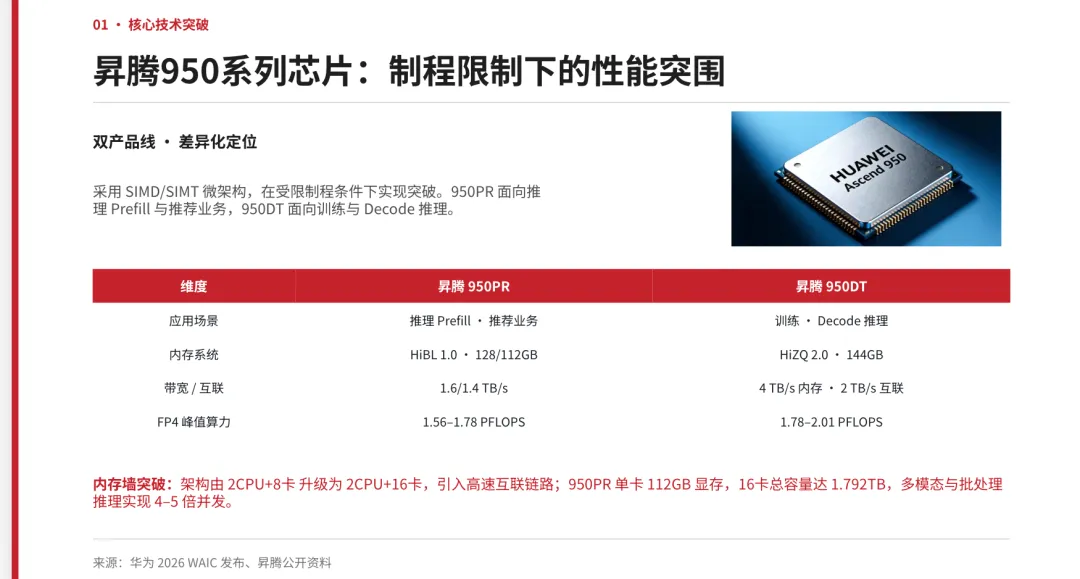
昇腾950系列芯片的两款产品:
950PR 面向推理 Prefill 与推荐业务,950DT 面向训练与 Decode 推理,通过自研内存实现带宽突破。关键创新是内存墙突破:2CPU+16卡架构使16卡总显存达1.792TB,并发提升4-5倍。Atlas 超节点架构
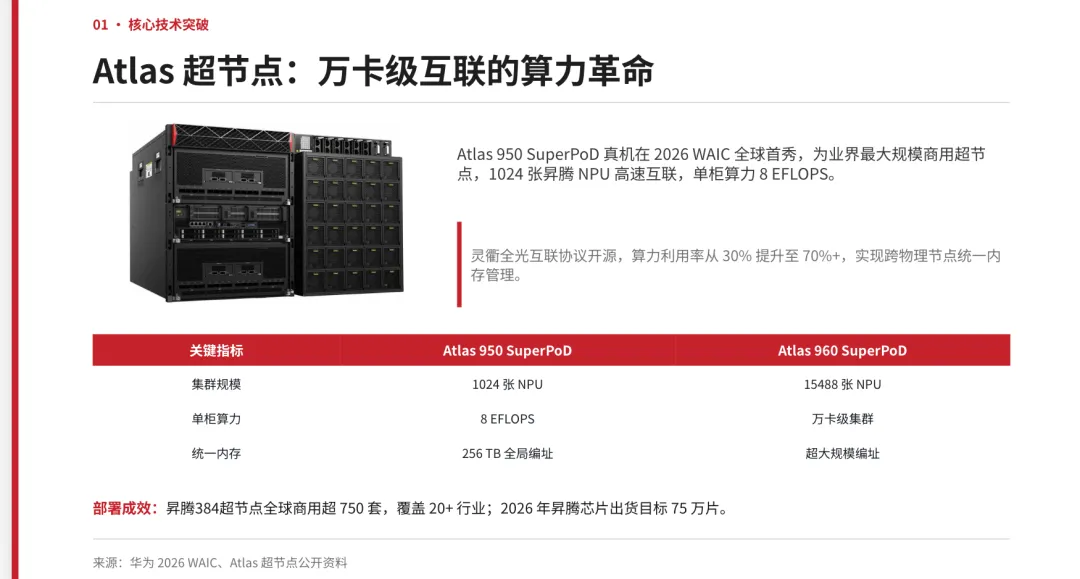
Atlas 950 真机首秀,支持1024张NPU互联,单柜算力8EFLOPS;灵衢协议提升算力利用率至70%+。Atlas 960 将集群扩展至15488卡,是国产万卡集群规模优势的体现。对比昇腾超节点的系统级性能
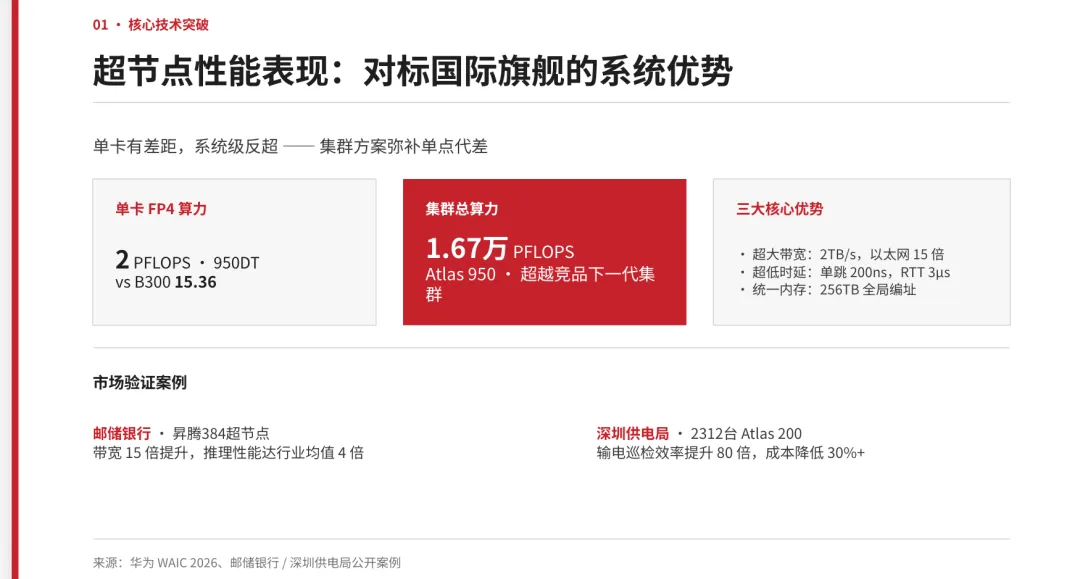
虽然单卡FP4算力与英伟达B300存在代差,但通过Atlas集群实现1.67万PFLOPS总算力,超越竞品下一代集群。软硬件协同战略:
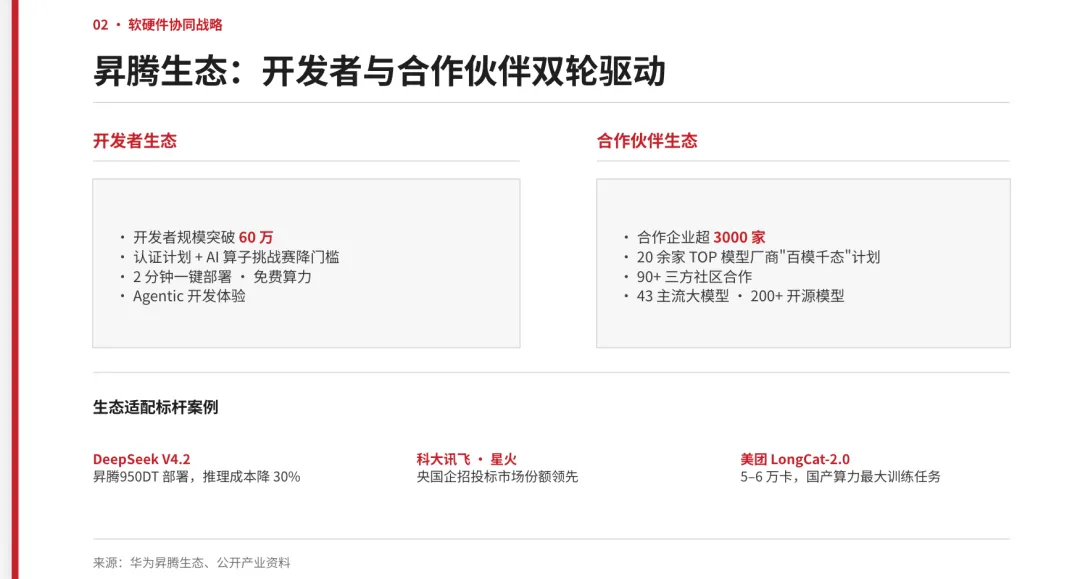
全栈技术闭环、CANN开源生态以及开发者与合作伙伴双轮驱动
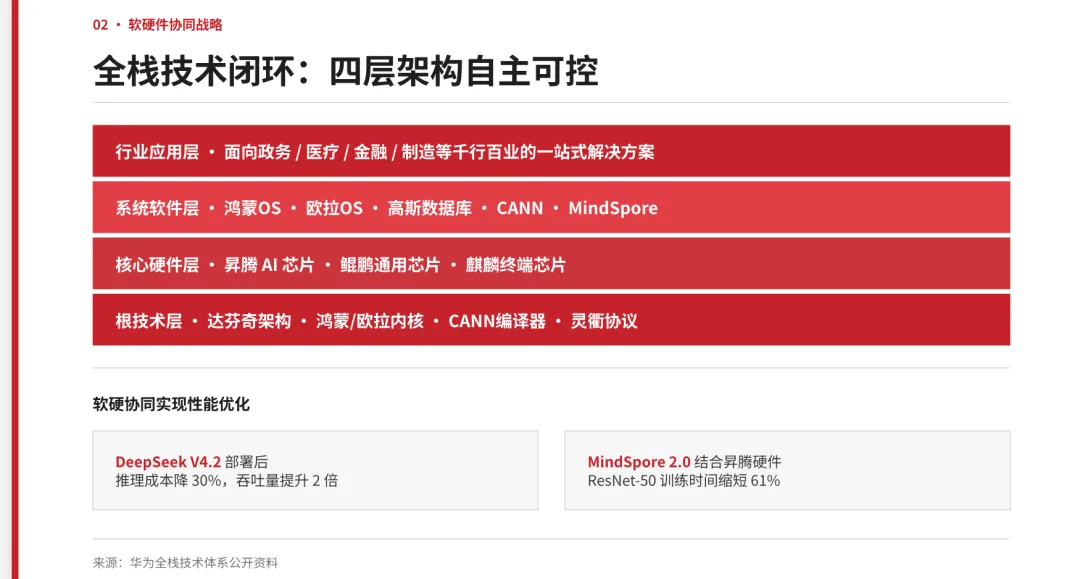
全栈技术闭环四层架构
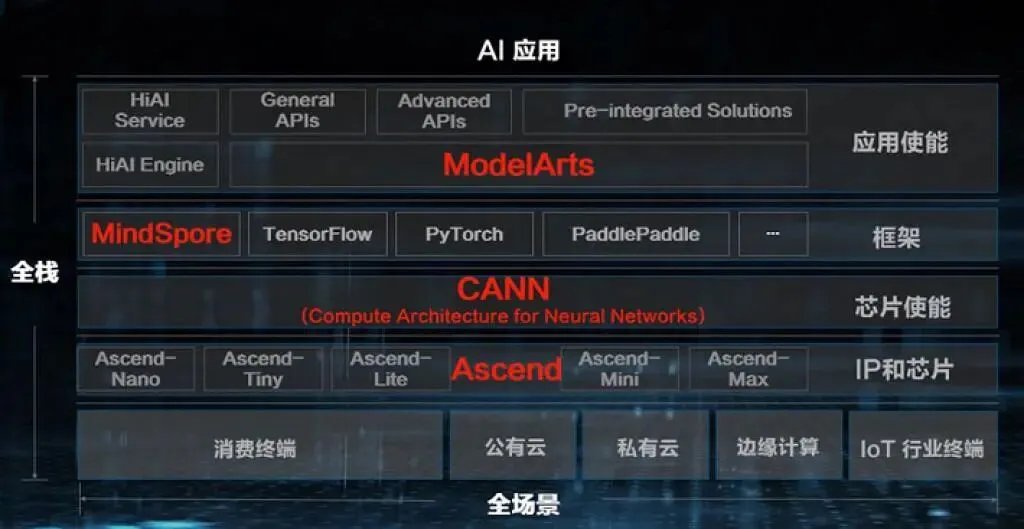
从行业应用层到根技术层,关键环节100%自主可控。软硬协同带来具体收益,如DeepSeek推理成本降30%,ResNet-50训练时间缩短61%。CANN的全称是“神经网络异构计算架构”(Compute Architecture for Neural Networks),它的角色,是把上层AI训练框架(如PyTorch、TensorFlow、MindSpore等)和底层昇腾芯片连接起来的桥梁,让开发者不用关心芯片细节就能调用底层算力。CANN 开源生态
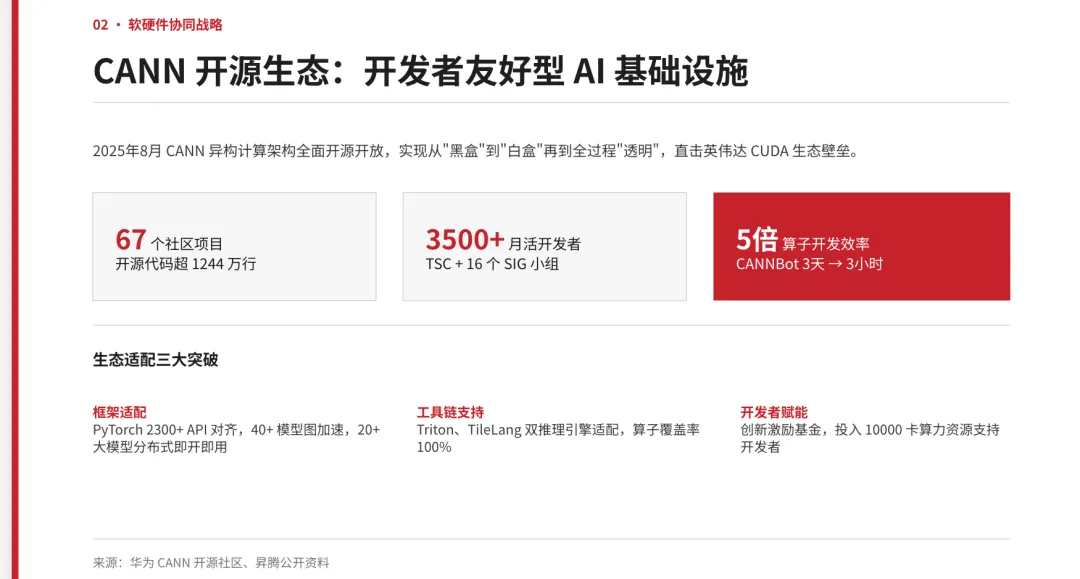
https://www.hiascend.com/cann/核心代码仓库托管于 https://gitcode.com/cannCANN 全面开源是应对 CUDA 壁垒的关键,67个项目、1244万行代码、月活3500+开发者。CANN 开源生态 对标 英伟达 CUDA 生态壁垒:
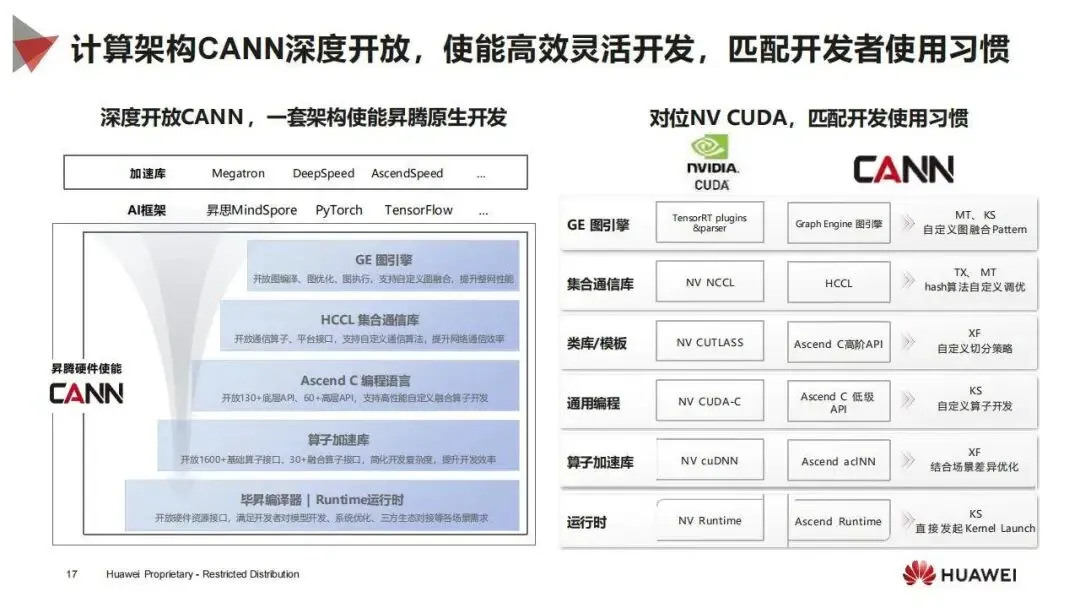
作为国产异构计算底座,CANN 以开源开放策略对冲 CUDA 长期构筑的生态壁垒。
优势上:CANN 深度适配昇腾全栈硬件,配合灵衢互联,在万卡超节点集群调度、MoE 模型训推上可做底层深度软硬协同优化;开源模式降低技术门槛,适配国内信创需求,规避海外技术断供风险,同时借助 CANNBot 等工具降低算子开发成本,快速聚合国内模型厂商与开发者力量。
挑战同样突出:CUDA 历经十余年沉淀,算子库、文档、开源模型资源极为丰富,开发者使用惯性强36氪。CANN 社区积累尚浅,大量存量 CUDA 代码迁移改造工作量大,第三方开源模型原生适配不足,工具链完备度、全球开发者规模仍与 CUDA 存在明显差距,生态建设仍需长期培育。
昇腾生态双轮驱动模式
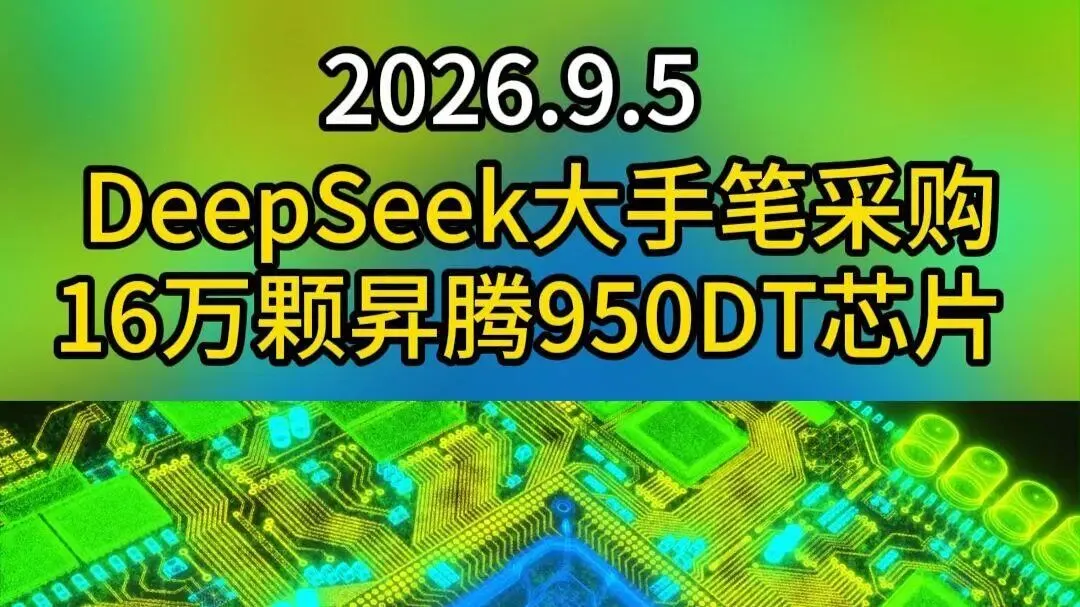
开发者60万+,合作企业3000+,形成强大产业协同网络。DeepSeek、科大讯飞、美团等标杆案例验证生态价值。DeepSeek内蒙古算力超级工程项目:采购16万颗昇腾950DT芯片
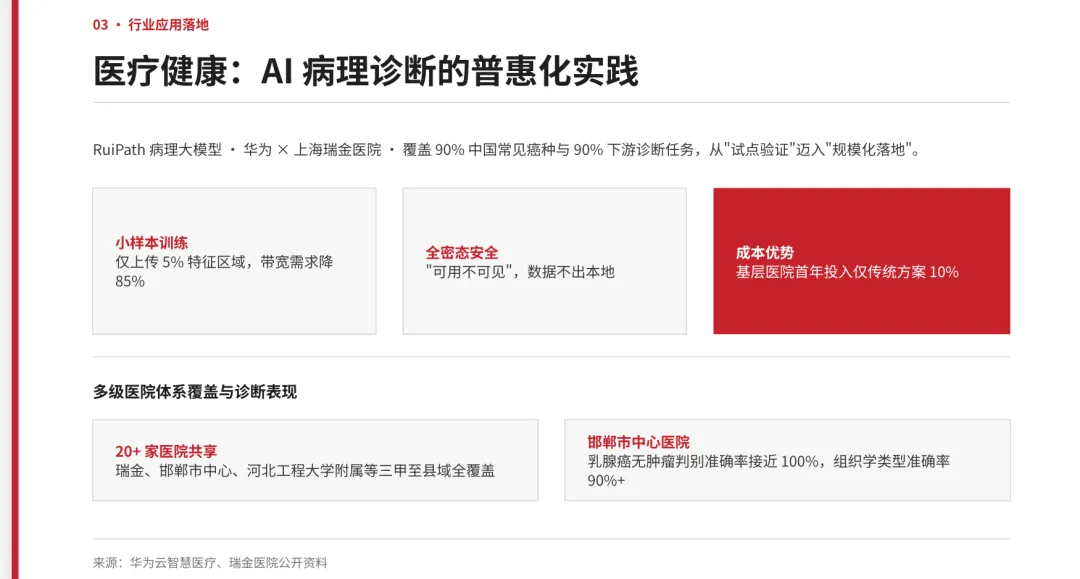
行业应用落地:
医疗、金融、智慧城市、能源制造四大核心赛道的规模化商用。医疗健康领域的RuiPath病理大模型
已共享20多家医院,邯郸市中心医院乳腺癌判别准确率接近100%。金融行业应用:
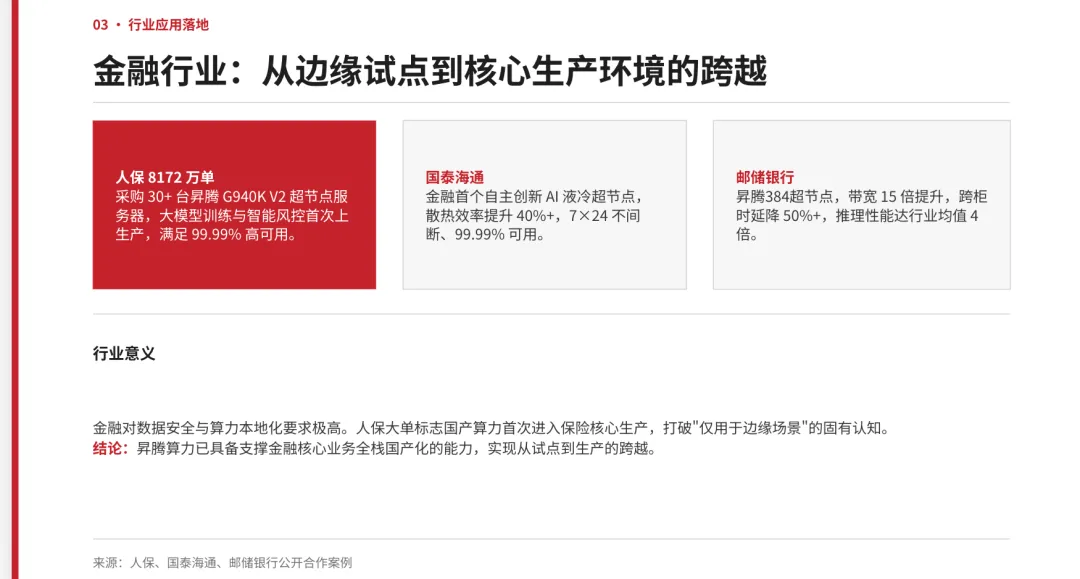
人保8172万国产算力单、国泰海通液冷超节点、邮储银行昇腾384超节点三大案例。智慧城市领域应用:
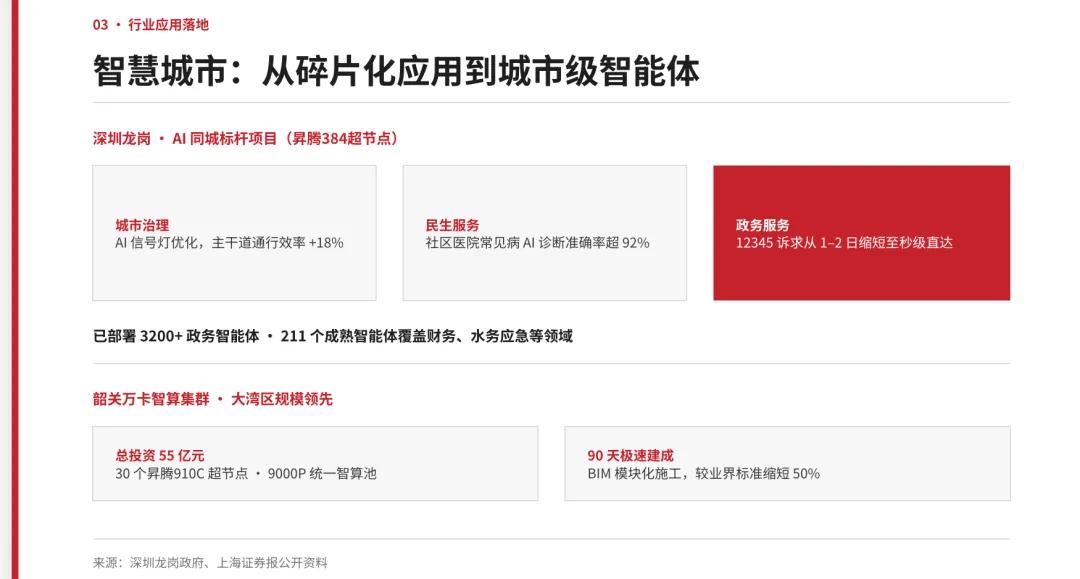
深圳龙岗AI同城项目实现城市治理、民生服务、政务服务三大突破。韶关万卡智算集群90天极速建成,是大湾区规模领先的全国产万卡集群。能源与制造业应用:
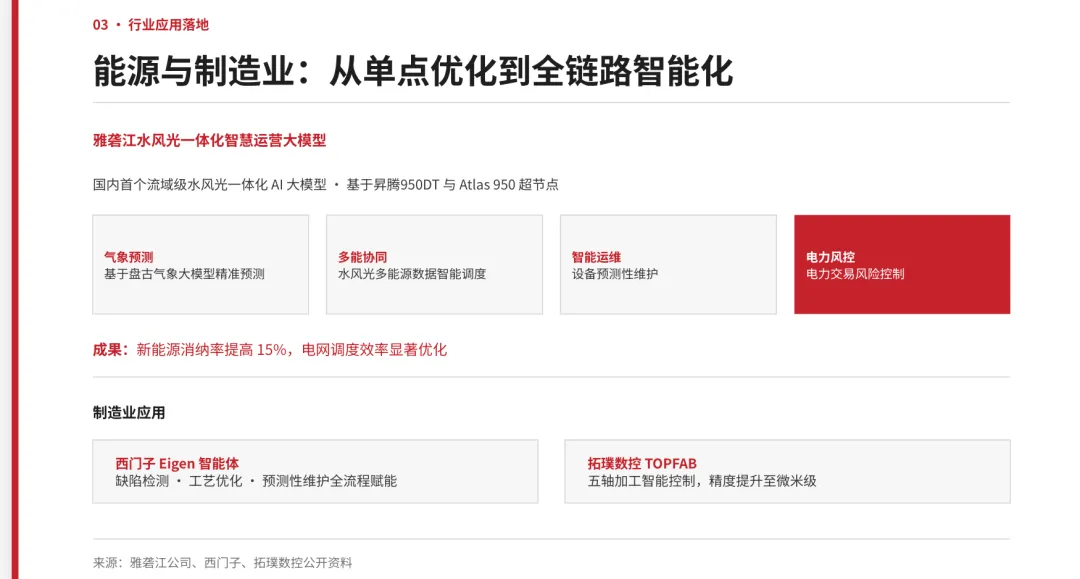
雅砻江水风光大模型实现四大核心能力,新能源消纳率提升15%。西门子Eigen智能体与拓璞数控五轴加工展示制造全链路智能化。市场表现与未来发展前景
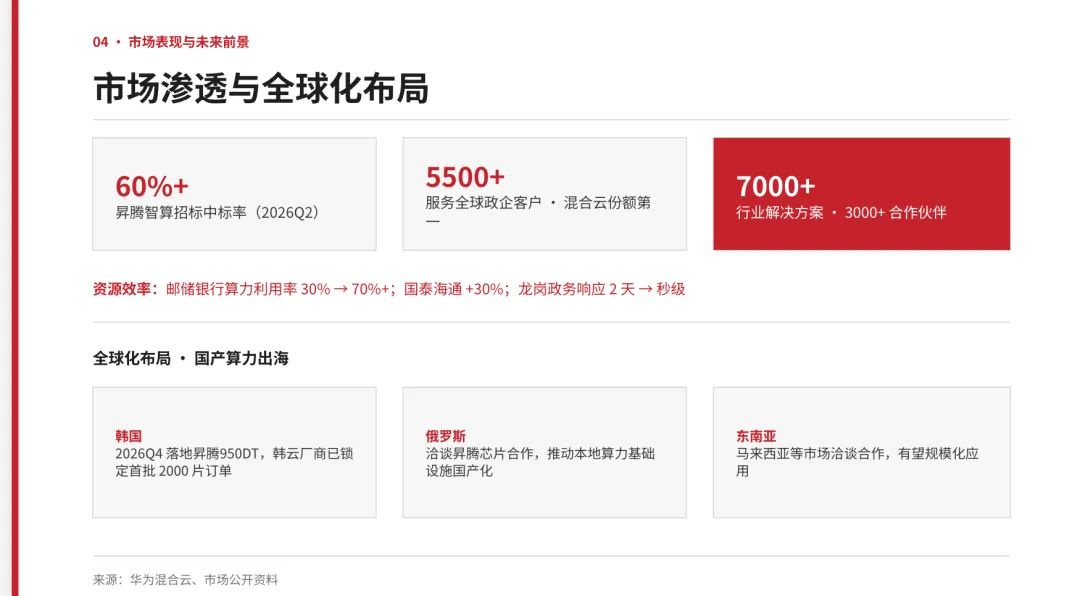
市场渗透、全球化布局以及从算力竞争到生态竞争的战略升级。市场渗透与全球化布局:
国内招标中标率60%+、服务5500+客户、7000+方案。全球化拓展韩国、俄罗斯、东南亚市场,推动国产算力出海。未来发展前景:
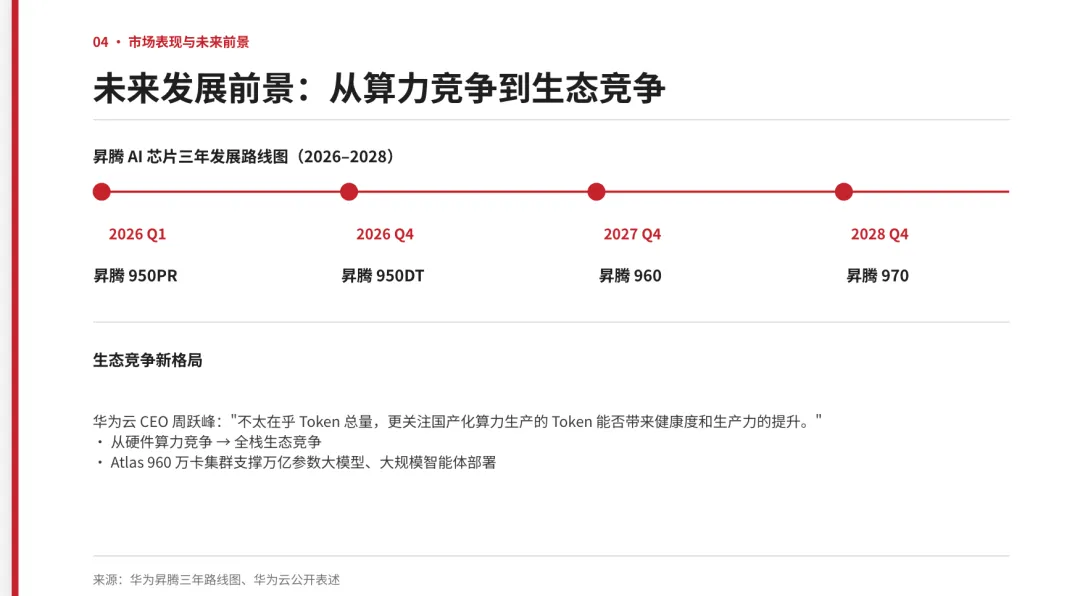
昇腾芯片三年路线图:950PR→950DT→960→970。竞争逻辑从硬件算力竞争转向全栈生态竞争,聚焦算力生产力。挑战与应对策略:
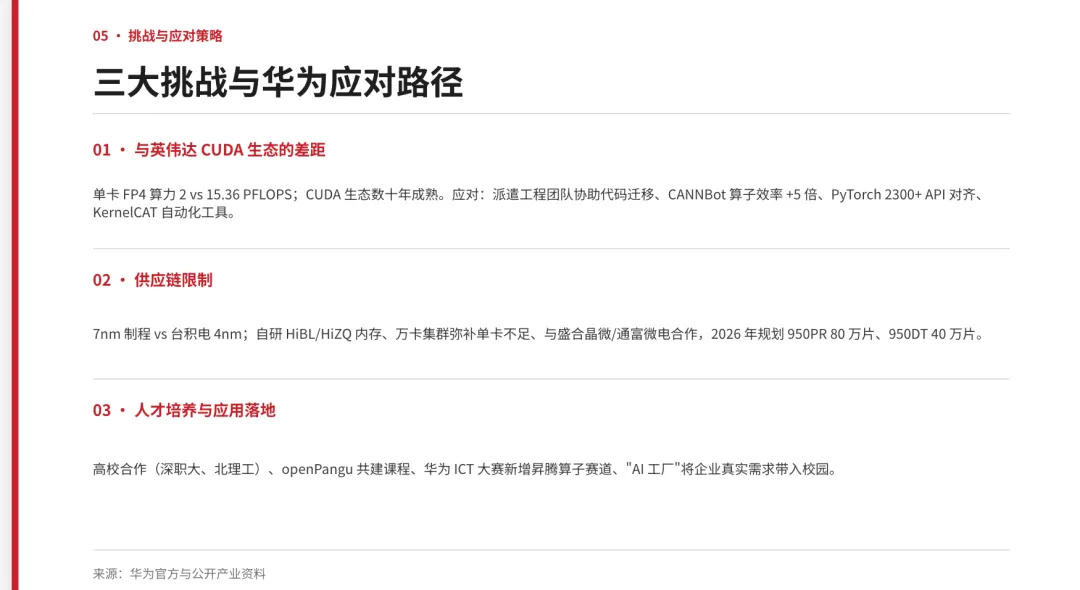
三大挑战及应对:
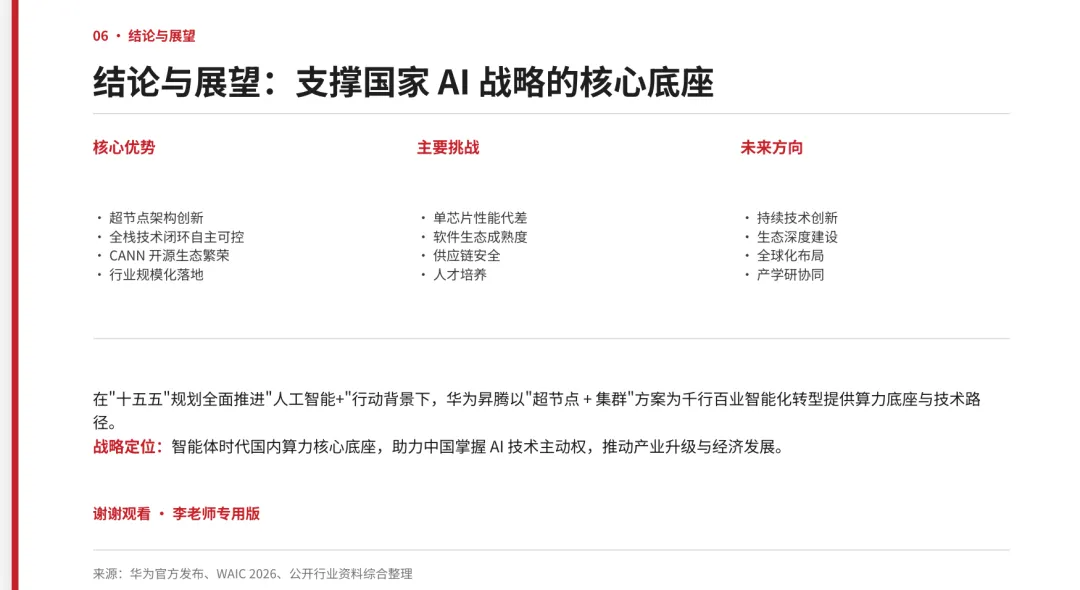
华为通过代码迁移、国产替代、产学研协同三大路径应对。总结核心优势、主要挑战与未来方向
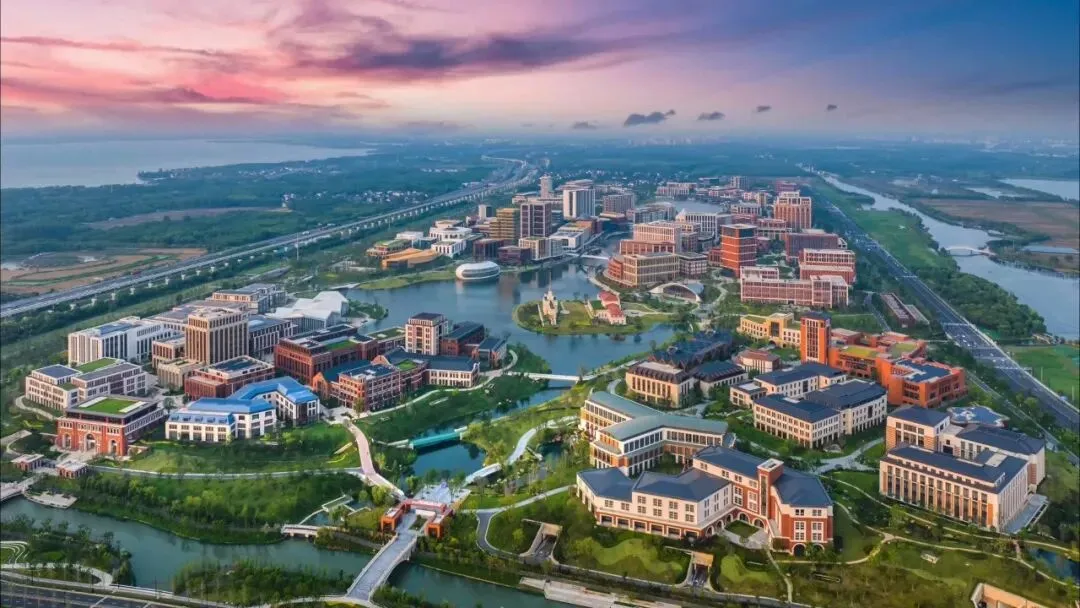
上图:华为上海练秋湖研发中心(华为全球最大研发中心所在地)
央企、中大型民企对接华为 AI 及算力生态顶层设计方案
(思路,大方向,仅限参考)
一、总体定位与设计原则
面向企业庞大存量业务体系,以业务价值优先、安全合规可控、分步平滑演进、开放生态共建为总原则,对接华为昇腾全栈 AI 生态(昇腾芯片 / 超节点、CANN、MindSpore、ModelArts、“百模千态” 伙伴体系)。不追求一步到位大规模硬件采购,坚持场景牵引算力、算力适配业务,兼顾国产化信创要求与现有 IT 资产复用,规避 “重硬件、轻应用” 陷阱,实现从试点验证、生产适配到全业务规模化 AI 转型。打通企业自有业务数据、业务流程与华为根技术底座,构建企业自主可控 AI 能力,支撑风控、生产调度、研发、客户服务、运维巡检等核心业务,兼容混合算力异构现状。二、现状诊断与需求评估(顶层第一步)
业务场景盘点:参考华为 ACT 评估框架,梳理集团各板块高价值 AI 场景,区分外围创新场景、准生产场景、核心生产场景,评估业务收益、数据条件、改造难度、合规风险,优先选择可量化降本增效的场景做灯塔试点。现有 IT 资产摸底:梳理现有服务器、存储、网络、云平台、大模型资产;统计存量 CUDA 体系下的算子、模型、AI 应用清单,明确迁移改造工作量;评估机房电力、制冷,判断是否具备部署 Atlas 超节点、液冷集群条件。数据底座评估:盘点集团多源业务数据,识别数据孤岛、数据质量、数据安全隐私约束,明确密态计算、数据不出域等合规要求,匹配华为 DataArts、全密态计算方案。组织与人才评估:评估内部 AI 算法、算子开发、集群运维人才缺口,规划内部团队 + 华为技术服务 + 昇腾生态 ISV 三方协同模式。输出物:企业 AI 现状评估报告、优先级场景清单、风险清单。李老师注:要加上领导层的战略需求(目标,这个要结合SP、BP了),这个优先级还最高,形成存量+增量+战略(SP、BP)三位一体的评估体系。三、总体架构顶层设计
(四层对齐华为全栈闭环)
1)算力底座层:云‑边‑端协同、训推分离、弹性池化
大型集团可采用混合算力架构:昇腾超节点(Atlas950/384)承担国产训推主力,兼容存量异构算力,通过统一算力调度平台实现资源统一管理;规模选型:试点阶段优先小集群 / 昇腾云裸算力做验证,不盲目上马万卡;核心业务演进阶段按需部署超节点,依托灵衢互联提升集群利用率;边缘业务复用 Atlas200 系列做现场推理;配套基础设施:同步规划高速网络、液冷散热、绿色低碳 PUE 指标,匹配央企绿色算力考核。2)基础软件层:对接 CANN 开源生态,降低迁移成本
基座:欧拉操作系统、CANN 异构架构、MindSpore,对接 PyTorch/TensorFlow 主流框架(2300+API 对齐);工具链:启用 CANNBot、KernelCAT、MindStudio,解决算子开发、模型迁移;存量 CUDA 模型优先采用伙伴迁移服务,实现可验证、可回退;AI 开发平台:基于 ModelArts 构建企业统一 AI 工作台,实现数据集管理、微调、部署、监控、版本管理一体化。3)数据‑模型层:对接 “百模千态,云聚共赢” 生态
引入生态成熟底座大模型(DeepSeek、智谱 GLM、星火等已完成昇腾深度适配),不重复从零训练基础大模型;依托企业私有行业数据做微调、RAG、Agent 开发,建设集团行业模型资产库;落实全密态 “可用不可见”,保障业务敏感数据安全;建设集团 Agent 开发体系,复用 Versatile 平台快速生成业务智能体,面向办公、风控、生产运维场景落地。4)业务应用层:业务系统深度集成
不推倒现有业务系统,通过 API / 服务化方式将 AI 能力注入现有 ERP、生产 MES、风控、客服、调度平台;分阶段:先外围(客服、文档解析、巡检分析)→准生产→核心生产(金融风控、能源调度、制造工艺优化),实现风险可控的迭代上线。5)保障体系(顶层不可或缺)
安全合规:AI 伦理、数据安全、等保、密态计算、审计追溯,满足央国企监管;人才体系:内部培训 + 昇腾认证 + ICT 大赛 + 联合实验室;生态伙伴治理:筛选昇腾认证 ISV、集成商,形成联合开发机制。四、分阶段实施路径
(仅限参考,以实际为准)
阶段一:灯塔试点(0‑6 个月,验证可行性)
选取 2‑3 个高价值低风险业务场景,租用昇腾云或者小规模本地集群;完成 1‑2 个业务模型迁移、调优,输出试点业务指标对比报告;打通数据、开发平台、业务系统最小闭环,摸清迁移痛点、人才缺口;输出:试点样板,验证昇腾生态对自身业务适配度,作为集团扩投决策依据。阶段二:平台建设与准生产推广(6‑18 个月)
根据试点结果,规划自建智算集群规模,按需引入昇腾超节点;搭建集团统一 AI 开发平台,批量完成存量 AI 模型迁移适配;扩大场景,向准生产业务推广,沉淀企业行业模型资产库;阶段三:核心生产深度落地与生态共建(18‑36 个月)
将昇腾算力逐步导入集团核心生产业务(如人保保险风控、邮储银行大模型推理同类模式);参与昇腾 “百模千态” 生态,输出本行业解决方案,共建行业联合实验室。重要原则:迁移可验证、可控制、可回退,禁止直接把核心业务一次性切换到新算力底座。五、风险识别与应对
模型迁移风险:存量大量 CUDA 算子迁移工作量大。应对:优先选用已适配的生态模型;引入华为 / ISV 专业迁移服务;试点先行,非核心业务先打磨经验。人才缺口风险:内部缺少 CANN、昇腾集群运维人员。应对:昇腾认证培训、项目驻场技术支持、产学研联合。算力利用率风险:硬件建设完成但是业务不足,算力闲置。应对:坚持场景牵引,先做业务验证再扩容硬件;集团内部算力统一调度,跨部门共享算力资源。业务兼容性风险:现有业务系统与 AI 能力集成困难。应对:服务化 API 解耦,不改造旧系统内核,增量接入 AI 能力。供应链风险:规划双轨异构算力,不单一依赖某一类硬件。六、组织与保障机制
(顶层能否落地关键)
高层牵头:成立集团 AI 专项工作组,业务部门 + IT 部门联合,避免 IT 单方面推动。三方协同机制:企业(业务 + IT)+ 华为(产品线 / 行业军团)+ 昇腾认证 ISV,明确分工与考核。考核导向:不以算力卡数量为考核指标,以业务降本增效、场景落地数量、模型上线效果作为核心 KPI。经费保障:将经费划分为:场景应用研发经费>软件平台经费>硬件采购经费,扭转重硬件轻软件应用的惯性。七、方案输出交付物清单
(仅参考,以实际为准)
走进华为学习华为
提供企业战略、流程变革咨询、数字化转型咨询(培训+陪跑)服务、AI战略转型咨询及落地服务,联系请加上图中李老师的微信,欢迎交流探讨。