Excel、Markdown、XMind 各写一份?测试用例 Skill 为什么先统一数据模型
- 2026-11-06 19:17:51
测试评审用 Excel,研发希望在仓库里看 Markdown,管理者又习惯用 XMind 浏览。很多团队会顺手维护三份文件,短期看很灵活,需求改两轮后却常出现同一编号对应三种步骤、测试数据只存在于某一份文件的问题。
这类问题表面上看是“用例写得不够多”,实际更常见的原因是输入事实、测试方法和交付格式混在一起:材料缺什么没有标出来,生成器补了什么也没有解释,最后大家只能凭表格外观判断质量。
多格式交付真正需要统一的不是表头,而是表头背后的测试语义。
下面仍然使用 lemon\_testcase 仓库里的登录 Demo,但本篇只聚焦一个问题。所有数量、命令和检查结论都来自本次本地运行;它们用于验证流程,不代表真实生产系统已经通过测试。
三份文件,为什么会慢慢变成三套用例
在日常需求评审、用例设计或回归准备中,这个问题通常会以几种方式出现:
为适配表格宽度删掉测试数据或来源信息 多行步骤转换后无法恢复原有顺序 不同渲染器各自解释业务,导致预期结果发生漂移 需求变更时不知道哪一份才是最新基线
传统做法往往依赖某位测试人员手工整理。经验丰富的人可以补出不少场景,但方法没有固化后,同一份需求换一个人就可能得到完全不同的范围。Skill 的意义不是否定经验,而是把可以重复的步骤变成显式流程。
同一批登录用例,分别导出三种格式
本次执行使用仓库中已脱敏的演示数据。核心命令如下:
python3 scripts/lemon_cases.py render --input functional.json --format excel --output functional.xlsxpython3 scripts/roundtrip_suite.py functional.json本次登录 Demo 以 28 条功能用例为输入,同时生成 Excel、Markdown 和 XMind。回读结果显示 Markdown 用例数仍为 28,XMind 的必要结构有效且案例数量一致。
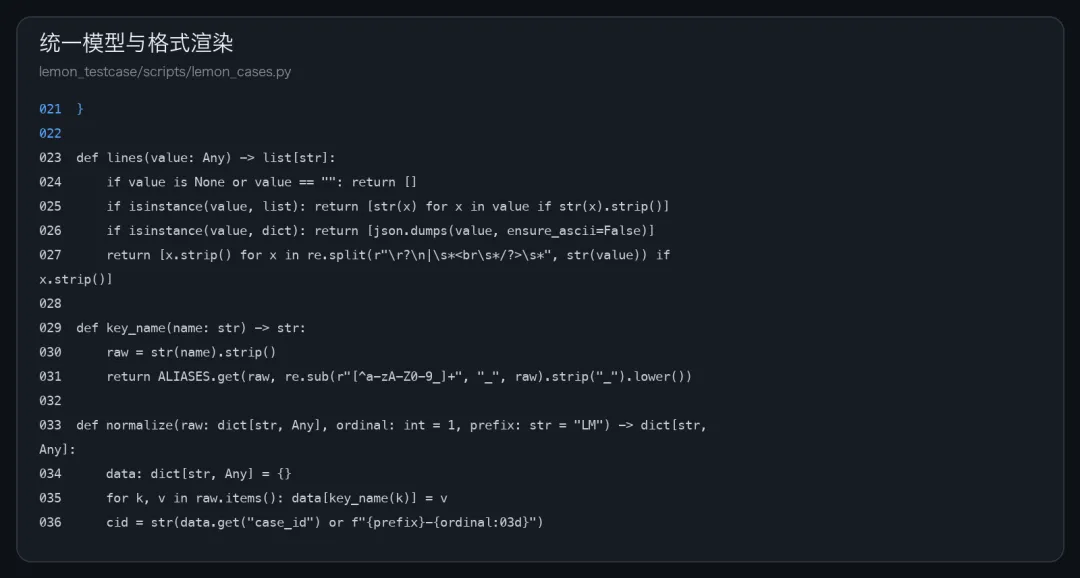
这里需要特别说明,生成数量不是覆盖质量。它只能说明当前输入与规则产生了多少案例;是否覆盖业务风险,还要继续查看来源、断言、状态、数据以及需求映射。
回读一致,究竟证明了什么
回读一致只能证明编号和核心字段没有在转换中丢失,不能证明原始用例本身正确。统一模型解决的是‘多份文件说法不一致’,不是‘业务判断一定准确’。
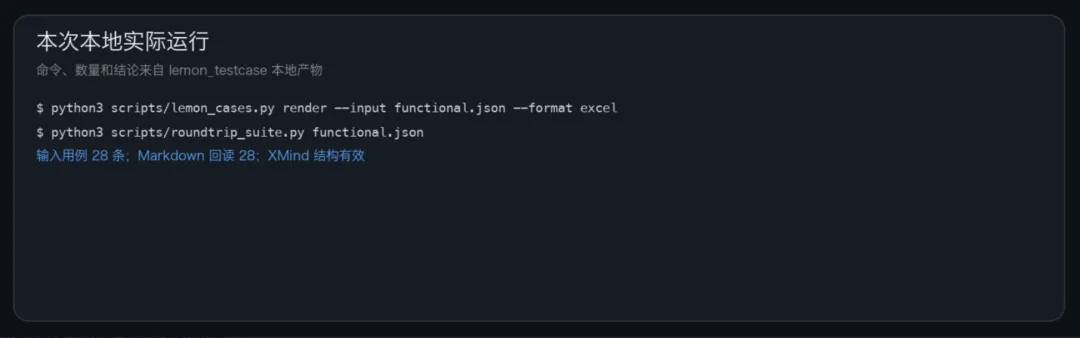
我更愿意保留这种不完美结果。因为技术文章如果只展示绿色通过,会让读者误以为工具已经替代评审。真实项目里,warning、缺口和不确定项恰恰是测试人员应该继续追问的地方。
先守住测试语义,再谈输出格式
lemon\_testcase 先把案例保存为 canonical JSON。编号、标题、模块、流程类型、测试方法、前置条件、步骤、数据和断言都只在这一层定义;Excel、Markdown、XMind 只是读取同一对象并换一种展示方式。渲染器没有权限重新推断业务。
这套设计有一个共同原则:先保留事实,再应用测试方法,最后才选择输出格式。没有事实依据的规则进入待确认项;自动检查发现的问题按 error、warning、info 分级;“实际结果”必须等待真实执行。
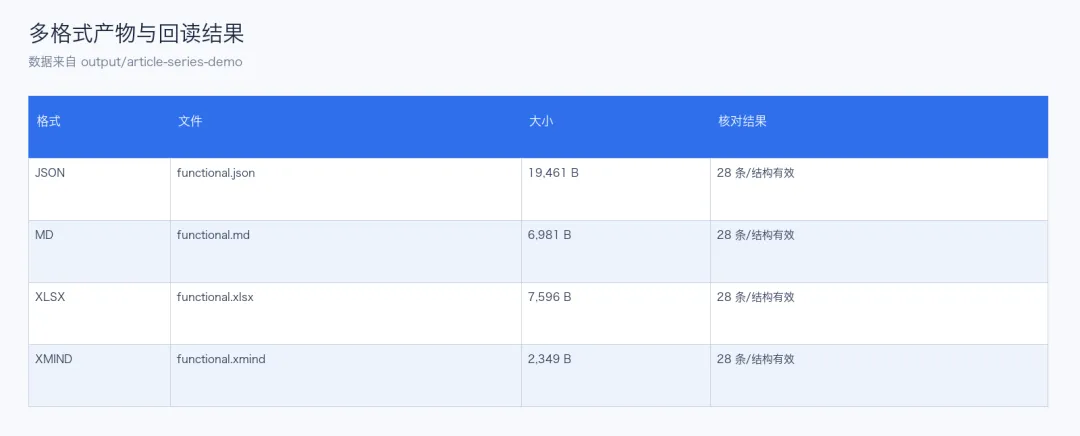
源码截图的目的不是证明实现没有问题,而是让读者知道文章中的能力具体由哪个模块承担。能看到实现位置,后续出现偏差时才能继续定位输入、生成、校验还是渲染环节。
格式没丢字段之后,还要检查这些内容
无论生成的是功能、接口、UI、性能还是自动化候选用例,进入评审和执行前都建议检查:
来源是否能支撑用例中的业务结论 测试数据能否在当前环境真实准备 步骤是否允许另一名测试人员复现 预期结果是否可观察、可判定 warning 与待确认项是否分配了负责人 实际结果是否来自真实执行,而不是生成器预填
如果执行结果与预期不一致,也不要立即认定为产品缺陷。可能是需求版本变化、环境配置差异、测试数据失效、接口契约滞后,也可能是 Skill 在抽取或扩展时理解偏差。需要回到来源材料建立证据链。
把统一模型放进团队协作流程
更实际的使用方式,是把 Skill 放在需求评审之后、正式用例评审之前。测试人员先确认材料版本和范围,再让工具完成结构化整理与第一轮场景扩展;随后围绕高风险规则、历史缺陷和环境限制做人工补充。这样既保留生成速度,也不会跳过专业判断。
评审结束后,建议同时保存 canonical JSON、最终 Excel、质量报告和待确认项。JSON 用于后续转换和差异比较,Excel 用于执行,质量报告记录机器发现的问题,待确认项则进入需求或接口沟通。下一次版本变化时,应基于稳定编号比较差异,不要重新生成后直接覆盖人工维护内容。
真正执行时,可以先选择少量 P0 用例做冒烟验证。若步骤、数据或断言无法落地,就回到用例层修正;若真实系统与已确认需求不一致,再进入缺陷流程。通过这种顺序,团队能区分生成偏差、环境问题、文档滞后和产品缺陷,避免把所有不一致都算到系统头上。
什么团队值得维护这套中间模型
适合需要多格式交付、测试平台接入和长期维护的团队。若团队只有一次性表格且没有复用需求,统一模型带来的收益会相对有限。
更稳妥的定位,是把输出看作一份结构稳定、可以继续评审和修改的测试用例初稿。它帮助我们少做重复整理,但最终的风险取舍、业务确认和执行结论仍由测试工程师承担。
回到开头,测试用例 Skill 真正要稳定的,不是一次生成多少条,而是从输入事实、测试方法、具体数据、质量检查到交付格式的整条路径。
当这条路径可追踪,工具的结果就不再是一张来历不明的表格。我们可以知道它用了什么材料、做了哪些扩展、暴露了什么风险,也知道哪些地方必须停下来人工确认。对软件测试来说,这种可解释、可复核的起点,比单纯追求生成速度更有价值。

