课证融通图谱化①|岗位能力清单A:从 Excel 到能提问的知识图谱
- 2026-10-25 03:08:05
课证融通图谱化①|岗位能力清单A:从 Excel 到能提问的知识图谱
教研室做课证融通材料,最折磨人的环节在画图。
清单本身躺在 Excel 里挺老实:7 项典型任务、16 个工作步骤、每步要哪些能力哪些知识哪些素养、哪门课支撑哪一步,一行一行清清楚楚。但一把它画出来,麻烦就来了——我用 XMind 画过,用幕布画过,最后都停在同一个尴尬的位置:图是树,数据是网。
这篇文章记录我把《岗位能力清单A》从 Excel 做成一张可检索、可提问的知识图谱的全过程。最终产物是一个单文件 HTML:108 个节点、325 条边,浏览器打开就能拖、能搜、能问。
一、政策要求摆在那,图的形式该升级了
课证融通不是学校自己拍脑袋的事。2019 年《国家职业教育改革实施方案》启动 1+X 证书制度试点,学历证书和职业技能等级证书要开始对接;2021 年 4 月全国职业教育大会首次提出“岗课赛证”综合育人,同年 10 月中办、国办《关于推动现代职业教育高质量发展的意见》把它写了进去——“按照生产实际和岗位需求设计开发课程”。2022 年新修订的《职业教育法》施行,证书与课程的融通有了法律依据。
文件要求“融通”,落到材料上就是一张映射关系表:岗位要会什么、证书要考什么、课程要教什么,三者对得上号。
问题出在展示形式。我观察过不少学校交上去的材料,包括我们自己前几版,能力图谱基本都是思维导图——一个中心主题,向下发散分支,分支再发散分支。
思维导图不是不能用,是装不下这份数据。
二、思维导图和知识图谱,差的不只是长相
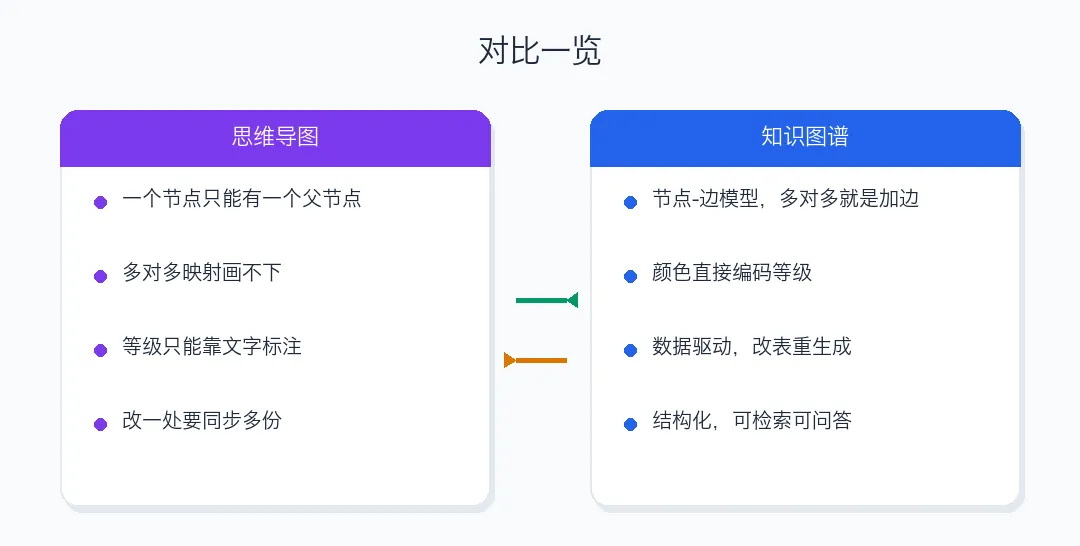
我拿《岗位能力清单A》的数据试过一次思维导图,四个坎过不去:
树装不下网。 思维导图是严格的父子层级,一个节点只能有一个爹。但课程映射是多对多:《数据库技术》同时支撑“向量检索与优化”和“微调数据集构建”两个步骤,“微调数据集构建”又被《Python数据处理与分析》等好几门课支撑。画成树,要么复制节点(数据从此不一致),要么不画(映射关系丢失)。
改一处,忘三处。 思维导图靠手工维护,Excel 里改了某个步骤的能力要求,导图那一份、PPT 那一份、课程标准那一份,总有一两份忘了同步。
等级只能靠打字。 我们的能力分核心、重要、一般三级,思维导图里只能用文字标在后面,一眼看不出哪个步骤压着什么等级的担子。
图是死的。 评审专家想问“AI-01-01 这个步骤到底需要哪些能力”,思维导图只能靠自己拿眼睛找。
知识图谱的节点-边模型刚好把这四件事接住了:多对多就是多加几条边;数据驱动,改 Excel 重新生成就行;等级用颜色编码;结构化之后就是可计算的——这一点的用处最后才显现出来,后面细说。
三、先看成品
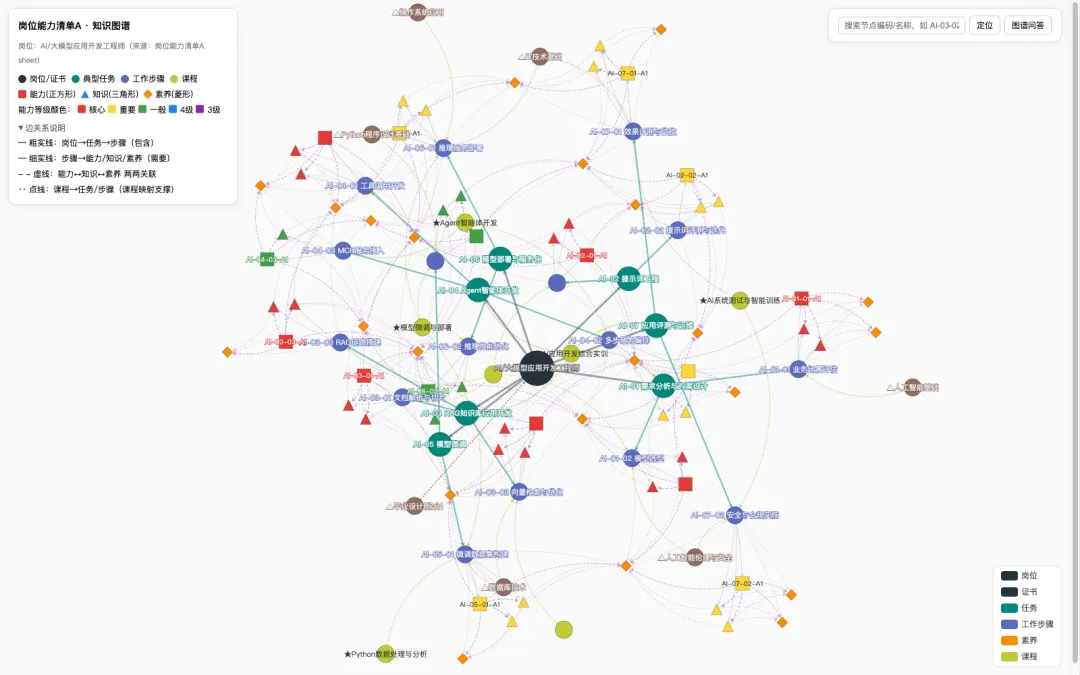
上图就是《岗位能力清单A》的知识图谱,一个 1.1MB 的单文件 HTML,浏览器直接打开:
108 个节点:1 岗位 + 7 任务 + 16 工作步骤 + 16 能力 + 32 知识 + 22 素养 + 14 课程 325 条边:包含、需要、关联、课程支撑四类关系 左上角图例:形状区分节点类型,颜色区分能力等级,边线样式区分关系类型(图中“边关系说明”已展开) 右上角:搜索定位 + 图谱问答
岗位是“AI/大模型应用开发工程师”。图中央那个深色大圆是岗位本身,往外第一层墨绿圆是 7 项任务,第二层靛蓝圆是 16 个工作步骤,再往外正方形是能力、三角形是知识、菱形是素养,最外圈黄绿色圆是课程。
四、具体是怎么做的
整条链路走下来六步,核心原则只有一个:数据只维护一份,图由数据生成。
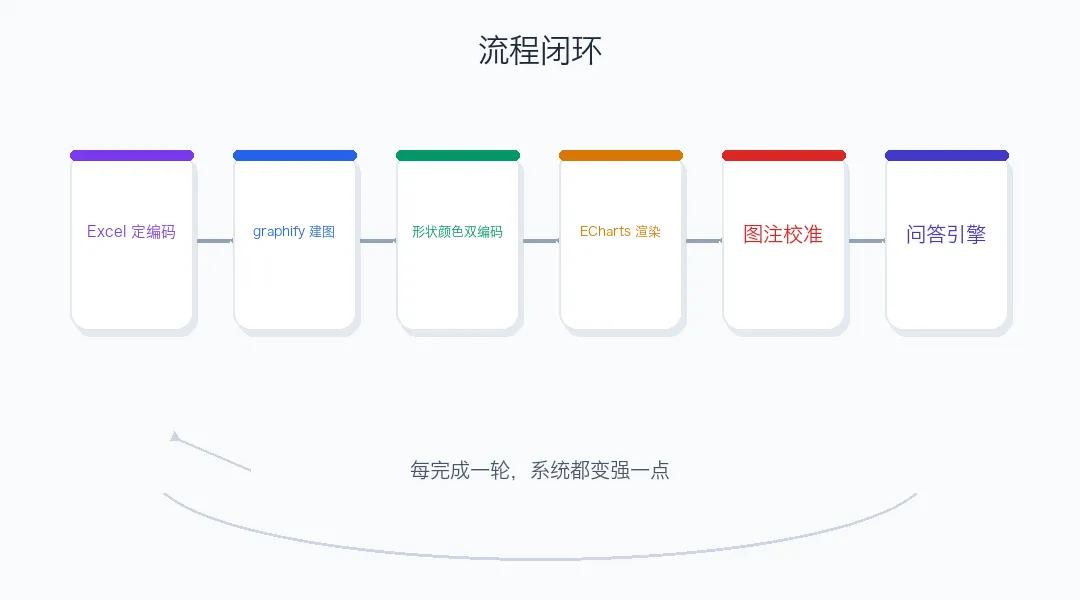
Excel 定结构。 原始数据就是三张 sheet 里的第一张,编码规则在 Excel 里就定死了:任务 AI-01 到 AI-07,步骤 AI-01-01 两级编号,能力后缀 A1、知识后缀 K1、素养用 Q 编号。编码本身就是图里的节点 ID,这一步定好,后面全自动。
graphify 建图。 用本地 graphify 技能跑五步流水线:合并语料 → 语义抽取 → 建图 → 社区检测 → 导出。产出的中间产物是节点表和边表,每条边带关系类型:包含任务、包含步骤、需要能力/知识/素养、能力↔知识↔素养两两关联、课程支撑任务/步骤。
视觉编码。 类型映射到形状——岗位、任务、步骤、课程用大小递减的圆形,能力正方形、知识三角形、素养菱形,扫一眼形状就知道节点是什么。等级映射到颜色:核心红、重要黄、一般绿,B 清单那边的 4 级蓝、3 级紫也一并定好,三张图用同一套色板。
ECharts 渲染。 用力导向布局(force layout),节点之间的斥力和边长调了几轮,让层级自然散开。加上搜索框:输入编码或名称片段,直接高亮定位到节点。
最后两步是这次新做的,也是最有故事可讲的部分:修图注、加问答,单独展开。
4.1 图注为什么要改
之前的版本,右下角有一行 ECharts 自动图例:红色方块“能力”、蓝色三角“知识”、橙色菱形“素养”。
评审看了一眼说:能力不都是红色的吗,怎么图里有黄的有绿的?
问题就在这。能力和知识节点的颜色是跟着等级走的——核心是红、重要是黄、一般是绿,图例却给它们钉死了固定色,等于图例在撒谎。改法是把右下角图例里的“能力”“知识”两项直接去掉,只留颜色恒定的六类(岗位/证书/任务/工作步骤/素养/课程),等级颜色交给左上角图例统一解释。一行代码的事,误导没有了。
4.2 让图谱能回答问题
图做好了,看的人还是会问:“这个步骤需要哪些能力?”“哪些课程支撑这个任务?”与其每次都拿眼睛找,不如让图自己回答。
我把右上角原来的“适配”按钮换成了“图谱问答”,点开是一个聊天面板。背后是写在页面里的本地规则检索引擎,不联网、不接大模型,答案直接从图数据里查出来,所以能做到精准——图里有什么答什么,绝不编造。
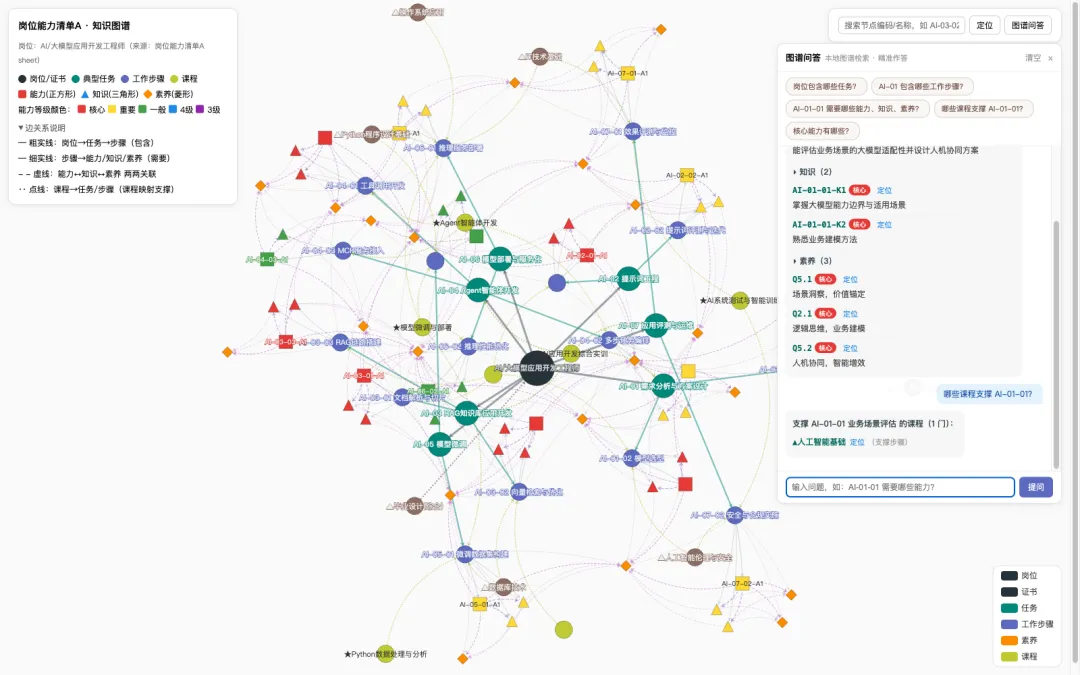
支持五类问法:
岗位包含哪些任务? AI-01 包含哪些工作步骤? AI-01-01 需要哪些能力、知识、素养?(答案带等级徽标,见上图) 哪些课程支撑 AI-01-01?反过来,某门课支撑哪些步骤? 核心能力有哪些?按等级检索全图
实体识别做了两层:编码精确匹配(输 AI-01-01 直接命中),名称片段模糊匹配(输“需求分析”也能找到任务 AI-01)。答案里每条结果带“定位”链接,点一下就在图上高亮跳过去。
写完用三个文件的真实数据跑了 25 个测试用例,全部答对。
五、几个取舍,记给以后的自己
为什么不用大模型做问答? 能接,但不敢接。这是要给评审看的材料,大模型万一“发挥”一下,把不存在的课程映射编出来,就是事故。规则引擎笨是笨了点,只会答五类问题,但它答的每一句都能在图里指出来源。精准和聪明之间,这个场景选精准。
为什么坚持单文件? ECharts 库、数据、样式、问答引擎全部内联进一个 HTML,1.1MB。发给任何人,双击就能开,不用起服务、不用装环境。材料评审的场景里,打开成本决定别人愿不愿意看。
思维导图彻底没用了吗? 也不是。汇报 PPT 里做总览页,思维导图仍然清爽。它输的是承载复杂映射和持续维护,赢的是一眼看清骨架。材料里两种图现在都在用,各干各的活。
六、下一步
这一篇讲的是 A 清单(岗位侧)。同批做的还有 B 清单(证书侧,人工智能训练师,4 级/3 级能力体系)和 C 清单(岗证融通,双编码,183 个节点 589 条边),后面两篇分别讲它们的特殊处理。
数据来源:《软件技术专业_岗证融通课程体系重构过程材料》Excel,三张 sheet 之一;渲染用 ECharts 5 graph 组件;建图流程走本地 graphify 技能。
你学校的课证融通材料,能力图谱画成什么样?还停留在思维导图的话,评论区聊聊卡在哪一步。

