PDF 转 Excel 少的那几行,可能都是钱
- 2026-09-22 11:12:04
印流的设计与代码 | Build Notes
2026 年 9 月 深圳
如果你每天要处理对账单、报价单、银行流水或库存表,这件事值得花三分钟。
这类错误落到具体工作里,是这样的:
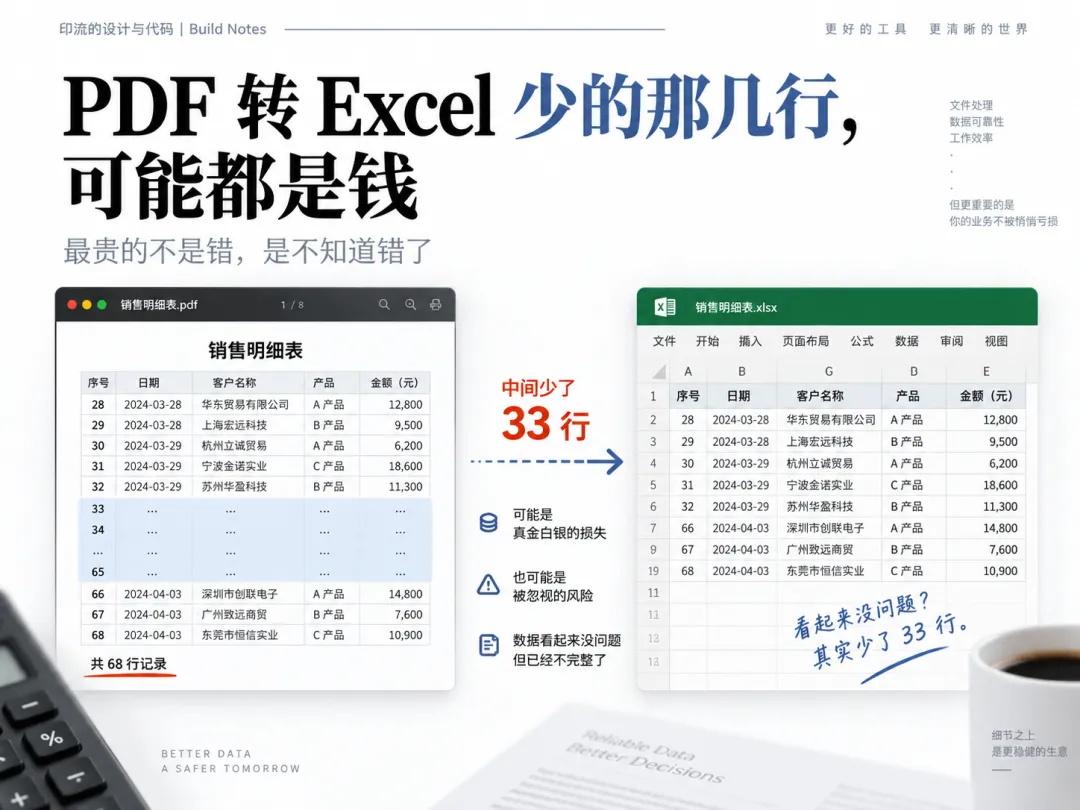
月底对账,你把客户发来的 PDF 对账单转成 Excel,逐笔核对。数字怎么都对不上,你以为是对方记错了,来回沟通好几天,最后发现是自己那份文件在转换时丢了三十多行。
问题不在你,也不在对方。在工具。而它不会告诉你。
一份对账单少 33 行,就是 33 笔没对上。财务得在几百行里把这 33 行找出来,半天就没了。
一份库存表少一页,就是一批货没进系统。客户下单时你说没货,其实仓库里堆着。
一份银行流水漏掉中间一段,报税的时候数字永远对不平。
更麻烦的是,这些错误不会停在原地。错的数据会一路往下走,进表格、进汇总、进报表、进决策。等你发现的时候,往往已经过了好几个环节。
最贵的不是错,是不知道错了。
还有一种代价不太有人提:你本来是想省时间才用工具的,结果省下来的时间,全花在核对上了。
一个不报错的错误
要理解它为什么会漏,得先知道 PDF 表格内部差别有多大。
有些是原生文本,直接能读;有些是扫描图片,得先识别。有些结构清楚,有些只是靠空格、坐标和视觉位置勉强排出来的。
表面看都是表格,内部完全是两回事。
更麻烦的是,程序出错的方式不是报错。
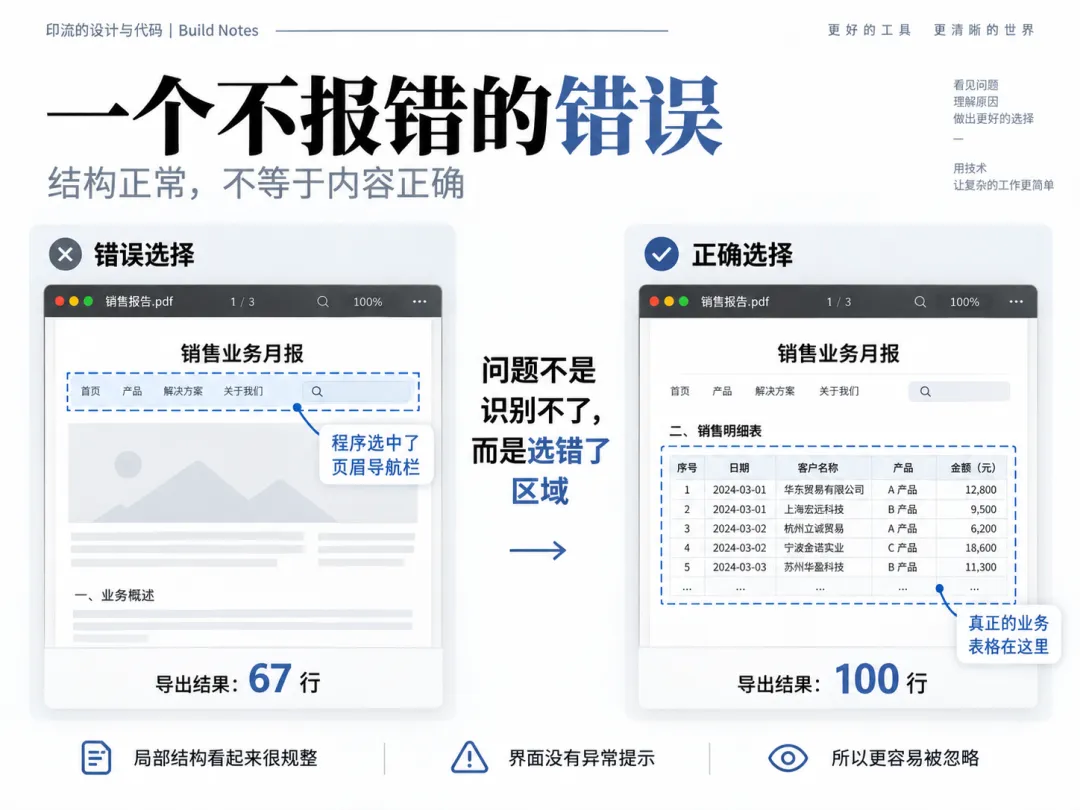
前段时间我做外部测试,一位测试者给了一份 3 页的浏览器打印版期货数据 PDF,一共 100 条业务数据。他自己用 PyMuPDF 加正则处理出来的 CSV,100 行全在,字段也规范。
这是一个很强的基准。
第一次跑工具的结果是 67 行。
少了三分之一。而且界面没有任何异常提示,仍然允许导出。
原因不是识别不了。是第一页上有好几个看起来像表格的区域,程序选中了页眉的导航栏,而不是下面真正的业务表格。它选中的那个区域,局部看起来结构很规整,所以原来的检查判定它没问题。
结构正常,不等于内容正确。
后来我修了跨页面的表格选择逻辑。重新部署后,第一页 33 行、第二页 38 行、第三页 29 行,100 行全部回来,和参考文件对照,关键字段没有语义偏差。
但结果里多了一个固定列。不是数据丢失,属于输出清理的问题。
这件事,国内外都在攻
修这个问题的过程中我去查了一下行业里在怎么做,发现它的难度是公认的。
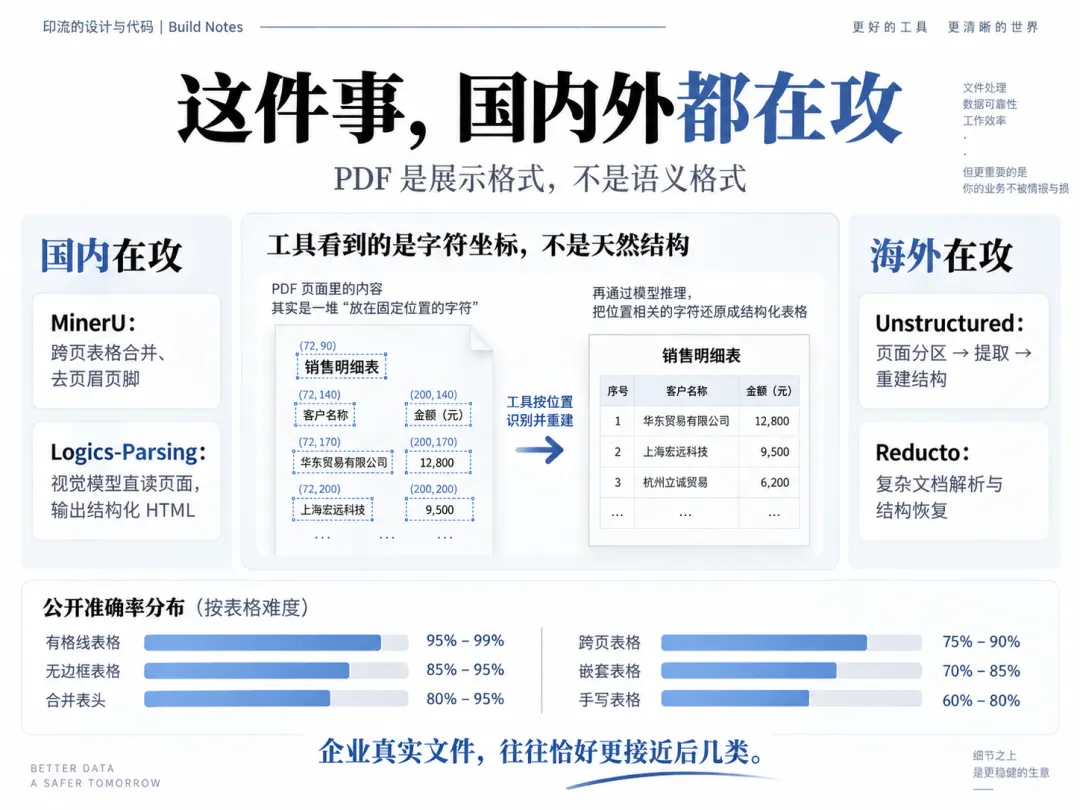
根本原因在于:PDF 是展示格式,不是语义格式。
它里面不存「这是一个表格」「这个标题属于这一节」,它只存每个字的坐标。所以提取工具看到的是「一堆带位置的字符」,而不是结构。双栏排版会被读成左右交错,财务表格里的表头会和数字分家。
国内最火的是上海人工智能实验室开源的 MinerU,GitHub 上七万多星,专门做「把 PDF 转成结构化数据」这一件事。它把跨页表格合并、自动去掉页眉页脚列为核心能力。这两个恰恰是最容易让人出错的地方。阿里巴巴通义实验室也开源了 Logics-Parsing,用视觉模型直接读页面图像输出结构化 HTML,在自建测试里超过了 GPT-5 和 Gemini 2.5 Pro。
海外那边,Unstructured、Reducto 这些专做文档解析的公司,做的是同一件事:先识别页面上的区域,再分区提取,最后重建结构。
但即便大家都在攻,准确率的分布仍然很不均匀。一组按表格类型统计的公开数据是这样的:
简单的有格线表格:95%–99%
没有可见边框、靠空格对齐的:85%–95%
合并表头的:80%–95%
跨页表格:75%–90%
嵌套表格:70%–85%
手写表格:60%–80%
问题就在这儿:企业真正要处理的,往往都是后几类。
而那些把 PDF 直接变成纯文本的工具,表格提取准确率通常低于 70%。我那份 100 行里出 67 行的结果,正好落在这个区间。
所以这件事不是「早就解决了、只是你没用对工具」,而是「全世界都在解决,但还没解决完」。
这些项目解决的问题是「解析得更准」。可从「解析得准」到「用户敢直接拿去用」,中间还有一段路没走完。
拿到 Excel 之后,有三件事必须做
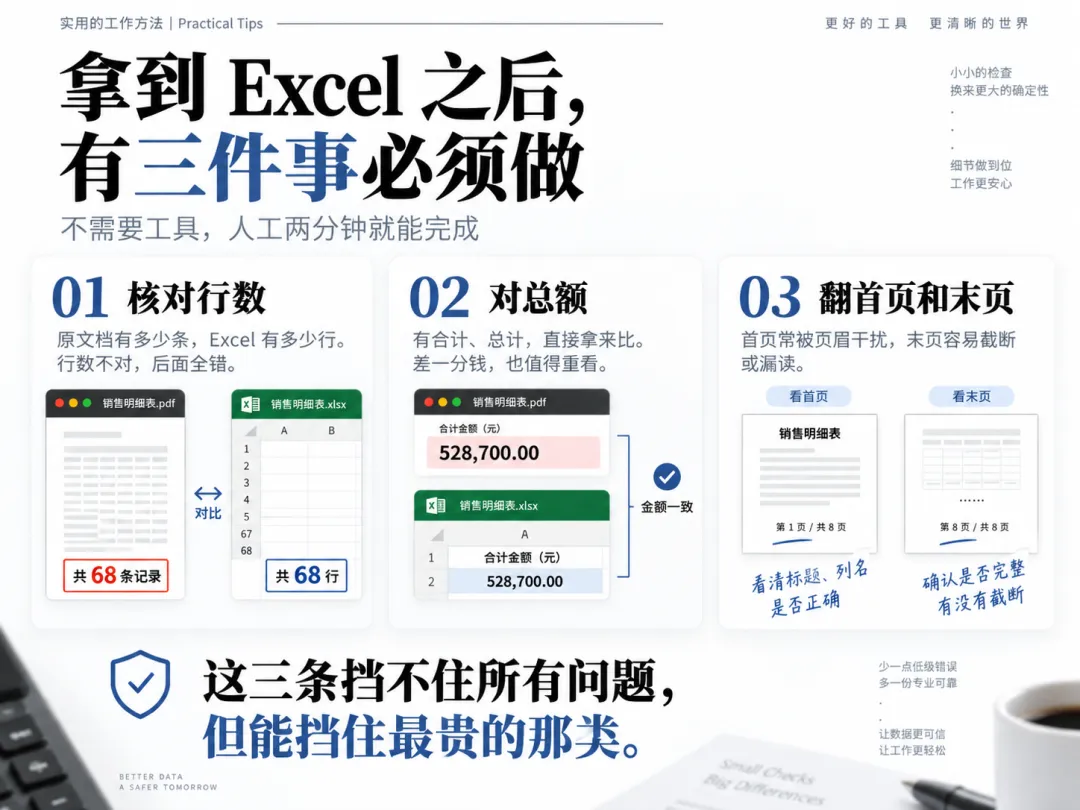
不需要工具,人工两分钟就能完成。
第一,核对行数。原文档有多少条数据,Excel 有多少行。行数不对,后面全错,不用往下看。
第二,对总额。原文档如果有合计、总计,直接拿来比。差一分钱,说明中间有问题。
第三,专门翻首页和末页。这两页是重灾区。首页常被页眉、导航栏干扰,末页容易被截断或漏读。
这三条挡不住所有问题,但能挡住最贵的那类。
这中间有个位置,现在还是空的
说回生意。
今天企业处理 PDF 数据,基本只有两个选择:买一个 OCR 工具,或者雇人手工录。
但「识别准确率」这个词有点误导。98% 的准确率放在 100 万条数据上,意味着 2 万条错误。而这 2 万条不会报错,它们安安静静躺在你的表格里。
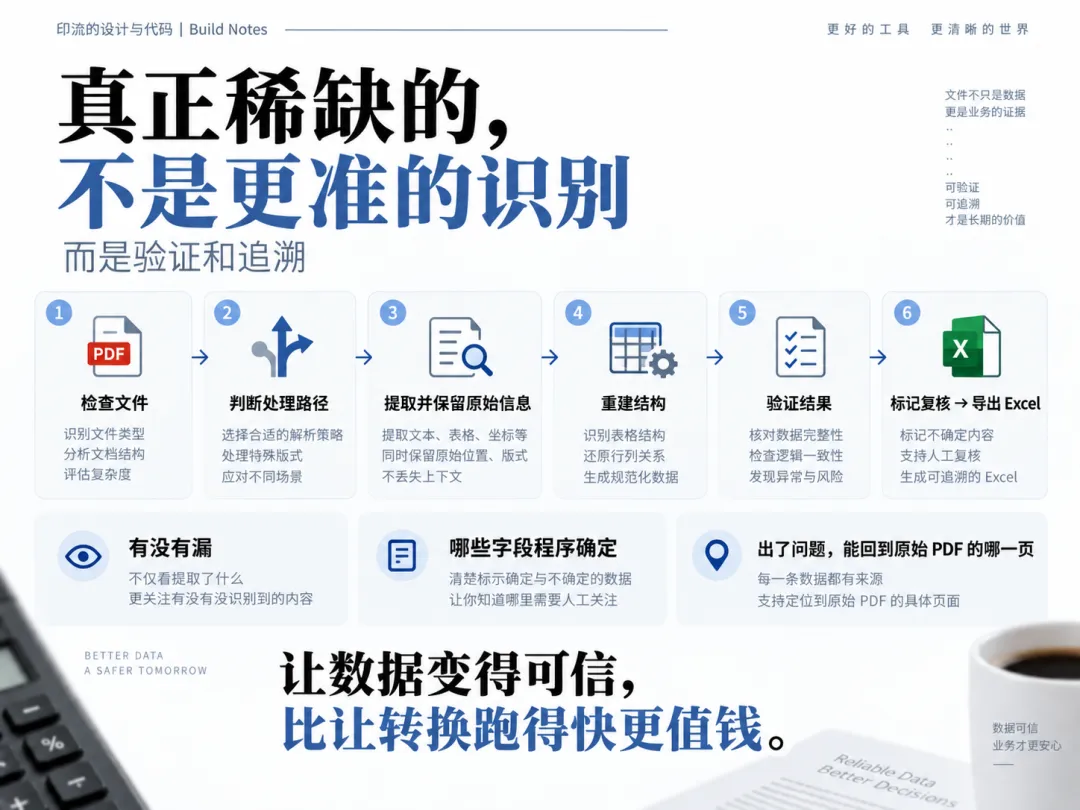
所以真正稀缺的不是更准的识别,是验证和追溯:这份数据有没有漏、哪些字段是程序确定的、哪些需要人工复核、出了问题能不能回到原始 PDF 的那一页。
我做 PDflow 就在往这个方向走:检查文件、判断处理路径、提取并保留原始信息、重建结构、验证结果、标记需要复核的部分,最后才导出。
这条路没走完。但我越来越确定,让数据变得可信,比让转换跑得快值钱得多。
对企业来说也一样。如果你每个月都在为人工核对 PDF 付出时间,那笔账值得重新算一次。那可能不是必要成本,是工具没做到位留下的窟窿。
如果你手上经常处理对账单、报价单、库存表、银行流水这类文件,我想知道一件事:
你更怕转换失败,还是转换成功以后,才发现里面少了东西?

