用AI做PPT,最容易翻车的那些坑,我都帮你总结好了
- 2026-09-23 12:40:04
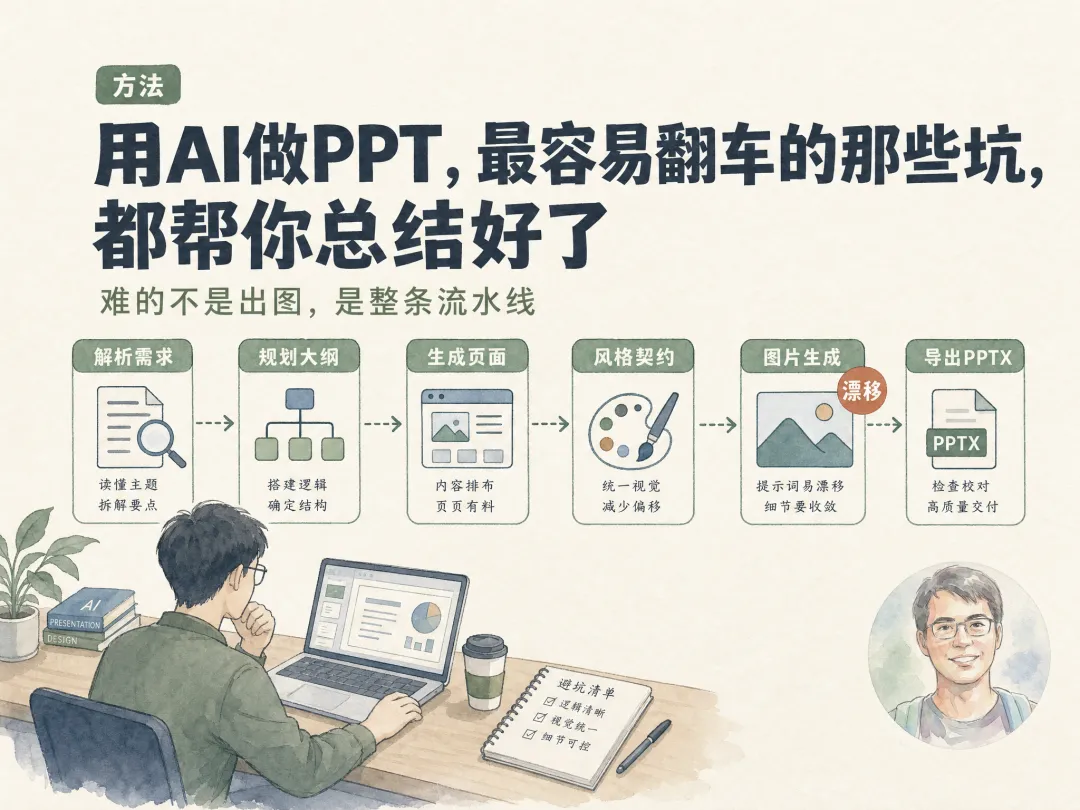
用 AI 生图来做图片型 PPT,看起来很容易:把资料丢进去,写一段 Prompt,等上几十秒到两分钟,一张看起来还不错的页面就出来了。
但真正自己做过几次就会发现,想让结果稳定、美观、少返工,还要尽量省时间和 token,并没有想象中简单。
本文只讨论使用 AI 生图能力制作 PPT,不讨论 HTML 或 SVG 或者直接代码生成式 PPT。后者的优点是精确、可编辑,但实际使用中也有一些明显的问题:速度慢、token 消耗高、版式比较单一,不够美观,复杂信息的排版也更困难。比如某次我在使用 PPT Master Skill 做 PPT 时,反复遇到 SVG 语法不对的问题,一直来回返工,白费token不说,一张图要花上10来分钟。
先说说,AI 生图做 PPT 这个方案好在哪里
它最大的优点,是有机会让一页 PPT 一次成型。
页面的布局、视觉元素和整体风格,可以在一开始就作为一个整体来设计。这样做出来的页面,往往比一点点拼装出来的内容更完整、更有整体感,也更美观。
另一个优点是快。通常等待几十秒到两分钟,相比其他制作方式,能节省不少时间和 token。
当然,这里说的是理想状态。想真正把这个优势发挥出来,还要先跨过几道坎。
AI 做 PPT,绝不是一次 Prompt
AI 做 PPT 更像是一条流水线,而不是把所有资料交给模型,再等它直接交付最终结果。
这条流水线至少包括:
资料解析、内容规划、分页设计、生图、演讲者注释,以及最后的 PPTX 组装。
每一步之间都有交接,也都需要校验。前面一步如果不稳定,后面通常很难靠一个 Prompt 补回来。所以,问题并不只是“怎么写提示词”,而是整条流程能不能连贯、稳定地跑下去。
真正要跨过的几道坎
1. 好用的模型和智能体
首先当然是模型和智能体本身。这个部分不展开说了,但它确实是前提。
现实情况是,很多人连稳定使用好模型和智能体都不容易,还要面对访问门槛、各种 Plus 订阅合拼,以及不断和风控做对抗。
2. 原始资料能不能被正确理解
资料解析是整个流程的基础。以 PDF 为例,里面可能有图片、文字、多列排版,还可能需要 OCR。模型不仅要读懂正文,还要理解图注、表注,判断哪些内容值得保留、哪些内容可以舍弃。
所以,直接把 PDF 提取成一段文本,很多时候是不够的。要想给后面的内容规划和分页提供足够好的素材,可能需要使用 MinerU、PP-Structure 等相对重量级的解析方案。
3. 到底要不要调研和补充数据
原始资料解析完之后,还要面对一个实际问题:是否需要继续调研,是否需要扩充数据源?
如果需要调研,调研到什么程度?哪些信息应该取用?哪些信息不必放进 PPT?这些问题如果没有提前想清楚,后面的内容很容易越做越散。
4. 内容怎么组织,页面怎么安排
分页规划不是简单地把一篇文章切成几段,而是要先理解全部内容,再结合页数限制,安排每一页到底讲什么。
不同类型的素材,适合的组织方式也不一样。有些内容适合用要点式,有些适合做流程图,有些适合用比较式。页面之间还要有连贯性,前后要讲得通。
同时,不同页面也有更合适的排版方式。要点、流程、比较、图文说明,并不能都套用同一种模板。
如果这些事情不提前约定,最后的结果就很像抽卡:每一页单独看可能还行,放在一起却未必连贯,页数、内容和版式也容易失控。
5. 需要一个中间表示和版式契约
要让流程稳定下来,最好不要只依赖模型在对话中的临时记忆,而是用一些中间文件把要求明确写下来。
比如:
• content.md:描述整套 PPT 要讲什么;• pages.md:描述如何分页、每页放哪些内容;• style.md:描述模板、标题系统和整体视觉风格。
这些文件相当于内容和版式之间的契约。没有它们,每一页很容易各画各的,最后出现页数漂移、字段漂移、字号漂移,甚至模板也不一致。
6. 素材到底该直接用,还是重新画
做 PPT 时,还会遇到一个很具体的问题:什么时候应该准确使用原资料里的图片或表格?什么时候可以让 AI 重新绘制?
重绘可能更统一、更符合整体风格,但也可能损失原始信息。直接使用原图或原表格,保真度更高,却未必能和页面风格自然融合。
这不是一个完全可以交给模型随机决定的问题,需要根据内容的重要程度和页面目标做判断。
7. 整套 PPT 的视觉风格要统一
视觉风格不是简单选一个颜色。它还包括适合内容的美学风格、字体和字号、多种排版布局,以及各种尺寸和位置的约定。
这些设定如果不统一,就算每一页单独看都不错,整套 PPT 放在一起也会显得松散。
好的提示词和检查机制,不能完全消除生图过程中的漂移,但可以降低返工的概率。
8. 生图结果本身会漂移
AI 生图还有一些很常见的问题:
• 画面模糊; • 中文乱码; • 画面里出现噪音; • 同一条信息被重复表达; • 文字样式不稳定,前后页面飘来飘去。
这也是为什么不能只生成一次、看一眼没问题就结束。结果需要检查,必要时还要重新生成。
9. 最后还要把它组装成真正能用的 PPTX
图片生成出来,并不等于 PPT 就完成了。后面还要进行 PPTX 组装,并做格式检查。
这一步有时还会遇到兼容性问题:看起来生成成功了,打开之后却可能出现排版或格式不一致。
从工程角度看,整条流程也不算简单。调用 API 可能失败,并发可能受限,模型返回的结果可能缺字段,也可能不符合预期。长任务还需要有监控能力,以及中断之后可以恢复的机制。
还有一些容易被忽略的实际需求
真正做成一个可复用的工具,往往还要考虑很多细节和实际需求:
• 是否提供演讲者注释; • 是否支持多语言输出; • 是否有多样化可选择的风格模板;用户喜欢某一种特定风格时,能不能从外部收集参考,再提炼成稳定的风格设定; • 某一页不满意时,能不能只修改这一页,同时保持原来的设定和主要内容不变; • 某一页文字太多、太细时,能不能在不改变核心内容的情况下进行高分辨率重绘; • 是否支持不同的长宽比,以适应不同的平台。 • 等等
至于想把生成结果转换成真正可编辑的形式,这是另一个问题,我也踩了好多坑,咱们可以单独再讨论。
这其实是一套完整的工作流
把上面这些问题放在一起看,就会发现:AI 生图做 PPT,难点从来不只是生成一张好看的图。
它需要一套完整的工作流,把资料解析、内容组织、分页设计、风格控制、生图、检查和 PPTX 组装串起来。更重要的是,这套流程还要能在本地复用,能够稳定运行,而不是每次都从头抽卡。
因为这件事并不像想象中简单。我们觉得它有价值也有意义做成线上工具,帮助大家省却一些麻烦,节省一些时间。这个工具已经上线,放在咱们 #麦伴科研 #maltsci网站上,侧栏上的PPT生成器就是。欢迎试用。
虽然这中间已经填了不少的坑,但还有不满意的地方,我们一直在打磨和优化当中。欢迎反馈。

