Excel 导入为什么也需要 AI 工程
- 2026-11-09 15:51:42
Excel 导入为什么也需要 AI 工程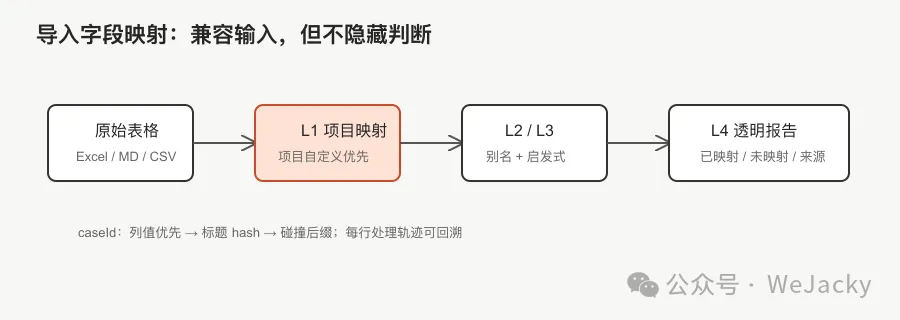
Excel 和 Markdown 导入的四层字段映射
同一份测试表,有人叫“案例名称”,有人叫“用例标题”,还有人把步骤和预期结果写在同一个单元格里。
如果导入器只认一套表头,结果不是整批失败,就是悄悄生成错误 case。真正可靠的导入系统,必须允许输入不整齐,同时把它的判断过程说清楚。
一、字段映射至少要有四层
固定列名只能覆盖最理想的文件,完全依赖 AI 又会让结果不可追溯。项目配置、内置别名、启发式判断和透明报告应该逐层兜底。
怎么解决
L1:优先使用项目级字段映射。 L2:识别内置别名,如案例名称、操作步骤、预期结果。 L3:根据列名模式做有限启发式猜测。 L4:把已映射、未映射和来源写入报告。
项目映射 > 内置别名 > 启发式猜测 > 明确报告未映射字段这样导入器可以“尽量继续”,但不会假装所有字段都确定。
导入的核心不是把文件读进来,而是让每一列如何被理解都可解释。
二、caseId 不能依赖人工永远填写
有些表格没有 caseId,有些文件里标题重复。系统需要稳定推导标识,同时处理同文件碰撞。
怎么解决
有明确 caseId 列时优先使用。 没有时根据标题生成短 hash。 同文件碰撞时增加稳定后缀。 在结果中记录 caseIdSource。
三、导入过程要留下逐行轨迹
每一行至少要能追踪:原始行号、最终 caseId、前置条件解析、字段映射、意图拆分和告警。
怎么解决
每行输出处理状态。 每个步骤输出句子到 intent 的映射。 未注册前置条件降级为警告,不静默拼进业务步骤。 导入成功后仍然运行 case validate。
四、走过的弯路
方案一:只支持固定 Excel 模板
现实团队会复制、改名、增加列,模板很快失控。
方案二:字段猜错也继续,不生成报告
表面导入成功,实际用例语义已经错了。
兼容输入和透明报告必须同时存在。
五、下次再遇到,先问哪两句
第一,这一列是确定映射,还是启发式猜测?
两者必须在结果里区分。
第二,导入后的 case 能否回到原始行?
不能追溯,就不适合批量进入执行。
下一篇收束测试资产链路:自愈动作如何留下可追责证据。
你们的测试表里,最容易出现歧义的是用例标题、步骤,还是预期结果?
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

