别被厂商PPT骗了:12个企业智能体落地真相
- 2026-11-06 01:03:26
怎么算"真落地"?先定三档
- 已确认部署
:有公开可核验的生产环境落地,而且能拿出业务结果。 - 仅展示演示
:只出现在发布会或财报电话会演示里,还不是客户实际生产部署。 - 信息不足
:公开信息只讲产品能力或用户规模,看不到企业级生产部署和具体效果。
凡是厂商或客户没披露量化数据的,实际效果统一标"数据未披露"。下面按客服、研发、数据分析三个领域,把 12 个案例摊开说。
一、客服:效率是真的,天花板也是真的
客服是企业智能体跑得最猛的赛道,因为场景高频、重复、结果好量化。但 Klarna 的故事提醒我们,自动化率高不等于高质量自动化率高。
表 1
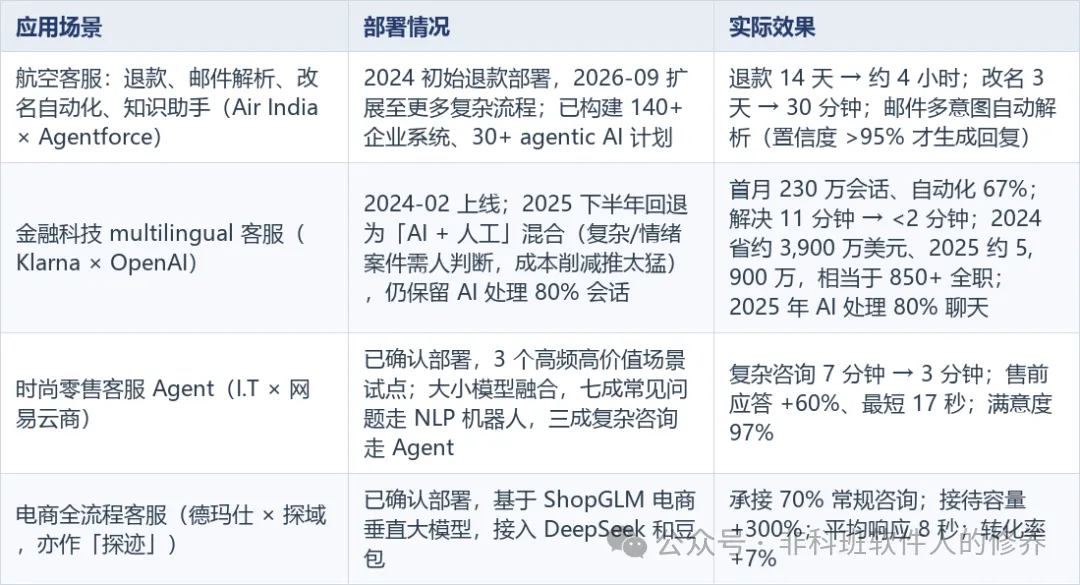
来源与状态:Air India×Agentforce — Salesforce 新闻稿及 CNBC TV18 独立报道,2026-09-15(已确认部署);Klarna×OpenAI — 2024-02 公告及 2025 年报/Reuters,2024-02 / 2025(已确认部署,含回退修正);I.T×网易云商 — 网易智企/砍柴网/沙丘智库,2025(已确认部署);德玛仕×探域 — 中国日报网,2025-08-28(已确认部署)。
几个点值得拎出来说。Air India 把退款从 14 天压到约 4 小时,关键是它只在置信度超过 95% 时才让 Agent 自动回邮件,复杂件一律转人工,没有硬上。Klarna 则是最常被引用的"成功案例",但它 2025 年把自动化推到 80% 之后又回退成"AI + 人工"混合,原因是复杂和带情绪的案件终究要人来判断,而公司自己也承认成本削减推得太猛。国内这边,I.T 用大小模型融合把复杂咨询从 7 分钟压到 3 分钟,德玛仕靠垂直大模型把接待容量拉高 300%、转化率提了 7 个点。
二、研发:代码真的有人在交
研发类智能体的特点是"拿得出硬指标":合并了多少 PR、生成了多少代码,都是可数的值。
表 2
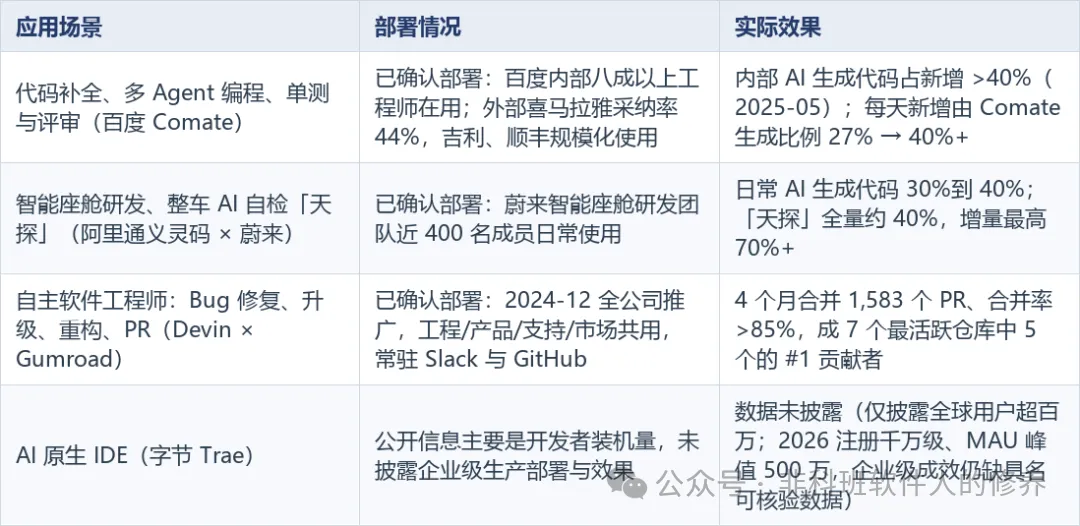
来源与状态:百度 Comate — 百度百科/IDC 评估/白皮书,2025(已确认部署);阿里通义灵码×蔚来 — 阿里云开发者社区,2025(已确认部署);Devin×Gumroad — devin.ai 客户案例,2024-2025(已确认部署);字节 Trae — 2026 中国智能体经济白皮书,2026-09(信息不足)。
百度 Comate 在内部八成以上工程师日常使用,外部喜马拉雅的采纳率也到了 44%,属于真刀真枪在用。阿里通义灵码 × 蔚来把智能座舱团队的 AI 生成代码占比做到三到四成,"天探"自检项目增量部分最高七成以上。最硬核的是 Devin × Gumroad:4 个月合并 1,583 个 PR、合并率超过 85%,成了 7 个最活跃仓库里 5 个的头号贡献者。反例是字节 Trae,用户规模很大(千万级注册),但始终没披露企业级生产部署和效果数据,所以只能标"信息不足"。
三、数据分析:让业务自己问数
数据分析智能体的卖点是"自然语言问数",但前提是数据底子干净、指标口径统一,否则答得越快错得越离谱。
表 3
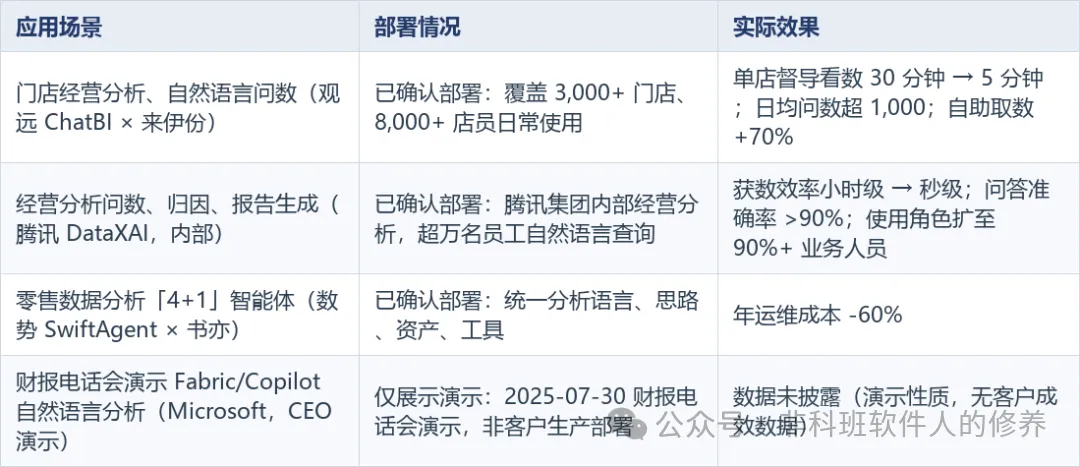
来源与状态:观远×来伊份 — 观远数据,2025-01(已确认部署);腾讯 DataXAI — 腾讯云开发者社区,2024(已确认部署);数势×书亦 — DoNews,2025(已确认部署);Microsoft Fabric Copilot — FY25 Q4 财报电话会/The Buildout,2025-07-30(仅展示演示)。
来伊份把单店督导看数从 30 分钟压到 5 分钟,覆盖 3,000 多家门店、8,000 多名店员,是典型的"把分析师的能力下放给一线"。腾讯 DataXAI 在集团内部让超万名员工用自然语言查经营数据,问答准确率超过 90%,使用角色从专业分析师扩展到九成以上业务人员。数势 × 书亦把年运维成本降了 60%。而 Microsoft 那条,只是 CEO 在财报电话会上的演示,至今没有客户生产部署,归入"仅展示演示"。
四、落地靠什么,卡在哪
下面这些判断,每一条都能在上面 12 个案例里找到对应。
先说从演示走到生产靠什么。
别先上 AI 再找场景,反过来才跑得通。落地的案例几乎都是把 Agent 塞进售前售后客服、报表取数、代码补全这类高频重复、结果能用数字衡量的活儿,拿经营结果说话,来伊份和 Air India 的退款就是例子。 数据底子得先干净。Data Agent 能不能让人信服,前提是一套统一口径的知识库和指标体系。观远、腾讯 DataXAI 这些团队都反复强调,先把指标和知识库统一,分析才站得住。 人得兜得住底。置信度阈值和转人工规则不是摆设:Air India 只在置信度超过 95% 的时候才自动回邮件,Klarna 回退之后也一直留着"随时转人工"的口子。盯着自动化率高低没意义,真正要紧的是自动处理的那些活儿质量够不够硬。 安全和合规是进门的条件。行列级权限、数据本地化、全量审计,这些做不到就别想进生产环境。百度 Comate 支持本地化或私有化部署(数据隔离),腾讯 DataXAI 做了行列级权限管控,都是这个逻辑。 别一口气铺开,要分阶段度量。先搭效能看板、把采纳率纳进考核,再按"工具引入、流程融合、文化转型"一步步走,而不是一次性全面铺开。
再说卡在哪里。
复杂、带情绪、高风险的活儿还是得人上。Klarna 在复杂场景暴露了自动化的边界,最后回退成 AI+人工混合;Agent 擅长 Tier-1 那类活儿,剩下两成复杂的仍得靠人。 数据质量和口径直接决定效果天花板。知识库脏、指标对不上,准确率立刻往下掉,这也是 Data Agent 总被点名的"认知幻觉"来源。 头一年就想看到 ROI 基本是妄想。连厂商自己都提示,部署即见效是误区,第一年难见回报,得配套治理机制,还得养用户的习惯。 在强监管领域,幻觉就是合规风险。金融这类地方,答错一道题和踩一条红线差不多,只能靠置信阈值加人工复核兜着。 自动化过头会反噬。Klarna 把成本削减推得太猛,最后被迫回退,这事儿说明"自动化率"和"高质量自动化率"根本不是一回事。 厂商宣传和生产实况常有落差。不少产品停在发布会演示或白皮书里,企业级成效缺第三方验证。这次调研里就有"仅展示演示"(Microsoft 的演示)和"信息不足"(字节 Trae)两类,选型时还是得拿可核验的生产证据说话。
结语
企业智能体不是没用,恰恰相反,在高频、重复、可量化的地方它已经真刀真枪地创造价值。但它也不是万能药:复杂场景的边界、数据质量的天花板、过度自动化的反噬,这三道坎一个都绕不开。选型时别被 PPT 上的自动化率晃了眼,拿得出生产证据、经得起交叉验证的,才是真的落地。

