商汤这次不拼参数,拼审美:动态 PPT、动态海报、能接着改的 Blender 工程
- 2026-11-04 18:40:40
11月2日,商汤发布日日新 SenseNova 6.8 Flash 正式版。整场发布没有提参数规模,讲的是一件事:AI 交出来的东西,能不能接着用。
这句话听起来虚,但它戳的是一个真问题。 过去两年,设计类 AI 的交付物基本是"一张好看的图"。图好看,但你不能改:字体是像素、层级是平的、动效得自己重做、想换个尺寸就报废。从"生成"到"生产",中间隔着的不是审美,是可编辑性。
先看它具体改了什么。三个场景,都是从"生成结果"往"生成工程"挪。
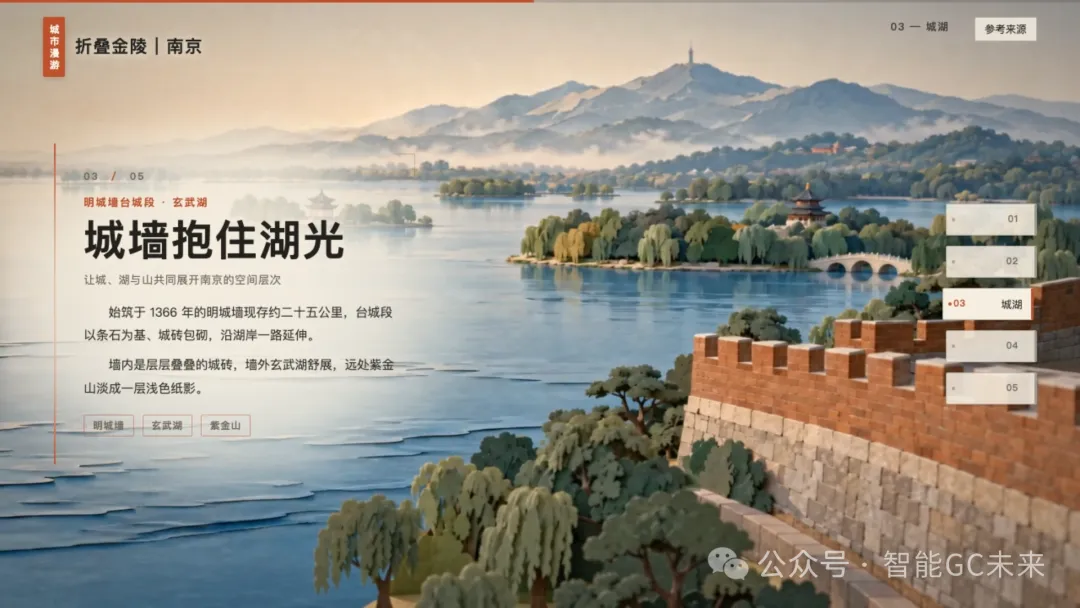
动态 PPT。 官方的说法是,把"叙事节奏"纳入生成目标——先梳理每一页要传达什么、哪里需要停顿、哪句要重点强调,再据此编排动效。转场类型、元素入场顺序、图表生长方式、版式规范在同一次生成里统一考虑,最后输出的是 PPTX,动效和页面结构是对得上的。
这件事难在哪,懂行的人一眼就看出来。 普通做法是先生成静态页,再往上叠动画,结果是动画和内容各说各话——重点句还没出来,装饰先飞完了。要让动效服务信息层级,模型得先理解"这一页想让人记住什么"。这已经不是绘图能力,是叙事能力。
动态海报。 同理,不是让图动起来,而是把主体视觉、文字层级、动效编排放在同一次生成里统筹:主视觉的运动幅度、文字出现的位置和时机互相配合,时间轴节奏服务于信息层级。成品能发社交媒体,也能沿用同一套视觉语言延展成系列素材。
这条对做投放的人价值最大。 一个 campaign 出十张素材,过去得保证十次风格一致;现在只要一次定下视觉语言,后面是派生。省的不是设计时间,是一致性成本。
动态 3D,接 Blender。 用户提需求,Agent 生成场景初版,结合实际渲染结果和用户反馈持续调整,多轮"生成—观察—反馈—修改"之后,输出的是可继续编辑的 Blender 工程。
官方举的例子很具体: 在 Blender 里做卢浮宫场景,第一版出来屋顶、金字塔位置有偏差,可以指着这些具体部位修正;还能追加要求,比如加天气动画效果。
这一条在技术路线上跟"文生 3D"是两回事。 文生 3D 直接吐网格或体素,看着像,但拓扑乱、面片冗余、没有真实尺寸;Blender 工程路线走的是参数化建模,几何带约束、尺寸带数值、下一步能接着改。前者给你一张概念图,后者给你一份能进生产管线的文件。
但官方自己挂了一个限制:这个功能依赖本地环境搭建,并且需要用户多轮交互完成。 这句话很重要——它意味着"一句话出片"在这儿不成立,你得装环境、得盯着改、得一轮轮提意见。 这不是全自动,是人机来回。
设计能力的其余几块也一并列了: 网页设计(页面布局、字体排版、色彩搭配、视觉素材风格统一,能出简约品牌风、创意视觉风、科技产品风);SVG 设计(矢量图形与动画,可无损缩放、可二次编辑);3D 网页建模(空间布局、材质光照、镜头控制、动画编排,网页里实时渲染);以及接入 Figma,把 AI 生成接进设计师现有工作流。
另一条主线是"长期记忆 + 主动交互",这个比设计更值得注意。
官方给了一个案例: 你曾向某客户推荐一款企业 AI 产品,客户因为产品不支持私有化部署拒绝了。一个月后产品升级,恰好补齐这项能力。你在准备销售例会材料时,模型把新版本的功能变化和此前记录的客户需求对上了,主动提醒你——这个曾经拒绝的客户,现在有重新跟进的价值。
它不只记得"为什么被拒",还整理了功能对比。 另一个场景是岗位交接:员工调岗,要交的不只是客户名单,还有合作进度、沟通习惯、需求反馈,以及那些没写进正式文档的经验。模型可以基于已授权的历史工作资料,把这些整理出来。
"每一次事后补救,转成提前预警"——这是官方的话,方向是对的。 但落地的前提很硬:得有足够长、足够干净的历史记录,并且用户愿意授权模型读这些记录。大多数公司的客户信息散在微信群、邮件、个人笔记本里,这套能力的第一步就卡住了。
现在看评测,这里必须小心。
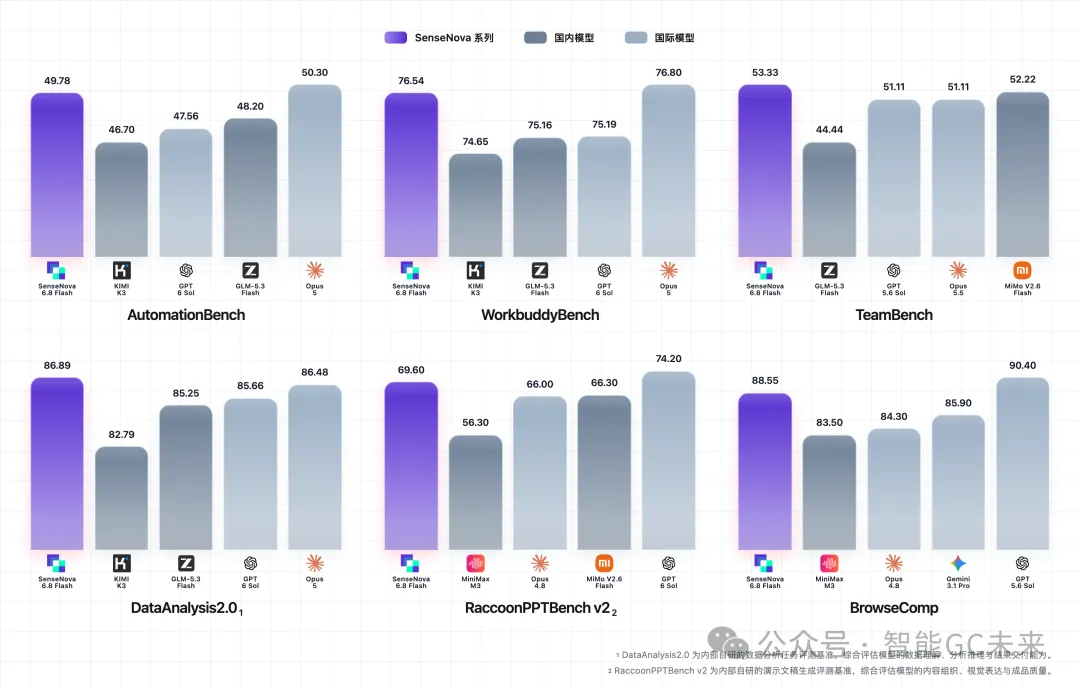
官方说,在智能体协作、数据分析与演示生成等场景上"超过部分国际前沿模型",在行业模型中"处于明显领先"。 榜单列了一堆:AutomationBench、WorkbuddyBench、TeamBench、DataAnalysis2.0、RaccoonPPTBench v2、BrowseComp、LongMemEval-S、BEAM 128K、PersonaMem-v2。
问题就出在这里:DataAnalysis2.0 和 RaccoonPPTBench v2 是商汤内部自研的基准。 官方注释写得很清楚,前者评"数据理解、分析推理与结果交付",后者评"内容组织、视觉表达与成品质量",都是自己出的题。这两项上"超过国际前沿模型",严格说只说明它更符合商汤自己定的标准。 拿自研基准跟别人的通用模型比,逻辑上先天吃亏——不是作弊,但也没法当独立证据。
公开基准那部分,数字反而更硬。 长期记忆类的 LongMemEval-S 上,SenseNova 6.8 Flash 拿到 96.67 分,同场第二高是 77.71;BEAM 128K 上 93.33 分,第二高 73.75。这两个差距接近 19 和 20 分,不是小数点级别的领先。 对照模型包括 GPT-6 Luna、DeepSeek V4.1 Flash、GLM-5.3 Flash、MiniMax M3、Claude 5.5 Haiku、Gemini 6.3 Flash 等。
长期记忆这项能力,跟前面那个"提醒你客户可以重新跟进"的案例是同一条线。 记忆评测拿高分,才有资格谈主动交互。所以这两个分数比设计演示更能说明这套产品的底子。
顺带说一个不太显眼但重要的动作:商汤开源了 SenseNova Loop-9B-Preview。 用的是 Looped Transformer 架构加流形约束超连接,只有 32 个不同的解码层,循环执行出 56 次解码层计算,用约 9B 参数的存储量拿到接近 27B 级模型的表现。这是架构层面的探索,跟 6.8 Flash 不是一回事,但放在一起看能看出商汤在两条腿走:一条做交付,一条赌下一代架构。
放到竞争格局里,商汤这次的选择其实挺清醒。
国内做通用模型,参数和榜单已经卷到没什么差异化空间。 6.8 Flash 走的是另一条:不跟你在 MMLU 上比,比的是"这份 PPT 能不能直接用""这个场景工程能不能接着改"。这是把评价标准从"模型多聪明"换到"活儿干得怎么样"——换赛道,而不是在同一条道上追。
风险也很清楚。 一是自研基准的公信力问题,这个短期内解决不了。二是"可编辑"这件事的完成度,Blender 那条明确依赖本地环境和多轮交互,离"提一句就行"还有距离。三是长期记忆的能力边界——评测分高不等于企业真敢把客户资料全交出去,数据授权和隐私这条线,才是这类功能能不能规模化的真正闸门。
最后说一句判断。 商汤这次最有价值的一句话是"从静态网页到可继续编辑的工程"。AI 设计工具比拼的下半场,不在生成得多好看,在交付物能不能直接进入别人的工作流。 一张图再美,设计师还得重画一遍;一份能打开、能改参数、能导出的工程文件,才是真省了工。
至于它是不是真的赢了国际前沿模型——等第三方把 DataAnalysis2.0 和 RaccoonPPTBench 之外的那几项复现出来再说。
【总结】 11月2日,商汤发布日日新 SenseNova 6.8 Flash 正式版,重点从内容生成转向任务执行与可用交付物。核心能力分两条线。一是设计交付:动态 PPT(把叙事节奏纳入生成目标,转场、入场顺序、图表生长方式与版式在同一次生成中统一考虑,输出 PPTX)、动态海报(主体视觉、文字层级与动效编排统筹考虑,可延展为系列素材)、动态 3D(通过 Agent 与 Blender 多轮"生成—观察—反馈—修改",输出可继续编辑的 Blender 工程,官方注明依赖本地环境搭建与用户多轮交互)、网页设计、SVG 矢量设计、3D 网页建模,并可接入 Figma 工作流。二是长期记忆与主动交互:能关联产品版本变化与此前客户需求并主动提醒跟进,也可基于授权资料整理岗位交接信息。评测方面,官方称在智能体协作、数据分析与演示生成上超过部分国际前沿模型;榜单含 AutomationBench、WorkbuddyBench、TeamBench、BrowseComp、LongMemEval-S、BEAM 128K、PersonaMem-v2,以及商汤内部自研的 DataAnalysis2.0 与 RaccoonPPTBench v2。公开基准中 LongMemEval-S 得 96.67(同场次高 77.71),BEAM 128K 得 93.33(次高 73.75),对照模型含 GPT-6 Luna、DeepSeek V4.1 Flash、GLM-5.3 Flash、MiniMax M3、Claude 5.5 Haiku、Gemini 6.3 Flash 等。同期商汤开源 SenseNova Loop-9B-Preview,采用 Looped Transformer 加流形约束超连接,用 32 个不同解码层循环执行出 56 次解码层计算,以约 9B 参数存储取得接近 27B 级表现。模型已开放体验,渠道包括 SenseNova Studio(Design 实验版)、SenseNova Token Plan、商汤小浣熊(限免至 2026年12月1日)。

