AI 视频一眼像 PPT,是镜头没编排:这个开源工具的解法是删
- 2026-11-06 21:58:33
点击下方名片关注「AI 硅基科技分享」,第一时间获取前沿 AI 行业资讯、技术拆解干货!
说到“开源数据库”,画面上是一个外国人对着笔记本电脑傻笑,从头笑到尾,没有第二个动作。这是 AI 做口播视频最常见的翻车现场:稿子是好的,画面是死的。一个叫 video-talkcraft 的开源项目要修的就是这个:给它一份口播稿和一条配好的音,它在你自己的电脑上算出每个字落在音频里的时间点,再按这些时间点排镜头、渲染成片。它对“为什么像 PPT”的判断一句话说破:像 PPT 不是画面不够花,是画面没有镜头;反 PPT 靠删不靠加。
严格说它算不上一款软件。仓库里没有安装包,主体是一套写给 AI 编程助手看的操作规程,加一批 Python 和 JavaScript 脚本。用法是把仓库链接丢给 Claude Code 这类工具,让它照着规程一步步做;量时间、对账、渲染、验收这些活都是脚本在干。
它把“一眼像 PPT”的原因归到编排这一层:生成模型只负责画,画什么、什么时候动、动多久,是另一层的事,而绝大多数 AI 视频流程里没有这一层。补法分两半:给每个镜头装一台几乎察觉不到的摄影机,再把多余的动效删掉。
编排要立得住,先得知道每个字在哪一秒。这条链上最硬的一个数:默认后端的中位偏差 40 毫秒,最差 200 毫秒; 30fps 下一帧 33 毫秒,中位误差一帧出头。
它先给每个字量时间
管线从一张稿子开始,但稿子得先改成能读的样子。数字一律写成汉字: 197747 要写成"十九万七千七百四十七",因为对齐是拿读音去对的,阿拉伯数字对不上任何一个音。
然后本机跑一个语音模型,把整条音里的每个字切出起止时间。默认后端是 FireRedASR2-CTC 的 int8 版本,跑在 CPU 上,不需要显卡,出来是一张表:第几个字,从第几毫秒到第几毫秒。
后面的所有时间都从这张表里查。分镜里每个动效的起拍点不许人敲,一律按"第几句话的第几个字"去表里取;取出来的值跟表里的差超过 0.1 秒,脚本报错。所以这个工具里没有"大概在这一句"这种写法:一个数字什么时候开始滚,跟着的是"同比增长"里"比"字落下的那一毫秒,而不是这句话开口的那一毫秒。
再往后,每句话先归到 26 个语义词里的一个,比如数字、对比、流程、章节、强调,按词去 108 张动效卡里挑候选,写成一份分镜表:每个镜头用哪张卡、什么时候进场、什么时候让位。这份表的最后一节叫未完成清单,允许写"无",不允许缺这一节,专门拦"没做完的被写成设计选择"。
渲染交给 Remotion ,一个用 React 写视频的框架。一条音轨不能切段拼,切了会因为编码器的前导延迟逐段错位,所以声音整条渲、画面按镜头分段渲,最后合起来。渲完不只是一个 mp4 ,还有一个能改的工程:打开时间线,每段动效都挂着它对应的秒数,改哪一句就直接改那一格。
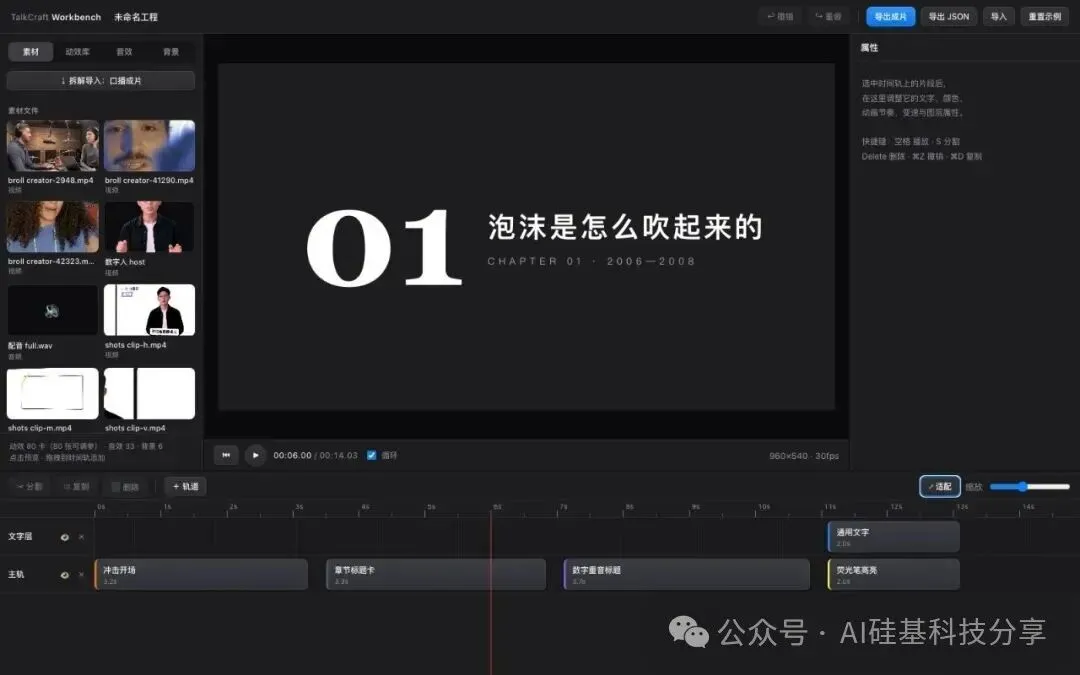 这是这个工具交出来的“工程”,不是成片。上半左边是素材(实拍片段、数字人、整条配音
full.wav),中间是预览画面,右下角标着 960×540 、 30fps 。下半是时间线:靠上那条叫“文字层”,挂的是一段 2 秒的通用文字;下面那条叫“主轨”,挂着冲锋开场、章节标题卡、数字圆标题题、荧光笔高亮四张卡片,每张标着自己的秒数。右边是选中片段后的属性面板。
反 PPT 靠删
PPT 感长什么样,看一段口播就认得出来:标题飞进来,字钉在屏幕上不动,下一句来了硬切一页,一页里塞着四块内容。要修的是两件事:让画面一直在动,让每句话有自己的动作。它的做法从删开始。
一套常见的口播动效系统里会有这些东西:主体待机时轻微浮动、环境的呼吸感、一道扫光、曝光脉冲、相机的脉冲式推拉。这五样它全从系统里拿掉了。
留下的只有一条:每个场景一次极缓的推拉,画面从 1.00 推到 1.04 或 1.06 ,也就是全片缓慢放大 4% 到 6%。慢到几乎看不出来,但每一帧都有位移。
跟推拉配套的是让位。一个主体说完它这一段就该退场,把位置让给下一个。画面里的东西因此有进场、停留、退场三段,不会进场之后一直待在那儿。
再往下是一组数量上的纪律:一个画面里同时站的主体不超过三组;每个镜头留一个空着的角;切镜前留 0.7 秒缓冲,开镜 1.5 秒内画面不能空着。
加动效是叠一层,删动效是判断哪一层本来就不该在。它把这个判断交给了机器:一段画面如果连续若干帧没有变化,验收脚本直接判不合格。一条片子里只要有一段时间画面完全静止,这条片子就交不出去。
40 毫秒对 33 毫秒
README 上写的精度是"20 到 40 毫秒"。这个区间是把两个后端的中位数拼在了一起。
这批数字是作者自己测的:一支 110 秒口播、 472 个字,拿 GPU 对齐结果当标准答案。
默认后端 FireRed 的成绩是:中位 40 毫秒, 95 分位 100 毫秒,最差 200 毫秒,质检误报 0 句, 110 秒音频推理 24 秒。换成 faster-whisper 之后,中位降到 20 毫秒,但 95 分位 140 毫秒、最差 413 毫秒,还有 2 句边缘误报。
换成帧就好懂了。 30fps 一帧 33 毫秒,中位 40 毫秒比一帧多 7 毫秒,一帧出头;最差 200 毫秒是六帧。它在验收标准里另写了一条规定:把时间对齐到帧这一步,量化误差的上限是 16.7 毫秒( 30fps 一帧 33 毫秒,正好半帧),不宣称 5 毫秒以内,那要 120fps 才做得到。
这套数字有一个前提:全部是作者自己测的,同一台机器、同一支 110 秒的样音,没有第三方复现过。
108 张卡,每张都写着"调过头会怎样"
仓库首页那句项目简介写的是 109 张动效卡,按 references/cards 目录点,是 108 个文件;二手文章里还有 78 和 79 两种写法。以目录为准: 108 。
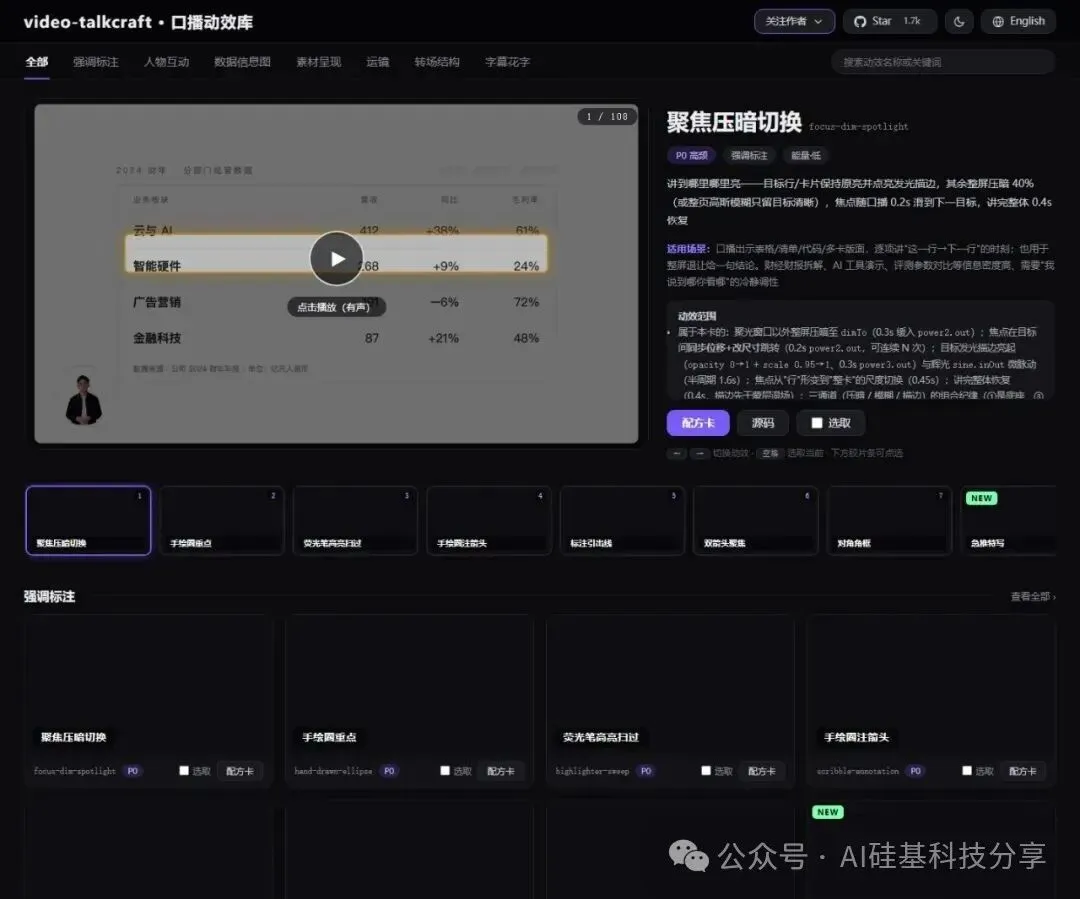
这 108 张不是模板。每张卡的正文固定四节,其中两节是参数表和已知坑, 108 张全都有。参数表里每一个数字后面都跟着一句"调过头会怎样"。
举一张:数字滚动。计数时长给的是 1.3 秒,注着"缩到 0.8 秒干脆利落,适合快剪;超过 2 秒观众等得不耐烦"。落定时弹一下,弹幅 1.08 ,注着"超过 1.15 像在抢数字本身的戏"。
审美在这套东西里被写成了区间和失效条件:你不用猜作者想要多长,照表调,表上写着越界会怎样。
卡可以改,改法有下限:颜色、字体、文案能换,时序、缓动曲线、几何比例不能动,脚本会算改完的版本和原卡的相似度,低于 0.55 就不通过。能换皮,换不了这套片子长什么样。
配套的验收分三关。第一关是六条机器闸,画面静止或发抖、音效被人声盖住、卡片改得不像原卡、节拍跟字对不上,这些都有脚本在判。第二关是独立审片,另起一个上下文,让没参与制作的人从头看一遍,不许制作者自己评自己。做的人看自己的片子,看不出哪里不对。第三关是规则合规,分镜和成片逐条对回文档里的规矩。
这三关判的是"合不合作者的规矩",判不了"这条片好不好看"。相似度那一关判的是像不像原卡,音效那一关判的是有没有被盖住,标准都是作者自己定的,没有外部标定。
两道许可闸,和 1.6GB 的依赖
许可是两道闸。工具本体用 PolyForm Noncommercial 1.0.0 :个人、教育、研究免费,做出来的成片归你,商业使用要事先授权。渲染引擎 Remotion 另有自己的协议:个人和非营利免费,营利组织在 3 人以内也免费, 4 人以上要买 Company License 。
授权怎么收费,没有公开条款。 9 月 23 日有人在 issue #43 里正式问:个人接单帮小微企业做视频算不算商用、要不要付费、按什么形式。作者的回复只有一句:"发邮件说明商用情况,我会邮件回复。"
GitHub 的协议识别把这个仓库标成"其他",它认不出 PolyForm 。同一个作者的另一个库 video-shotcraft 是 Apache-2.0 , 13,001 个星标,做产品宣传片;这一个做口播解说,协议收紧了。
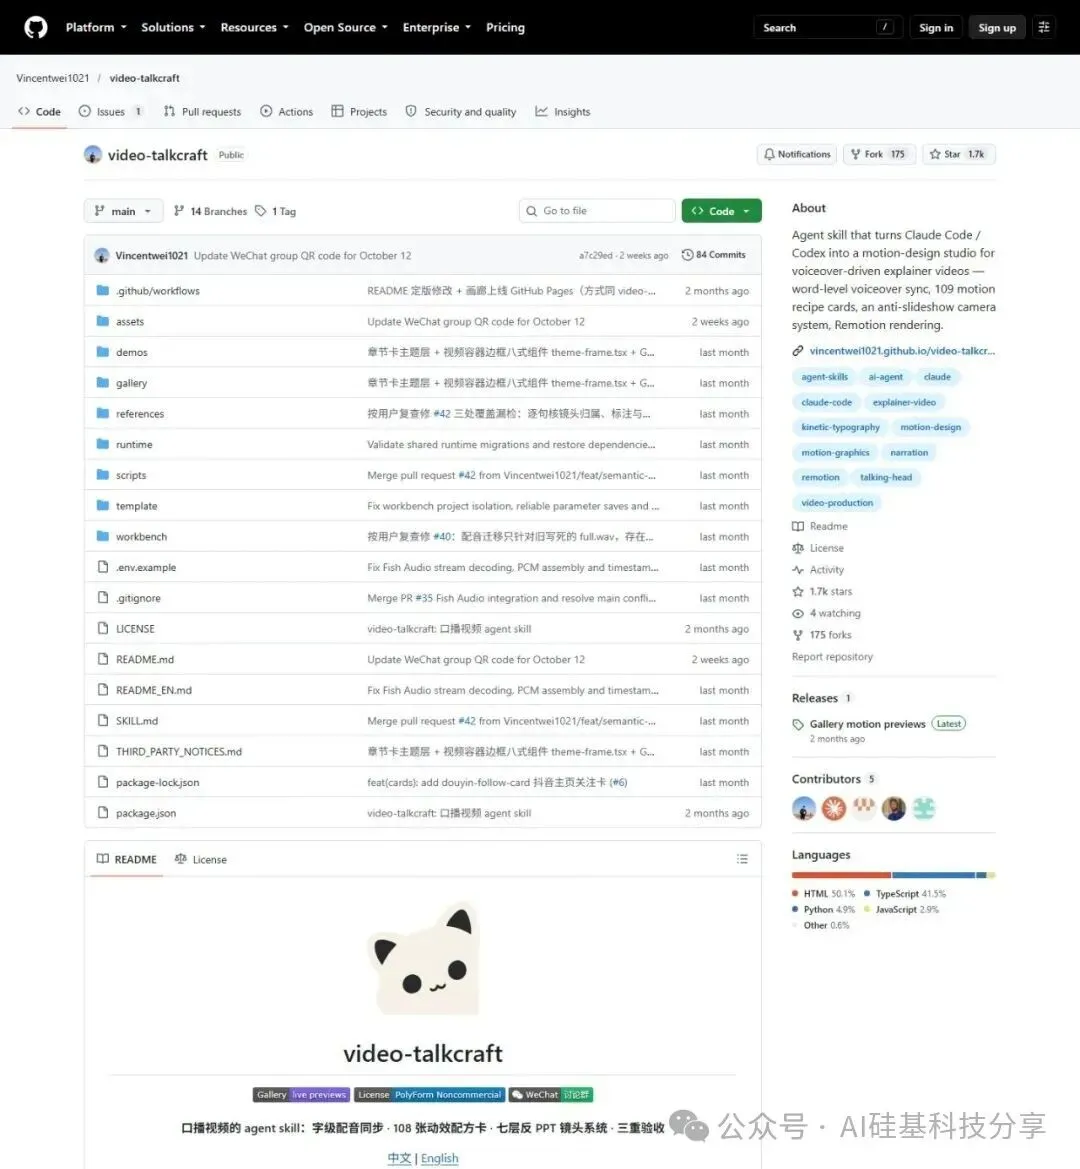 这是仓库首页。右上角是 1.7k 星标、 175 个 fork ;右栏 About 里 “License” 一项后面是空的——GitHub 认不出 PolyForm ,所以不给协议名。文件列表显示 14 个分支、 84 次提交,最新一条是“更新 10 月 12 日的微信群二维码”。最下面的 README 首屏有中文简介和“中文 | English”切换。
依赖也重。node_modules 一份约 760MB ,模型第一次跑要下 767MB ,浏览器内核还要单独再下一次,三笔加起来 1.6GB 起,另外得装 Node 、 Python 和 ffmpeg 三套环境。这些数是作者写在 README 里的,没有实测。
比硬盘更现实的是内存。它不用显卡,但把 193 秒的音频整段喂进去,峰值内存 8.1GB 、耗时 62 秒;到 210 秒, onnxruntime 直接在编码器的自注意力层崩掉,因为内存随音频长度按平方涨。脚本默认按静音切成 75 秒以内的段, 34 秒的一段只要 2.4GB 。三分钟以上的口播,撞的是内存墙,不是算力墙。
范围也窄:只做口播和解说,默认横屏 1920×1080 ,中文优先;必须同时给稿子和成品配音,没有稿子,它只能把口水词标出来报告,不敢下剪刀。剧情片、纯音乐混剪、数字人都不在范围内。
对想拿它接单的人来说,卡住人的是两件事:工具商用要事先授权、没有公开报价,渲染引擎对 4 人以上的营利组织另收 Company License ;三分钟以上的口播还得切段跑,改一次就要重渲一段。自用和教学不受这些限制,接单会同时撞上许可和机器。
1,713 个星标,仓库里没有一条成片
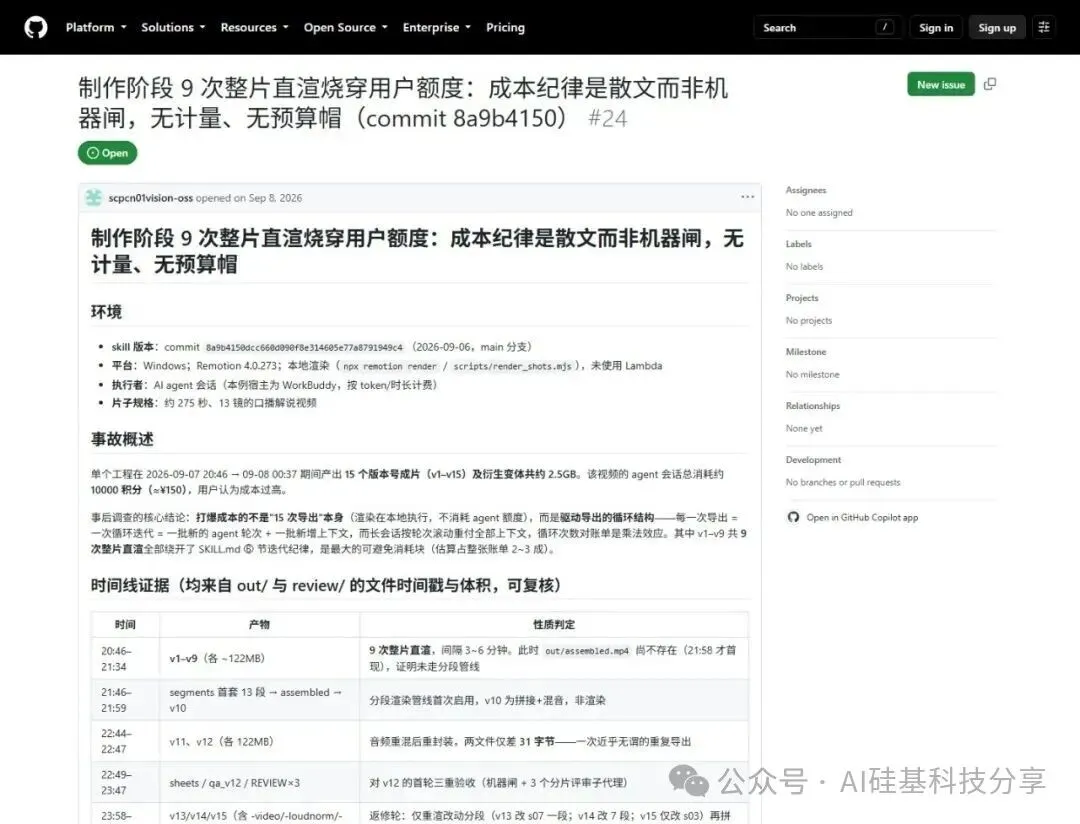
成本这件事有一个还开着的证据。 9 月 8 日有人提了 issue #24 ,标题写的是"制作阶段 9 次整片直渲烧穿用户额度":没有计量、没有预算帽,成本纪律只写在文档里,不在机器闸里。作者后来加了一步"先做一个镜头、确认了再铺开",计量和预算帽到现在没做,那条 issue 还开着, 0 回复。三关全过的片子,额度照样能烧穿。
再就是证据本身。这个仓库 2026 年 8 月 22 日建库,到 10 月 23 日有 1,713 个星标、 175 个 fork ,仓库里一条成片 mp4 都没有。 108 个 HTML demo 是真能点开、能自己动的,但那是单张卡的预览,不是一条完整的片。 Hacker News 上搜这个项目名, 0 条结果。所有性能和精度数字都出自作者自测,测的是同一支片。
代码最后一次实质改动是 9 月 22 日,之后 10 月 12 日那次提交只换了微信群二维码。
开头那句判断,在这里落了地:一条口播视频像 PPT ,塌的是两个地方,时间是按版式排的,动作是往里加的。这个项目把时间交给音频,把动作压到一张写着失效条件的表里,再用机器把两头卡住。
这套办法能走多远,取决于那张表里有多少是一个人的口味。目前 108 张卡、 26 个语义词、 0.55 的相似度下限,都是一个人的。它能保证片子"像这个作者会做的片子",保证不了"好看"。
要看这类工具值不值,两个地方可以自己核:它有没有把"删掉什么"写成规则,还是只把"加上什么"做成一个素材库;它的性能数字有没有第二个人跑出来过。

