搭上workBuddy,我把Excel表格里的红利策略应用,制作成了一个微信小程序
- 2026-11-07 04:08:06
10 月 24 日,「卒子日记」(红利交易小助手)小程序通过微信审核,终于发布上线。从第一行代码到正式发布,历时了整整一个月,特别以此文记录这一路的关键抉择与弯路。
一、起点:一张我用了很久的 Excel
一切始于一张我用了很久的表格——《历史分红表格及对应现金流表格.xlsx》。里面七张子表:29 只高股息标的的分红下限、基准股息率、购买价格上限;每只标的 9 档网格价格带(4 档买入、基准、4 档卖出,每档 5%);银行、保险、其他高息行业的五年分红数据等等。
这套「股息率锚定 + 网格分档」的体系我自红利策略执行以来,一直在维护;但 Excel 有天然短板:它不能跟着我走。我人在外面,想看某只标的现在站在第几档,得回家开电脑。
于是我起了念头:把它搬进手机,想做一个小程序——标的池、九档价格带、交易记录、收益统计,全部按我自己的口径来。说实话,以我这个外行,这个念头搁在以前只能是个念头,这次我决定和 WorkBuddy 搭伙试一试。
二、它长什么样:功能与界面一览
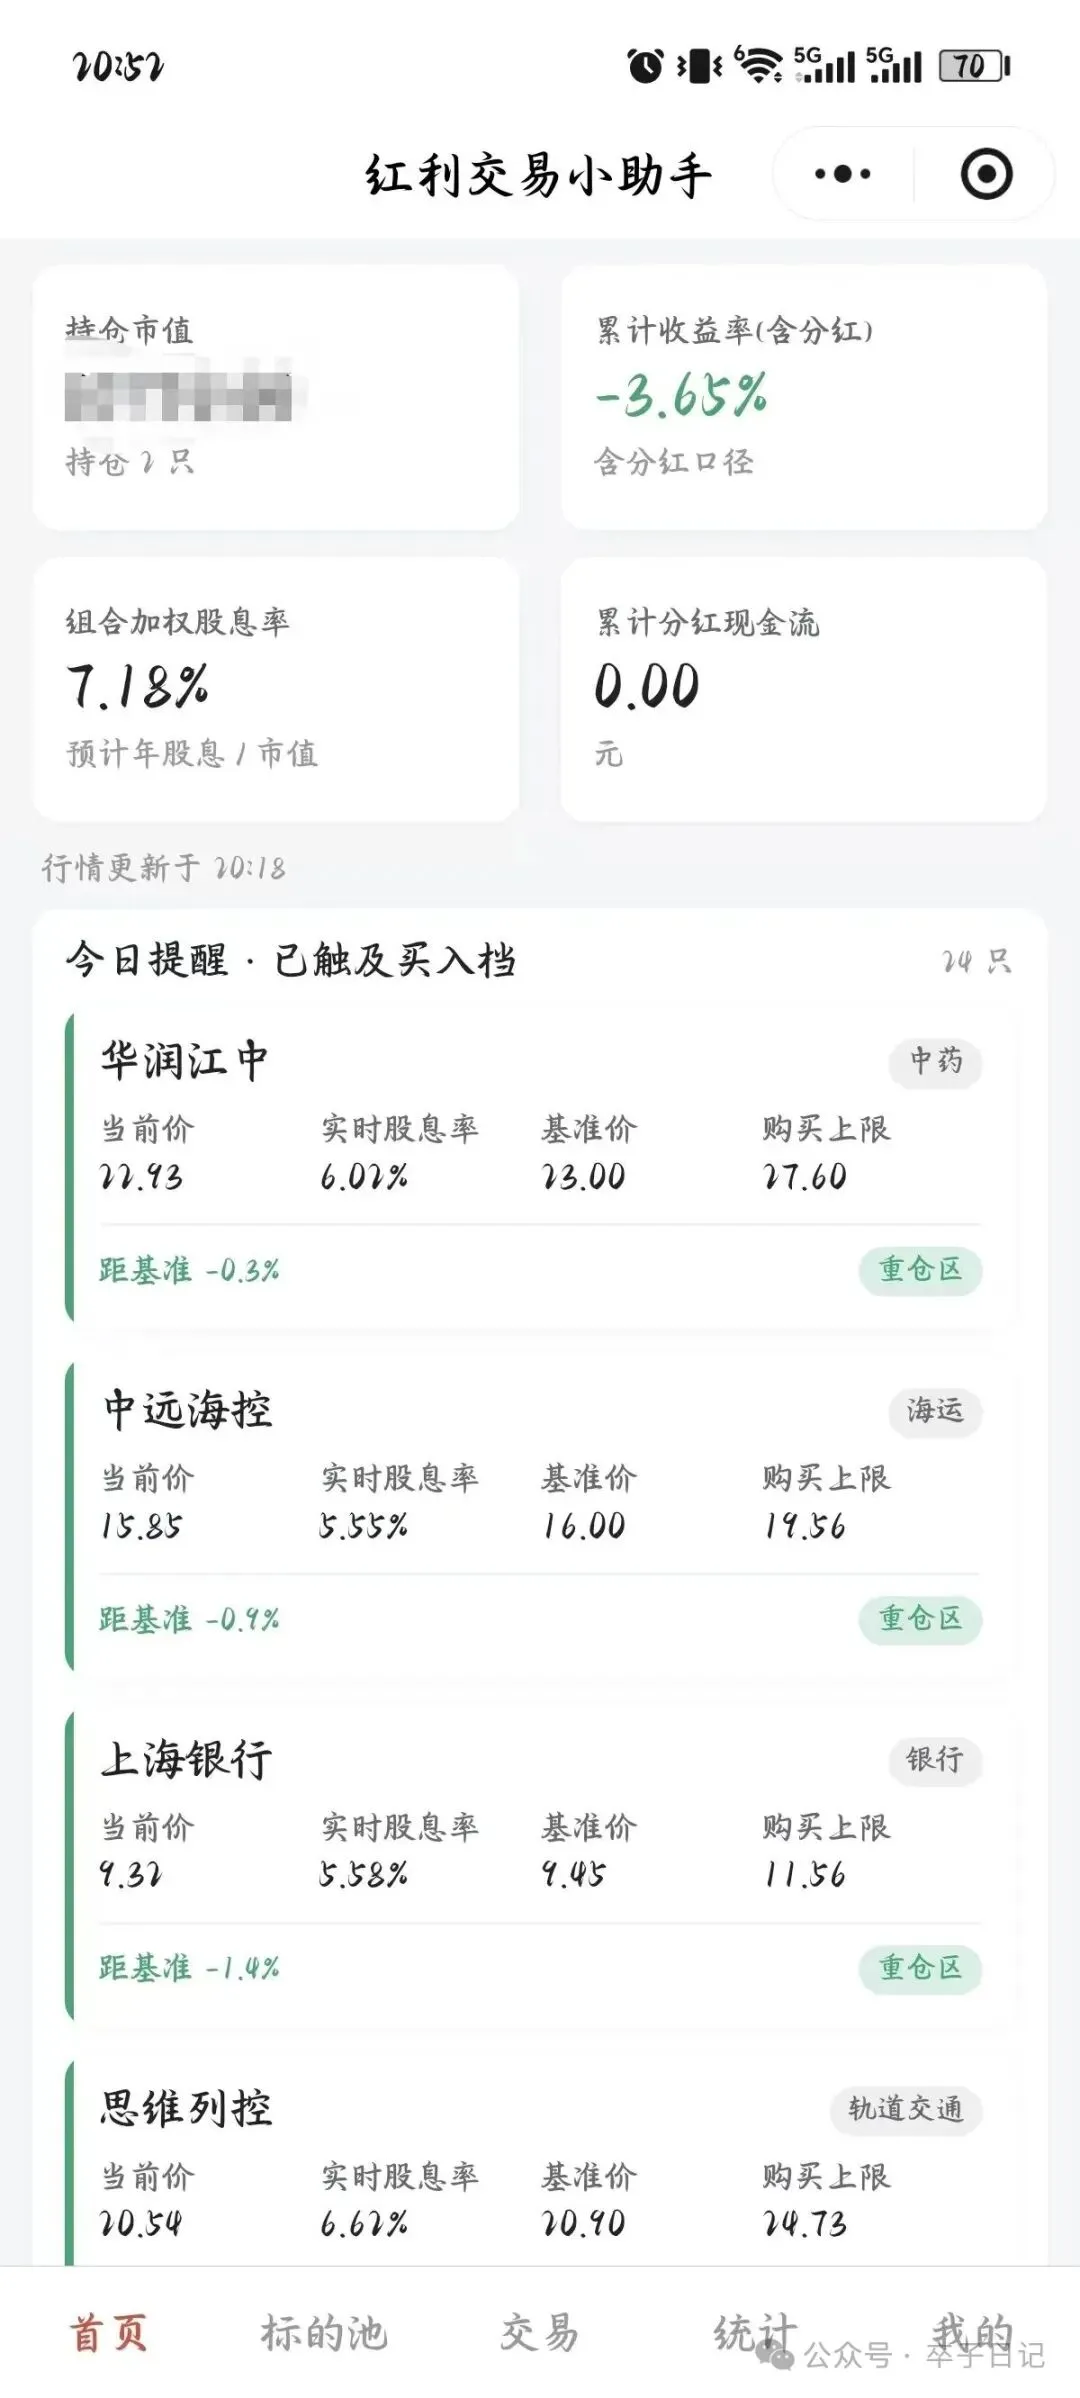 | 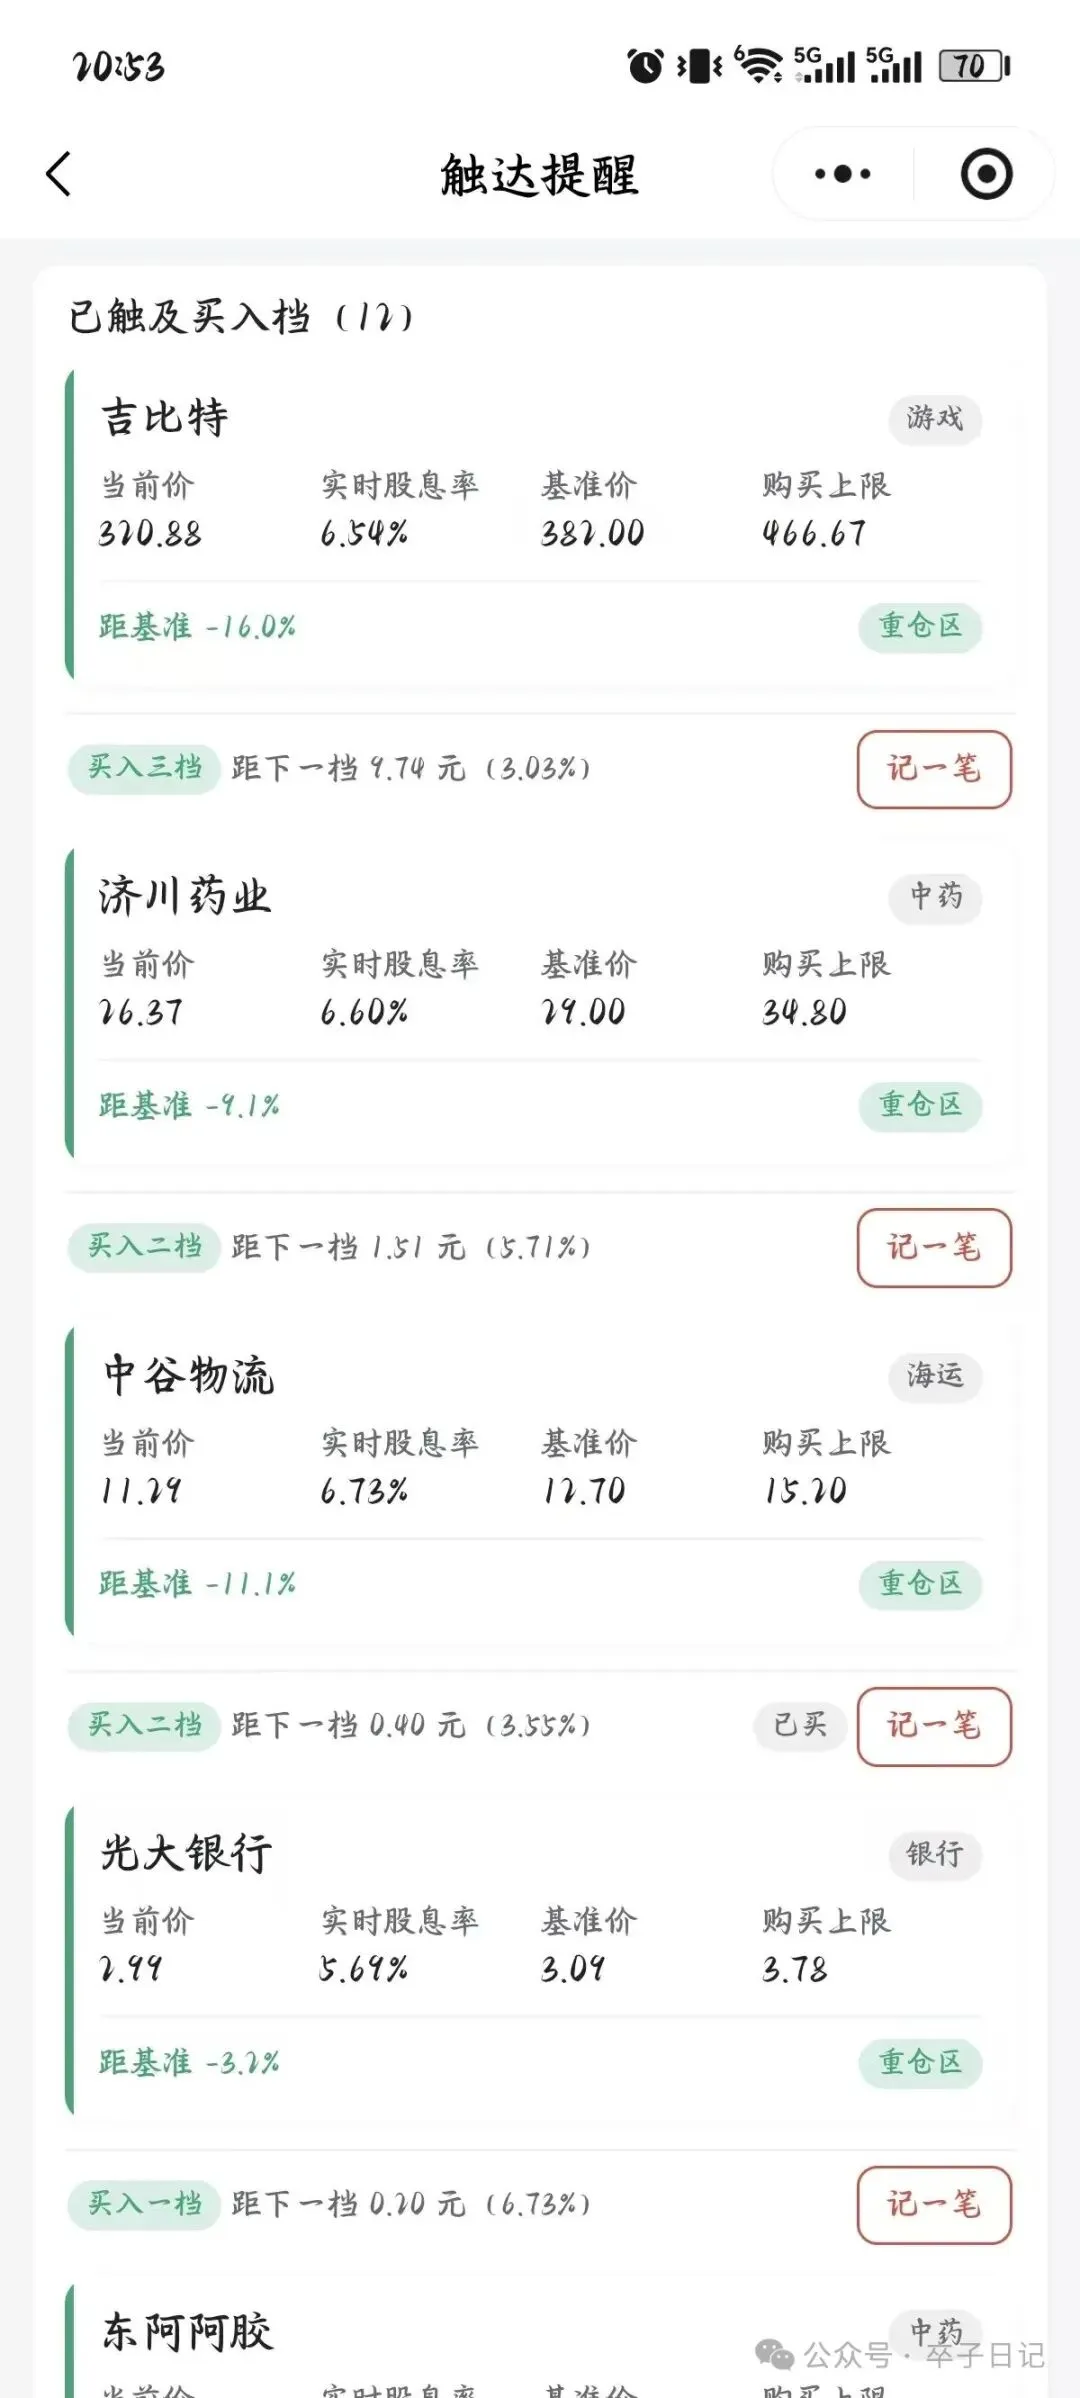 |
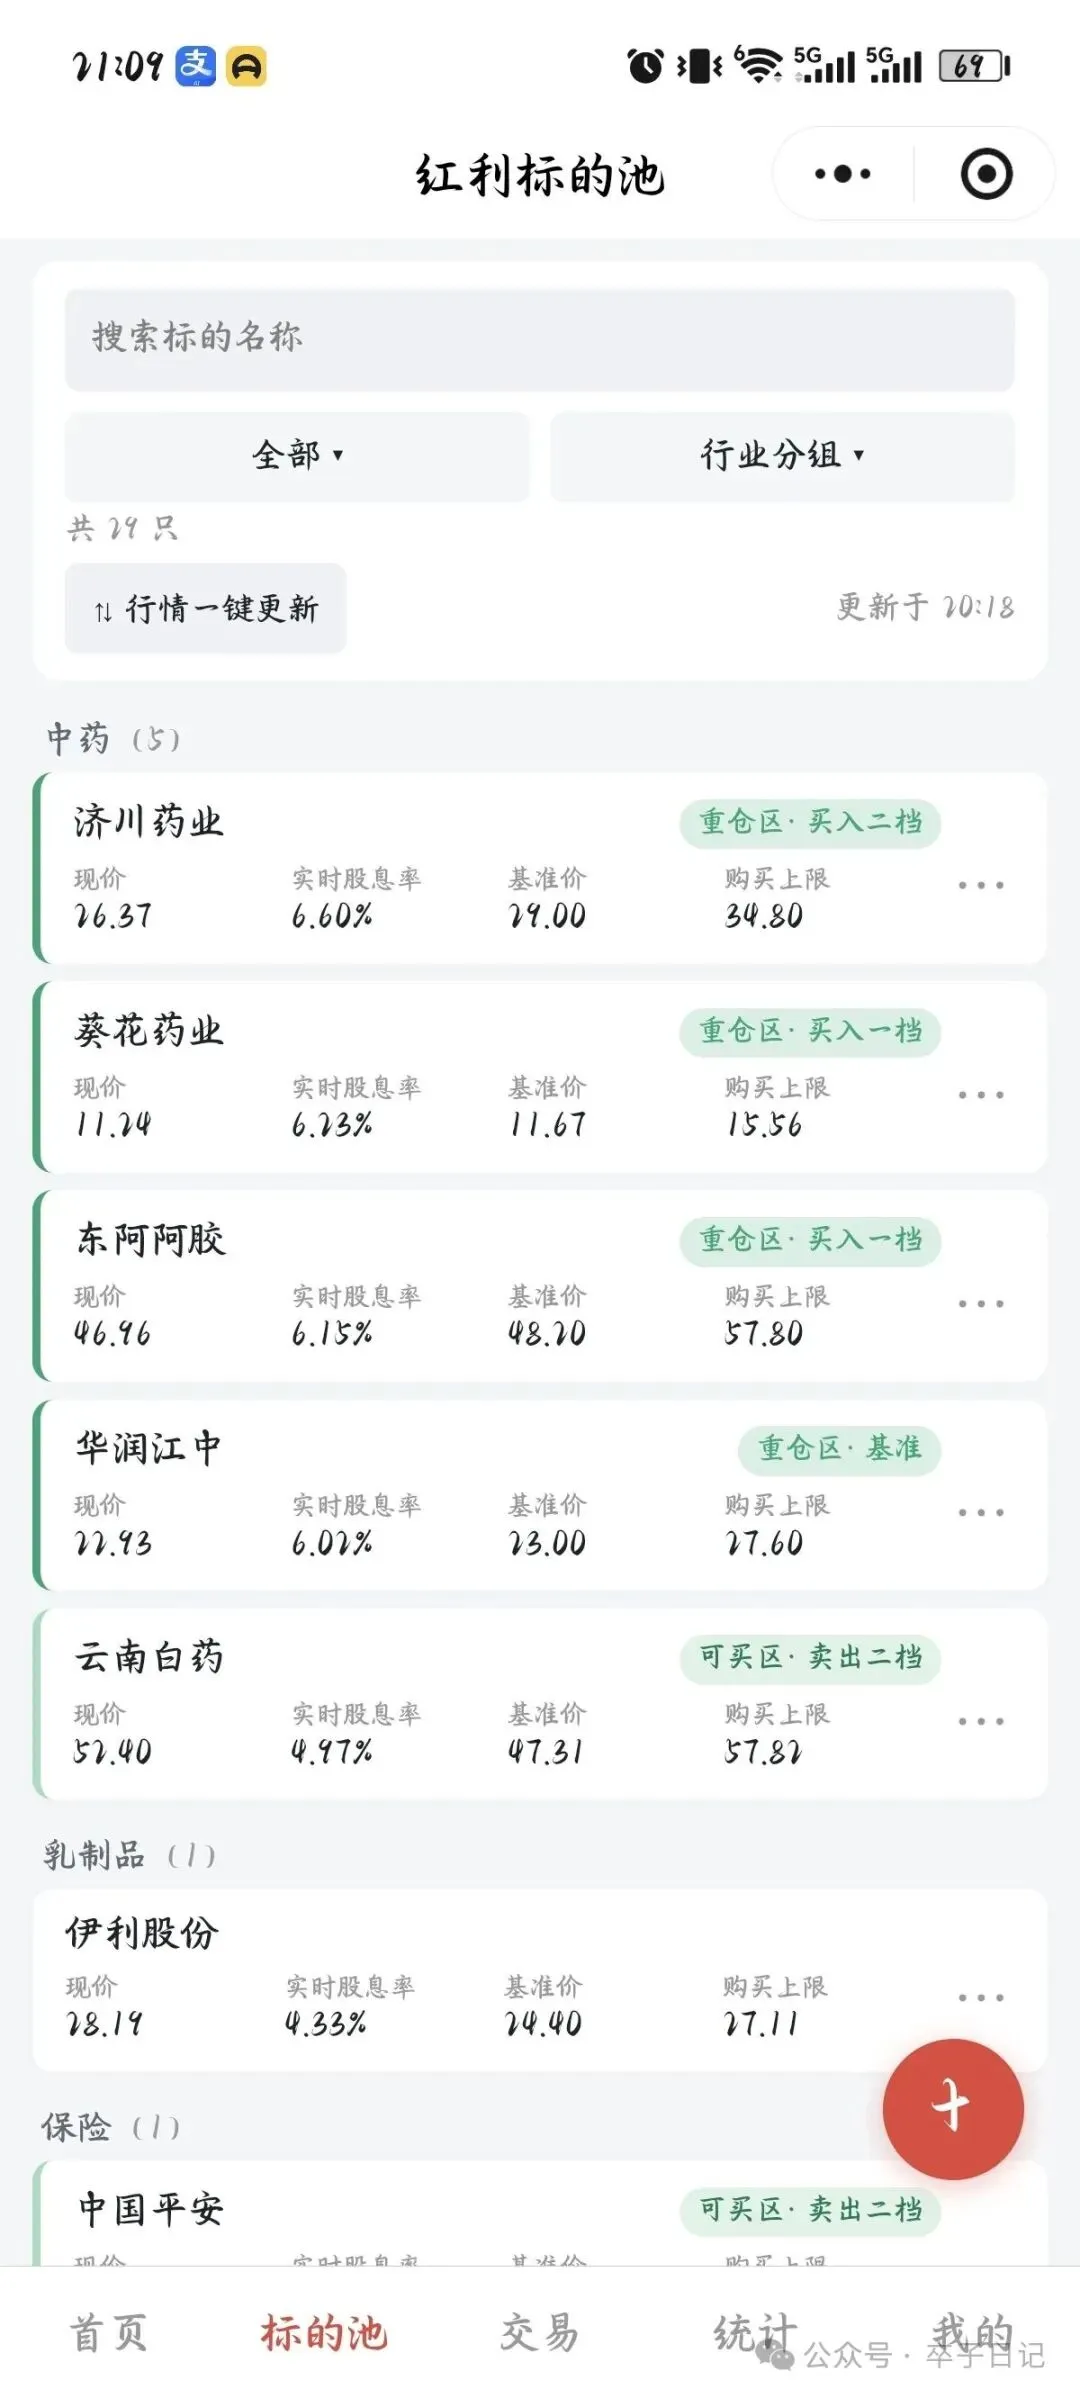
· 首页 · 标的池:自选的高股息标的一屏铺开,每只显示当前价格、实时股息率、基准价以及购买上限价——一眼看出谁已进入低位档、谁的分红临近。
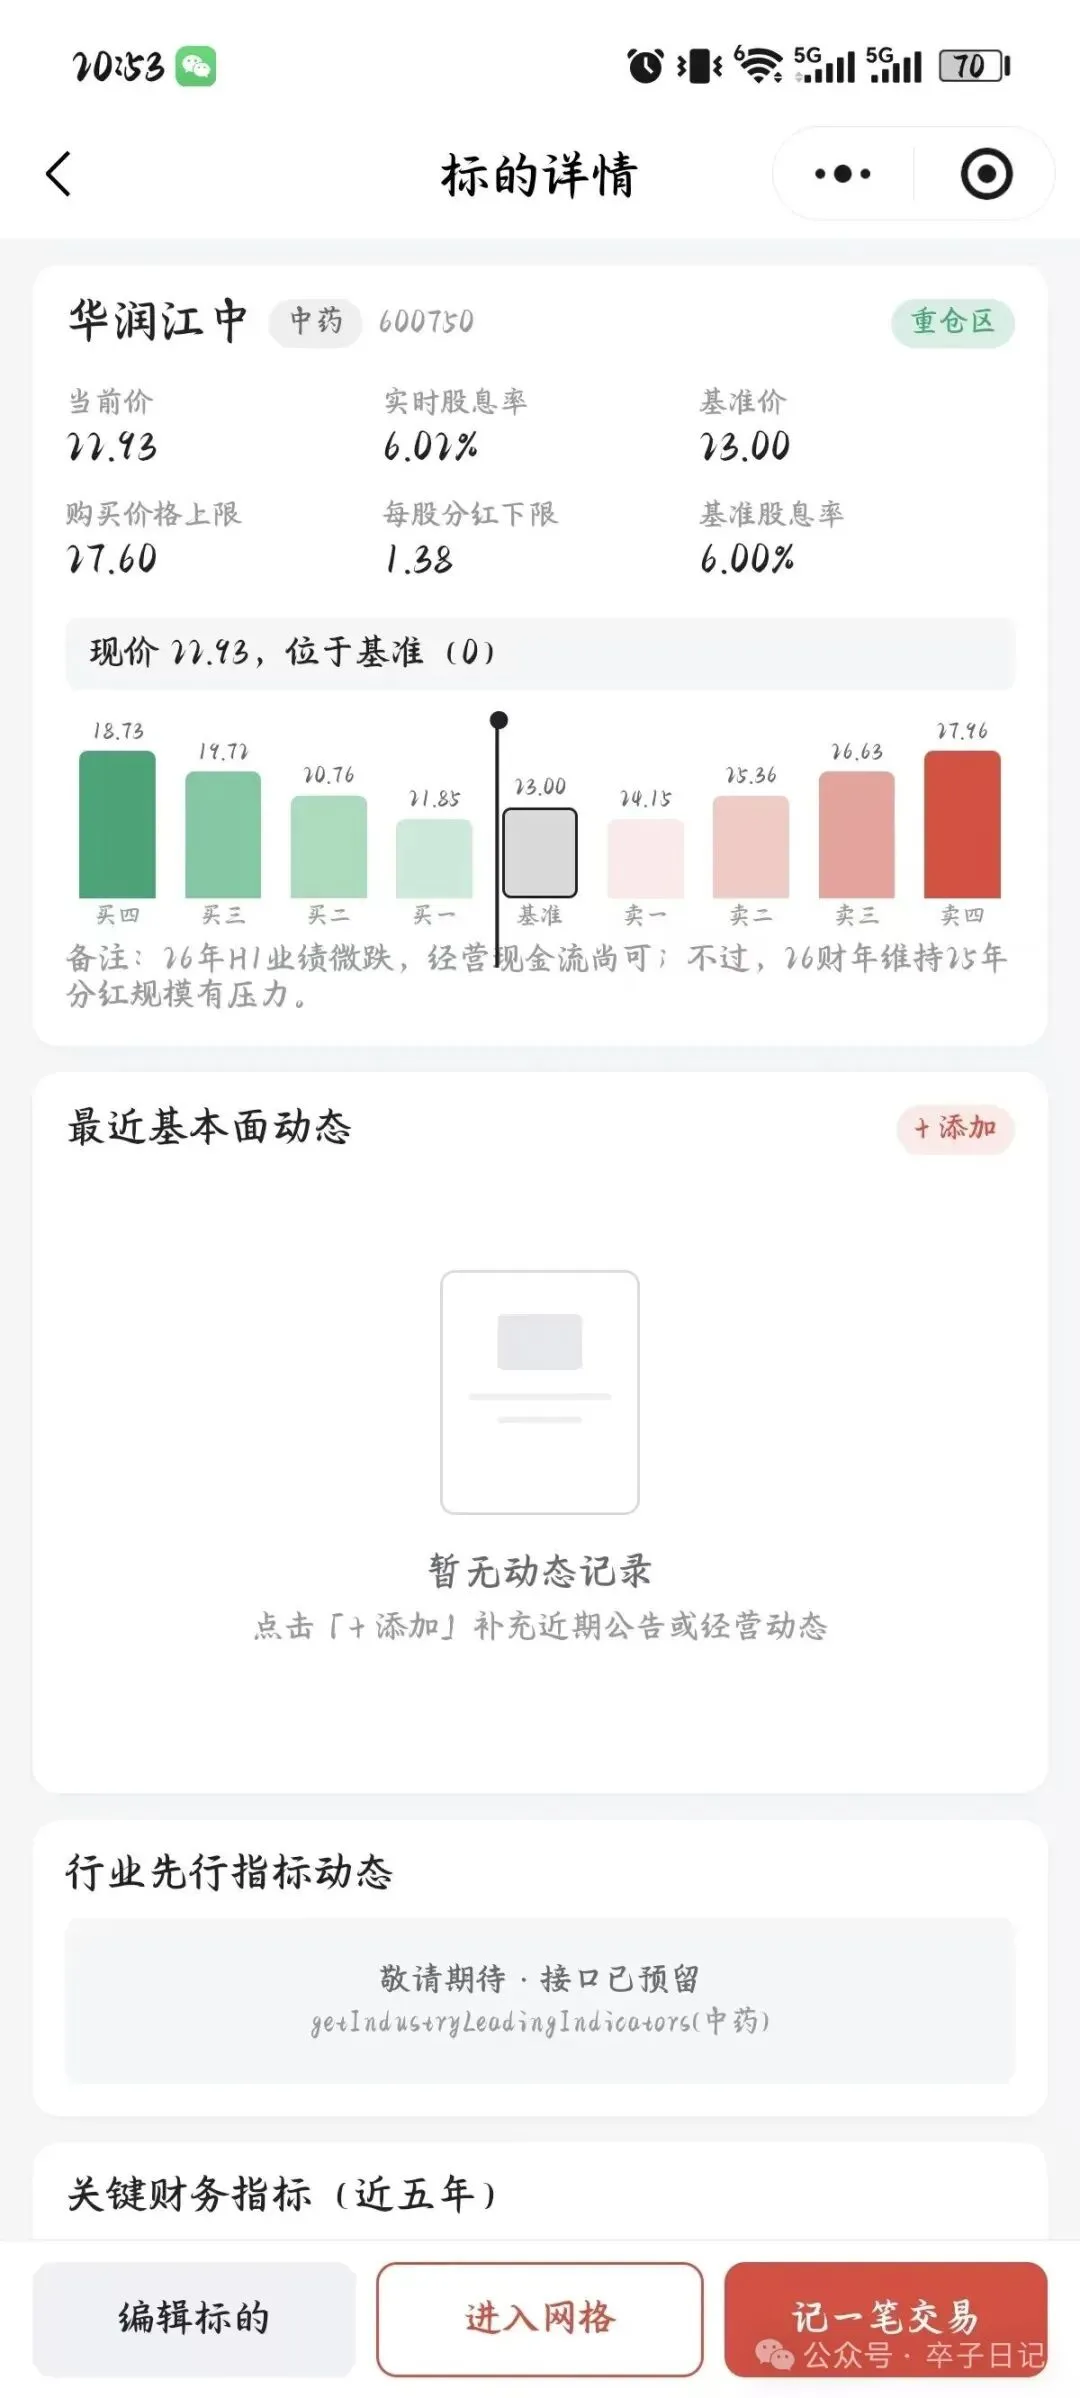 | 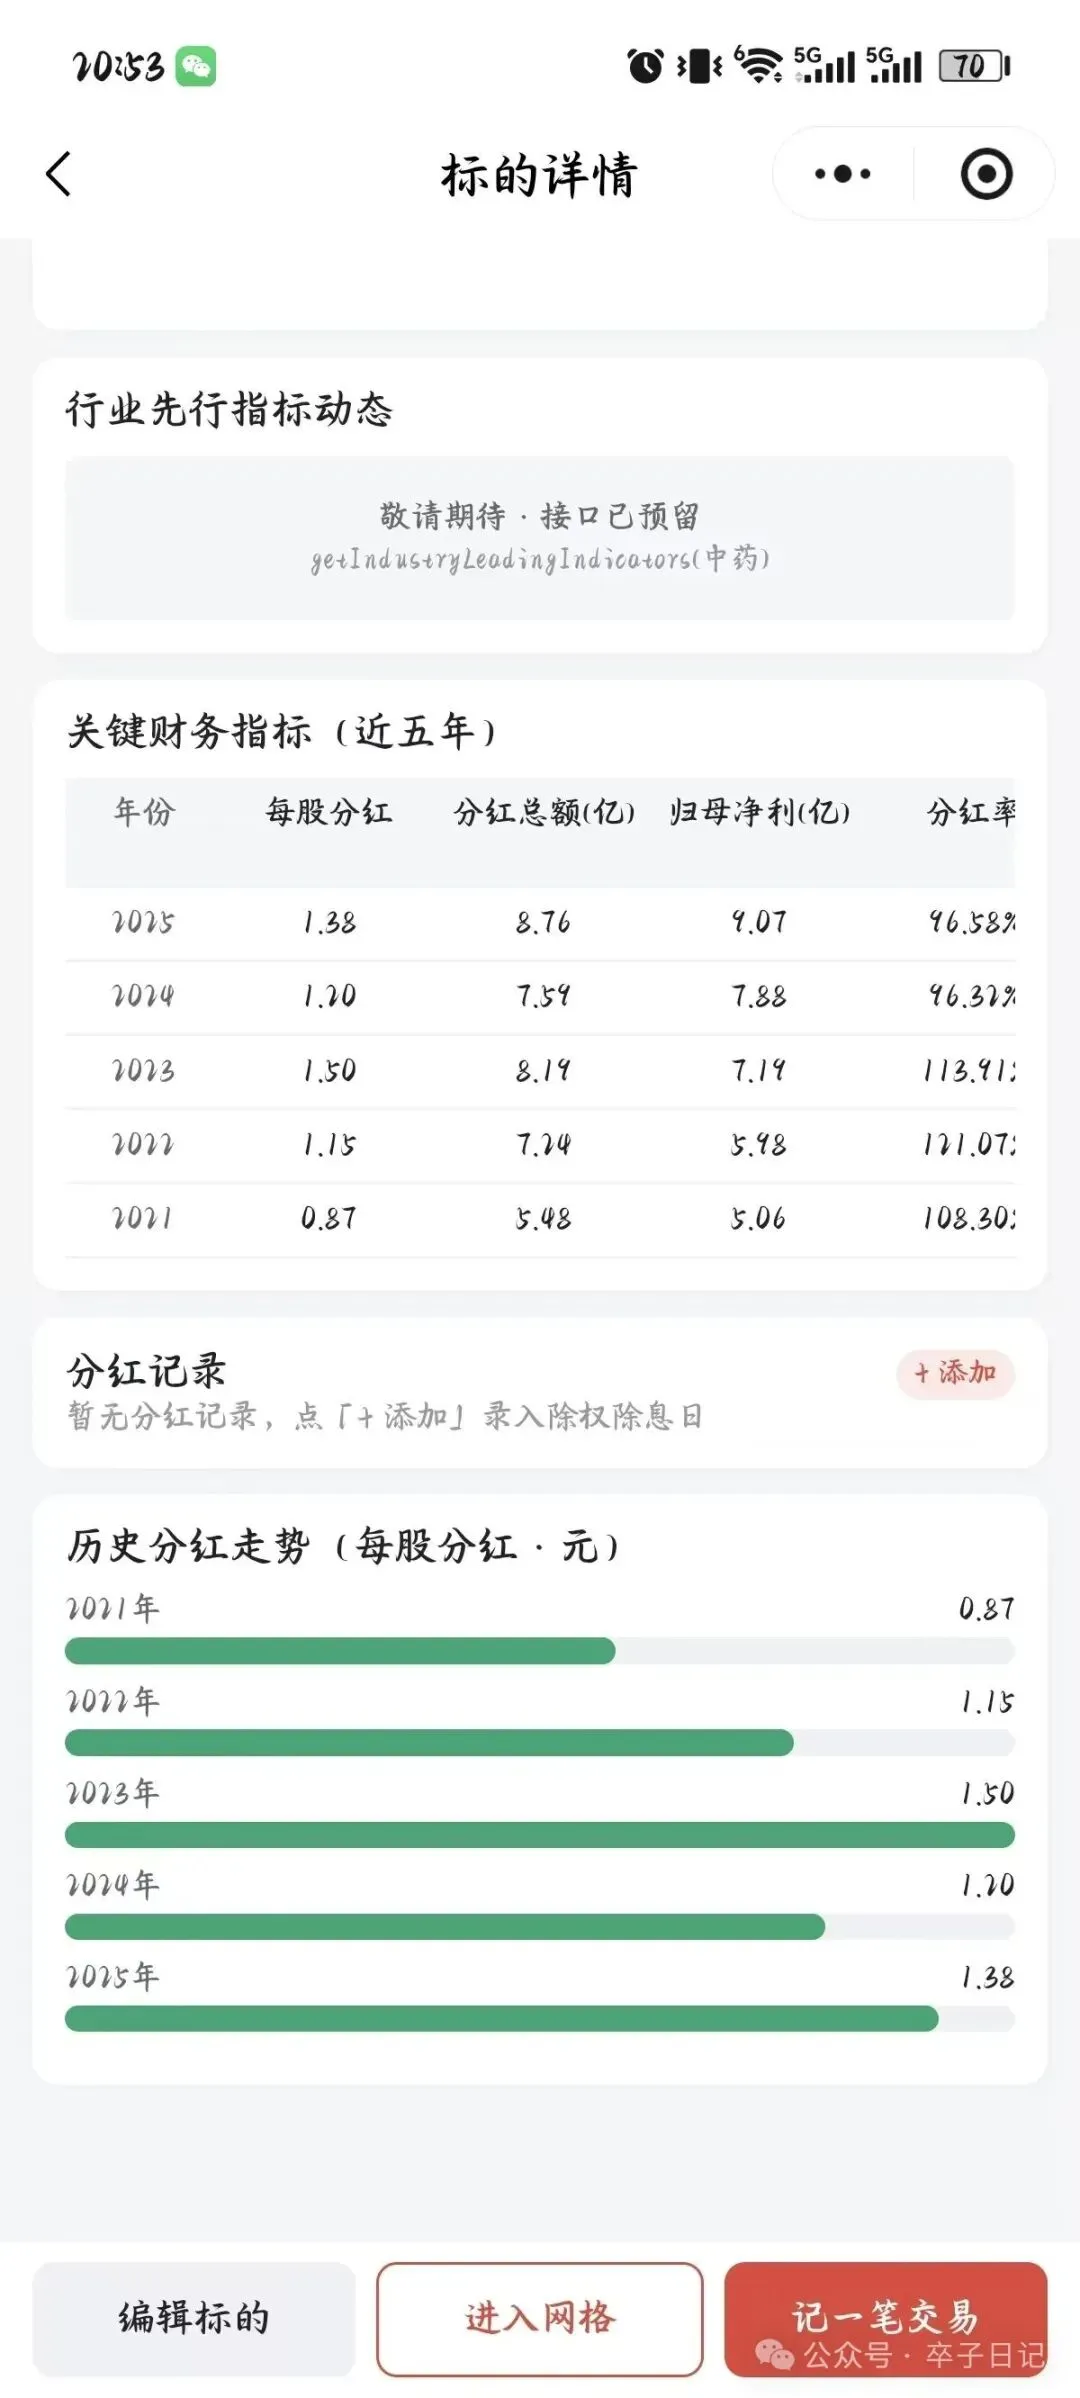 |
· 个股详情 · 九档价格带及分红日历:4 档买入、1 档基准、4 档卖出,每档 5%,按触及深度配由浅到深的颜色;基准价以下一律“不卖”。同时还补充个股基本面动态、相关先行指标动态、过去的分红日历数据详情,这是我那张 Excel 里最重要的信息,现在随时能看。
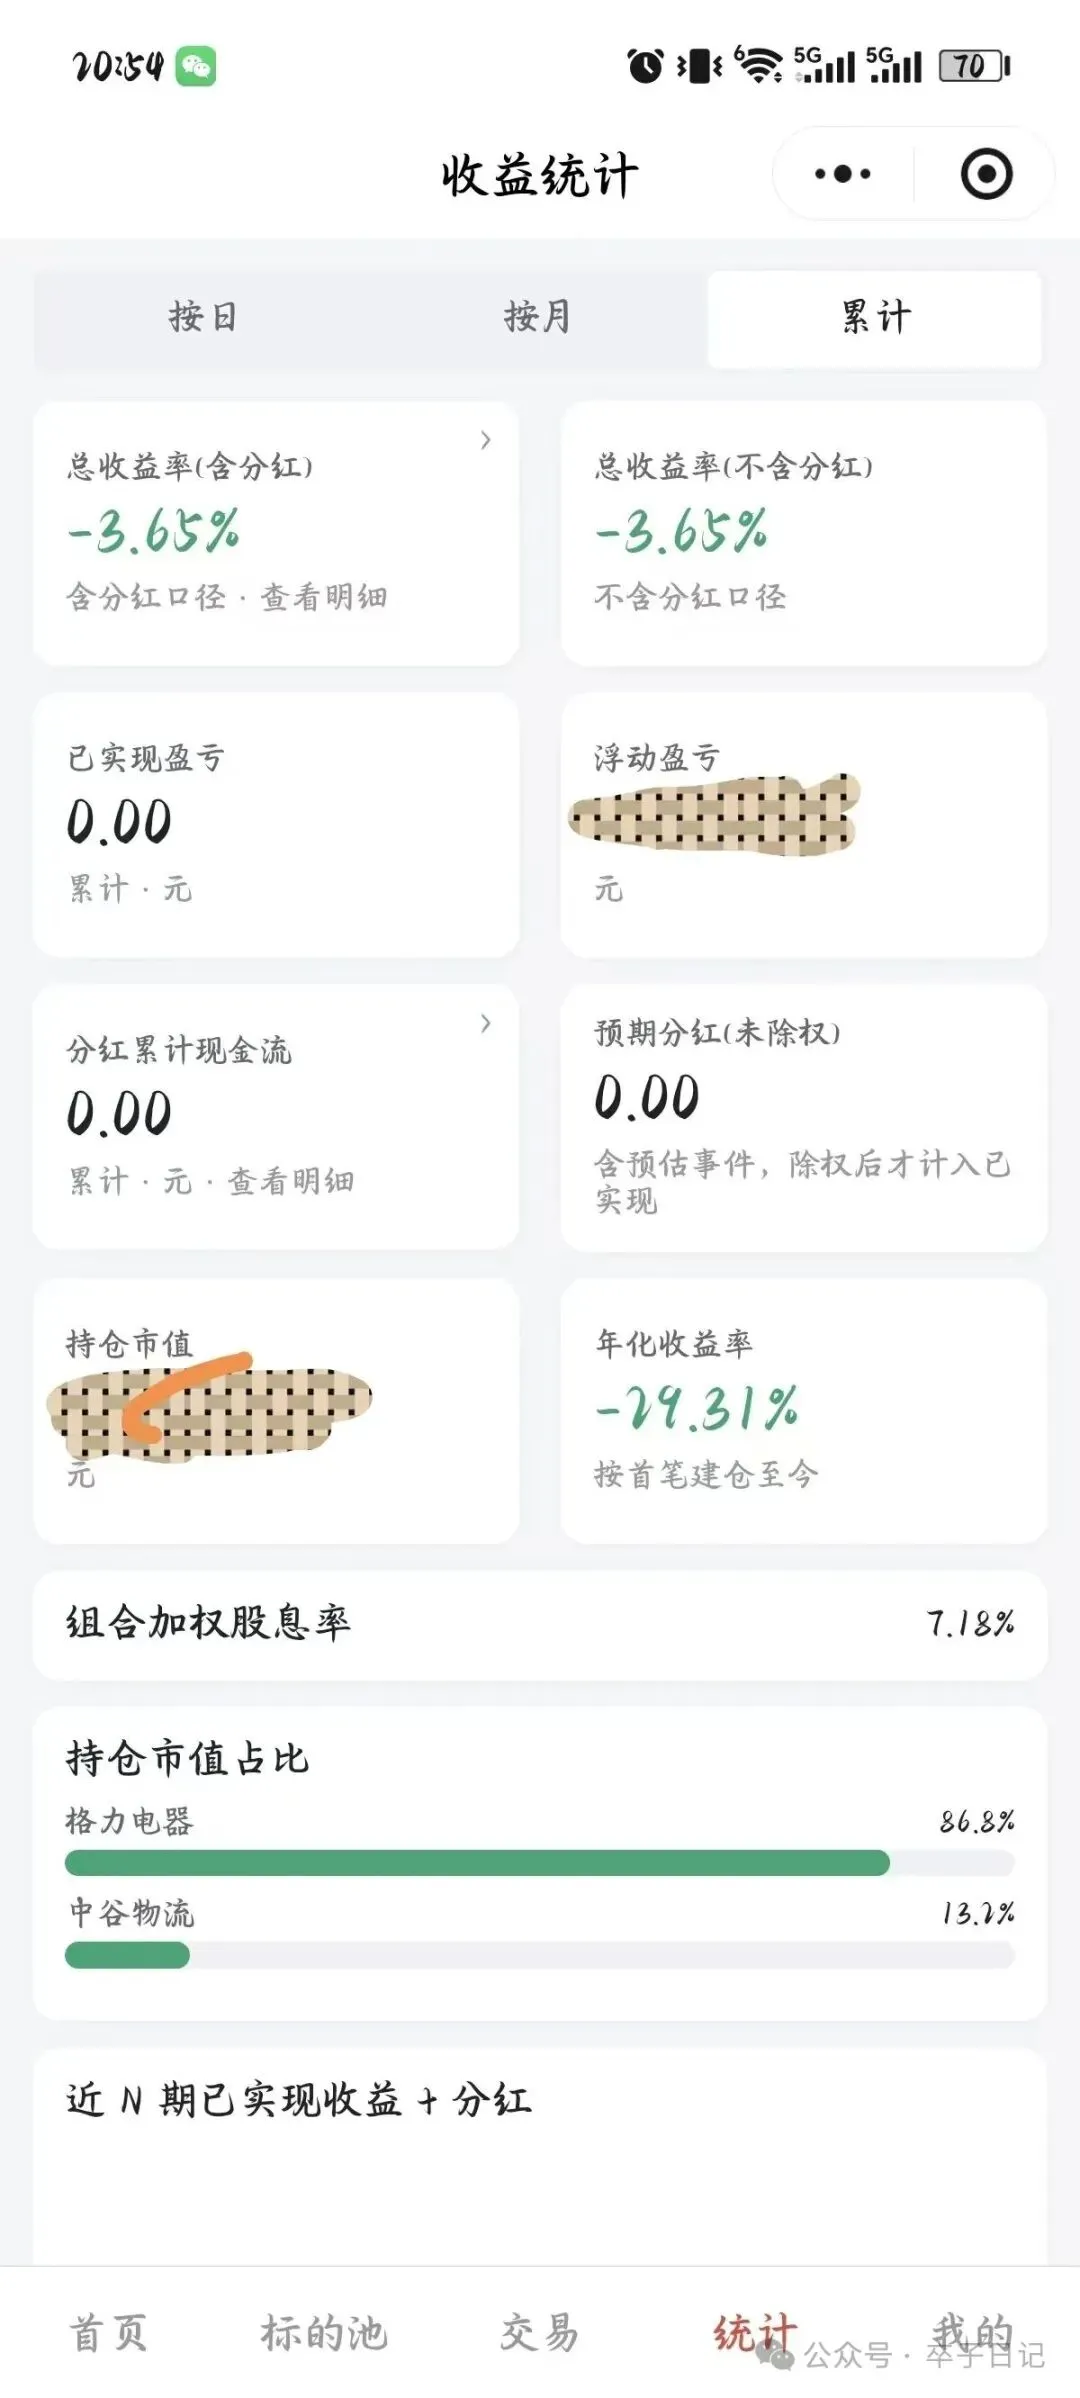 |  |
· 交易记录与收益统计:自己可以在交易界面记录每一笔买入卖出,系统自动会计算出实时收益情况;收益里“已实现分红”和“预期分红”严格分离——未除权的分红绝不虚增当期收益,这些还是小程序制作过程中实现的功能延伸。
三、第一个难关:一个“基准价”就有两种算法
项目启动比我预想的顺利——WorkBuddy的AI 技术团队按需求文档、架构设计、代码实现、测试验证的流水线跑,十几个页面和全部工具模块一次成型。真正的麻烦出现在测试阶段。
测试发现了一个我从未意识到的问题:「基准价」到底以谁为准?我的表格里,有一列是公式算出来的基准价(每股分红下限 ÷ 基准股息率),而网格价格带是我手工敲定的锚定价——两者并不完全相等。程序自动取了公式值,逻辑上“对”,但和我多年手工校准的锚定价对不上,九档价格带整体偏移。
这个问题的价值在于:代码的“正确”不等于数据的“正确”。最后定下双字段方案——以我的手工锚定价为权威(参与网格计算),公式值保留作参照并标注来源。29 只标的 × 9 档共 261 档价格与 Excel 逐位核对,零偏差。
这件事让我明白:和 AI 协作开发,最重要的不是让它写代码,而是把我脑子里的隐性规则显性化。我自己都说不清的口径,程序永远做不对。
四、第二个难关:未来分红偷偷虚增了收益
分红日历功能上线时,AI 主动发现了一个口径漏洞:我录入的“预期分红”会被无条件计入当期收益——也就是说,一笔还没除权的分红,会让统计页立刻虚增收益率。
正确的规则是分离:已除权的分红才是“已实现”,进收益;未除权的只算“预期”,单独展示。规则定了,问题又来了——测试发现除权日当天 0 点到 8 点之间,统计页和日历页对这个分红的判断会不一致。根因是日期解析的时区问题:日期字符串被默认按 UTC 解析,比北京时间早了 8 小时。
一个看似简单的“日期”,背后藏着时区、口径、边界三重坑。这类问题 AI 能自查出来,但它需要被明确要求“去查”,而不是默认正确。
五、第三个难关:行情数据在真机上根本拉不到
最大的技术坎是行情。开发者工具里一切正常,可微信的规则是:小程序只能请求已备案的白名单域名,而行情源既不是我的域名,也不可能给我备案。工具里的“不校验合法域名”开关,体验版真机根本不认。
解法是云开发:写了一个云函数跑在腾讯服务器上,由它代抓行情——服务器之间访问外网不受小程序白名单约束。顺带还解决了一个意外问题:小程序端按 UTF-8 解码 GBK 数据会乱码,中文名全丢;云函数里能按 GBK 正确解码,于是「兴业银行」这样的名字终于能正常显示了。
这一步还有个插曲:自动化测试突然红了 11 项,一度怀疑是代码缺陷。三方独立核验后发现,是测试的真值快照过期了——我的 Excel 每天收盘后自动更新,快照没跟上。根治方案是给测试框架加了“保鲜机制”:快照过期自动重生成,并把“数据漂移”和“代码缺陷”分类报告。
六、第四个抉择:备份走云存储还是云数据库
交易记录是真金白银攒出来的数据,卸载小程序、清缓存、换手机,本地数据说没就没。备份方案讨论时有个隐蔽的坑:如果用云存储存文件,那个文件的 ID 只能存在手机本地——换手机连“恢复”的入口都找不到了,等于一个死锁。
最终用云数据库按微信账号自动隔离,换机后登录同一账号直接读回。设计“可恢复”的系统时,别选“资源标识必须先存在本地”的存储——这条教训值得记一辈子。
七、公开上线:把“买入卖出”说成“低位高位”
自用没问题,但要公开上线,微信对金融内容的审核是实打实的严:个人主体拿不到证券业务资质,任何“给出买卖信号”的表述都可能被驳回。
我的选择是双版本:自用版保持直白术语;公开发布版由脚本自动派生,把「买入档」改成「低位档」(描述价格位置而非交易动作),「重仓区」改成「低估值区」,「交易」改成「记录」。四十多条替换规则、残留敏感词扫描归零、两版算法输出逐位一致——审核看界面实质,改词不保证过审,但至少不因措辞先倒下。
这条路还顺手修了几个 bug:两版 appid 分叉(加了锚定期望值的硬校验)、测试框架毫秒级取整口径不一致(恒差 1 毫秒导致一条测试永远红)。最诡异的问题往往来自最不起眼的地方。
八、最后一公里:备案、隐私、等待
真正的上线流程比写代码琐碎:类目选“工具/办公”(个人主体唯一现实解)、简介反复打磨成“个人投资记录工具”的口径、隐私指引只申报真实用到的剪贴板与设备信息、ICP 备案(工信部 2023 年起强制,服务类型绝不能碰金融类,备注写成“个人记录工具,数据仅存本人账号”)。
2026 年 10 月 24 日,审核通过,发布。
九、发布了,但路还没有走完
10 月 24 日审核通过、正式发布,我以为到了终点,其实只是换了一条赛道。
发布不等于立刻能被搜到:微信搜一搜对小程序的收录和排序需要时间沉淀,新上线的小程序要靠名称权重、用户使用行为和搜索优化一点点“养”出来。目前用精确名称搜索,它还排在很靠后的位置,甚至偶尔搜不到——公众号菜单里的跳转入口倒是已经能用了。从“能搜到”到“容易被搜到”,还有一段路要走。
而这条路上最大的限制,来自我的身份:个人主体。个人公众号、个人小程序拿不到金融业务资质,“股息率”“买入档”“卖出信号”这类直白的金融术语,在简介、功能命名和推广描述里都不能敞开了用——这也是前面那套“低位/高位”中性化改造的根本原因。它不体面,但合规地活下去,比说得漂亮重要得多。
尾声
回头看这一个月:一张 Excel 表,经历四轮重大口径争论、三次架构补课、一轮审核合规改造,最终变成微信里搜得到、别人用得上的正式小程序。
我最大的感受是:普通人缺的从来不是想象力,而是把想象力落地的路径。我懂投资、懂这套体系的每一处口径,但放在过去,“自己做个小程序”门槛高到不会开始。而这一次,AI 承担了它擅长的部分——架构、编码、测试、文档、上线策划,把标准拉到了专业团队的水准;我则专注做只有我能做的部分——定义规则、校准数据、把关每一个会影响真金白银的决策。
它不是替我做了产品,是让“我自己做产品”这件事第一次具备了可行性。这一百多个文件、四百多项测试、无数次“你确认过这个口径吗”的追问,最终都收敛进一个能装进口袋的工具里。
这大概就是Ai智能最好的样子:不是让少数人做更炫的东西,而是让普通人也能把脑子里的那个念头,真正造出来。
至于它能不能被更多人搜到、被更多人用——个人主体之下,慢慢走,不着急。能被造出来,已经是这一个月最好的答案。
「卒子日记」· 红利记录本,2026-10-24 上线

