434MB的汇报PPT交给WorkBuddy,我踩了3个坑
- 2026-11-06 23:44:30
前两天,一个朋友来找我。他要修改、补充、润色一份汇报 PPT,着急用。
我看了眼文件:434MB。
一个 PPT,434MB。打开才发现,里面嵌了一段 5 分多钟的航拍视频,321MB,剩下 100 多 MB 是 30 多张没压缩的实拍照片。这个体积,投屏要卡,发微信群基本发不出去。
他手里有三份材料:一份正式的文字稿、一份之前做的新版 PPT、一个装着 23 张现场照片的文件夹。要做的就是把文字稿和新版里的内容整理进原来那份 PPT,数据做上图表,照片排好版,整体大气一点。
这种活儿要是纯手工,一天就搭进去了。这次我没自己动手,全程用的是 WorkBuddy。
结果做下来踩了三个坑,也摸出了几条能复用的路子。
我第一步是让 WorkBuddy 读那份文字稿。
它返回了 200 个字的预览,然后告诉我:读全文的接口取不全,它换别的方法。
后面它是自己写了个脚本,把文档完整解析出来的。这一步我什么都没做,它自己绕过去的。
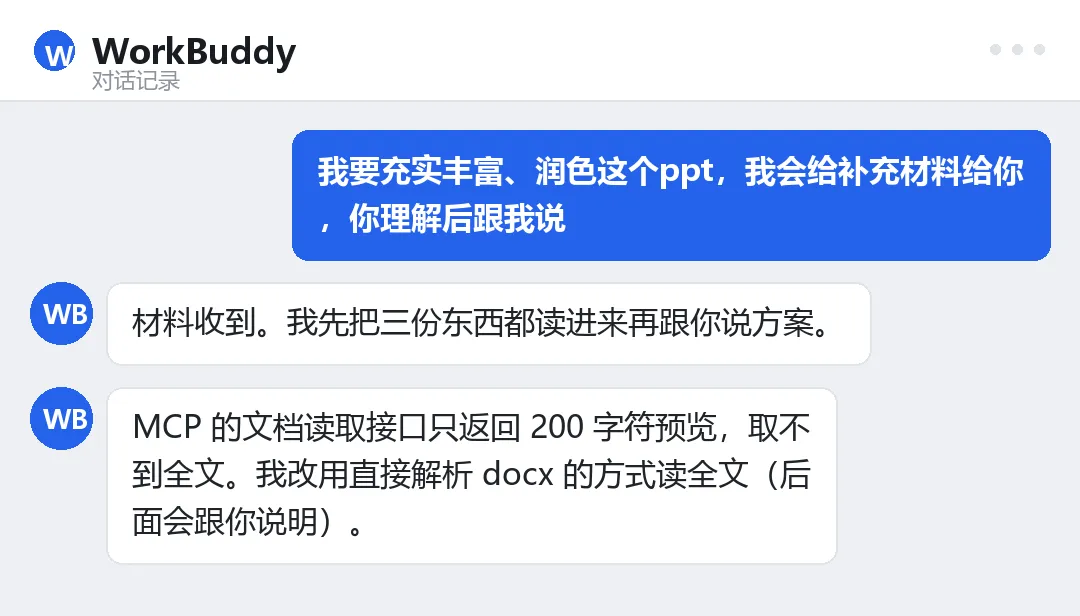
这件事给我提了个醒:WorkBuddy 读文件不是万能的。有些格式、有些工具,它第一次拿到的是残缺内容。
这里有个很简单的判断方法。如果你发现它给你的内容明显不完整,直接说一句「用别的方式把全文读出来」。它能换路子。你要是不说,它可能就拿着那 200 个字往下做了。
这是整个过程里最值钱的一步,也是最容易被忽略的一步。
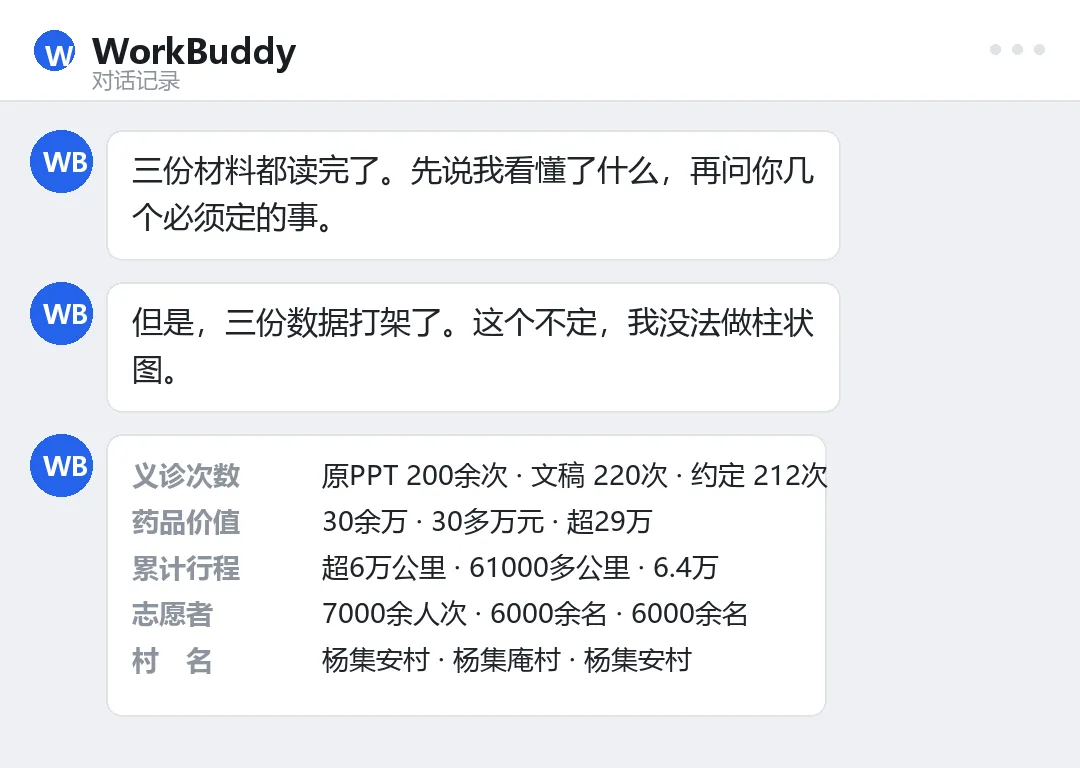
我本来以为三份材料互相补充,拼一起就行了。WorkBuddy 读完告诉我:口径不一致。
同一件事,三份材料里有不同说法。义诊次数、累计行程、志愿者人次、药品价值,甚至村名的写法、荣誉的年份,全都不统一。
你想象一下,这份东西是拿去做项目汇报的。评委翻两页看到数字对不上,整份材料的可信度就打了个折。
三份材料,加起来几十页,要人眼一行行核对我是不敢保证不漏的。WorkBuddy 把三份材料里的数字一次全列出来对照,不一致的地方全都挑了出来。
最后我定了一条规矩:所有数据以正式文字稿为准,其他两处只当素材用。定下这一条,后面所有页面统一口径,不用再来回改。
可复用的动作
做汇报材料之前,先让它把几份材料里的数据列个对照表,你挨个定口径。这半小时比后面改十遍都值。
第一次交付,我拿到的是一份以新版 PPT 为底的东西。
打开才发现不对。
我要的是润色原来那份,不是拿新版重做一份。虽然内容都在,但骨架换了,原本的叙事结构也变了。
返工。
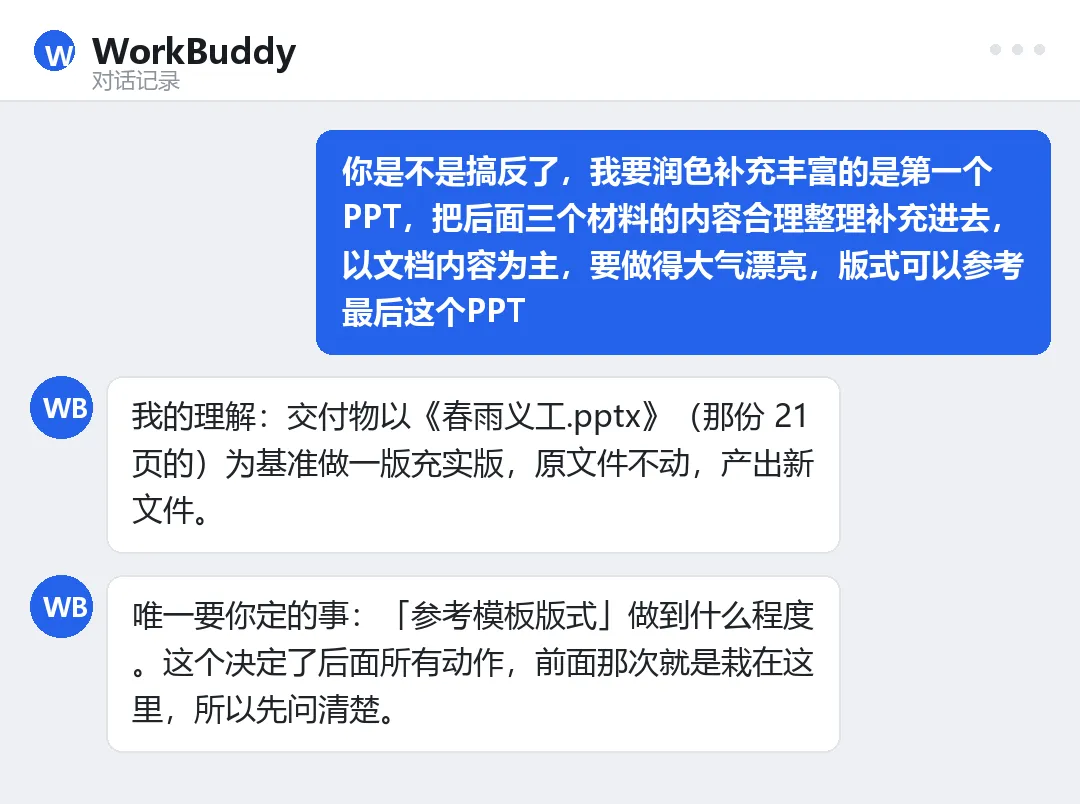
这不是 WorkBuddy 的问题。我说「把第一个丰富起来、参考最后这个 PPT 的版式」,但「丰富」和「重做」这个区别,我没说透。后来把话问明白:保留原来的页面骨架,只套用模板的视觉风格。这一句说清楚,第二次做得就完全对上了。
这一课很贵:用 AI 干活,「方向」这件事必须说死。尤其是「以谁为底」「参考到什么程度」这类话,含糊一句,可能就是白干一遍。
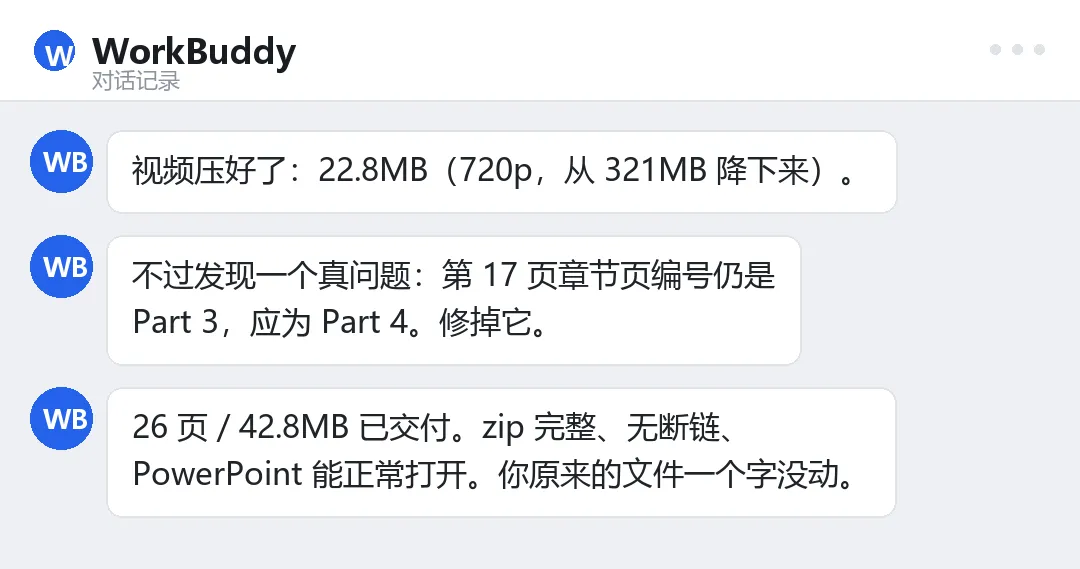
视频瘦身。321MB 压到 22MB,降到 720P。航拍画面压完肉眼基本看不出差别,但整个 PPT 从 434MB 瘦到 42MB,能发群里,也能顺畅投屏了。这一步是 WorkBuddy 自己去调压缩参数跑的,我就说了一句「视频保留,可以压缩」。
照片排版。它先把每张照片按目标区域的形状中心裁切,再放进去,照片不会拉伸变形。30 多张图,尺寸位置都算好,比我手工拖快太多。
一份 26 页的汇报 PPT,42.8MB,含嵌入视频。
原来的文件一个字没动。
交付前它还自己做了一轮检查,发现有个章节页的编号写错了,修掉才给我。
朋友拿到文件的反应就一句话:这要自己弄,得弄到什么时候。
回头看一遍,它实际做的事有这么几类:
读 把 docx 文字稿、两份 PPT、图片文件夹的内容全部提取出来
核 跨三份材料做数据对照,挑出所有不一致的地方
转 压缩视频、按比例裁切照片
改 调整 PPT 页面结构,填文字、放图片、做数据图
查 交付前自己跑一遍完整性校验
我要负责的其实只有一件事:把方向说清楚。
这活儿纯手工,我估计要干一整天,还不一定做得比现在好。但要说它能全自动搞定,那也不是。整个过程卡了三次,两次都卡在「我到底要什么」上,没有一次卡在技术上。
我现在的用法是这样:把「要什么、以什么为准、参考到什么程度」一次说清楚,然后让它自己找方法去做。剩下的它会自己想办法,包括读不到文件的时候。
你平时做汇报或者总结材料,最花时间的是哪一步?
找素材、核对数据,还是排版?留言说说,我挑几个典型的场景,下次拆给你看。

