你的AI猫咪视频,为什么像PPT?这5步,把萌图拍成故事
- 2026-11-10 08:15:06
你有没有遇到过这种情况?
猫生成得很可爱,围巾也很漂亮。加上音乐,拼成视频,自己看着挺满意。可再看一遍:它坐着、走着、眨眼,然后……就结束了。
画面很多,事情却没发生。
还有一种更难受:第一镜是橘猫,第二镜换了脸,第三镜围巾消失。你越补提示词,视频越像几只猫轮流上班。
我建议先停下生成。不急着换模型,先把目标改成:用30秒,讲清一个让人想看完的小故事。
下面这5步,就用“橘猫偷走蛋糕,原来在给小灰猫过生日”来演示。
01 别先写提示词,先写一句“发生了什么”
“一只可爱的猫在客厅”是场景,不是故事。
我会先填三个空:它想做什么?遇到什么误会?最后发现什么?
这个案例就是:橘猫偷偷准备生日惊喜,因为嘴边有奶油,被误会偷吃;最后,纸箱里的小灰猫戴着生日帽出现。
注意,我没有安排追车、打架、穿越。第一条练习片,只用一个客厅、一个主要角色、一处反转;小灰猫留到结尾亮相。
把这段直接发给对话模型:
验收只有一句:不用解释,别人能不能说出这条片发生了什么?
02 先定演员,别让每个镜头重新“招猫”
脚本通过后,我才做角色参考图。
先锁住阿橘:橘色条纹、琥珀眼睛、奶油色口鼻、砖红三角围巾。性格是嘴硬心软,不是每镜随机切换。
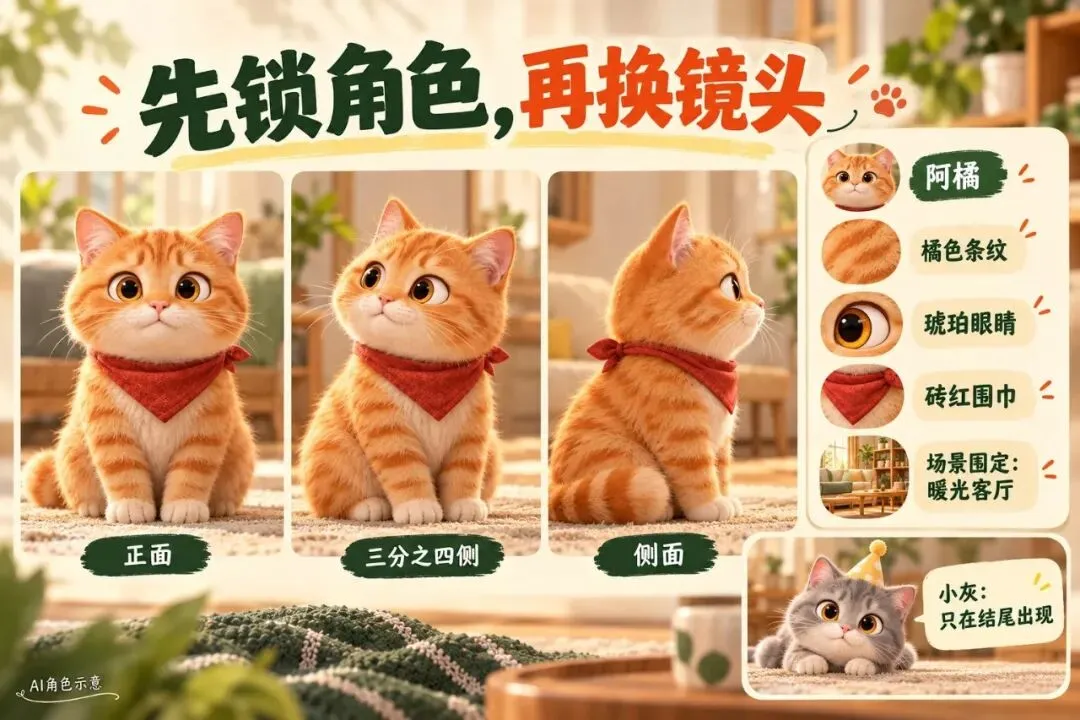
在支持参考图的生图工具里,先保存一张清晰角色图;后续分镜沿用它,不要只复制同一句文字描述。
场景也固定:暖光客厅、矮木桌、同一个纸箱、同一只白盘子。小灰猫单独存角色图,生日帽颜色不变。
每次换镜头,只修改景别、姿态和位置。换的是镜头,不是演员。
并排检查两张图:眼睛、条纹、围巾是否一致?如果不一致,先修静帧,别急着让错误动起来。
03 分镜不是凑6张图,是给观众6次“下一步”
我会把30秒拆成这条线:
0—3秒:白盘子空了,蛋糕去哪了? 3—8秒:阿橘嘴边有奶油,眼神往纸箱飘。 8—13秒:纸箱旁露出蛋糕,角落露一点生日帽。 13—18秒:阿橘盯着箱内,它究竟在藏什么? 18—25秒:小灰猫戴着生日帽出现,误会解开。 25—30秒:两只猫围着蛋糕,落在温暖的收尾。
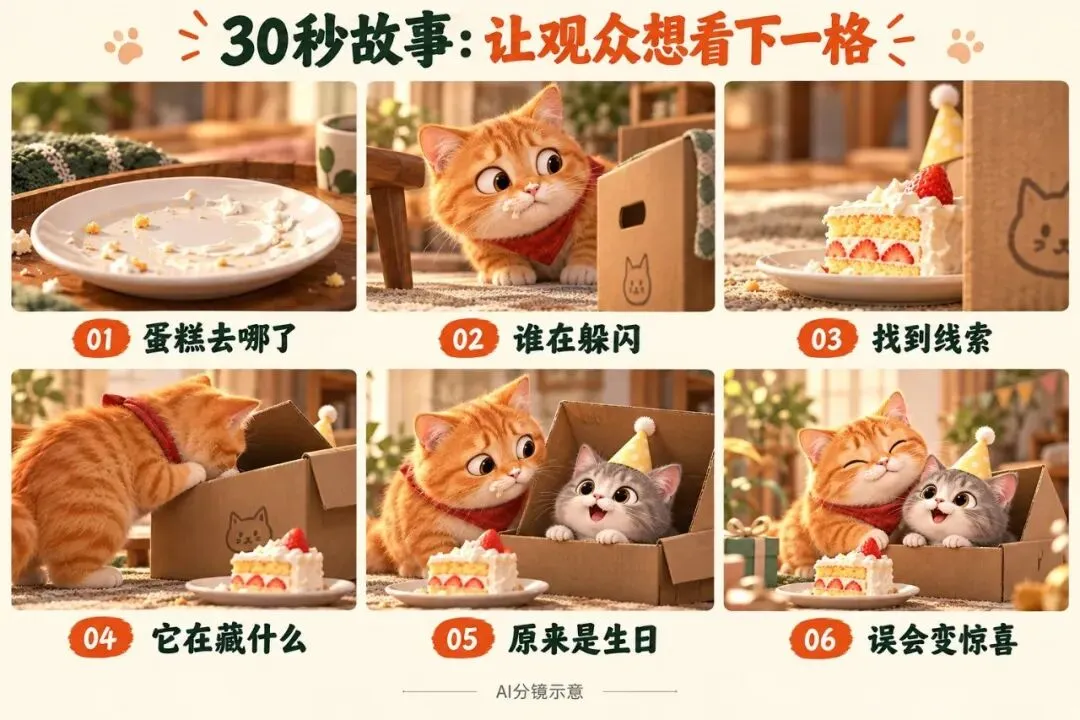
生日帽要提前露一点。否则结尾突然宣布“过生日”,反转就容易变成硬编。
镜头也别全是正面全景:空盘用特写,阿橘的心虚用近景,结尾才拉开看关系。
每镜只承担一个信息。看完这一格,观众知道了什么,又想确认什么?答不上来,就合并或删掉。
这些秒数是剪辑目标,不是模型必须一次生成的时长;生成后按内容裁切。
04 让猫动起来之前,先把动作缩小
最容易踩的坑,是一句话塞满“跑过来、拿蛋糕、转身、开箱、跳进去”。
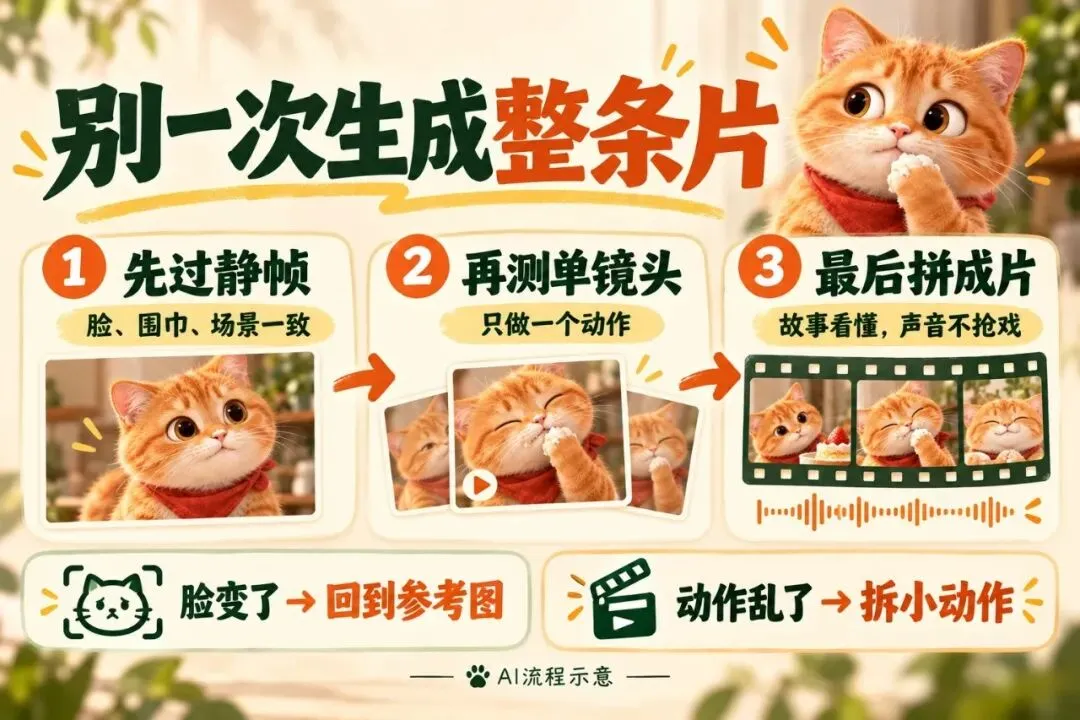
我会先上传通过检查的静帧到图生视频工具,只测试一个简单动作。比如阿橘看向纸箱这一镜:
图生视频里,参考图负责起始构图和外观,文字重点描述动作、镜头与变化。这也是官方图生视频指南的基本思路。
先看这一个镜头:脸有没有漂?围巾有没有变?动作能否看懂?
脸不对,回到参考图;动作乱,减少动作;画面无故切换,先检查指令是否混入多个场景。
不要拿一整条片试错。先跑通一镜,再做剩下的。
05 剪辑时,删掉“很好看但没用”的画面
最后打开剪辑工具,按镜头编号导入素材,而不是按生成时间乱排。
空盘、心虚、线索、揭晓,这四个信息点先接顺。长时间走路、重复眨眼,再好看也先删。
声音分三层:一句短旁白交代疑问,轻音效点出奶油和纸箱,背景音乐铺情绪。不要三层一起抢注意力。
不会做口型,就先用旁白版;人物没有开口,却配上一大段对白,反而容易出戏。音乐与配音素材先确认使用权限。
导出前,我会做两遍检查:静音看,故事能不能懂?只听声音,旁白是否清楚、音乐是否压人?
再检查画幅统一、字幕不挡猫脸、结尾有明确回应。完整,不等于把素材全塞进去。
今天就做一镜,别先规划50集
你现在可以先写一句故事,做阿橘的参考图,再生成“它看向纸箱”的测试镜头。
这三样通过,再把6镜接成30秒练习片。它不保证爆款,但能让你知道问题究竟出在故事、角色,还是动作。
我更看重的不是“AI一键出片”,而是:每一步有产出,每一步能验收,出错知道回哪一步。
本期的全套实操SOP,公众号后台回复 「猫咪动画」,即可领取。

