【开源】8.8K Star:改 PPT 不必整页重生成
- 2026-11-10 22:21:17
【开源】8.8K Star:改 PPT 不必整页重生成
同事甩来一份 20 页的汇报 PPT,说「顺手改一下」。
第 7 页那条增长曲线,年份该从 2024 换成 2025;第 12 页三条风险,第二条要重写。加起来不到 40 个字。
但在 AI 生成 PPT 的工具里,这个动作通常只有两种下场:整页重新生成,曲线、配色、版式全换一批新的,改一处崩三处;或者干脆放弃,把 HTML 截图贴进 PowerPoint 手工挪。
生成很快,改起来很慢 —— 这才是 AI 做 PPT 真正的墙。
生成不是瓶颈,「改」才是
过去两年,AI 做 PPT 的竞争全压在生成侧:谁的模板多、谁的动效炫、谁一句话能出 30 页。
可真正把 PPT 交出去的人都知道,PPT 从来不是一次成型的产物。它要过领导第一轮、客户第二轮、老板随手一改的第三轮。一份 20 页的材料,从初稿到定稿,改动量往往比初稿本身还大。
所以评价一个 AI PPT 工具,不该只看它出得多快,而要看它出完之后,你还改不改得动。
GitHub 上有个项目把这件事当成了第一性问题。它叫 Dashi PPT Skill,自述是一套「适合职场人的 PPT Skill」,目前 8,853 Star / 798 Fork,采用 AGPL-3.0 协议,主力语言 JavaScript,仓库 2026 年 6 月建立,Skill 当前版本 0.4.14(数据来自 GitHub API 与仓库 README)。
它最反常识的一点藏在 README 的一句小字里:
生成之后如何编辑,比生成本身更重要
一、同一页,它会同时给你 4 个方案
第一次用它生成,预览页打开会有点意外:你说了 10 页,它给你看的是 40 页。
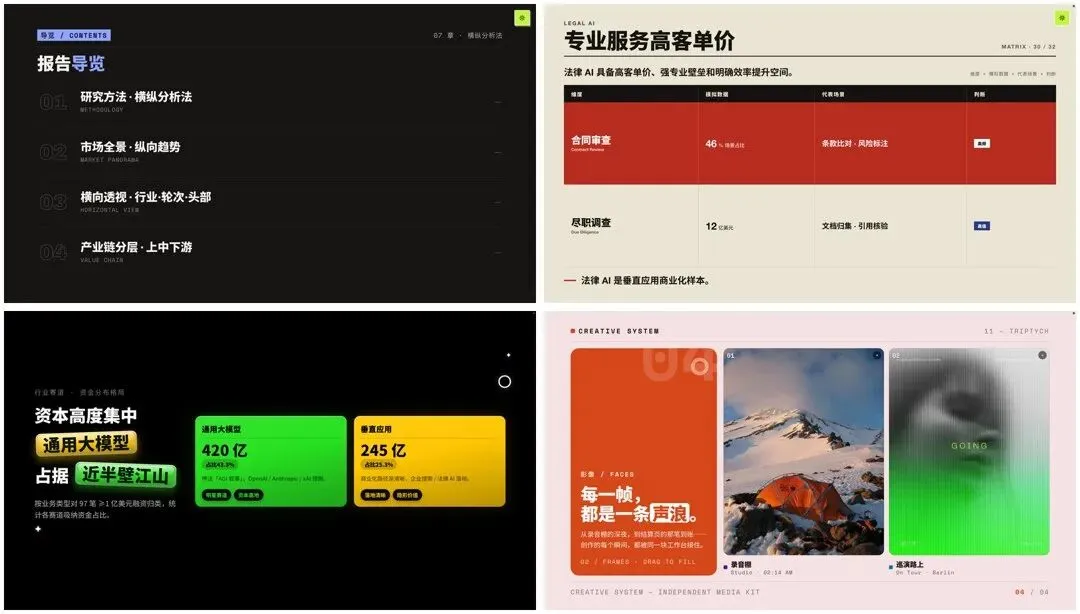
据 SKILL.md,这个 Skill 为每一个逻辑页生成 3 个模板方案 + 1 个 Agent 定制方案:前三个是同一份内容套进三张结构完全不同的版式,第四个是 Agent 在主题视觉语言内自己排的一页。
选页也不是随手挑。它用带随机种子的查询来挑候选版式——
npm --prefix <skill-root>/project run layout:query \ -- --theme theme03 --role radar --limit 8\ --seed ai-report-20260927-a7k:slide-3
注意那个 --seed,格式是 主题-日期-随机词:slide-N。SKILL.md 写得很明确:相同 seed 和相同输入必须稳定复现。
这一条看着枯燥,实际解决的是 AI 生成最常见的抱怨——「昨天那版挺好看,今天找不回来了」。它把随机性关进了种子,让「碰运气出的好版式」变成可复现的资产。
而前三个模板方案走的是另一条路,叫锁模板填文案:保留所选页面的原始视觉、结构、模块数量、显隐、强调、配色、图表类型和图片槽位,只替换可见文字。
换句话说,那 3 个方案的作用不是「给你挑好看的」,而是给你一个锚点——版式是定死的,换的只是字。
二、1020 个版式,却只留了 11 个自由文本框
把仓库里的 layout-manifest.json 拉下来一算,规模是实打实的:
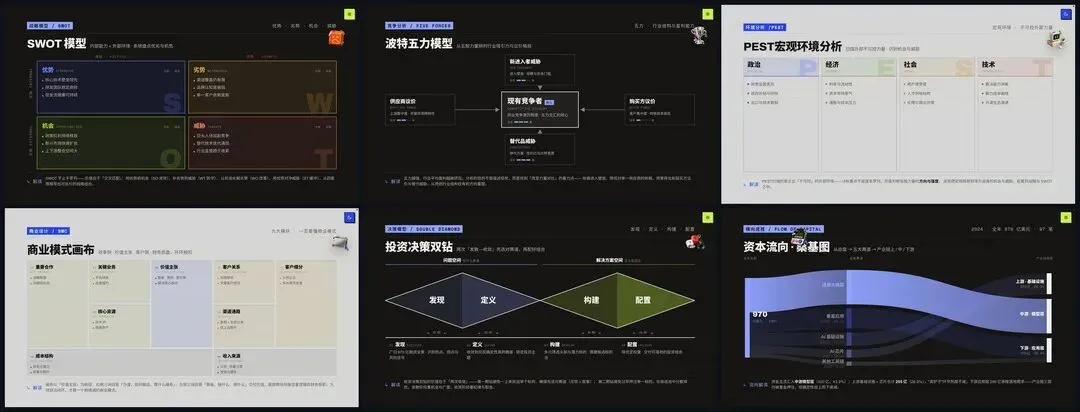
- 1020 个版式
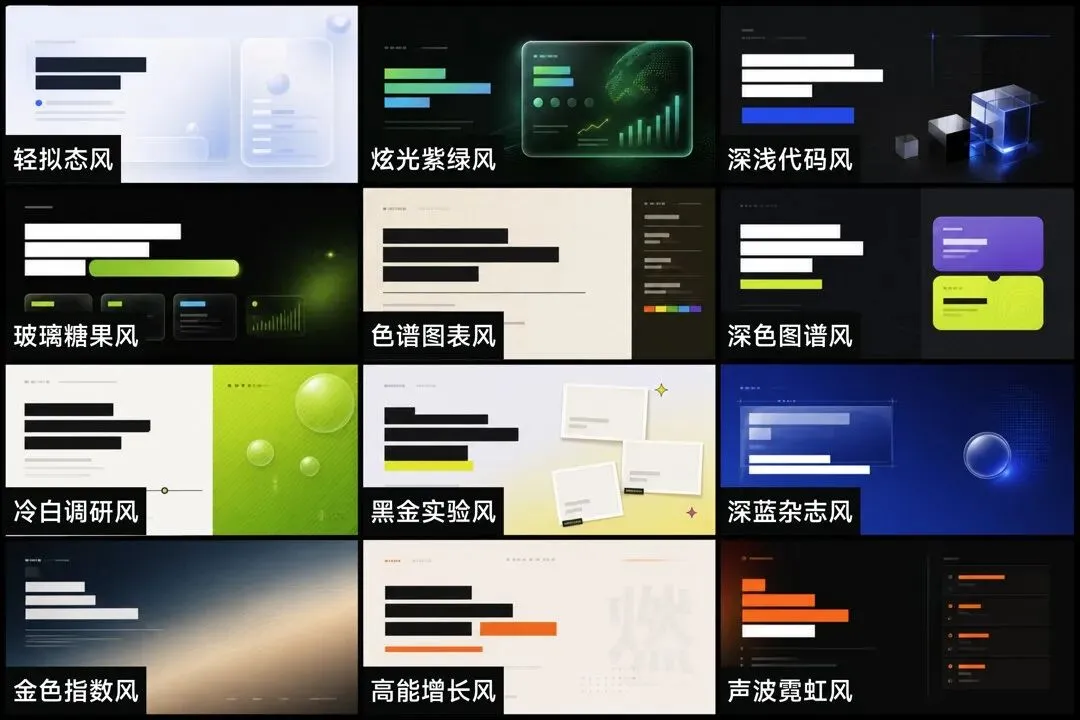
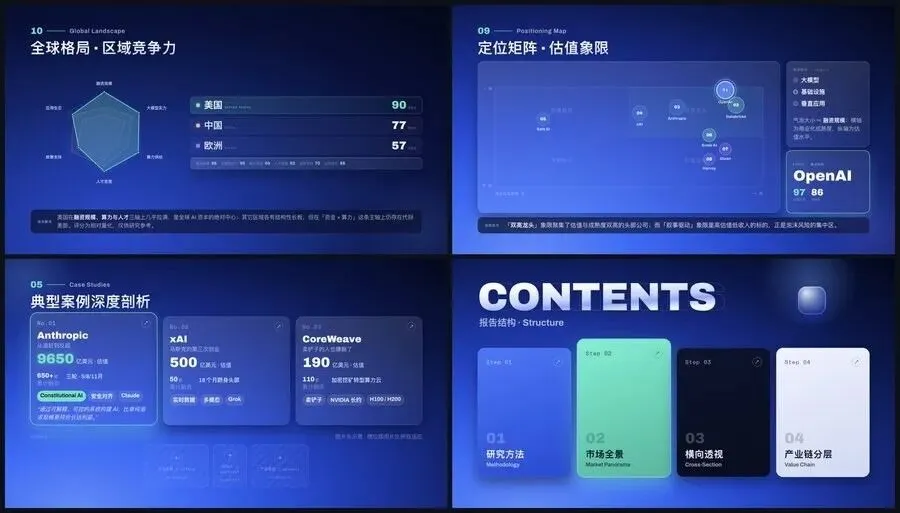
,分属 12 套主题。最多的 theme09 深蓝杂志风有 111 个,最少的 theme07 冷白调研风有 71 个。 - 8576 个可调控件
,与 README 宣称的数字完全一致。拆开看:开关类 4276 个、滑杆类 2372 个、下拉类 1825 个、图标类 77 个、图片类 26 个。 版式槽位覆盖雷达图、瀑布图、矩形树图、漏斗、热力图、桑基图、象限图、排名、时间线等,还有 SWOT、波特五力、PEST 这类分析模型版式。
有意思的不是 8576 这个大数字,而是它的结构。
这 8576 个控件里,出现频率最高的是 focusIndex(605 次)、focusEnabled(439 次),后面跟着 accent、showDecor、showCaption、chartType、imageCount 之类。
翻译成人话:你能调的是「哪一项是重点」「这个装饰显不显示」「图表换成哪种」「图片放几张」,而不是像素级自由排版。
更狠的一个数字是:1020 个版式加起来,一共只有 11 个自由文本字段。
这不是遗漏,是选择。README 里对「能不能自定义 xxx」的官方回答是:
当前自定义样式仅限于特定范围。这是有意为之:稳定的产出比自由的选色更重要。
这句话值得抄下来。绝大多数 AI 工具遇到「我要自定义」,本能反应是把所有参数都敞开;而它反过来承认:开放度越高,稳定的产出越难保证。于是把自由度压在「结构可调」这一层,视觉语言交给主题管。
三、内容不上传,导出只对本机开放
技术团队用 AI 做汇报材料,绕不开一个保密问题:把公司经营数据丢进在线生成器,等于把材料交出去。
据 README 的 FAQ,这个项目的边界画得比较清楚:内容层面零上传——你的文档和 PPT 内容不会发送到任何服务器,生成、编辑、导出都在本机完成,成品离线可打开。
它诚实列出了仅有的两处联网行为:首次生成时 npm 自动安装依赖;完成任务后的静默版本检查,而且只拉最新版本号,不上传任何内容。
还有一个容易被忽略的细节:本地预览服务默认在同一局域网内可访问,但导出接口只对本机开放。也就是说,同网段的人可能看见你的预览页面,但拿不走导出的 PPTX。
这种「把例外一条条列出来」的写法,比笼统的「数据安全」四个字有用得多。
它也有开源协议上的例外。项目主体是 AGPL-3.0(README 称这是 OSI 认证协议里 copyleft 效力最强的一个),但子包 project/packages/html-deck-to-pptx(导出引擎)是专有组件,只能作为本 Skill 的组成部分使用,不得单独提取或再分发。README 同时说明:该目录 v0.2.7 及之前的历史版本曾以 MIT 发布,该授权仅对历史版本有效。
商用之前,这两行值得先读一遍。
它是怎么做到「改得动」的:版式与文案分家
所有关于「可编辑」的承诺,最后都要落到数据结构上。这个项目的做法是把一页 PPT 拆成两层:版式(结构)+ 文案(内容)。
按 SKILL.md 的说明,标准流程是先写一份逐页的内容包,再交给脚手架生成 goal.json:
{ "pages": [{ "id": "page-1", "presentation": { "pageIntent": "cover", "title": {"full": "完整标题", "short": "短标题"}, "summary": {"full": "完整摘要", "short": "短摘要"} } }] }
关键在 schema v2 的设计约束:业务内容只写一次,写进内容包;goal.json 里每页只保存「结构目标 + source binding」,不持久化重写文案、指标、列表、图表和 media 值。
SKILL.md 用一句话定义了这条规矩:
slide.content.presentation是唯一业务事实源
于是模板在运行时按 contentMap + projection.structure 即时生成属性。改一句文案,4 个方案一起更新,不会出现「改了 A 版,B 版还是旧字」的错位。
为了让这套结构不散架,还配了几处硬约束:
contentLocked: true的版式,正文由组件固定、props 填不进去,只能换一页能填正文的布局; HTML 字段只允许 <br>换行加<b>/<em>强调,禁止自由 HTML,validate:goal-spec会直接拦截;新生成的 deck 禁止复用旧目录里的 goal.json或旧 HTML;渲染后必须过三关校验: validate:goal-spec、validate:swiss、validate:goal-copy。
还有一条很实在的防坑条款:如果输出正文里出现 AI Capital、SoundWave、Key Metrics、Roadmap、End of Report 这类与用户主题无关的模板默认文案,必须重写 JSON 重新渲染,不能交付。
这条能写进文档,说明作者踩过——模板演示文案泄漏进成品,是这类工具最尴尬的故障。
上手:三条命令
环境要求不高:Node.js 20+ 和 npm;导出 PPTX / PDF 需要本机装有 Chrome / Chromium / Edge,可用 CHROME_PATH 指定。
一键安装(国内网络建议走镜像):
npx dashi-ppt-skill@latestnpx --registry=https://registry.npmmirror.com \ dashi-ppt-skill@latest
装完直接把文档丢给 Agent,说一句「用 dashi-ppt 做 PPT」,它会先问两件事:主题风格(12 套预览图),以及是否需要图片/视频。这两个问题它不会替你决定。
选定后生成 goal.json,再渲染:
<skill-root>/scripts/render_goal_deck.sh \ output/client-review/goal.json \ output/client-review/ppt/index.html
Windows 上用 PowerShell 版脚本(render_goal_deck.ps1),SKILL.md 特别说明不要经 WSL/bash。
渲染完脚本会起一个本地预览服务,给你 http://127.0.0.1:<port>/。这里的坑要注意:只有通过这个预览服务打开,编辑才能自动保存,也才能导出可编辑 PPTX。用 file:// 直接打开本地 HTML 是不自动保存的,也不能导出。
想指定端口,先设 DASHI_PPT_PREVIEW_PORT,端口用 5200–5999 段,4178 / 4300 / 4400 是保留端口不可用。
不想开浏览器也行,命令行直接导出:
npm --prefix <项目目录> run export:pptx \ -- <PPT输出目录>/ppt 输出.pptx
三个容易踩的坑
一是分不清 HTML 和 PPTX。 这个 Skill 默认交付 HTML,只有你明确说「PPTX」「可编辑 PPTX」「PPT 格式的文件」时才会导出 PPTX 文件。想要原生格式,得把话说清楚。
二是 token 消耗要有心理预期。 README 的 FAQ 给了实测值:一套 10 页 PPT 约 10 万 token,随文档长度和往返修改次数浮动;按 Codex 5 小时额度窗口粗算,大约够生成 10 套。这不是「随手玩玩」的量级,重要材料再上。
三是别把它当万能排版器。 README 自己划了界线——它适合行业研究、融资复盘、竞品分析、趋势报告、项目汇报这类需要快速形成结构完整、视觉统一、还能继续改的材料;不适合需要逐像素手工定制视觉的场景。
最后
回到开头那份 20 页的汇报。真正卡住人的从来不是第 1 页怎么生成,而是第 7 页改一个年份、第 12 页重写一条风险时,你会不会被迫把整页重来一遍。
Dashi PPT Skill 给的是一个很克制的答案:把版式锁死、把文案抽出来,用 1020 个版式和 8576 个控件换一个「改得动」,同时坦率地告诉你哪些自由度它不给。
如果你也经历过「生成 30 秒、改稿 3 小时」,可以去看看它的 layout-manifest.json——那份文件本身就是一堂关于「AI 产物该怎么设计编辑边界」的课。
Star 地址:https://github.com/chuspeeism/dashi-ppt-skill

