第376讲:Python和Excel VBA两种技术路线数据清洗:手机、邮箱、公司名、日期标准化
- 2026-09-23 02:39:31
在日常的CRM(客户关系管理)或ATS(申请人追踪系统)运营中,从系统导出客户或候选人数据几乎是每个运营、销售或HR每周都要面对的工作。
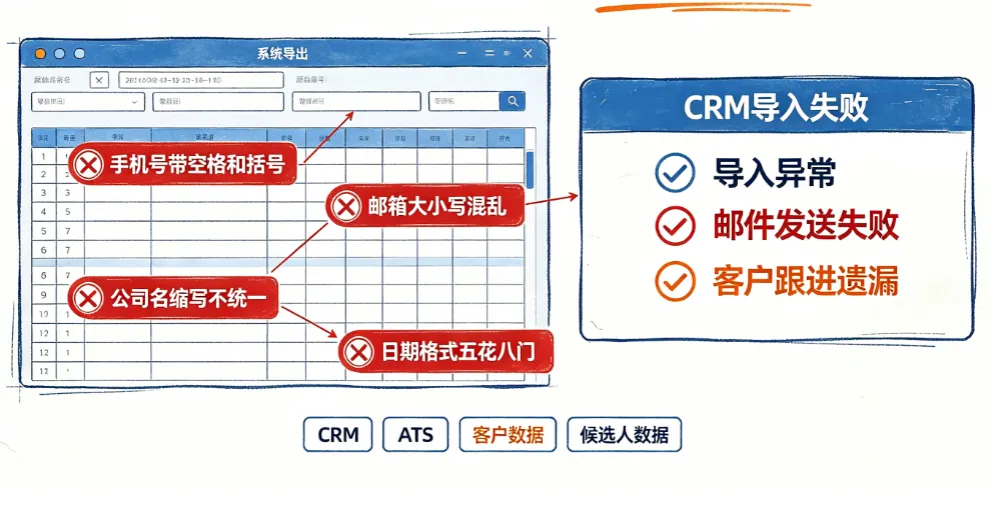
然而,导出的原始数据往往令人头疼:手机号里夹杂着空格和括号、邮箱地址大小写混乱、公司名称缩写不统一、日期格式五花八门(比如“2023/12/1”、“01-Dec-23”、“2023年12月1日”混在同一列)。这些“脏数据”如果直接导入CRM,不仅影响数据分析的准确性,还可能导致邮件发送失败、客户跟进遗漏等严重问题。
今天,我们就以“数据清洗:手机、邮箱、公司名、日期标准化”为主题,通过Python和Excel VBA两种技术路线,手把手教你如何将这些杂乱的数据标准化,输出可直接导入CRM的干净表格。文章不仅会给出具体的实现代码,还会深入对比两种方案的优劣,并在文末附上5道选择题帮你巩固知识点。
一、痛点拆解:四类字段的清洗规则
在开始写代码之前,我们需要明确每一类字段的标准化目标。
1. 手机号清洗
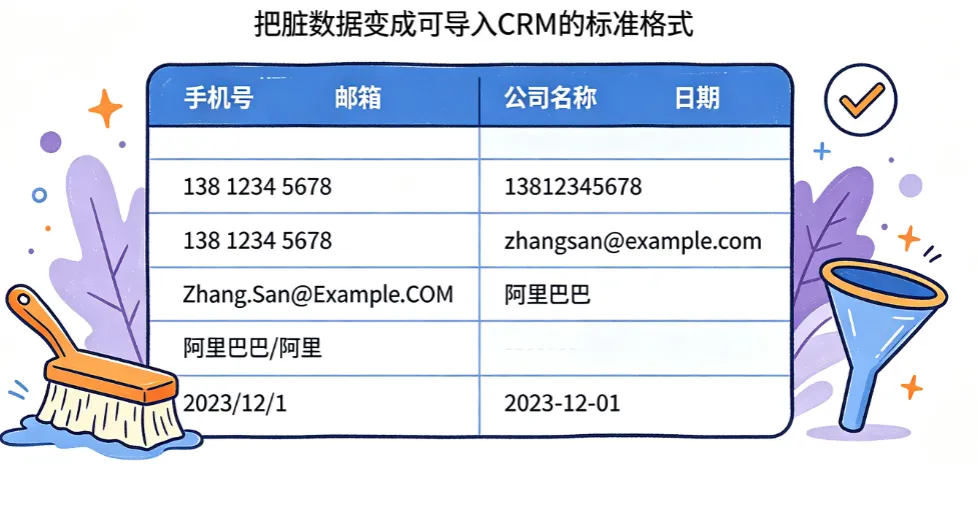
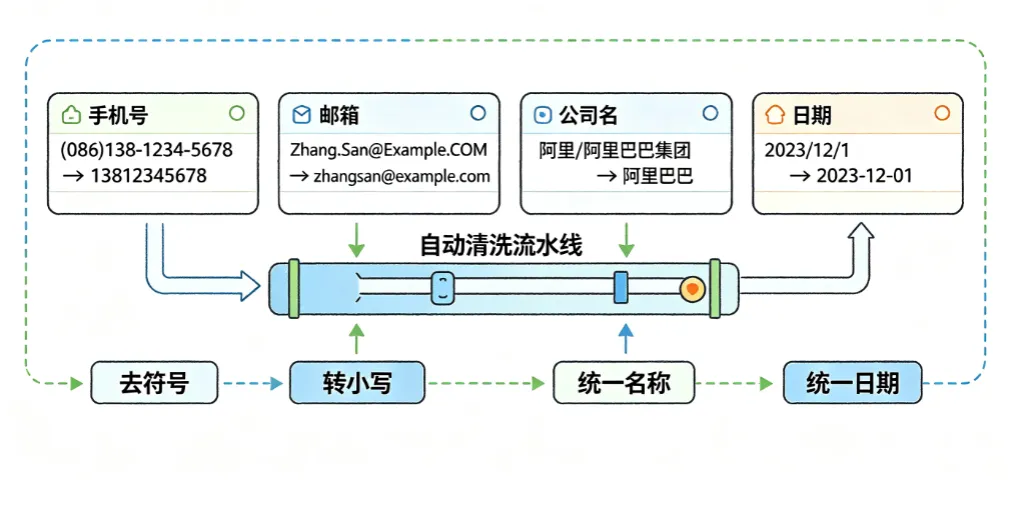
常见脏数据:138 1234 5678、(086)138-1234-5678、+86 13812345678、138****5678(脱敏)。
标准化目标:统一为纯数字字符串,如13812345678;或根据业务需求,统一为带国际区号的格式+8613812345678。
规则:去除所有非数字字符(除开头的“+”号外),然后根据长度判断是否添加国家码。
2. 邮箱清洗
常见脏数据:Zhang.San@Example.COM、lisi@company.com(前后空格)、wangwu@company..com(多余点号)。
标准化目标:全部转为小写,去除首尾空格,修正明显的输入错误(如连续点号)。
规则:strip()+ lower()+ 正则替换多余符号。
3. 公司名清洗
常见脏数据:阿里巴巴、阿里巴吧(错别字)、Tencent与腾讯并存、XX公司与XX有限责任公司混用。
标准化目标:去除前后空格,统一使用规范全称或常用简称,修正明显错别字。
规则:建立映射字典(如{"腾讯": "Tencent", "阿里巴吧": "阿里巴巴"}),利用模糊匹配或精确替换。
4. 日期标准化
常见脏数据:2023/12/1、01-Dec-23、2023年12月1日、20231201。
标准化目标:统一转为YYYY-MM-DD格式(如2023-12-01),并转换为真正的日期类型,方便后续排序和计算。
规则:利用日期解析函数,处理多种格式,无法解析的标记为缺失值。
二、Python实现:pandas + regex 批量清洗
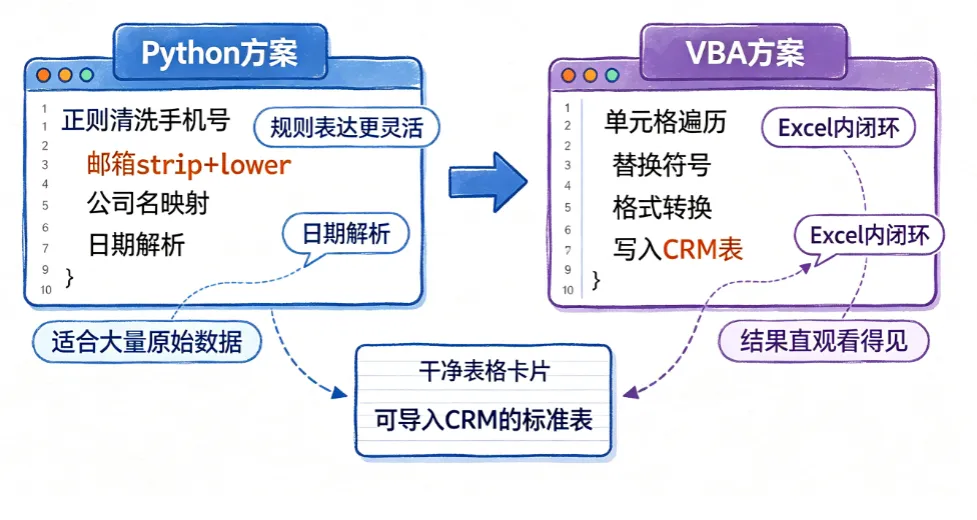
Python在数据处理上的优势是批量、自动化和可复现。我们主要使用pandas进行表格操作,re模块处理正则,apply或向量化方法进行批量转换。
1. 手机号清洗函数
import redef clean_phone(phone):if pd.isna(phone):return Nonephone = str(phone)# 保留开头的+号,其余只留数字plus_prefix = '+' if phone.startswith('+') else ''digits = re.sub(r'\D', '', phone)# 如果原号码没有+但长度是11位且以1开头,假设是中国手机if not plus_prefix and len(digits) == 11 and digits.startswith('1'):return digits# 如果有+86,去除+86后保留11位if plus_prefix and digits.startswith('86') and len(digits) > 2:digits = digits[2:]return plus_prefix + digits if plus_prefix else digits
讲解:re.sub(r'\D', '', phone)是核心,它移除了所有非数字字符。\D在正则中表示“非数字”。我们单独处理了“+”号,避免国际号码被误伤。
2. 邮箱清洗函数
def clean_email(email):
    if pd.isna(email):
        return None
    email = str(email).strip().lower()
    # 替换连续的点为单个点
    email = re.sub(r'\.{2,}', '.', email)
    # 简单验证格式
    if re.match(r'^[^@]+@[^@]+\.[^@]+$', email):
        return email
    return None  # 无效邮箱返回空
3. 公司名清洗:映射表 + 模糊匹配
精确替换适合已知错误,对于未知变体,可以使用fuzzywuzzy库进行模糊匹配(需安装)。这里展示基础映射:
company_map = {'阿里巴吧': '阿里巴巴','腾讯科技': '腾讯','tencent': '腾讯'}def clean_company(name):if pd.isna(name):return Nonename = str(name).strip()return company_map.get(name, name) # 找不到则返回原值
4. 日期标准化:pd.to_datetime 的威力
def clean_date(date_str):if pd.isna(date_str):return Nonetry:# dayfirst=False 避免将01/02/2023解析为2月1日return pd.to_datetime(date_str, errors='raise', dayfirst=False).strftime('%Y-%m-%d')except:return None # 解析失败返回空
pd.to_datetime非常强大,能自动识别多种格式。设置errors='raise'可以捕获异常,避免程序中断。
5. 批量清洗完整流程
import pandas as pd# 读取脏数据df = pd.read_excel('dirty_data.xlsx')# 应用清洗函数df['clean_phone'] = df['phone'].apply(clean_phone)df['clean_email'] = df['email'].apply(clean_email)df['clean_company'] = df['company'].apply(clean_company)df['clean_date'] = df['date'].apply(clean_date)# 生成脏数据报告:哪些行有缺失dirty_report = df[df.isnull().any(axis=1)]print(f"发现 {len(dirty_report)} 行存在清洗失败或缺失值")# 输出干净数据df.to_excel('clean_data.xlsx', index=False)
干货提示:在生产环境中,建议将清洗规则(如公司名映射表)存储在外部Excel或数据库中,方便业务人员维护,而不需要修改代码。
三、VBA实现:RegExp + 自定义函数在Excel内清洗
如果你的数据量不大(几千行以内),或者团队没有Python环境,使用Excel VBA是一个“轻量级”选择。你可以直接在表格里加一个【清洗】按钮,点击即完成。
1. 启用正则支持
VBA中使用正则需要先引用Microsoft VBScript Regular Expressions 5.5(在VBA编辑器中点“工具”->“引用”勾选),或者使用晚期绑定。下面我们用晚期绑定,避免引用问题。
2. 手机号清洗函数
Function CleanPhone(phone As String) As StringDim reg As ObjectSet reg = CreateObject("VBScript.RegExp")reg.Pattern = "[^\d+]"reg.Global = True' 先提取所有数字和开头的+Dim digits As Stringdigits = reg.Replace(phone, "")' 简单处理:如果11位且以1开头,直接返回If Len(digits) = 11 And Left(digits, 1) = "1" ThenCleanPhone = digitsElseCleanPhone = digits ' 可根据需要扩展End IfEnd Function
3. 邮箱清洗函数
Function CleanEmail(email As String) As StringIf IsNull(email) Or email = "" Then Exit FunctionDim reg As ObjectSet reg = CreateObject("VBScript.RegExp")' 去除首尾空格并小写CleanEmail = LCase(Trim(email))' 替换连续点为单点reg.Pattern = "\.{2,}"reg.Global = TrueCleanEmail = reg.Replace(CleanEmail, ".")End Function
4. 公司名清洗与日期处理
公司名清洗同样可以用Select Case或字典,这里略。日期方面,VBA的CDate函数可以转换一些常见格式,但容错性较差。更稳健的做法是分列解析:
FunctionCleanDateVBA(dateStr As String)AsDateOn Error Resume NextCleanDateVBA = CDate(dateStr)If Err.Number <> 0 ThenCleanDateVBA =#1/1/1900# ' 错误日期用默认值,或返回空End IfOn Error GoTo 0End Function
5. 在Excel中批量运行
你可以写一个简单的子过程,遍历选中区域并调用上述函数,将结果输出到相邻列。然后插入一个按钮,将宏指定给该按钮,实现“一键清洗”。
四、Python vs VBA:对照与选型建议
维度 | Python (pandas) | VBA (RegExp) |
|---|---|---|
批量处理 | 轻松处理百万行,向量化速度快 | 万行以上可能卡顿,循环较慢 |
正则能力 | 功能完整,支持复杂模式 | 功能足够,但语法稍显陈旧 |
日期解析 |
|
|
可维护性 | 代码即文档,规则易版本控制 | 代码藏在文件内,分享需启用宏 |
适用场景 | 数据量大、需自动化流水线、复杂清洗 | 数据量小、需与Excel深度交互、临时清洗 |
结论:如果你需要定期处理大量数据,或者清洗规则复杂,Python是更好的选择;如果你只是偶尔在Excel里处理几千行数据,且希望业务人员能自己点击按钮完成,VBA更合适。
五、交付物清单
一个完整的数据清洗项目,交付物不应只是“干净数据”,还应包括:
清洗规则表:记录每条字段的清洗逻辑、正则表达式、映射关系。
脏数据报告:列出清洗失败或存在缺失值的原始记录,方便人工核查。
干净数据:标准化后的表格,可直接导入CRM。
六、选择题(答案见文末)
在Python中,使用
re.sub(r'\D', '', '+86-13812345678')会得到什么结果?A.
+8613812345678B.
8613812345678C.
13812345678D. 报错
关于
pd.to_datetime函数,下列说法错误的是?A. 可以自动解析多种日期格式
B. 参数
errors='coerce'会将无法解析的日期转为NaTC. 它只能解析
YYYY-MM-DD格式D. 返回的是
Timestamp对象或NaT在VBA中,使用正则表达式去除字符串中所有非数字字符,正确的Pattern是?
A.
\dB.
[^0-9]C.
\DD.
[0-9]邮箱标准化时,通常不需要进行的操作是?
A. 转为小写
B. 去除首尾空格
C. 验证格式合法性
D. 将域名部分转为大写
对于公司名称“阿里巴吧”,最合适的清洗方法是?
A. 使用模糊匹配或映射表替换为“阿里巴巴”
B. 直接删除该行数据
C. 保留原样,因为不影响分析
D. 使用
pd.to_datetime解析
答案:
B (
\D匹配非数字,+和-被移除,但开头的+也被移除了,因为\D包括+)C (
pd.to_datetime支持多种格式,并非只能解析一种)B (
[^0-9]表示非数字字符,VBA的RegExp中\d和\D也可用,但B是明确写法)D (域名部分应小写,转为大写不符合规范)
A

