我拆了两个 AI PPT 开源项目,终于看懂了 AI 到底是怎么做 PPT 的
- 2026-09-18 11:30:34
我拆了两个 AI PPT 开源项目,终于看懂了 AI 到底是怎么做 PPT 的
从 PPT Master 到 Guizang PPT Skill:两条完全不同的 AI PPT 技术路线
这段时间我一直在想一个问题:
AI 到底是怎么生成 PPT 的?
这个问题看起来很简单。
把一篇文章丢给大模型,让它总结一下,分成十页,然后调一个 PPT 库,把标题、正文、图片塞进去,不就完了吗?
我一开始也是这么想的。
直到我连续拆了两个很有意思的开源项目。
一个是 ppt-master。
另一个是 guizang-ppt-skill。
有意思的地方在于,它们做的事情表面上几乎一样:
给 AI 一段内容,让它生成一套漂亮的演示文稿。
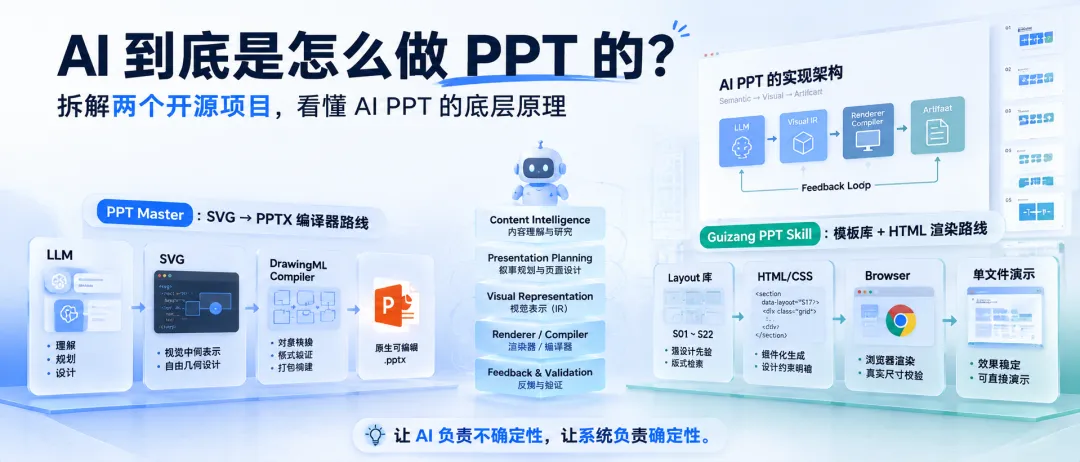
但我真正把源码、Prompt、Workflow 和最终生成链路追下去之后,发现它们走的是两条几乎完全不同的路。
一个最后生成真正可以在 PowerPoint 里继续编辑的 .pptx。
另一个干脆绕开 PowerPoint,把浏览器本身变成了 PPT 播放器。
更有意思的是:两条路都成立。
而且把它们放在一起看之后,我突然觉得,AI PPT 其实是一个非常好的样本,它几乎把今天 Agent 类 AI 产品最核心的技术问题都浓缩在里面了。
它涉及内容理解、规划、设计、代码生成、中间表示、编译、渲染、验证和反馈闭环。
所以这篇文章我不想讨论“哪个 AI PPT 工具更好用”。
我真正想回答的是:
一个 AI,究竟怎样把一句模糊的“帮我做个 PPT”,一步一步变成最终能看到、能演示、甚至能继续编辑的视觉作品?
一开始,我以为 AI PPT 的核心是“大模型写内容”
如果把 AI PPT 最朴素地拆开,大概是这样:
用户输入↓大模型理解↓生成大纲↓每页写标题和正文↓套模板↓导出 PPT
这也是很多早期 AI PPT 产品给人的感觉。
所以很容易形成一个判断:
模型越聪明,PPT 就做得越好。
但真正看完这两个项目之后,我发现事情恰恰没有这么简单。
因为大模型真正擅长的是:
理解、抽象、取舍、叙事、判断。
而一份 PPT 最后还需要解决大量大模型并不天然擅长的问题:
字体应该多大?
这一段放左边还是右边?
图片裁成什么比例?
卡片之间留多少距离?
文字溢出了怎么办?
一个 SVG 阴影能不能转换成 PowerPoint 原生对象?
这一页在 16:9 屏幕上到底有没有撞到底部翻页按钮?
这些问题已经不是“语言问题”了。
它们开始进入另外一个世界:
视觉表示与确定性执行。
而两个项目真正的分叉,也正是从这里开始的。
第一条路线:把 AI PPT 当成一个“编译器”
先看 ppt-master。
我一开始找源码的时候,甚至有点困惑。
因为按照传统 AI 应用的思路,我下意识想找这种代码:
response = llm.generate(prompt)slides = parse(response)generate_ppt(slides)
结果并没有。
后来才意识到一个很重要的事情:
它本质上不是一个传统 App,而是一套 Agent Skill。
真正运行大模型的是 Claude Code、Codex 之类的 Agent Host。
仓库里的 Markdown 文件,不只是文档。
SKILL.md、workflows/、references/strategist.md、executor-base.md……
这些文件本身就是系统行为的一部分。
换句话说,这是一种新的软件结构:
传统软件:Code↓Code↓OutputAgent 软件:Markdown Workflow↓LLM Reasoning↓Tools / Code / Files↓Output
ppt-master 的技术设计文档甚至直接把自己描述为一种AI-directed workflow, human-controlled draft:Agent 负责 presentation-specific reasoning,而确定性工具负责转换、验证与打包。
这也是我第一次真正意识到:
今天很多所谓的“AI Agent 产品”,真正的源代码已经不完全是 Python 和 TypeScript 了。
有相当一部分逻辑开始写在自然语言 Workflow 里。
PPT Master 并不会拿到主题就开始画第一页
假设我们给它一个主题:
PPT AI 生成工具的原理和实现
如果只有这么一句话,没有文章,没有资料,没有数据,它甚至不会马上开始做 PPT。
它首先要判断:
支撑这份演示所需要的事实够不够?
如果不够,会进入 Topic Research 阶段。
这个阶段负责补齐事实,并把外部事实写成 Research Supplement 和 Fact Provenance。
而且它明确规定:
Research 阶段只负责:
什么是真的。
不能负责:
PPT 应该有几页、选什么图片、页面怎么设计。
也就是说,系统很早就把:
事实获取和
演示设计拆开了。
这看起来是一件小事,实际上非常重要。
因为很多 AI 工作流失败的原因就是:
研究、判断、写作、设计全部混在同一个 Prompt 里。
模型一边找事实,一边已经开始构造故事。
于是很容易出现:
为了故事好看,事实开始迁就故事。
PPT Master 的处理方式是先建立证据,再允许设计。
接下来出现了一个角色:Strategist
事实准备好之后,仍然不会直接进入 PowerPoint。
下一步是 Strategist。
它做的事情不是:
给我列 8 页标题。
而是先回答更高一层的问题:
谁要看?
为什么要看?
看完之后应该发生什么变化?
整套 PPT 最重要的一句话是什么?
这个东西在 PPT Master 里被定义得非常系统。
Strategist 会确认 Audience、Intent、Outcome、Core Message、Delivery Context 等,然后提出三个完整的设计方向,再选择最合适的方向。
最后形成一个很重要的文件:
design_spec.md这个文件可以理解成整套 PPT 的“语义蓝图”。
对于我们“PPT AI 生成工具的原理和实现”这个题目,其中一页可能不是简单写:
第 5 页:AI PPT 技术架构。
而是类似:
Audience MoveBefore:AI PPT 就是大模型自动写几页内容。After:AI PPT 是由语义规划、视觉表示、渲染器和反馈闭环共同组成的系统。Core Message:真正困难的不是让模型写出内容,而是把概率性的模型输出转化成稳定的视觉 Artifact。Visualization:展示 LLM → IR → Renderer → Artifact → Feedback 的系统关系。
PPT Master 的 Design Spec 确实要求每一页包含 Audience Move、Layout、Title、Core Message、Content,以及按需要加入 Visualization、Images 等信息。
我非常喜欢这里面的一个思想:
一页 PPT 的单位,不是“一块内容”,而是“一次认知变化”。
用户看这一页之前相信什么。
看完之后理解了什么。
这才是这一页存在的理由。
然后,PPT Master 做了一件很“软件工程”的事情
Strategist 的结果还不是最终执行文件。
系统会进一步把关键设计决策固定下来。
比如:
画布比例是什么。
字体是什么。
颜色是什么。
视觉语言是什么。
页面 roster 是什么。
哪些东西之后不能随便改。
这里的本质其实是:
把 Agent 的记忆变成外部状态。
因为如果让一个模型连续设计 20 页 PPT,你很难保证它做到第 18 页时还准确记得:
第一页用了什么颜色。
正文最小字号是多少。
标题到底是左对齐还是居中。
哪几页已经约定必须使用图片。
所以成熟的 Agent 系统不会只是说:
“记住刚才我们说好的设计。”
而是:
Reasoning↓Write state to file↓Read state again↓Continue execution
这其实也是我最近越来越强烈的一个感觉:
真正可靠的 Agent,不是记忆力特别好的 Agent,而是善于把状态外部化的 Agent。
真正做 PPT 时,AI 写的居然不是 PPT
接下来才轮到 Executor。
Executor 负责真正把一页页面做出来。
这里发生了整个 PPT Master 最关键的一次技术选择:
它没有让大模型直接写 PowerPoint XML。
也没有让大模型一直调用:
add_textbox()add_shape()add_picture()
它选择了:
SVG
作为中间表示。
所以当 AI 要做这样一页:
AI PPT 实现架构LLM / Strategist↓Intermediate Representation↓Renderer / Compiler↓Final Artifact↑Feedback
它最终真正“编写”的,更接近这样的东西:
AI PPT 的核心是一条从语义到 Artifact 的流水线LLM / Strategist...
到这里,事情突然变得很像软件开发了。
SVG 在这里,其实就是一种“视觉编程语言”
如果我们把传统编译器画成:
C Source Code↓Compiler↓Machine Code
PPT Master 实际上是在做:
SVG↓DrawingML Compiler↓PowerPoint
这也是为什么它的 SVG 不是“随便什么浏览器能显示的 SVG”。
技术设计里明确说明,它使用的是一个受项目约束的canonical SVG dialect。
也就是说,SVG 在这里已经不只是图片格式了。
它是:
专门为 PPT Master 设计的一种视觉 IR——Intermediate Representation,中间表示。
为什么需要它?
因为大模型非常熟悉 SVG。
矩形是什么?
文字是什么?
圆是什么?
Path 是什么?
坐标放在哪里?
这些模型都很容易生成。
但是让模型直接稳定地写 PowerPoint OOXML,就复杂得多了。
于是 SVG 变成了中间那座桥:
LLM-friendly↓SVG↓PowerPoint-friendly
接下来发生的事情,就真的和编译器差不多了
PPT Master 里有一个核心模块:
svg_to_pptx其 DrawingML converter 会解析 SVG,并针对不同元素分别调用:
convert_rectconvert_circleconvert_ellipseconvert_lineconvert_pathconvert_polygonconvert_polylineconvert_textconvert_image
也就是说:
SVG最后不是变成一张截图里的矩形。
而是变成:
PowerPoint Rectangle ShapeSVG 的:
最后变成 PowerPoint 原生的文本对象。
SVG 的:
可以转成 DrawingML 的自由形状。
图片变成原生 Picture。
所以用户最后在 PowerPoint 里仍然可以:
点进去。
改文字。
拖矩形。
换颜色。
重新排版。
这就是它所谓native editable PowerPoint的本质。
为什么这条路线这么复杂?
因为 PowerPoint 本身不是一个特别适合大模型直接编程的视觉系统。
最终 .pptx 其实是一个 OOXML Package。
里面包含:
slidesrelationshipsmediaslide layoutsslide mastersthemesnotesanimationstransitions...
PPT Master 的 Builder 不仅用了 python-pptx,还直接处理 XML、ZIP package、relationships、theme、transition 和 animation 等底层结构。
于是整个系统本质上成了:
一个 AI 驱动的 Presentation Compiler。
前端是概率性的 LLM。
后端是确定性的编译器。
我后来把它概括成一句话:
Probabilistic Frontend + Deterministic Backend
大模型可以负责模糊问题:
这页应该讲什么?
这页应该是什么关系?
什么最重要?
哪种结构更清楚?
但一旦进入:
对象能不能转换。
坐标是否合法。
图片有没有损坏。
字体如何映射。
OOXML Relationship 对不对。
Package 能不能打开。
这些事情就交给确定性程序。
这其实是一个非常漂亮的 AI 系统设计原则。
然后我看了第二个项目,发现它干脆把问题重新定义了
第二个项目叫:
guizang-ppt-skill。
它同样是一个 Agent Skill。
但当我打开 SKILL.md 的时候,很快发现:
它做的“PPT”和 PPT Master 根本不是一回事。
它的最终产品不是:
xxx.pptx而是:
index.html一个可以在浏览器直接打开的单文件横向翻页演示。
README 直接把它定位成适配 Claude Code / Codex 的 HTML Deck Skill,内置电子杂志风和瑞士国际主义两套视觉系统。
当我意识到这一点时,后面很多设计突然就解释通了。
它不需要自己发明 Renderer,因为浏览器就是 Renderer
假如 AI 要画三个并排的卡片。
PPT Master 需要关心:
xywidthheight
然后 SVG 再转换。
Guizang 可以直接写:
LLMVisual IRRenderer
然后让 CSS:
display: grid;grid-template-columns: repeat(3, 1fr);gap: 24px;
接下来的事情全交给浏览器。
字体 shaping。
换行。
Grid。
Flex。
图片裁切。
动画。
层叠。
窗口。
键盘事件。
浏览器已经帮它做好了。
所以 Guizang 根本不需要构建一个:
SVG → DrawingML Compiler因为:
HTML + CSS 本身就是一套成熟了几十年的视觉 DSL,而 Chromium 本身就是世界上最成熟的页面渲染器之一。
这是两条技术路线分叉的根本原因。
更有意思的是,Guizang 几乎不鼓励 AI 自由设计
这是我觉得第二个项目最值得研究的地方。
如果说 PPT Master 的哲学是:
给 AI 足够大的设计空间,然后在后面验证它。
Guizang 的思路几乎相反:
一开始就别给它那么大的空间。
比如瑞士风 Style B。
它不是说:
按 Swiss Style 自由发挥。
而是非常明确地规定:
正文默认只能从登记的:
S01S02...S22
22 种 Layout 中选择。
每页必须写:
data-layout=”Sxx”不能临时创造一个:
S23觉得自己今天灵感特别好。
swiss-layout-lock.md 甚至直接说明,它存在的目的不是“增加灵感”,而是防止生成结果只是“看起来像 Swiss”,实际已经脱离原始设计体系。
这句话让我印象特别深。
原来 AI 设计还有另一条路:别让模型设计,先让专家把设计做好
这背后其实是一种完全不同的技术哲学。
假设一页要表达:
AI PPT 的三层架构。
PPT Master 的 Executor 会想:
我应该怎样设计这一页?
Guizang 更像在想:
S05 Three Layers 是不是正好适合?
再比如:
AI PPT 的两种技术路线。
它更可能直接去找:
S08 Duo Compare如果是一套反馈闭环:
S14 Loop Form如果是一张系统结构:
S17 System Diagram于是问题从:
Generate a layout变成了:
Retrieve a layout+Adapt content
这是一个非常大的变化。
我后来用一个贝叶斯视角来理解这两个项目
Guizang 做的事情,本质上是在建立一个非常强的设计 Prior。
它提前规定了:
什么颜色好看。
什么字号组合安全。
什么图片比例合理。
什么 Layout 适合什么内容。
标题应该放哪里。
卡片应该怎么排列。
底部要留多少安全区。
大标题有多大。
图片应该怎么裁。
于是模型真正需要探索的空间被大幅缩小。
可以粗略理解成:
GuizangStrong Prior↓Small Search Space↓Less Model Freedom↓Lower Variance↓More Stable Output
而 PPT Master 更接近:
Large Design Space↓LLM Reasoning↓Free Composition↓Higher Potential↓Strong Validation Required
所以我后来用两句话总结它们:
Guizang:Strong Prior + Simple Execution。
PPT Master:Large Hypothesis Space + Strong Verification。
这可能比“HTML 和 PPTX 有什么区别”更接近两个系统真正的灵魂。
而 Guizang 最让我意外的地方,是它对“反馈”的处理
AI 写完 HTML,并不意味着任务完成。
它有一个 validate-swiss-deck.mjs。
一部分是静态规则。
比如:
有没有使用未登记 Layout。
标题是不是不应该居中却居中了。
SVG 里是不是塞进了可见文字。
图片有没有绑定正确的 image slot。
但真正有意思的是下一步。
如果环境里存在 Playwright,它会直接启动 Chromium。
然后真的把:
index.html打开。
接着测:
getBoundingClientRect()scrollHeightclientHeight
检查:
页面有没有 Overflow。
最下面的元素有没有撞出去。
标题和下面内容间距是不是太小。
有没有进入底部翻页导航的危险区域。
看到这里我突然想到:
这其实已经不是一个 PPT 问题了。
这是典型的:
Generate → Execute → Observe → Repair
Agent 闭环。
两个项目表面上完全不同,最后居然在“反馈”这里重新汇合了
PPT Master:
LLM↓SVG↓Compiler↓Error / Validation↓Repair
Guizang:
LLM↓HTML↓Browser Render↓DOM Measurement↓Repair
技术对象完全不同。
但更高一层看,它们其实是同一个东西:
把模型输出放进真实环境执行,再从环境获得信号。
而不是:
大模型觉得自己写对了,那就算对了。
这是今天 Agent 真正开始变得可靠的关键。
如果把同一页同时放进两个系统,区别会非常直观
还是那一页:
AI PPT 的实现架构
PPT Master 的链路是:
Page Intent↓Executor↓自由设计几何关系↓SVG↓SVG Validator↓DrawingML Converter↓PowerPoint Shape↓.pptx
Guizang 的链路是:
Page Intent↓识别:这是一张系统关系图↓检索 S17 System Diagram↓填充 HTML Component↓CSS Grid / Flex↓Chromium↓Browser Deck
一句话:
PPT Master 在做 Geometry Generation。
Guizang 在做 Component Composition。
到这里,我才真正理解 AI PPT 的核心其实不在“PPT”
如果把这两个系统再往上抽象一层,你会发现,无论最后输出 .pptx 还是 .html,其实都绕不开五层。
1. Content Intelligence↓2. Presentation Planning↓3. Visual Representation↓4. Renderer / Compiler↓5. Feedback & Validation↺
第一层解决:
我到底在讲什么?
第二层解决:
我要怎样让别人理解?
第三层解决:
这个意思怎样表示成一个视觉结构?
第四层解决:
谁把这个视觉结构真正画出来?
第五层解决:
画出来之后到底对不对?
真正不同的,是第三、第四层。
PPT Master 选择的是:
Visual Representation = Canonical SVGRenderer = SVG → DrawingML Compiler + PowerPoint
Guizang 选择的是:
Visual Representation = HTML Components + CSSRenderer = Browser
一旦用这个模型来看,你再去看 Gamma、Beautiful.ai、Canva、Google Slides Agent、各种 PPT Copilot,很多实现差异都会变得容易理解。
还有一个问题特别值得思考:AI 真的应该自由设计每一页吗?
拆完这两个项目之后,我自己的答案发生了一些变化。
以前很容易觉得:
大模型越来越强,总有一天应该让它随便设计。
但 Guizang 给了另外一个答案。
也许根本没必要。
现实中专业设计师自己也不是每天从一张完全空白的画布开始。
设计系统、Grid、Typography、Design Token、Component Library、Brand Guideline,本来就是现代设计工业化的重要基础。
所以也许更合理的 AI PPT 系统应该是:
80% 页面↓高质量 Layout Library 检索20% 特殊页面↓允许自由设计
而不是让 AI:
20 页全部从零发明。
这会把问题从:
Generative Design部分转化为:
Retrieval + Adaptation而后者恰恰是大模型非常擅长的事情。
所以,如果让我今天重新设计一套 AI PPT 系统,我会把两个项目合起来
我会保留 PPT Master 的:
Research。
Fact Provenance。
Strategist。
Audience Move。
Design Spec。
可持久化的执行状态。
SVG IR。
Native PPTX Compiler。
OOXML Validation。
但视觉生成阶段,我不会默认每一页都 Free Design。
我会先建立一套 Guizang 那样经过人工打磨的:
Layout LibraryComponent LibraryTypography SystemColor SystemImage Slot SystemSpacing Rules
然后:
Page Intent↓Layout Retrieval↓Content Adaptation
只有找不到合适结构的时候,才允许:
Free-form SVG Generation生成之后,不马上导出 PowerPoint。
而是先:
Render Preview↓真正测 Bounding Box↓检查 Overflow↓检查视觉层级↓检查图片裁切↓Visual Critic↓Repair
最后才:
Compile to native PPTX完整架构会更像:
User│▼Source / Research│▼Strategist│▼Page Intent│┌──────────┴──────────┐▼ ▼Layout Retrieval Free Design80% 20%│ │└──────────┬──────────┘▼Visual IR│▼Render Preview│▼Visual Measurement│Repair ↺│▼PPTX Compiler│▼Native PowerPoint
我现在反而觉得,这可能比单纯追求“更强的大模型”更接近 AI PPT 真正会走向成熟的方式。
最后,再回到最开始那个问题
AI 到底是怎么生成 PPT 的?
我现在不会再回答:
大模型先写大纲,再调用 PPT 工具。
这个回答太浅了。
更准确的说法应该是:
AI PPT 的本质,是把一个模糊的沟通意图,一层一层约束成一个可以被确定性 Renderer 执行的视觉程序。
整个过程其实是:
Prompt↓Intent↓Narrative↓Page Intent↓Visual Representation↓Renderer / Compiler↓Artifact↓Feedback↺
你会发现,越往前,问题越模糊。
越往后,问题越确定。
前面需要大模型。
后面需要工程系统。
所以一个真正成熟的 AI 产品,并不是把所有事情都交给大模型。
恰恰相反。
它应该清楚地知道:
哪些问题应该让模型判断,哪些问题应该尽快从“概率”变成“规则”。
PPT Master 用:
SVG + Compiler
完成这次转换。
Guizang PPT Skill 用:
Template + HTML/CSS + Browser
完成这次转换。
路线不同。
但它们最终都指向了同一个非常重要的 AI 工程思想:
让 AI 负责不确定性,让系统负责确定性。
也许这才是我拆这两个 PPT 项目之后,真正学到的东西。
而且它显然不只适用于 PPT。
从报告生成、科研绘图,到软件 UI、CAD、实验设计,甚至未来的自动化科学研究系统,本质上都在面对同一个问题:
怎样把大模型模糊但强大的判断能力,逐步压缩成一个可执行、可验证、可重复的真实世界 Artifact。
PPT 只是一个非常好的开始。

