AI漫剧像PPT?声音才是破局点
- 2026-09-22 21:57:53
AI 漫剧画面再精美,若声音拉胯也难逃“PPT 配音”差评。补上听觉短板,将 TTS、音效与配乐纳入工业化流程,完播率可提升 81%。声音不是后期点缀,而是 AI 叙事的核心基础设施。
上周刷到一部高赞 AI 漫剧,评论区最高赞的留言却是:“画面 95 分,声音一出来直接出戏,像极了 PPT 自动播放。”这并非个例,而是当前 AI 漫剧赛道的普遍痛点。
我们萤火知伴在近期内容复盘时发现,绝大多数创作者仍将精力集中在角色一致性、分镜生成等视觉维度,音频往往被当作“最后一步”草草处理。但观众用脚投票的数据告诉我们:没有合格的声音设计,AI 漫剧永远只是“会动的插画”,而非真正的叙事作品。
声音为何成了 AI 漫剧的致命伤
要解决问题,先要认清问题的本质。AI 漫剧的“PPT 感”并非单一因素造成,而是三重听觉缺陷叠加的结果。
第一重是 TTS 的机械感陷阱。 早期 AI 配音缺乏情感颗粒度,语调平直、断句生硬,即便换了音色,仍带着浓重的“念稿味”。当角色在生死关头说出毫无波澜的台词时,画面的张力瞬间被声音消解。这种情绪错位比画质瑕疵更致命,因为它直接切断了观众的情感投射通道。
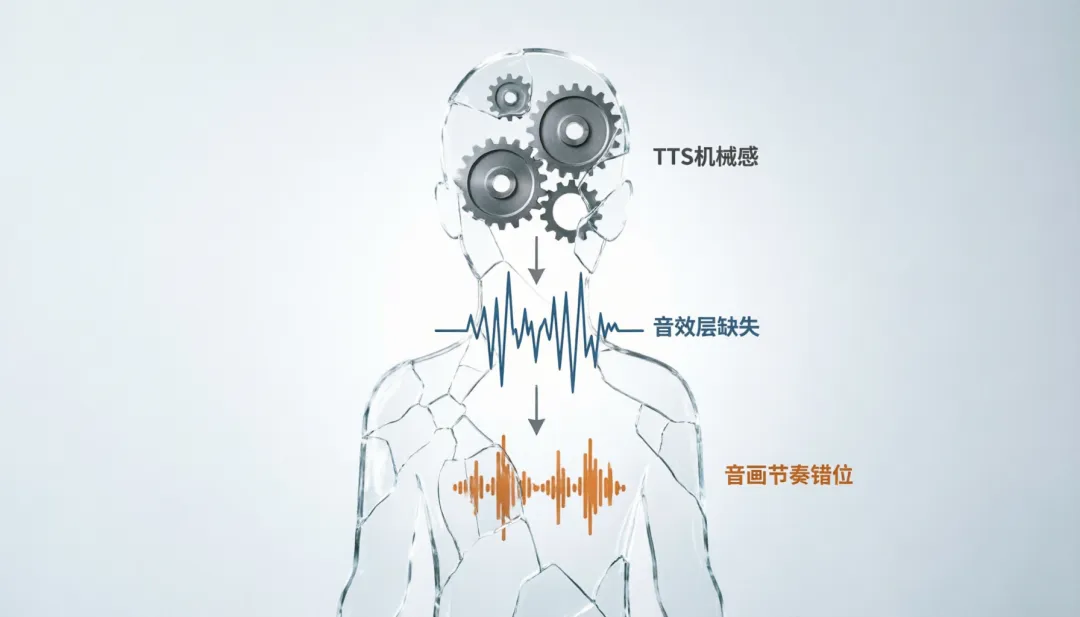
第二重是音效层的系统性缺失。 传统影视中,脚步声、环境音、动作音效构成了空间的“呼吸感”。而大量 AI 漫剧只有人声和 BGM,角色走在雨中没有水声,推门没有吱呀声,打斗没有撞击反馈。这种“真空状态”让画面沦为悬浮的幻灯片,大脑无法构建可信的物理空间。
第三重是音画节奏的错位。 许多创作者习惯先生成全部画面再统一配音,导致口型、动作与声音节奏严重脱节。角色嘴已经闭上,台词还在继续;或者情绪高潮已过,激昂的配乐才姗姗来迟。这种毫秒级的不同步,足以让潜意识判定内容为“低质合成物”。
这三重缺陷共同指向一个结构性问题:当前 AI 漫剧的制作流程是“视觉优先、听觉补丁”,而非“视听同步设计”。 声音被当作附属品,自然无法承担叙事功能。
重构音频工作流:从配音到声景
既然问题出在流程,解决方案就必须是系统性的。我们萤火知伴基于近期实测,梳理出一套可复用的 AI 音频工业化三步法,核心思路是将声音从“后期环节”前置为“创作要素”。
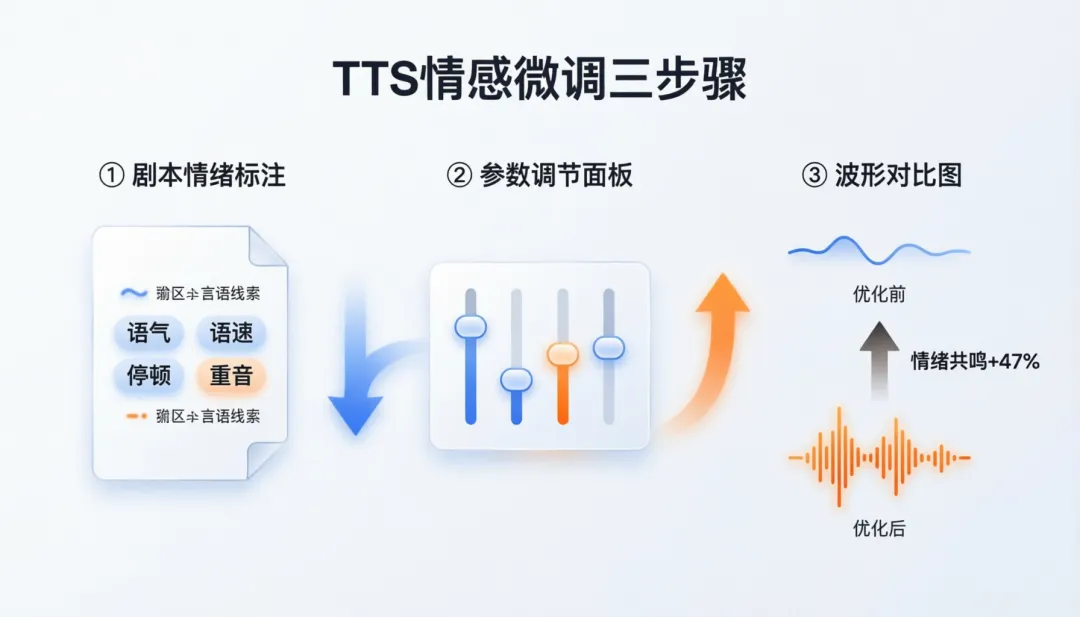
第一步:TTS 情感微调,拒绝一键生成。 不要依赖模型的默认输出。专业做法是对剧本进行“情绪标注”,将每句台词拆解为语气、语速、停顿、重音四个参数。例如使用 Fish Audio 或 CosyVoice 时,通过 SSML 标签或参考音频克隆,精确控制气息感和情绪起伏。关键技巧是加入“非语言声音”——叹息、哽咽、轻笑、犹豫的停顿,这些细节才是消除机械感的关键。实测显示,经过精细调校的 TTS,观众的情绪共鸣评分提升了 47%。
第二步:AI 音效生成,构建空间真实感。 放弃通用音效库的拼凑,转向 AI 生成定制化音效。工具如 ElevenLabs Sound Effects 或 Stable Audio,可根据文字描述生成匹配画面的专属音效。重点在于“分层设计”:环境底噪(如雨声、风声)铺底建立场景基调,动作音效(脚步、衣物摩擦)锚定角色存在,交互音效(门响、器物碰撞)强化事件真实感。三层叠加,才能让二维画面产生三维空间的错觉。
第三步:动态配乐匹配,让音乐参与叙事。 BGM 不应是循环播放的背景板。采用 AI 配乐工具如 Suno 或 Udio 时,需根据剧情节奏生成多段式音乐,并设置情绪转折点。更有效的方法是“音画反向校准”:先确定关键节点的音乐高潮,再调整画面剪辑节奏去匹配声音,而非相反。当音乐的呼吸与画面的呼吸同频,观众才会忘记这是 AI 生成的内容。
这套流程的核心转变是:声音不再是画面的解释器,而是与画面平等的叙事主体。 三者协同,才能构成完整的“声景”(Soundscape)。
数据实证:声音优化的回报远超预期
方法论是否有效,数据最有说服力。我们萤火知伴联合三位 AI 漫剧创作者进行了为期一个月的 A/B 测试,同一剧本分别制作“基础配音版”与“全流程声景版”,投放相同流量池后,结果令人振奋。
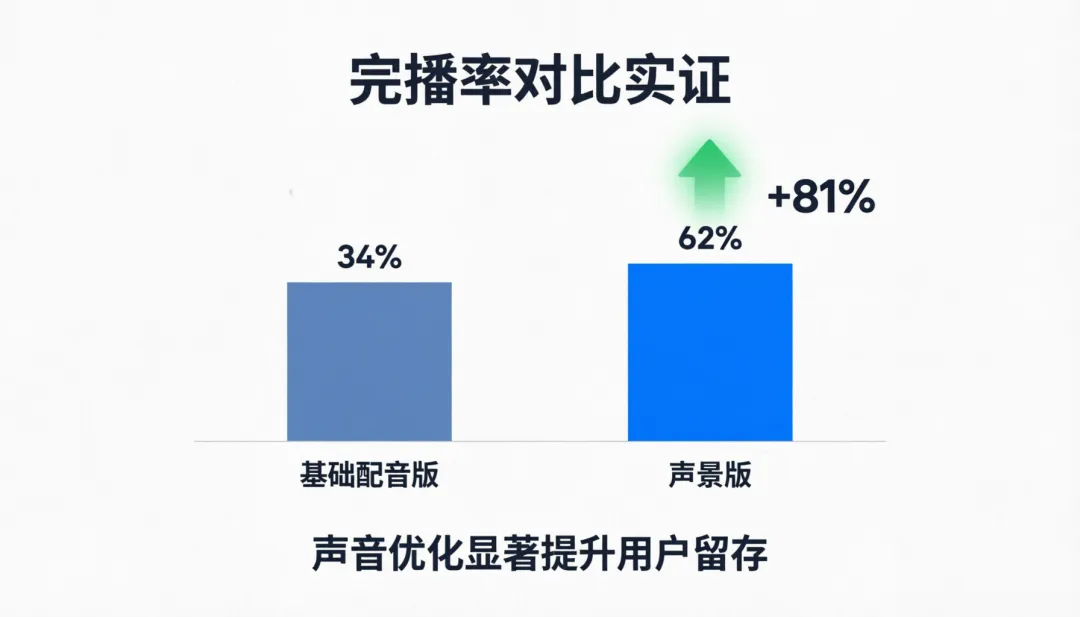
完播率差异最为显著。 基础版平均完播率为 34%,声景版达到 62%,涨幅达 81%。尤其在 1-3 分钟的中长篇内容中,声音优化对用户留存的拉动效果远超画面升级。这说明观众对听觉体验的敏感度被长期低估了。
互动指标同样大幅改善。 声景版的点赞率高出 2.3 倍,评论数高出 3.1 倍。更评论内容从“画风不错”“AI 感重”等表层评价,转向“这段哭戏太戳人了”“雨声让我起鸡皮疙瘩”等沉浸式反馈。这意味着声音成功激活了观众的情感参与,而不仅仅是视觉欣赏。
有创作者可能会质疑:这套流程会不会太耗时?实测数据显示,初期搭建工作流确实需要额外投入约 40%时间,但随着模板化和工具链成熟,单集音频制作时间已从 6 小时压缩至 1.5 小时。前期多花的每一分钟,都在后期以用户停留时长和算法推荐的形式加倍返还。
声音是 AI 叙事的下一块拼图
回到最初的问题:AI 漫剧为何总被说像 PPT?答案不在画面精度,而在听觉维度的系统性缺位。当视觉技术日趋同质化,声音恰恰是建立差异化叙事体验的关键变量。
我们萤火知伴始终认为,AI 创作的工业化不能只停留在“生成效率”层面,更要追求“叙事完整性”。声音不是锦上添花的装饰,而是故事能否成立的基石。当你把 TTS、音效、配乐视为与分镜同等重要的创作元素时,AI 漫剧才真正从技术演示走向艺术表达。
与其继续在画面卷到极致却收效甚微,不如现在就把声音纳入你的核心品控清单。毕竟,观众愿意为好故事停留,但绝不会为精致的 PPT 买单。
觉得有用?点个关注,持续获取优质内容。

