学习笔记 EP03:ROV 的推进系统与运动控制
- 2026-11-04 21:18:38
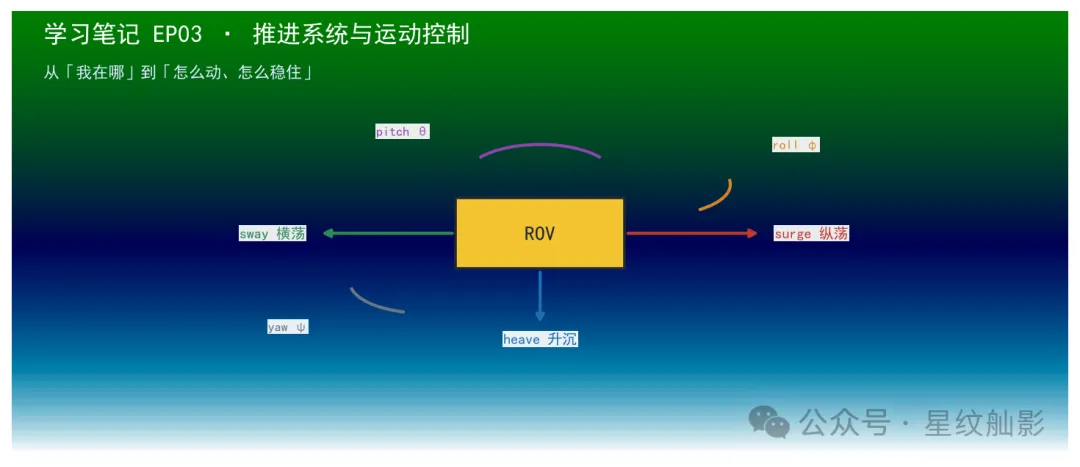
前两篇里,我们已经把 ROV 的家族(EP01)和它"怎么知道自己在哪"(EP02 水下定位与导航)讲清楚了。但定位只解决了一半问题——知道位置,不等于能到达并保持那个位置。
真正让 ROV 动起来的,是推进系统与运动控制。前者把电能或液压能变成推力,后者把人的意图(或自主指令)翻译成每个推进器该转多快。两者合在一起,才构成一条完整的"感知—决策—动作"闭环:水下定位与导航过程负责感知,本篇负责动作,而动作又反过来依赖感知来修正。
有一个反直觉的点值得先记住:在水下,悬停不动比直线前进更难。 前进时水动力相对稳定;一旦要定点保持,海流、浮力差、推进器非线性会同时来捣乱。所以"稳得住"才是推进与控制水平的试金石。
一、怎么描述运动——6 自由度与坐标系
要谈控制,先得有统一的语言。水下航行器沿用海运界 1950 年确立的 SNAME 符号体系,用一个 6 维向量描述位姿、速度和受力。
位姿(体坐标系相对于地面坐标系的位置与姿态):
η = [ x, y, z, φ, θ, ψ ]ᵀ
速度(体坐标系下的线速度与角速度):
ν = [ u, v, w, p, q, r ]ᵀ
广义力与力矩:
τ = [ X, Y, Z, K, M, N ]ᵀ
六个分量对应六个自由度(DOF):沿 x 的纵荡(surge)、沿 y 的横荡(sway)、沿 z 的升沉(heave),以及绕这三根轴的旋转——横滚(roll, φ)、俯仰(pitch, θ)、艏摇(yaw, ψ)。其中 x 指向前、y 指向右舷、z 指向下(NED:北-东-地约定),构成右手系。
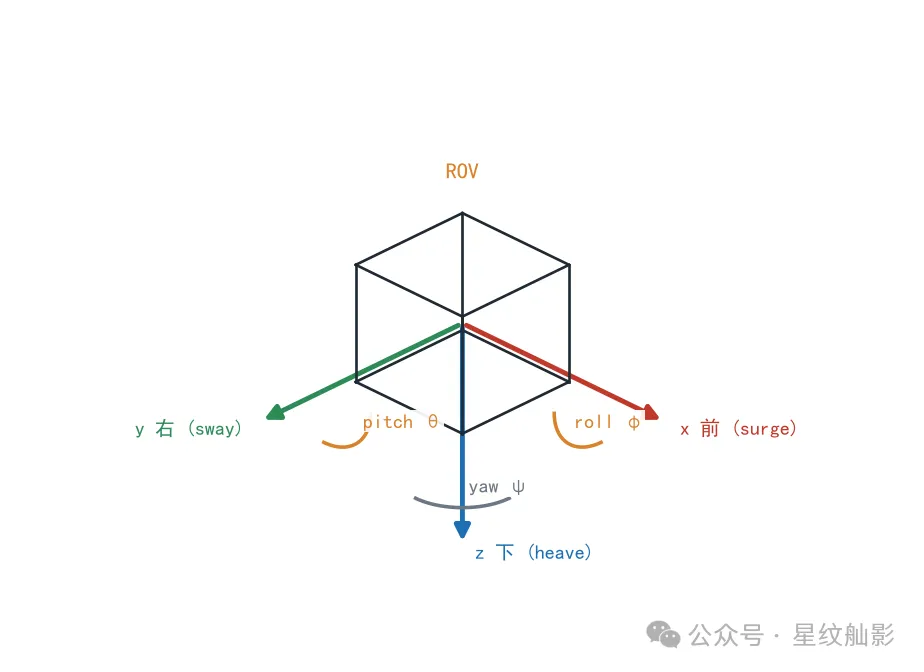
为什么必须搞两套坐标系? 受力、惯性、推力都最自然地在体坐标系(BODY)里表达(推力沿机体轴、附加质量随体轴定义);而位置、任务指令、导航结果却在地面坐标系(NED)里表达。两套坐标靠姿态变换矩阵 R(η) 连接,并进一步构成运动学方程:
η̇ = J(η) · ν
J(η) 是 6×6 变换矩阵,上半区就是 R(η)(把机体速度旋转到地面系),下半区把体坐标角速度 (p, q, r) 换算成欧拉角变化率。这就是需要两套坐标系的根本原因——一套坐标无法同时干净地表达"推力沿机体轴"和"位置在地面系"。R(η) 由三个欧拉角(ψ 艏摇、θ 俯仰、φ 横滚)依次旋转合成;当 θ 接近 ±90° 时矩阵奇异(万向锁)。这也正是前文延伸里引入四元数的原因——用四元数参数化姿态,可让 J(η) 在大幅机动时始终可逆。
Fossen 的《Marine Craft Hydrodynamics and Motion Control》就用这套符号,把经典水动力方程整理成后面要用的紧凑矩阵形式。
二、动力从哪来——推进器与能源
2.1 电动还是液压
工作级 ROV 的推力来源主要有两类,本质差别在"能量如何变成轴向推力":
电动推进:电机电磁转矩 ∝ 电流,响应快(毫秒级)、转矩-转速特性平滑、可控线性好。但功率密度受电机与电力电子限制,单体推力上限较低。多见于观察级与轻中型 ROV(如 BlueROV2 的 T200 推进器)。液压推进:水面液压动力站(HPU)把机械能变成高压油(压力 ∝ 力),经脐带缆长距离输送至水下执行机构。液压功率密度高、能扛冲击负载,是重型工作级 ROV 的主流;代价是油液可压缩性、管路泄漏与阀响应带来更大滞后,且要处理水下防爆与污染。
一句话:电动赢在"快而干净",液压赢在"大而猛"——选型的本质是在"响应/可控性"与"推力量级"之间权衡。
2.2 推力不是线性的
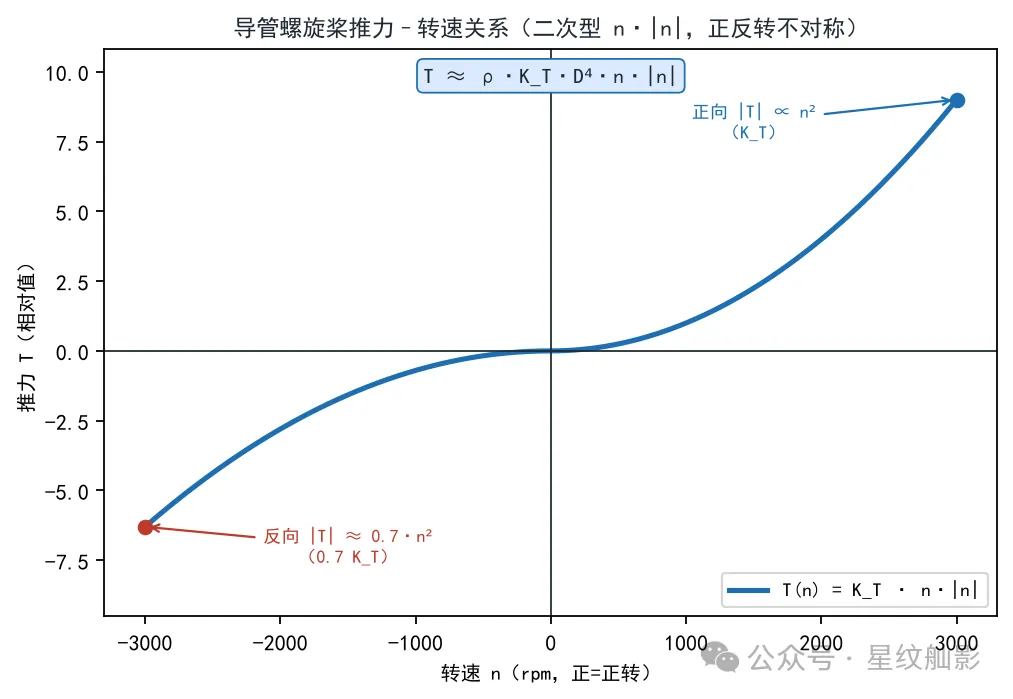
单个导管螺旋桨的推力近似与转速平方成正比,且正反转不对称:
T ≈ ρ · K_T · D⁴ · n · |n|
其中 ρ 是水密度,K_T 是推力系数,D 是桨径,n 是转速(带符号)。这个二次型可以用动量理论理解:螺旋桨把一段水流加速,推力等于质量流量乘以流速增量,即 T = ṁ·Δv;而 ṁ ∝ A·v(流量正比于桨盘面积与诱导速度),Δv ∝ n(诱导速度正比于转速),于是 T ∝ n²,再补上符号即得上述形式。
注意 n·|n| 这一项:它表明正转和反转产生的推力大小不同。关键在于 K_T 并非正负相同——Kort 导流管与桨叶是为单向来流优化的,反转时入流分离更严重、效率更低,通常反向推力只有正向的 65%–80%。这就是为什么"前进容易、后退吃力",也是分配算法必须把它当作非对称执行器对待的原因(见第五章)。
2.3 典型布局——4 水平 + 2 垂直
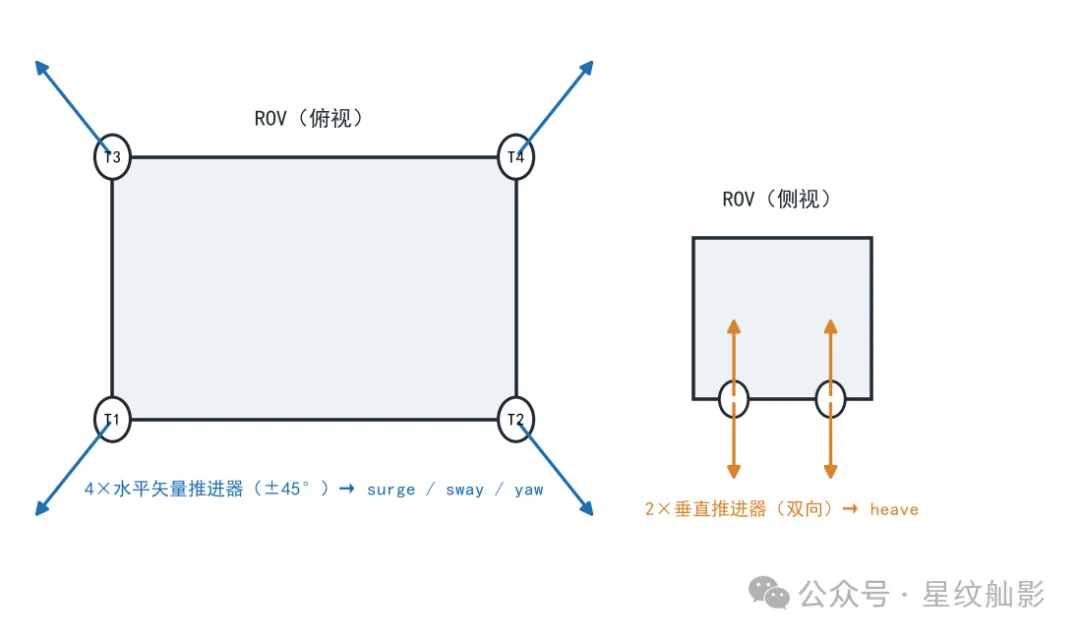
最常见的轻型配置是 6 台推进器:4 台水平布置、与纵轴成 ±45° 形成"矢量推力",合力可分解出纵荡、横荡和艏摇三个自由度;另外 2 台垂直布置,负责升沉(并借差动辅助俯仰/横滚)。BlueROV2 的官方资料即明确为"6 thrusters (4 vectored, 2 vertical)"。
把"布局"翻译成数学,就是下一章分配矩阵 B 的水平子块。对一台水平推进器 i,设它在体坐标系的推力方向单位向量 ê_i = (cos α_i, sin α_i, 0),安装位置为 (x_i, y_i),则它对 [X 纵荡, Y 横荡, N 艏摇] 三个自由度的贡献为:
X_i = T_i · cos α_i
Y_i = T_i · sin α_i
N_i = (x_i · sin α_i − y_i · cos α_i) · T_i
其中 N_i 是位置矢量 r_i 与推力 F_i 叉乘的 z 分量(N = x·F_y − y·F_x)。把四台 ±45° 矢量推器的 α_i 与对称位置代入,得到的是一个 3×4 矩阵:3 个自由度由 4 台推器提供,本身就已经冗余 1 个自由度。这解释了为何轻型 ROV(如 BlueROV2)用 4 台水平推器就能同时控住纵荡、横荡、艏摇,且仍有余量做容错。垂直 2 台专门负责升沉(并借差动补俯仰/横滚)。
重型工作级常扩到 6–8 台,目的不是增加自由度(6 个已经够),而是把冗余从"水平 1 个"放大到"全局多个"——多一台推进器就多一种分配方案,也多一份容错能力(详见第五章)。具体台数是机型相关的工程选择,并非普适定则。
2.4 能源——点到为止
推进器要的电或液压,都来自脐带缆(水面供电 / 水面 HPU 经缆供压)。这部分涉及缆的力学、收放与通信,是 ROV 区别于 AUV 的关键结构,我们留到 EP04 专门拆解,本篇只把它当作"已存在的能量来源"看待。
三、运动的物理约束——动力学模型
把受力列成方程,就得到 ROV 的标准动力学模型(Fossen 形式):
M · (dν/dt) + C(ν) · ν + D(ν) · ν + g(η) = τ
逐项拆解它"为什么长这样":
M·(dν/dt):惯性项。M = M_RB + M_A。M_RB 是刚体惯性(含转动惯量);M_A 是附加质量——加速机体时,还要带动周围一团水一起加速,这部分"被拖着走的水"等效为额外惯性。由于势流对称性,M_A 同样是对称正定矩阵,在某些轴上甚至大于 M_RB。这是水下与空/陆运动最本质的区别之一:你推的不仅是机器,还有它裹挟的水。 C(ν)·ν:科氏与向心力项,来自机体坐标系随体旋转。它的关键性质是反对称(C + Cᵀ = 0),于是 νᵀCν ≡ 0——也就是说 C 项本身不做功,它只在六个自由度之间重新分配动能,既不凭空产生也不耗散能量。认识到这点,很多"控制律为何能稳定"的疑问就清楚了:系统的能量只能被 D 耗散、被 g 储存,C 只是搬运工。 D(ν)·ν:水动力阻尼项。D(ν) = D_l + D_q(|ν|):线性项来自粘性表面摩擦(∝ν),二次项来自压差阻力(∝|ν|ν)。在 ROV 工作速度下,二次阻尼往往主导,这使得动力学成为强非线性——同一套 PID 增益在慢速悬停和高速航行下表现会差很多,逼出"增益调度"。 g(η):恢复力项。垂直方向净力为 (W − B)(水中净重);力矩来自重心 G 与浮心 B 不重合——当 B 在 G 上方时,任何倾斜都会产生使系统回正的回复力矩(类似不倒翁/初稳性)。这就是 ROV 为何要精心配平:配平越好,(W−B) 与回复力矩越可控,定点保持越省力。
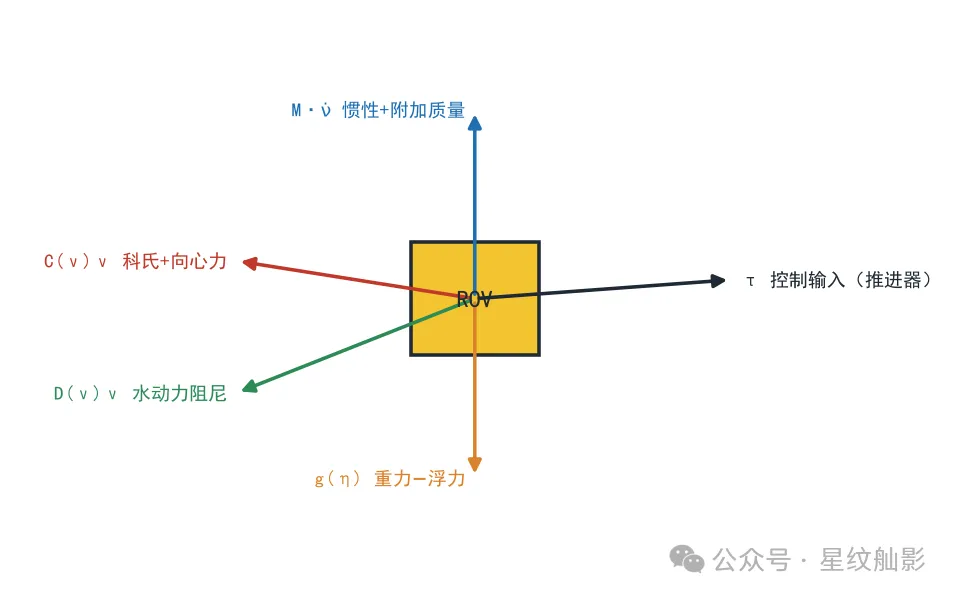
这套方程的关键特征是强非线性、强耦合:速度影响阻尼与科氏力,姿态影响重力恢复项,控制输入 τ 还要经第五章的分配才落地为真实推力。正因如此,水下控制比陆地轮式机器人难得多——陆地车基本只需平面上的力平衡,ROV 却要同时处理六个耦合自由度。
四、控制怎么工作——从指令到动作
控制的目标,是让 ROV 的实际位姿 η 跟踪期望位姿 η_d。工程上几乎都用级联闭环,但真正的要点在带宽分离:内环(速度)必须比外环(位置)快 5–10 倍。原因很直接——位置是力经两次积分得到的量,若外环下指令太急、内环跟不上,推力还没建立位置就冲过头,会振荡甚至失稳。所以"外环慢、内环快"不是工程习惯,而是稳定性的硬性要求。
① 位置/姿态环(外环):比较期望位姿与实测位姿,输出"想要的线速度/角速度" ν_d;
② 速度/角速度环(内环):让实际 ν 跟踪 ν_d,输出"想要的广义力" τ_cmd;
③ 推力分配(见第五章):把 τ_cmd 拆成各推进器的推力指令 u;
④ 推进器执行 u,产生真实推力,作用于 ROV(被第三章的动力学方程支配);
⑤ 传感器(INS、DVL、深度计、罗经)测回实际 η、ν,回到第①步形成反馈。
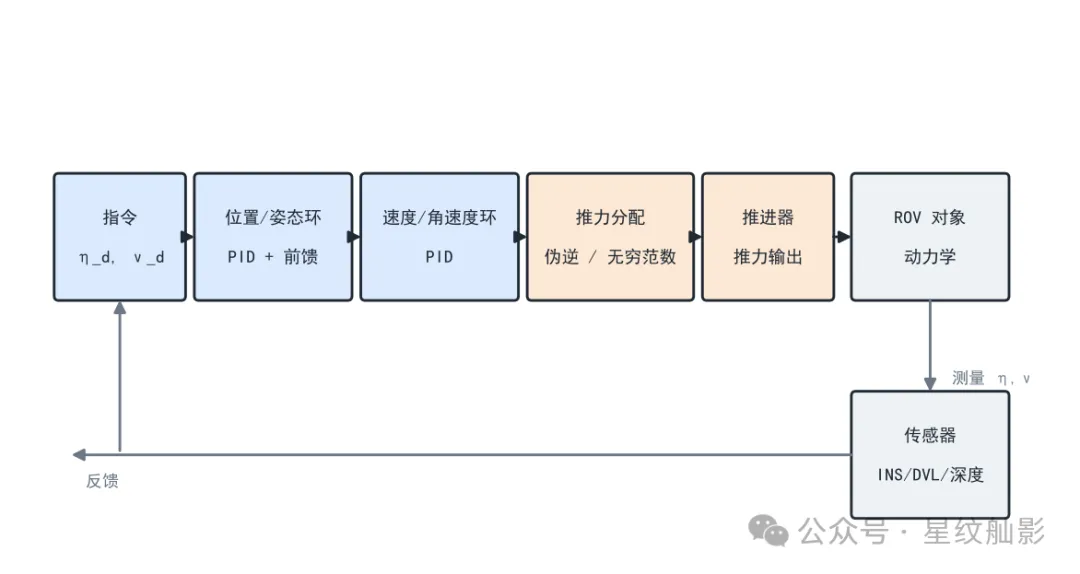
最经典的内/外环控制器是 PID 加前馈。PID 部分:
u_pid = K_p · e + K_i · ∫ e dt + K_d · (de/dt)
其中 e 是误差。前馈的物理含义是:稳态时 ROV 要对抗的是确定项 τ_ff = C(ν)·ν + D(ν)·ν + g(η) + F_env(科氏/向心项 + 稳态水阻 + 重力浮力差 + 海流等环境扰动)。把这些提前注进执行器,PID 只需补偿残差(瞬态与建模误差),响应更快、稳态更准,且不易饱和。
动态定位(DP)是这套框架在工程上的重要延伸:它把"定点保持"当作外环目标。位置误差(来自 EP02 的 USBL/LBL 或声学定位)生成期望速度,速度环靠 DVL 实测(或位置微分)闭环;中间的状态由 EP02 的 EKF 观测器给出干净估计。所以 DP = 反馈 + 前馈(海流估计)+ 观测器,三者缺一不可。海流一来,DVL 测到相对水速度变化,控制律立刻补推力抵消——"悬停比前进难"正靠这层闭环化解。值得提醒的是,真实推进器存在一阶滞后,且推力有饱和上限(见第五章),二者都会吃掉内环相位裕度,因此实际调参必须留余量。
五、推力分配——把"想去的力"分给每个推进器
控制环算出的是"想要的广义力" τ,但真正能动的是 m 台推进器各自的推力 u。两者通过分配矩阵 B 联系:
τ = B · u
B 的每一列是"某台推进器单位推力对六个自由度的贡献",由它的安装位置与朝向(几何)决定:列 i = [ ê_i ; r_i × ê_i ],其中 ê_i 是推力方向单位向量、r_i 是从重心到该推器的位置矢量。当 m > 6(冗余配置),同一 τ 对应无穷多组 u——该选哪一组?
最省事的答案是伪逆(最小二乘),它最小化各推进器推力的平方和(即能耗):
B† = Bᵀ · (B · Bᵀ)⁻¹ , u = B† · τ
更实用的是加权伪逆,给不同推进器不同的权重(例如给已部分故障的推进器加大权,逼分配算法少用它),从而编码"容错"偏好:
B†_W = W⁻¹ · Bᵀ · (B · W⁻¹ · Bᵀ)⁻¹
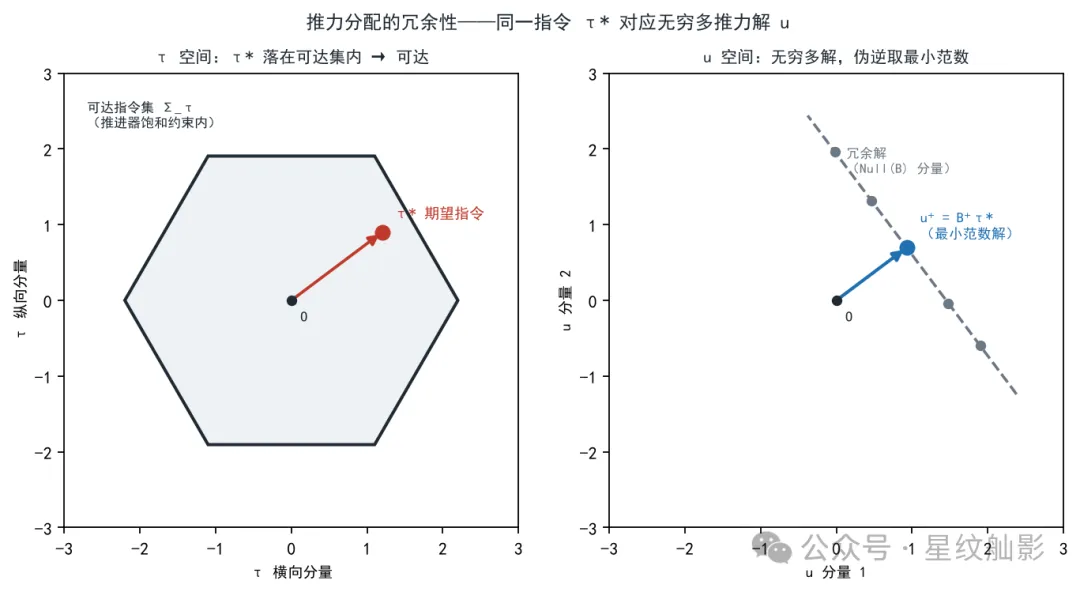
但伪逆有个硬伤:它最小化的是"平方和",不保证单台推力不超饱和。真实推进器有最大推力上限 T_max,伪逆解可能让某一台"爆表"却还不知道。工程上有两种解法:
无穷范数(l∞)准则:最小化"所有推力中的最大值" min max|T_i|,等价于把指令 τ 塞进"推力可达多面体"——各推器 Box 约束 [−T_max, T_max] 经 B 映射后的交集。若 τ 落到多面体之外,在物理上就做不到,必须降需求或重构。这天然兼容饱和约束,且对单台失效有更好容错性(Soylu 等,2008)。
二次规划(QP):min ||u||²(或 ||u−u_prev||²)s.t. B·u = τ, |u_i| ≤ T_max。这是实船常用做法,把饱和与故障(去掉某列即容错)一并写进约束求解。
冗余因此既是麻烦也是资源:多出来的自由度带来了"怎么选"的问题,而选得好(QP/加权/l∞ 准则)就能换来能耗优化与容错,选得差(裸伪逆)则可能让一台推器过载、其余闲置。
六、自主到什么程度——遥操作与共享控制
ROV 与 AUV 最根本的区别,在于 ROV 始终有人在回路。AUV 离线编程、自主航行;ROV 则由水面/甲板上的 pilot 通过摇杆或主手实时操控——这是它名字里"Remotely Operated"的题中之义,也是它能干精细活(如机械臂作业)的前提。
主从遥操作(master-slave,双边)是最直接的形式:操作员扳动主手,远端 ROV 的机体/机械臂按比例跟随,主从两端交换位置与力。力反射(force reflection)让操作员"摸"到接触力,是拧阀、插拔等精细作业的关键。但长时延(长缆、卫星中继)会让直接双边控制失稳——经典解法是波变量 / 无源性方法(Niemeyer & Slotine),把能量以"波"的形式在链路中传输,保证任意常数时延下都稳定。这是遥控潜水器工程里非常硬核的一支。
工程上更常见的是共享控制(shared control):把部分自由度交给自动闭环,人只管高层任务。例如"定深 + 定向"由自动控制维持,操作员只需用摇杆下达"向左前方平移"的意图;遇到精细作业再切回全手动。架构上是"人在环顶(human-on-top)"——控制器在跟踪指令的同时,自动守着饱和、避障等底层约束。这种分工既减轻疲劳,又保留人类判断力。
七、具身大模型——从遥操作到自主作业
近年兴起的一个方向,是用具身大模型把"自然语言指令"直接变成 ROV 的控制动作。其雏形是一条"视觉-语言-动作(VLA)"链路:操作员说一句"检查这段管线",模型融合视觉/深度/DVL/声呐等感知,端到端生成推力与机械臂指令。
目前已有若干真实进展(均属前沿、尚未成熟、以仿真验证为主):
OceanGPT(沧渊):浙江大学牵头,ACL 2024 发表的海洋领域大模型,能生成水下机器人操控代码,初步具备"水下具身智能"能力;2025 年开源的"沧渊"已含问答、多模态(声呐/科学图像)、代码生成(OceanGPT-coder)等模块,在海鹰系列平台上将操控代码编写从"小时级"缩短到"秒级"。 USIM & U0(2025):专为水下机器人打造的 VLA 数据集与模型,基于 Isaac-GR00T 基座、约 30 亿参数,在 Stonefish 仿真中用 BlueROV2 采集数据;论文报告导航类任务成功率约 87%,整体在线成功率约 43%(早期版本曾报 80%,口径随评测框架变化)。 UnderwaterVLA(2025):提出"双脑"架构,把高层任务推理与底层反应式控制解耦,并用水动力-informed 的 MPC 实时补偿流体效应;现场试验显示相比基线导航误差降低、任务完成率提升约 19%–27%。
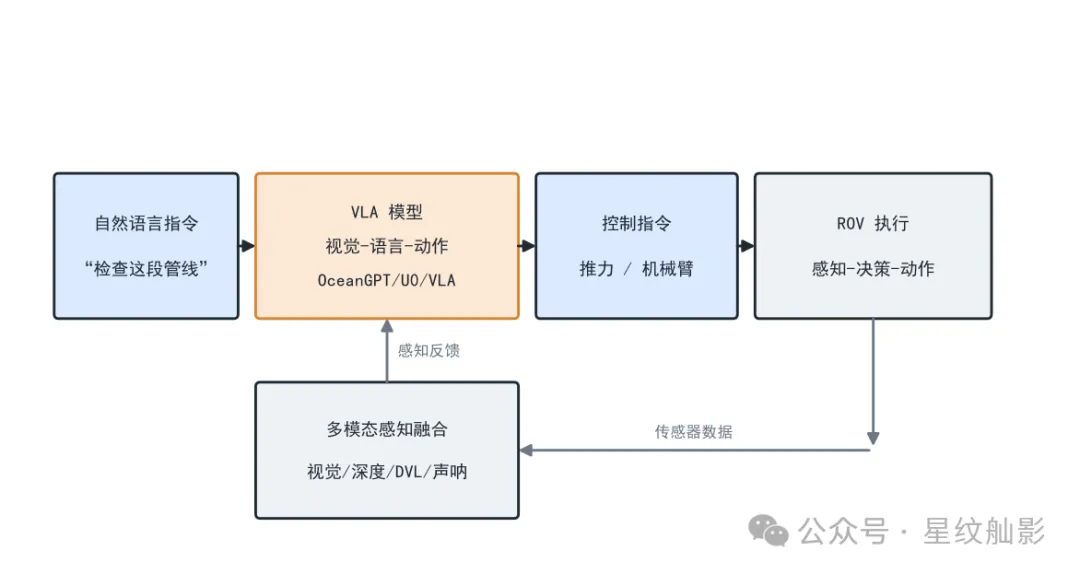
必须清醒看待:这些工作目前多以仿真为主,且存在明显的"领域鸿沟"——为陆地训练的通用 VLA 模型若不做水下微调,在水下几乎完全失效(浑浊、低能见度、强水动力耦合)。零能见度场景还需依赖声呐而非视觉。因此本章只作前沿提示,不展开方法细节;待有成熟的实海域验证,再单独成篇。
八、控制律谱系——概览与工程取舍
前七章把"描述运动 → 推进器与能源 → 动力学 → 控制闭环 → 推力分配 → 遥操作 → 具身自主"这条骨架走完,落点是 PID+前馈+DP 这条工程主力线。但无论第六章的共享控制,还是第七章的具身大模型,指令一旦下到执行端,都绕不开同一个底层命题——用什么控制律去跟踪指令、又怎么把广义力分给推进器。方法谱系远不止 PID,本篇作为收束,先把它们摆上桌给一张概览与取舍;每种方法"怎么造、怎么调"的具体原理,留到后续文章展开。
工程落地仍以 PID + 前馈 + DP 为绝对主力,因为它稳、易调、可解释。但面对强海流、模型不确定和推进器饱和,研究界提出了更激进的方案:
这些方法"为什么各有所长"可以再挖一层:SMC 的鲁棒来自把系统强行拉到滑模面上,代价是不连续控制带来的高频抖振(磨损推进器),实际多用边界层或超螺旋(super-twisting)高阶 SMC 抑制;MPC 的强项是把饱和写成硬约束一起优化,特别适合第五章说的推力上限,但代价是每一步都要在线求解、依赖模型精度;ADRC/DOB 不追求精确模型,而是把"模型误差 + 外部扰动"打包估计后补偿,因此更皮实。
Kaspar 等(2023–2024)对 52 篇近期水下航行器控制论文的综述显示,MPC 是近年被引用/应用最多的方法,其次是反步法(Backstepping)以及 PID 与强化学习的混合;但多数研究仍停留在仿真。现实中的工作级 ROV 扰动量级惊人:以"海斗号"(中国科学院沈阳自动化研究所研制的全海深 ARV)这类真实平台为参照,推力饱和、脐带缆张力与未建模扰动都远非"10 N 级"仿真可比——在工作级 ROV 上,脐带缆张力随长度与母船升沉可达数千牛,推进器迟滞、时变浮力配平与参数漂移同样棘手。论文里很美的控制律,到了真实海域往往还要叠加增益调度、自适应与 DOB 才稳得住。
取舍结论:对绝大多数 ROV,先把 PID+前馈+DP+加权伪逆分配做扎实,足以覆盖绝大多数常见工况;SMC/ADRC/MPC 作为针对性增强,按平台算力与扰动强度择机引入;容错重分配则是工作级冗余平台的"安全网"。
需要强调的是,本章只把这些方法摆上桌,并未展开它们的内部构造与调参——滑模面的设计与抖振抑制(边界层、超螺旋高阶 SMC)、MPC 的预测模型与在线滚动优化、扩张观测器(ESO)的带宽整定、容错重分配在推进器失效后如何重构可行域,每一项都够单独成章;而"仿真里很美"与"海里稳得住"之间的工程鸿沟(辨识精度、传感器噪声、时变参数与未建模动力学),更需要结合真实平台数据才能讲透。这些留待后续文章逐一拆解——学习笔记 EP04 将先转向脐带缆/TMS/供电通信,把本篇第二章点到为止的"能源"那块补齐,控制律的深度选题则在其后再独立展开。本篇的任务到此告一段落:从"我在哪"走到"怎么动、怎么稳住",闭环的骨架已经搭好,剩下的是把每一块骨头填实。
资料来源
一、权威教材与符号
SNAME (1950). Nomenclature for Treating the Motion of a Submerged Body through a Fluid.Fossen, T. I. Marine Craft Hydrodynamics and Motion Control(2011/2021),6-DOF 模型、坐标系与运动学方程 η̇=J(η)ν 的标准框架。Antonelli, G. Underwater Robots(2003/2006),推进器模型、推力二次型与分配。
二、综述与论文(控制、分配、扰动)
Kaspar, J. C. 等(2023–2024). A Survey of Control Technologies for Autonomous Underwater Vehicles,系统回顾 52 篇近期控制方法(MPC 最常用)。Soylu, S. 等(2008). A chattering-free sliding-mode controller … with fault-tolerant infinity-norm thrust allocation,l∞ 分配与容错。Omerdic, E. & Roberts, G.(2003/2004). 推进器故障诊断与容错分配、可行域几何。Niemeyer, G. & Slotine, J.-J. 波变量/无源性遥操作(时延稳定)。Guerrero, J. A. 等(2020);Shao 等(2021);Long 等(2022);Li 等(2023). 各类 SMC/ADRC/MPC/DOB 水下控制实例。Blue Robotics. BlueROV2 Datasheet(4 vectored + 2 vertical 配置)。
三、具身大模型(前沿,可能为非成熟方案)
Bi, Z. 等. OceanGPT: A Large Language Model for Ocean Science Tasks(ACL 2024, arXiv:2310.02031);2025 开源"沧渊"。Gu, J. 等. USIM and U0: A Vision-Language-Action Dataset and Model for General Underwater Robots(arXiv:2510.07869, 2025)。Wang, Z. 等. UnderwaterVLA: Dual-brain vision-language-action architecture for autonomous underwater navigation(arXiv:2509.22441, 2025)。
四、图片来源
图1–图7 与封面均为程序化重绘(matplotlib),来源见各图注;非工程图纸、非 AI 生成图,可供学习引用。

