制造企业AI数据集建设方案PPT:采集、标注、治理
- 2026-11-05 21:40:09
制造企业AI数据集建设方案PPT:采集、标注、治理
埃森哲AI成熟度评估拆解 信息化总监汇报AI落地进展
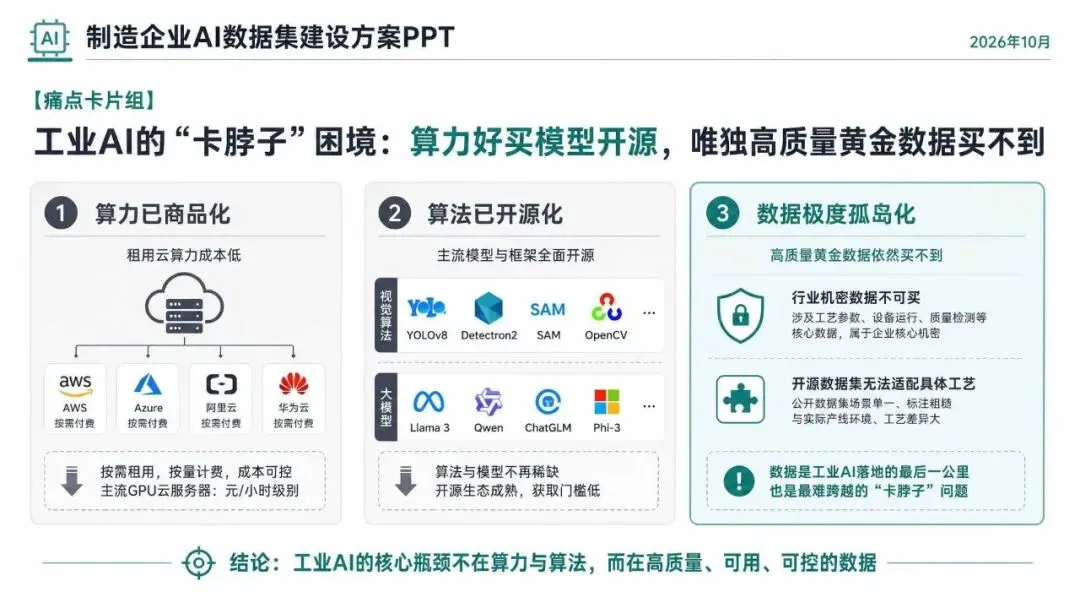
周五的项目评审会上,算法组表示,这个模型的准确性无法提高,都是因为数据质量不过关,需要购买一些公共的数据,但被流程负责人当场否决了,因为公共的数据与产线的真实情况有很大的差距,做出的模型无法使用。其实这件事,最让人头疼的地方不是购买计算资源、寻找算法,而是缺乏自家的优质生产流水线,哪怕是开源出来的模型,也不能正常运行。
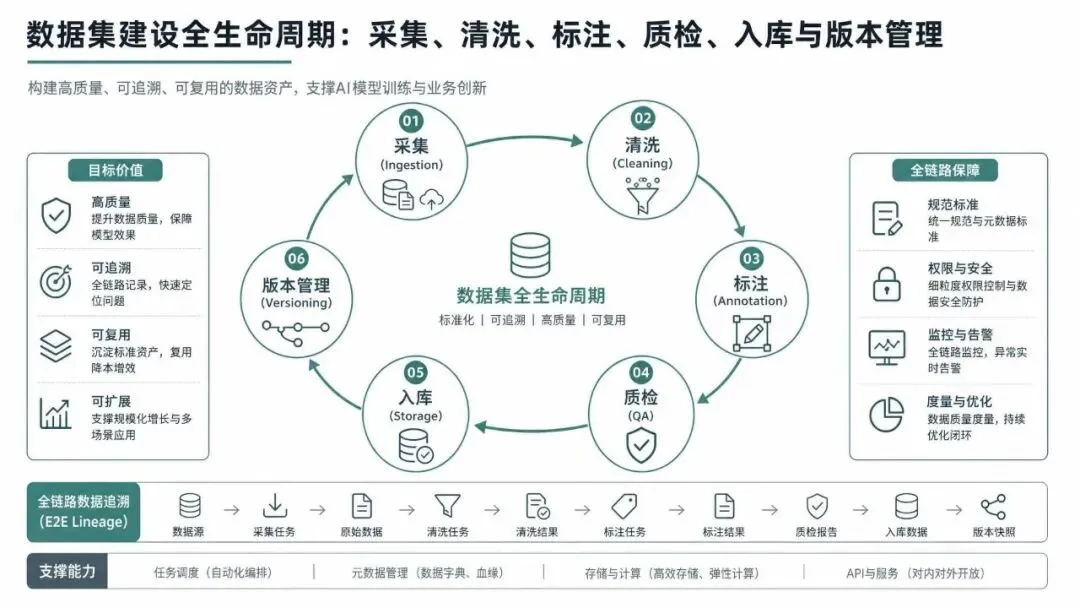
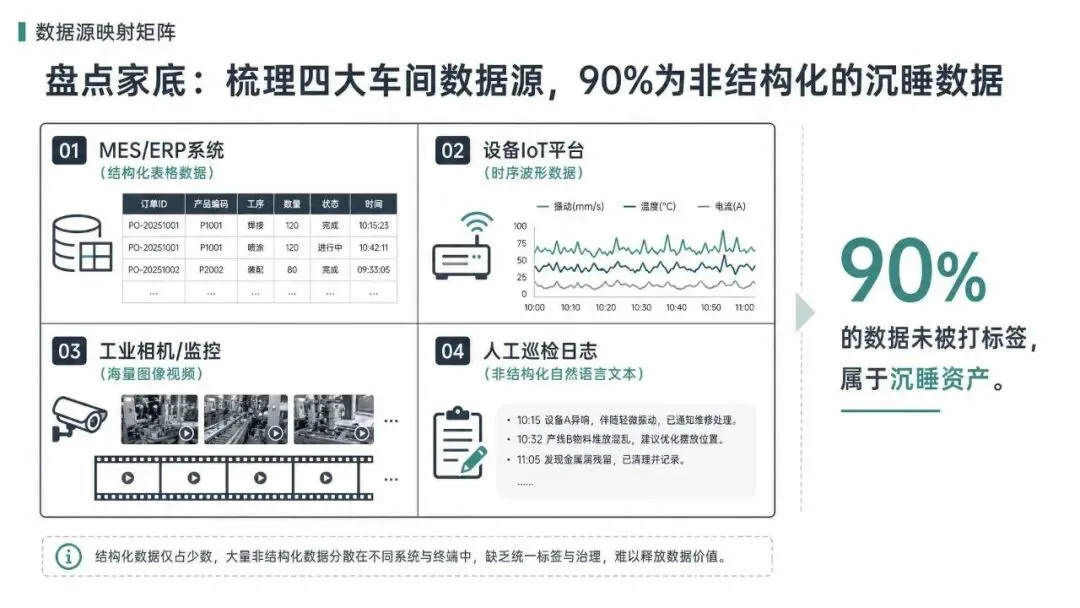
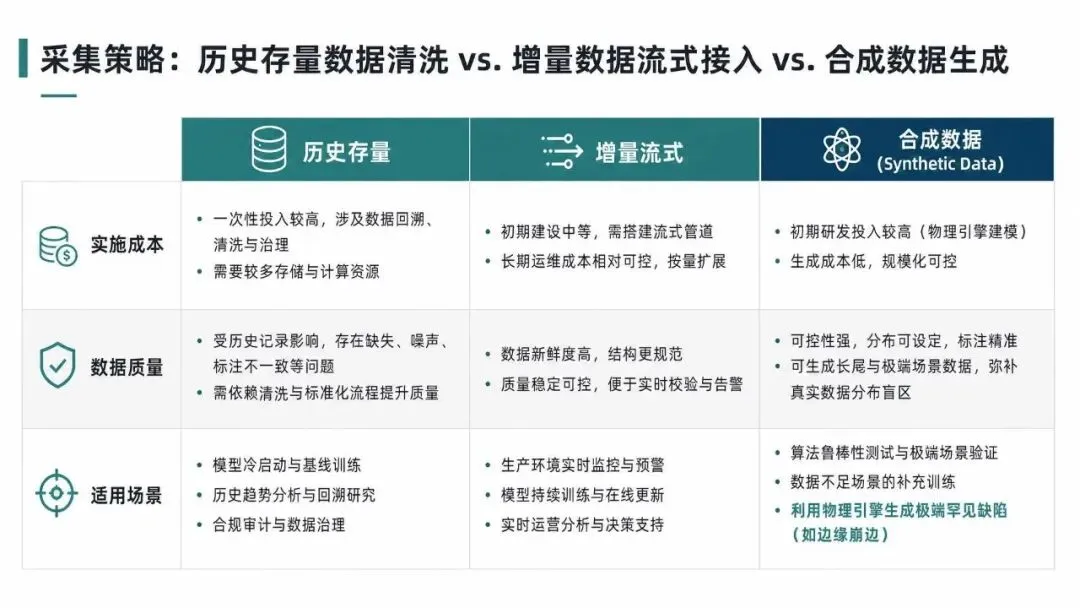
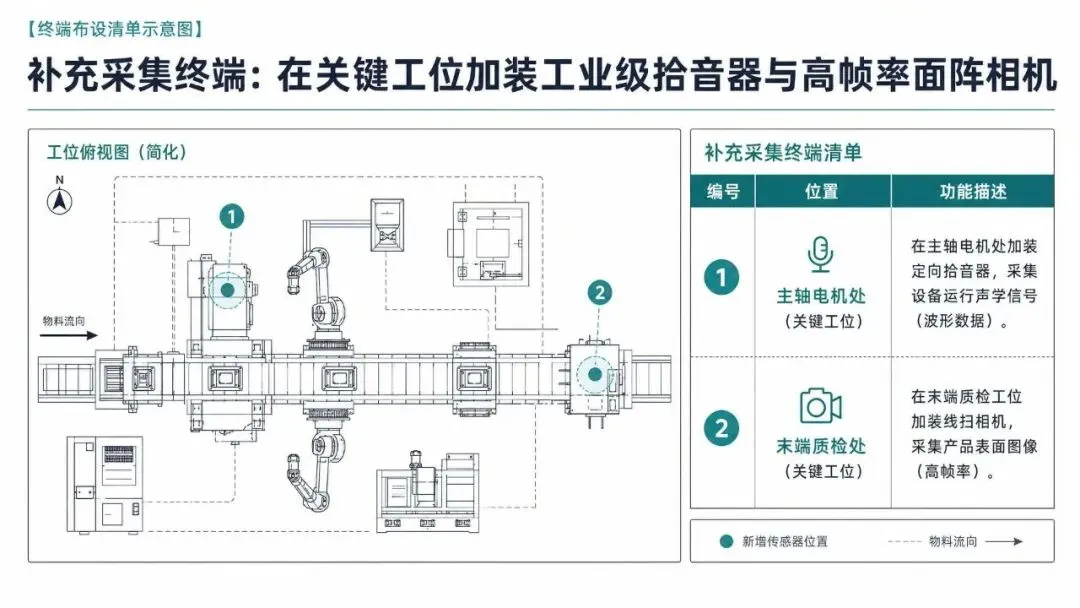
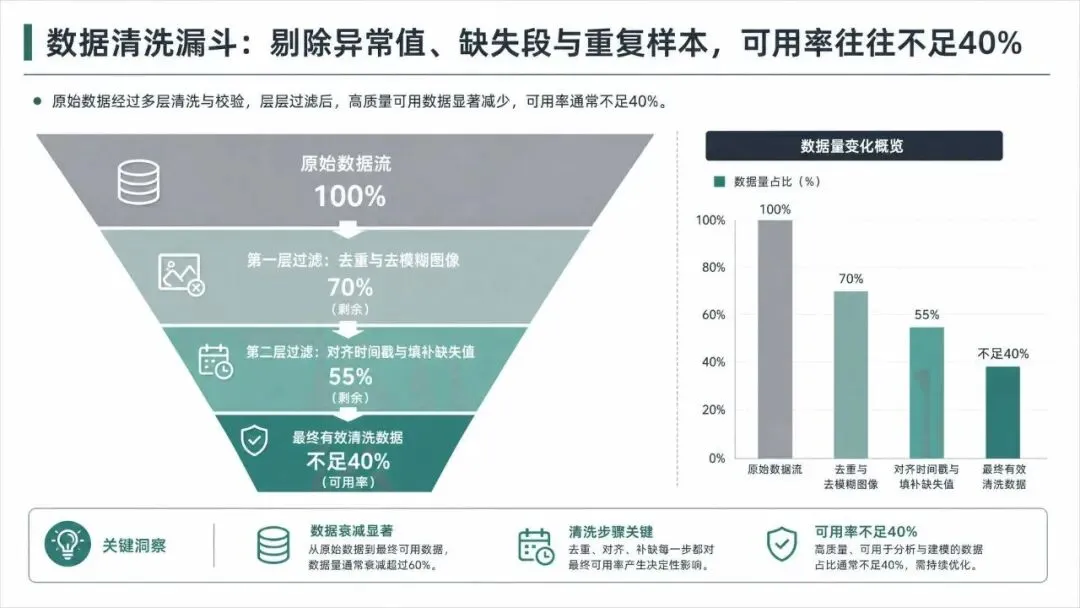
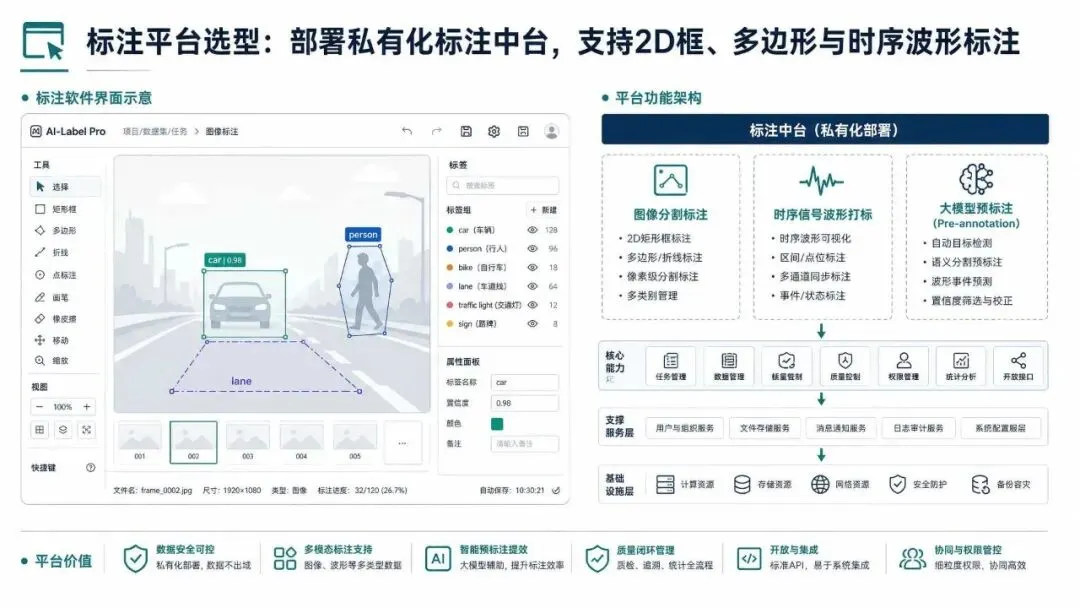
通过对四个主要的工厂数据源的统计分析,发现其中90%的数据是无结构的、处于休眠状态的。MES的结构表格,设备的 IoT定时波形,工业摄像头的视频,人工巡检记录,分散于各个系统中没有标注。采集过程分为三个阶段,对历史数据存量进行清理,对增量数据进行流式访问,对极端场景进行综合数据填充。然后,在所述关键站处添加方向拾取和高帧频平面阵列摄像机,以补充丢失的收集尺寸。原始资料经过过去、重置、调整、补缺等层层过滤后,最后的有效利用率通常在40%以下,这只是一般的衰减,不是清理工作做得不好。
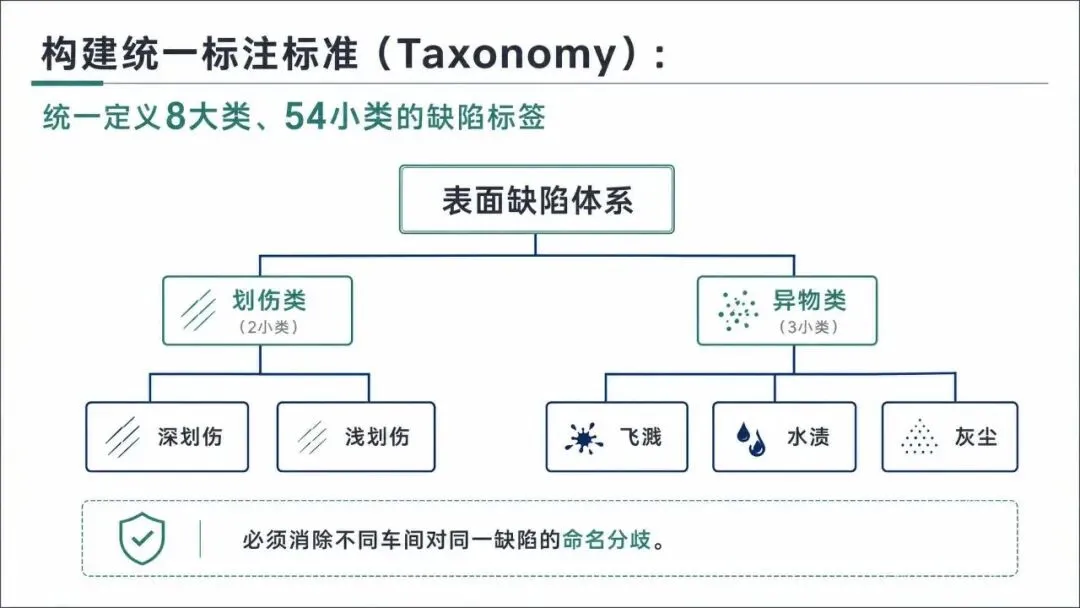
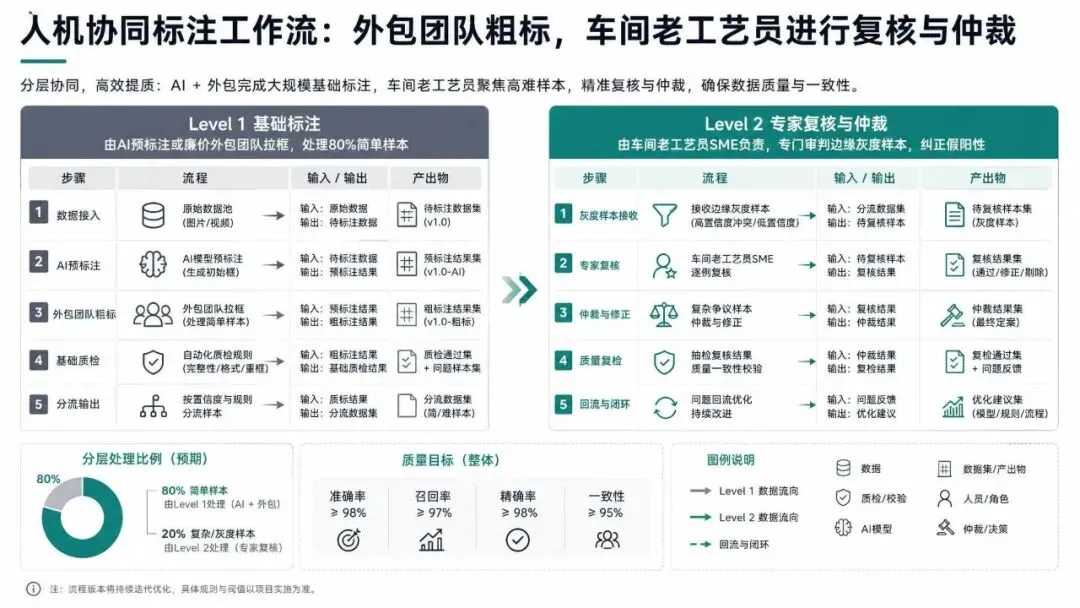
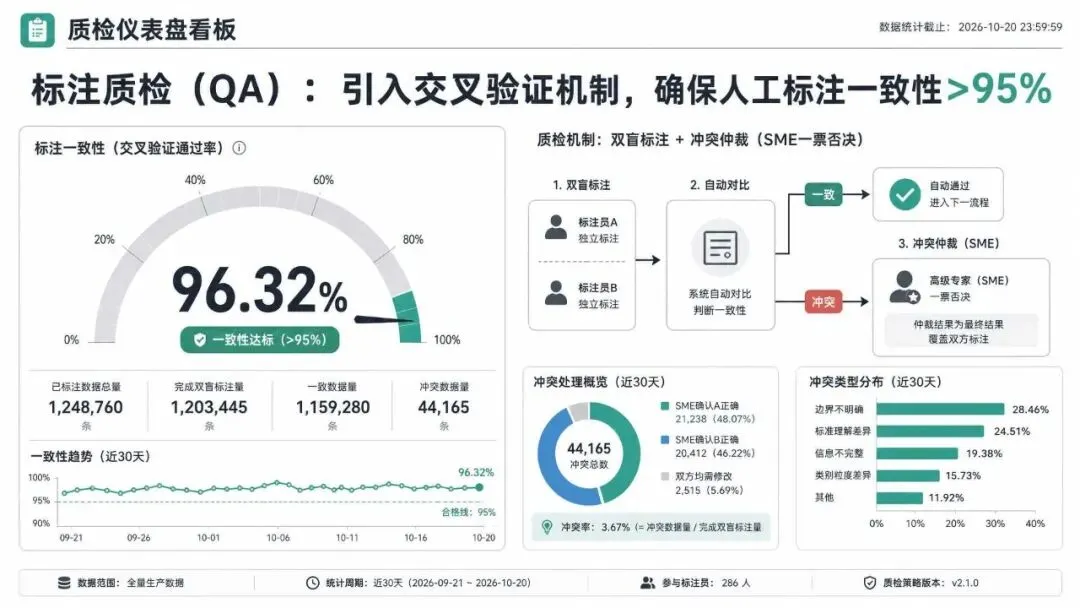
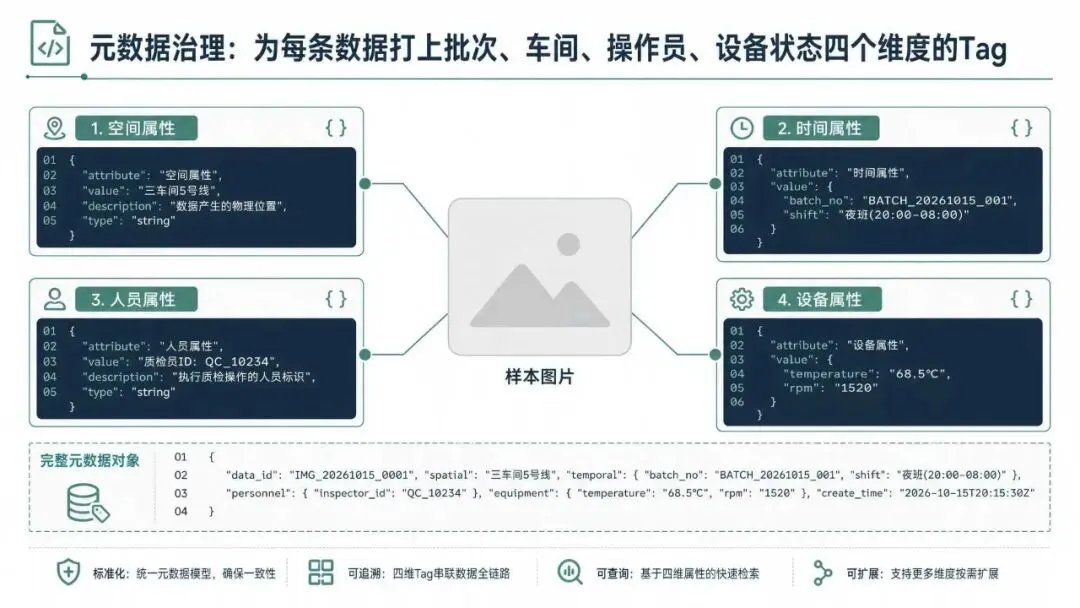
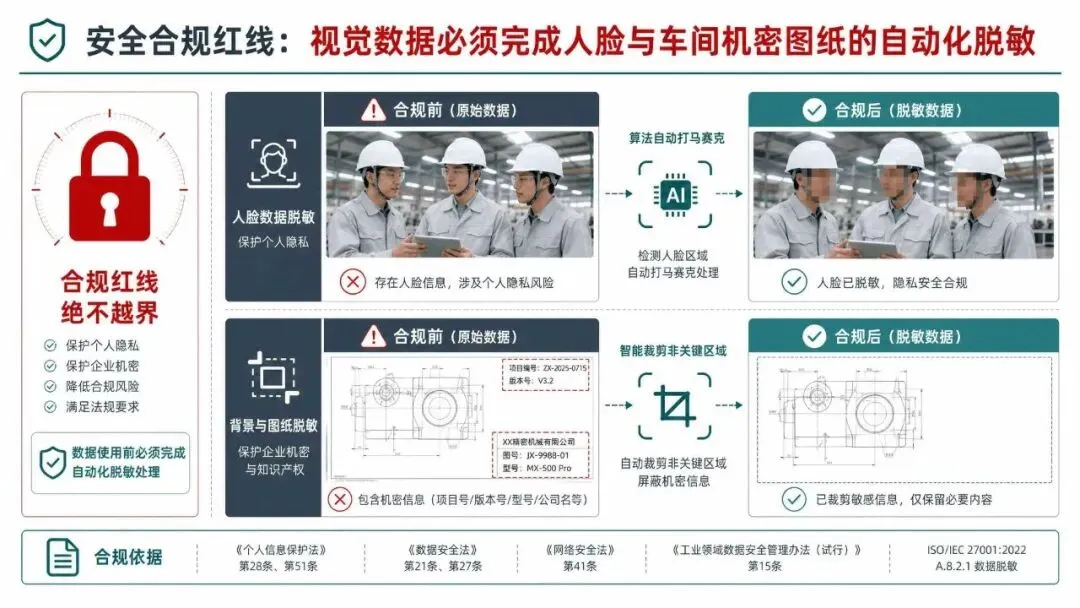
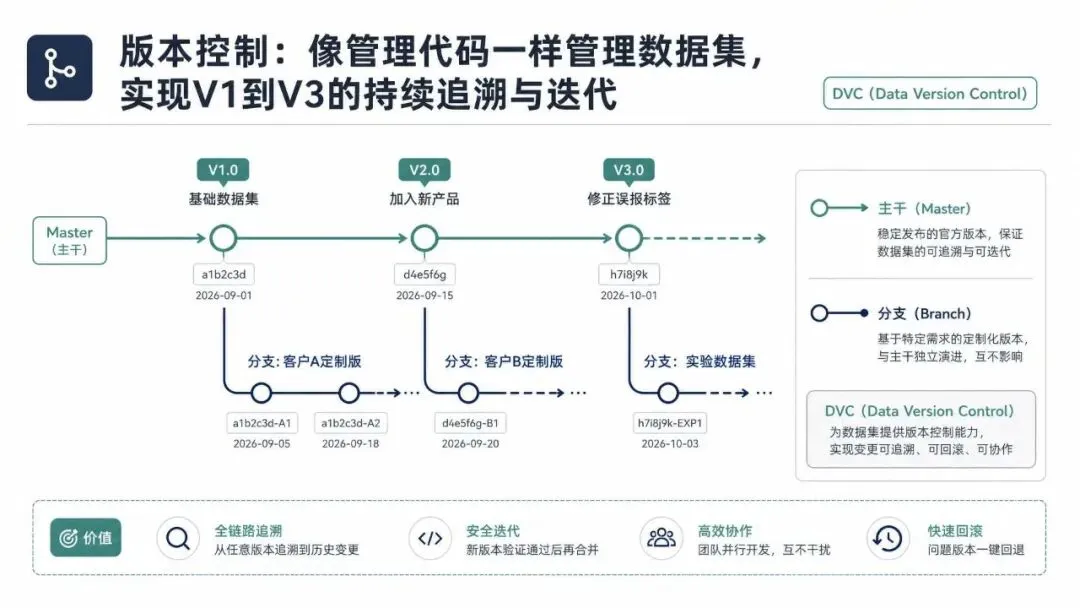
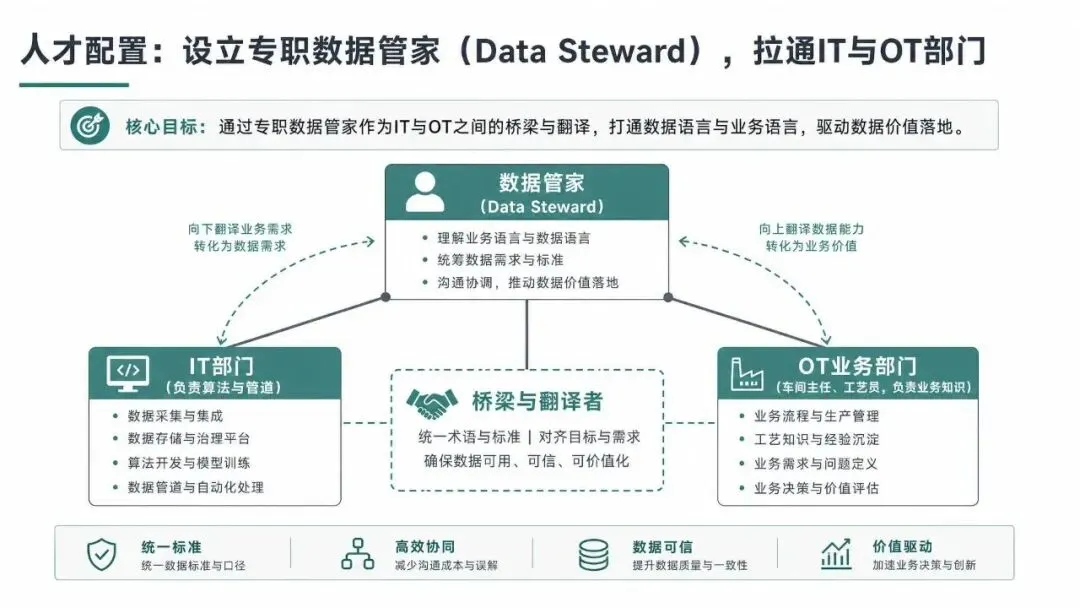
通过对8个大类54个小类缺陷的统一标注,首先解决了各生产单位对相同的缺陷名称的差异。人机协作标记线采用人工智能+外包的方式,对80%的简单样品进行标记,而对20%的边缘灰度值样品进行标记,实现了双盲标记的96.32%。每一项数据都打上空间,时间,人员,设备的四维标签,对脸部和秘密的图形进行自动脱敏处理。版本控制管理数据集的方式与管理代码的方式相同,并且可以跟踪和恢复。建立一个全职的数据管理员,负责 IT和 OT之间的沟通。
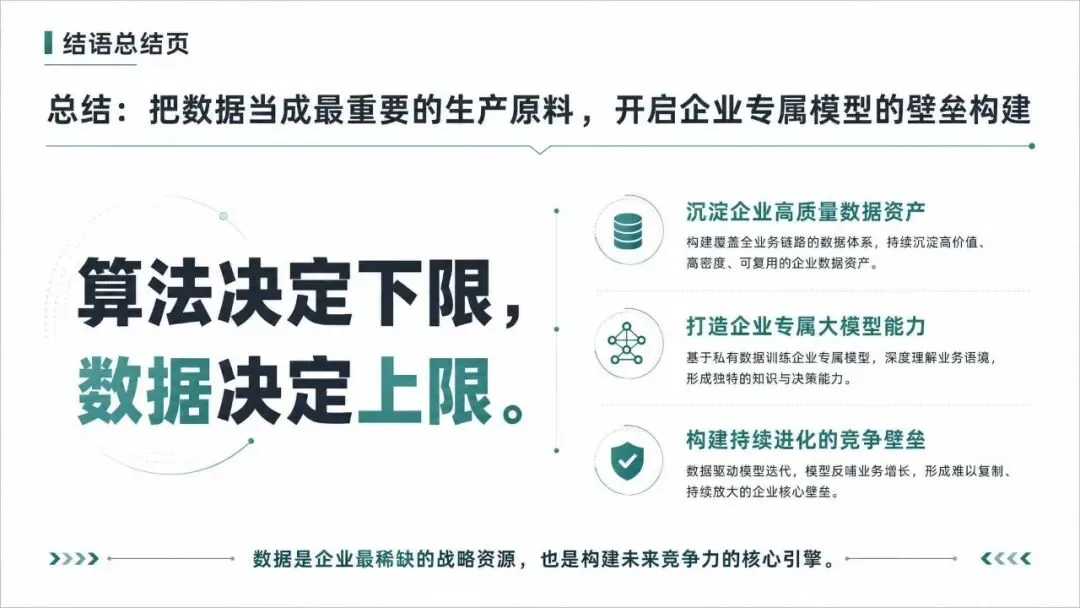
工业 AI在着陆时卡住,多半不是因为计算能力和算法的问题,就是因为自身缺乏优质的金手指数据,只能用公共数据来充数。不要等到模型不正确了,再回过头来补充资料,将采集、标注和治理的环节都打牢了,这就是产业 AI的正确道路。
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

