为了让 AI 做一份 PPT,我手翻了 627 张微信截图
- 2026-11-09 00:39:43
// AI 协作复盘
为了让 AI 做一份 PPT
我手翻了 627 张微信截图
一次真实的踩坑记录 · 附开源 skill
说明:为保护个人信息,文中配图均为二次加工——依据真实截图与真实反馈文案重制,不含真实单位、姓名与照片。
01
我以为是排版问题,结果第一关是「怎么读我的微信」
那天半夜,团支书在群里艾特我,说最佳团日的答辩 PPT交给我做。
我是宣传委员,这活儿本来就该我干。但他补了两句:稿子领导改过一版,你按这个改;素材和相关的聊天记录都在微信里,你自己翻。
答辩在这个周末。我盯着那份二十多页的文件看了很久。有满的、有空的、有对齐的、有没对齐的,页面右上角的标签每页位置都不一样。说实话,我当时心里是发怵的。
我第一反应不是自己排,是让 AI 干。我手上有个 DeepSeek Harness,把稿子丢进去,让它改排版、补装饰。然后我发现,它要干的第一个活根本不是排版,是把我微信里的聊天记录读出来——领导的要求、改稿的意见、同学发的照片,全在那里面。
接下来的几个小时,它在这个问题上撞了很多次墙:
▍想直接读微信的数据库,文件是加密的,打不开
▍想从运行中的内存里读,被系统的安全机制挡住,连试三次都失败
▍想用脚本模拟滚轮去翻聊天,五种方式试遍,事件送不进微信
▍想读微信窗口里的文字,那个窗口只暴露三个按钮,读不到内容
▍连微信缓存里的图片都试过暴力解码,256 种组合全试了,不行
最后能走通的方案特别笨:我自己开着微信,一屏一屏往下翻,它每不到一秒截一张图,一共截了 627 张,再用文字识别把图上的字拼起来。
这中间翻了两次车,也是那天我体验最差的两段。
一次是它截屏时会把微信窗口抢到最前面。我正打字打到一半,窗口一抖,字没了。我当时的原话是:你什么时候开始,我得知道你要干什么,以后提醒我一下再切屏。
还有一次它翻错了会话,150 张全部白录,我一个字有效信息都没拿到。我说:你刚才翻的全是错的。
事后复盘,它烧掉的 token 主要就在这一块。它那边的记录里没有精确的数字,但有这些可以核对的动作:627 张截图、5 批文字识别、40 次整图查看,后面还有 26 轮整份 PPT 的全片渲染。
也就是说,我以为我在为「改 PPT」付钱,实际上大头付给了「读聊天记录」。
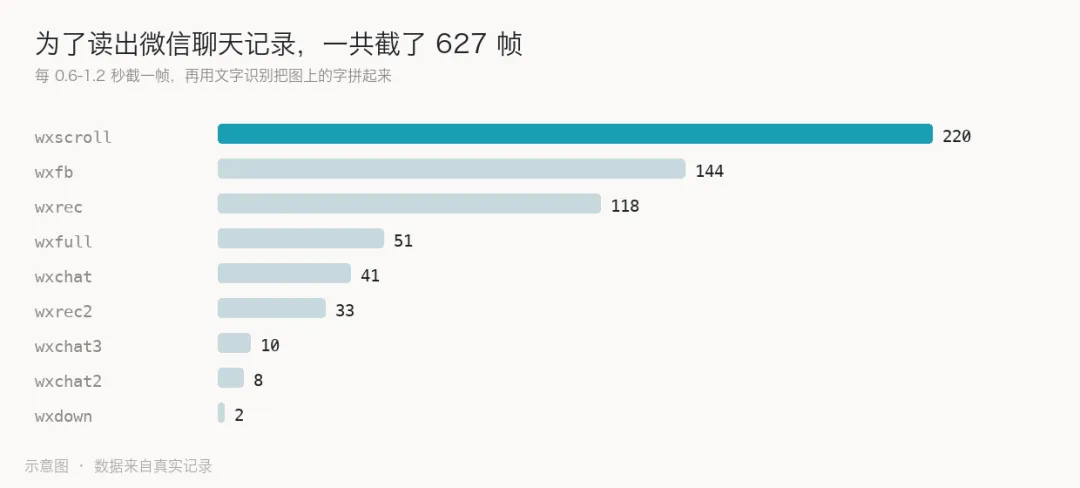
627 帧截图分别落在 9 个目录里,一个目录就占了 220 帧
02
有四轮都卡在同一个字上:字体
翻完微信,它开始做 PPT。第一版做出来 15 页,白底红装饰,结构还挺清楚。然后我把批注截图发给它。三张截图里,出现最多的两个字是:
「字体!」「字体!」「字太小!」
后面又发了一轮,11 张截图,还是这个字。
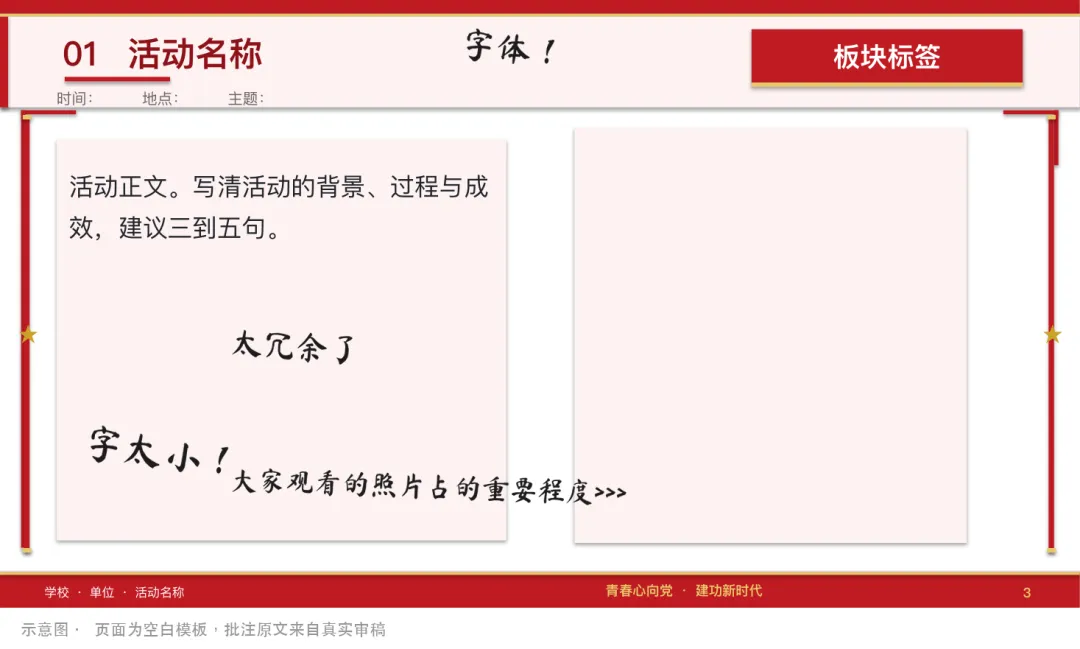
审稿批注复刻示意(页面为空白模板,批注原文来自真实审稿)
第一轮它用的是苹果系统自带的字体。我的电脑是 Windows,打开以后字体被替换掉,中文和数字变成了两套,一眼就假。
第二轮它改成了微软雅黑。我打开一看,正文是改过来了,但文件里的「主题字体」没改——那里面还留着 Calibri 和 Arial。结果同一个问题又出现一次。
第三轮它才把主题字体一起改掉,再把残留清干净,这一关才算过。这件事后来变成了我 skill 里最硬的一条规则:改字体必须连主题字体一起改,只改正文等于没改。
03
我把它交接出去了,原话是「你做得太差了」
到第二天下午,我实在忍不住了。
不是它不努力。那天它一共出了八版,从 15 页做到 26 页,还把我那 48 张照片分门别类重命名归档好了。但它太慢了,一版一版改,一轮一轮烧。
而且我还有一堆具体要求它没做到:照片被拉伸、照片越出页面、装饰盖住正文、右上角标签每页位置都不一样。
我跟它说:你把这个项目的相关资料整理一下,我要交接给 Codex,你发给我文案,我直接转过去就能开工。你做得太差了。
它交出了一份 13.6KB 的说明文档:工作目录、环境命令、硬性规范、待办、避坑记录、验收清单。
审稿批注复刻示意(页面为空白模板,批注原文来自真实审稿)
现在回头看,这份文档挺有价值。它把自己踩过的坑全写下来了——哪些装饰会被否、照片的四种典型问题分别是什么原因、字体为什么要连主题一起改。后面接手的一上来就知道什么不能做。
04
换成 Codex 之后
我换的是 Codex,但接的还是 DeepSeek 的 API,模型没换。换的是那个干活的壳子。换完第一感觉就是:顺。
从晚上十点到十一点十五,一个多小时里它改了六版。而前面八版,我花了将近一整天。
我不敢说这就是「因为它更聪明」。更准确的说法是,它肯先动手量,而不是先动手画。举两个我到现在还记得的例子。
页面底部有个装饰角标,我肉眼看着就是「有点怪」,但说不上来哪里怪。它量了一下:这个角标的竖笔从 6.60 英寸的位置一直往下伸到 7.28 英寸,而页脚是从 7.06 英寸开始的。它是插进页脚里 0.22 英寸。这种问题看是看不出来的,量一次就明白了。
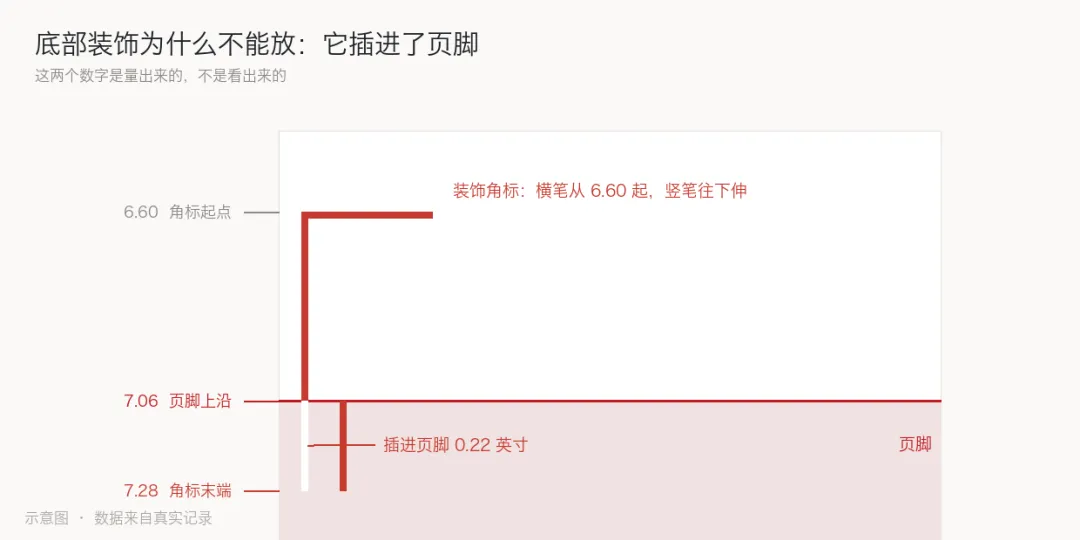
三条线按真实坐标画:6.60 是角标起点,7.06 是页脚上沿,7.28 是角标末端
再比如四宫格那几页,照片摆完左右各空出一大块。它量出来:那四张照片的宽高比决定了它们最高只能到 2.6 英寸,横向最多占 7 英寸左右。填不满不是排版没排好,是物理上就填不满,所以换个思路,用浅色底衬把空白收掉。
还有一次,我说「这个装饰有点难看」,它删掉之后页面又空了。它没停在「删」这一步,而是把两条竖着的标语改成了一条横的,又给空出来的地方补上底衬。这类活儿靠的不是灵感,是先量完再决定。
05
我搜了一堆现成的 PPT skill,一个都没用上
中间我不甘心,去搜有没有现成能用的。X 上有一篇「中文创作者十大必装 Skill」,我把里面跟 PPT 相关的全点开看了,GitHub 上也按星数排了一轮。
看完的结论是:没一个适合我。不是它们不好,是它们解的不是我的题。那些 skill 大多是两种路子:一种输出 HTML 网页幻灯片,一种整页生成图片再拼成 PPT。
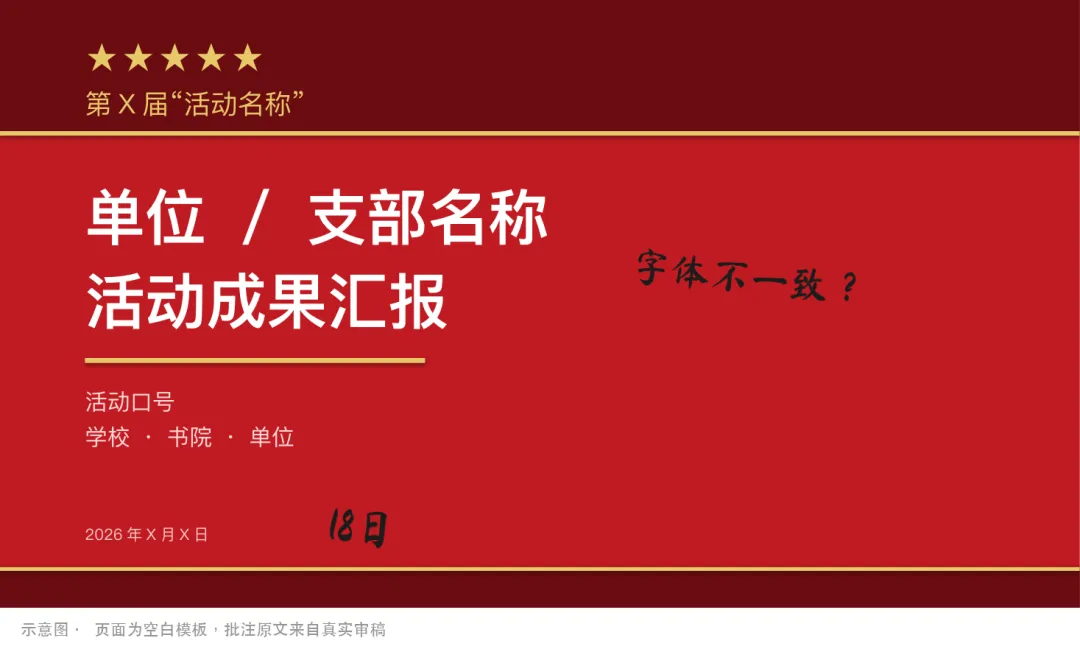
审稿批注复刻示意(页面为空白模板,批注原文来自真实审稿)
而我的要求很硬:这份 PPT 要拷到答辩电脑上,用 PowerPoint 打开,还得能现场改字——稿子随时可能被改。HTML 网页打不开,整页图片改不了。
那一下我明白了一件事:挑工具之前,先想清楚交付标准。不是哪个星多就用哪个,是我要交的东西长什么样。想清楚这条,后面反而顺了:既然没有合适的,那就自己做一个。
06
把每次被打回的原因,写成规则
我攒这个 skill 的方法不是记笔记,是把每一次被否掉的原因,写成能执行的规则:
01 字体必须连主题字体一起改。只改正文,文件拿到 Windows 上会变成两套字体,一眼假。
02 全篇行内间距只允许 0.15 英寸一种取值,不能这次 0.12、下次 0.2。
03 图片显示比例必须等于原图比例,改尺寸只能等比,绝不拉伸。
04 底部不要放任何装饰。量过了:正文最深到 6.82 英寸,页脚从 7.06 英寸开始,中间只剩 0.24 英寸,什么都放不下。
05 被否掉的装饰不要再用。飘带、星簇、竖排标语都试过,都被否了,留白就用浅色底衬补。
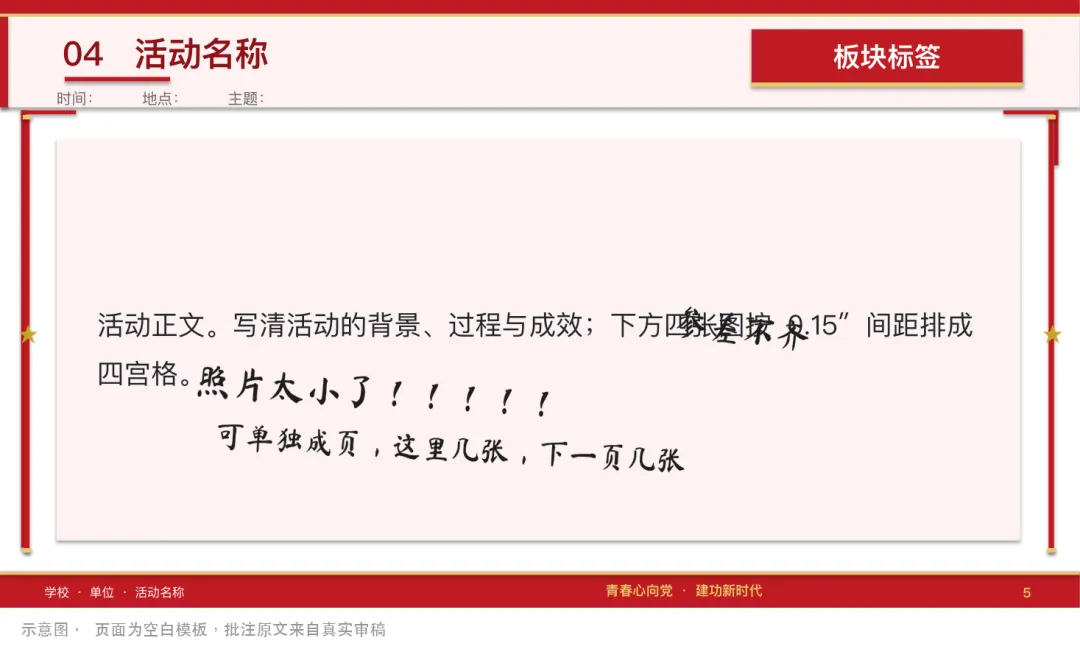
审稿批注复刻示意(页面为空白模板,批注原文来自真实审稿)
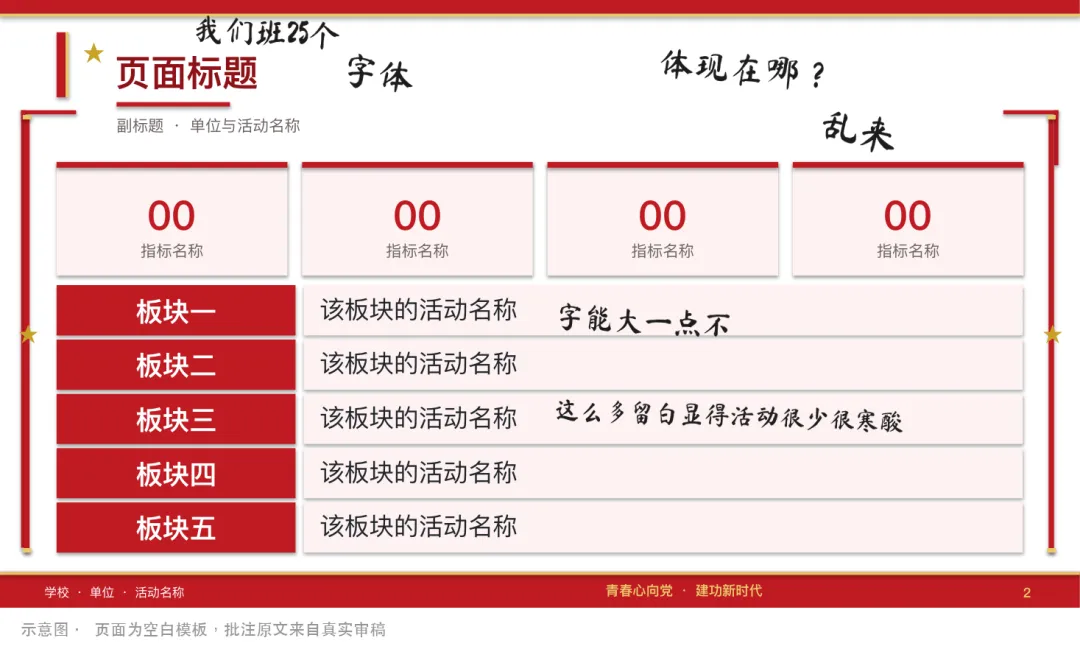
我还把「批注原文」一起写了进去。比如有人在概况页上批了这么一句:「这么多留白显得活动很少很寒酸」。
这一句比十条设计原则都管用。它告诉我,「空」在这份稿子里不是风格问题,是会被读成「你们没做几件事」。
规则写完,我又从最终稿里抽出一套空白模板:内容全清掉,只留版式和装饰,删掉图片的位置用浅色底衬标出来,下次直接套。最后写了 README,别人复制一句话发给自己 AI,就能装上。
∞
很累,但确实有点自豪
今天最开心的一刻,是在终端里敲下 git push、看到那行 set up to track 的时候。仓库里躺着我自己写的第一版 skill 和一套空白模板。
顺带说一句,我今天才第一次正经用 git,前面还因为用户名拼错一个字母,推送失败折腾了半天。
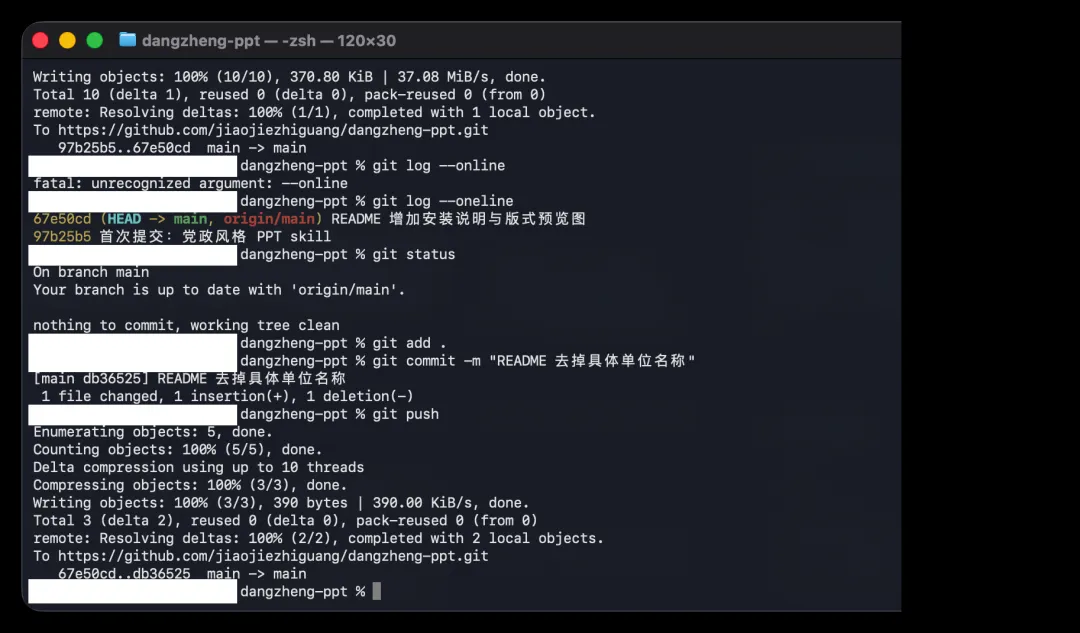
第一次推送成功(终端提示符里的用户名已遮掉)
但也真的很累。改到第九版才敢交出去,交完对方只回了一句:
算了,就先这样吧。
这句话我盯着看了挺久。它不好听,但它很真——说明还有问题没解决,只是对方也累了,不想再改了。
所以我把它也写进了 skill 里:哪几种装饰被否过、哪几页的空白是怎么来的、哪一版照片被拉伸过。下次再遇到同样的活,我希望它能一次做对,而不是让我再烧一轮 token。
如果你也在用 AI 做 PPT,我的经验就一句话:别指望它一次做对。让它把每次错在哪记下来,下次不再犯同一个错,这才是杠杆。
// 开源
我做的这套党政风格 PPT skill 已经开源,配了一套空白模板。
github.com/jiaojiezhiguang/dangzheng-ppt
我是 正太,一名大学生,喜欢研究计算机技术。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
微信扫码关注「小公子不才」

